AI・テクノロジー

AI技術・仕組み

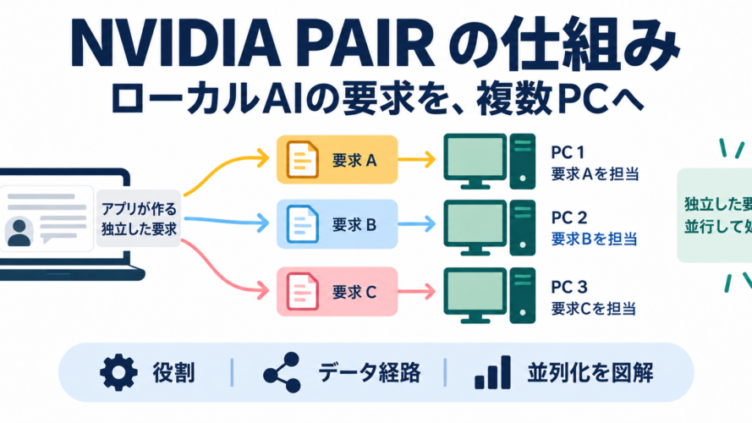
NVIDIA PAIRとは?複数PCにローカルAIの推論を振り分ける仕組み

NVIDIA PAIRの役割と推論リクエストの分散を図解。Ollama・LM Studioとの分担、CPU・GPUへのデータ経路、モデル配置、VRAMを合算しない理由、並列化の用途とベータ版の制約を解説します。
AI技術・仕組み
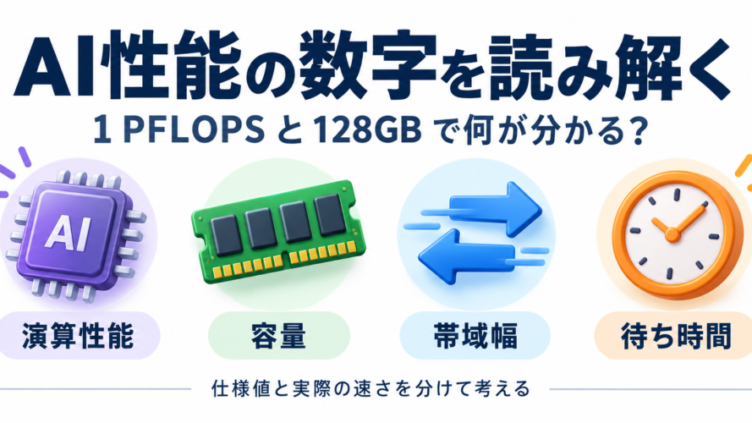
「1 PFLOPS」「128GB」でAI性能は分かる?RTX Sparkから学ぶ性能指標

RTX Sparkの最大1 PFLOPS・128GBを入口に、AIの演算性能、メモリ容量、帯域幅、待ち時間を図解。FP4の条件、必要容量と転送時間の計算、TTFT・ITL、実測を比較するときの確認点を解説します。
AI技術・仕組み

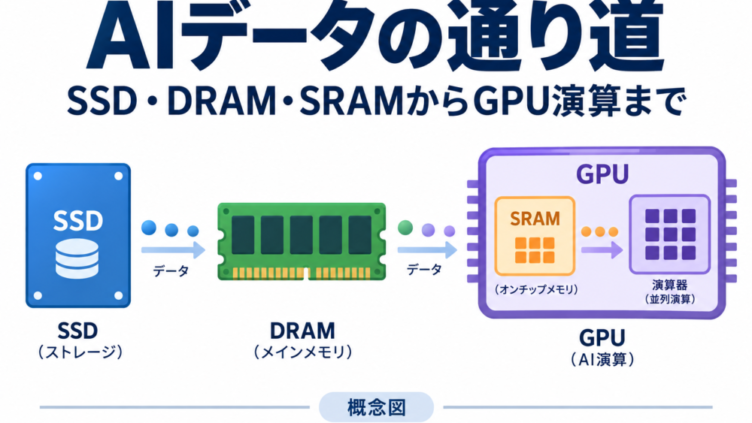
AIのデータはどこを通る?SSD・DRAM・SRAMからGPU演算まで

AIモデルがSSDから読み込まれ、DRAM・キャッシュ・Shared Memory・レジスタを使ってGPUで演算される流れを図解。CPUの指示とデータ転送、SRAMとVRAMの違い、再利用、結果保存までを説明します。
AI技術・仕組み

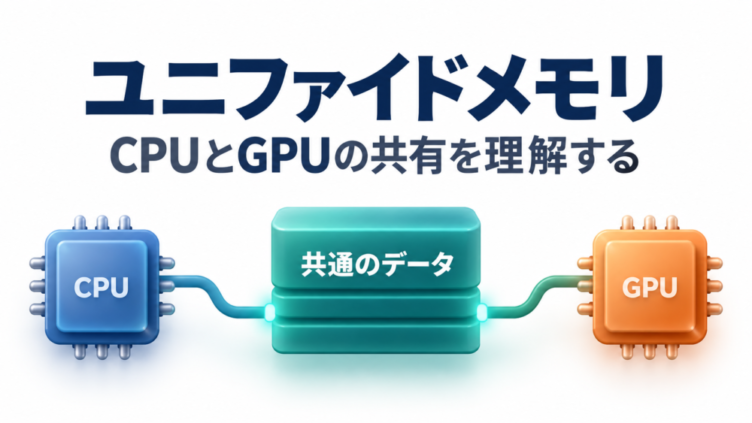
ユニファイドメモリとは?CPU・GPUの共有とデータ転送を図解

ユニファイドメモリとVRAMの違いを図解。CPU・GPUの物理共有、CUDA Unified Memory、GPU内Shared Memoryを区別し、仮想アドレス、ページ移動、同期、バッファ再利用、AIに必要な容量の考え方を説明します。
AIニュース・サービス

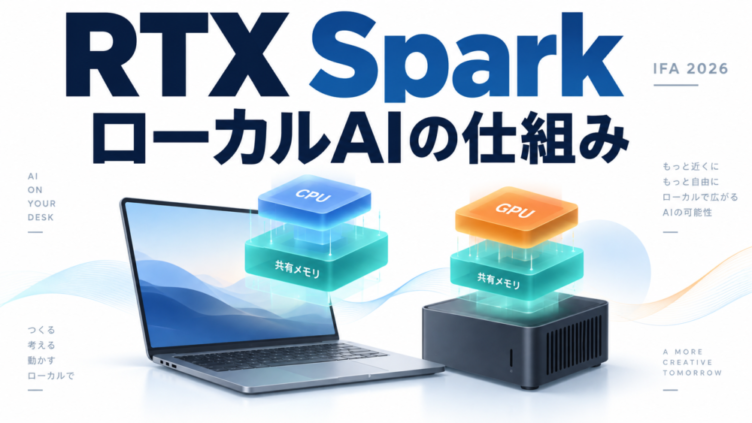
RTX Spark搭載PCとは?IFA 2026発表とローカルAIの仕組みを図解

IFA 2026で紹介されたRTX Spark搭載PCを解説。Acer・Lenovoの発表、DGX Sparkとの違い、CPU・GPU・ユニファイドメモリ・SRAMの役割、文書要約のデータ転送を図解し、最大1PFLOPと128GBの読み方を整理します。
AI開発・実装

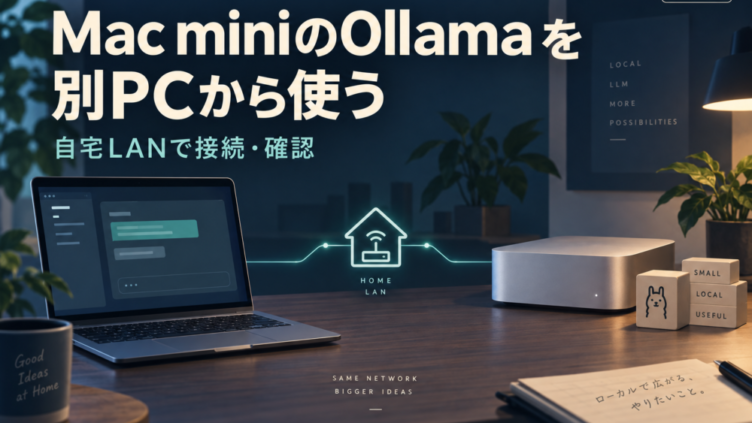
Mac miniのOllamaを別のPCから使う方法|自宅LANで接続・確認する手順

Mac miniのOllamaをWindowsや別のMacから使う手順を解説。macOSアプリ版のOLLAMA_HOST設定、モデル一覧の取得、文章生成、接続できない場合の切り分けとローカル限定への戻し方を整理します。
AI開発・実装

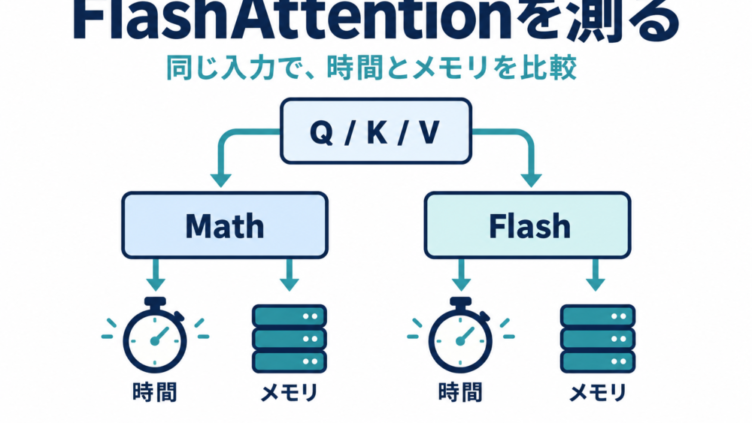
FlashAttentionの速度とGPUメモリを比較する方法|PyTorchの測定コードと注意点

PyTorchのSDPAでMathとFlashAttentionを同じ入力から比較する測定コードを解説。CUDA Eventによる時間計測、追加ピークメモリ、出力差の確認、非対応・メモリ不足やdecode時の注意点を整理します。
AI開発・実装

LM StudioでPDFを読み込んで質問する方法|回答の根拠と読み取り漏れを確認する

LM StudioへPDFを添付して質問する手順を解説。短い文書と長い文書の参照方法、回答と原文の照合、スキャンPDF・OCR・表の読み取りで確認したい点、読めないときの切り分けを紹介します。
AI開発・実装

Ollamaで長文を入れると遅い・メモリ不足になる原因|コンテキスト長と設定の見直し

Ollamaで長文や会話履歴を渡すと遅くなる・メモリ不足になる原因を整理。num_ctxと実入力の違い、KVキャッシュ、同時実行、APIの計測値を使い、条件を一つずつ変えて切り分ける手順を紹介します。
AI開発・実装

MacのOllamaモデルを外付けSSDへ移す方法|保存先変更と再起動後の確認

MacのOllamaモデルを外付けSSDへ移す手順を解説。元データを残すコピー、OLLAMA_MODELSの設定、アプリとMacの再起動後の確認、モデルが見つからないときの切り分け、元に戻す方法を紹介します。
スポンサーリンク