主成分分析(PCA)は、複数の入力を組み合わせて新しい軸を作り、データのばらつきをできるだけ残しながら次元を減らす方法です。寄与率は、その軸で元の分散のどれだけを説明できるかを示します。残す次元数は寄与率だけで決めず、可視化・復元・予測のどれに使うかに合わせて判断します。
例えば、12個の入力項目を2個の主成分へまとめると、散布図で全体を見やすくなります。ただし、2個の元の列を選ぶ処理とは異なります。この記事では、まず4点の小さなデータで何が起きるかを計算し、標準化と次元数の選び方につなげます。
PCAは「残す列」ではなく「新しい軸」を作る
特徴量(モデルや分析へ渡す入力項目)が2つあると、1件のデータは平面上の点になります。PCAは、その点の集まりが大きく広がる方向を探します。第1主成分は分散が最大になる方向、第2主成分は第1主成分と直交し、その条件で最も分散が大きい方向です。
軸を求めるとき、通常のPCAは分類ラベルや予測したい正解を使いません。「ばらつきを残す」ことと「正解を予測しやすくする」ことは、後で分けて確認する必要があります。scikit-learnのPCA解説でも、分散を説明する直交成分への変換として整理されています。
| 方法 | 2項目を1項目に減らす例 | 残るもの・注意点 |
|---|---|---|
| 特徴量選択 | x1を残してx2を使わない | 元の項目名で扱える。捨てた列の情報は直接使えない |
| PCA | x1とx2を係数付きで足してz1を作る | 両方の列を使えるが、新しい軸の意味づけが必要 |
元の列のまま管理したい場合は、特徴量選択の使い分けが参考になります。PCAでは成分が2つになっても、変換に元の12項目すべてが必要なことがあります。後段モデルの入力数が減ることと、測定項目を減らせることを混同しないようにします。
4点を1次元へ写し、元の座標へ戻してみる
同じ単位の2項目について、次の4点を考えます。説明用に作ったデータで、各列の平均は0です。
| 点 | x1 | x2 |
|---|---|---|
| A | 2 | 1 |
| B | 1 | 2 |
| C | −1 | −2 |
| D | −2 | −1 |
このデータの第1主成分の方向は、右上へ45度進む向きです。長さ1のベクトルで書くと、次のようになります。
点をこの軸へ射影(軸に垂直に下ろした位置へ写すこと)すると、軸に沿った座標は次の式で求められます。この座標が主成分得点です。
Aを代入すると、得点は(2+1)/√2 ≈ 2.121です。1つの数値に縮めた後、元の2次元空間へ近似的に戻すには、得点に軸のベクトルを掛けます。
| 点 | 第1主成分の得点 | 1次元から復元した座標 | 元の点から失われた差 |
|---|---|---|---|
| A | 約2.121 | (1.5, 1.5) | (0.5, −0.5) |
| B | 約2.121 | (1.5, 1.5) | (−0.5, 0.5) |
| C | 約−2.121 | (−1.5, −1.5) | (0.5, −0.5) |
| D | 約−2.121 | (−1.5, −1.5) | (−0.5, 0.5) |
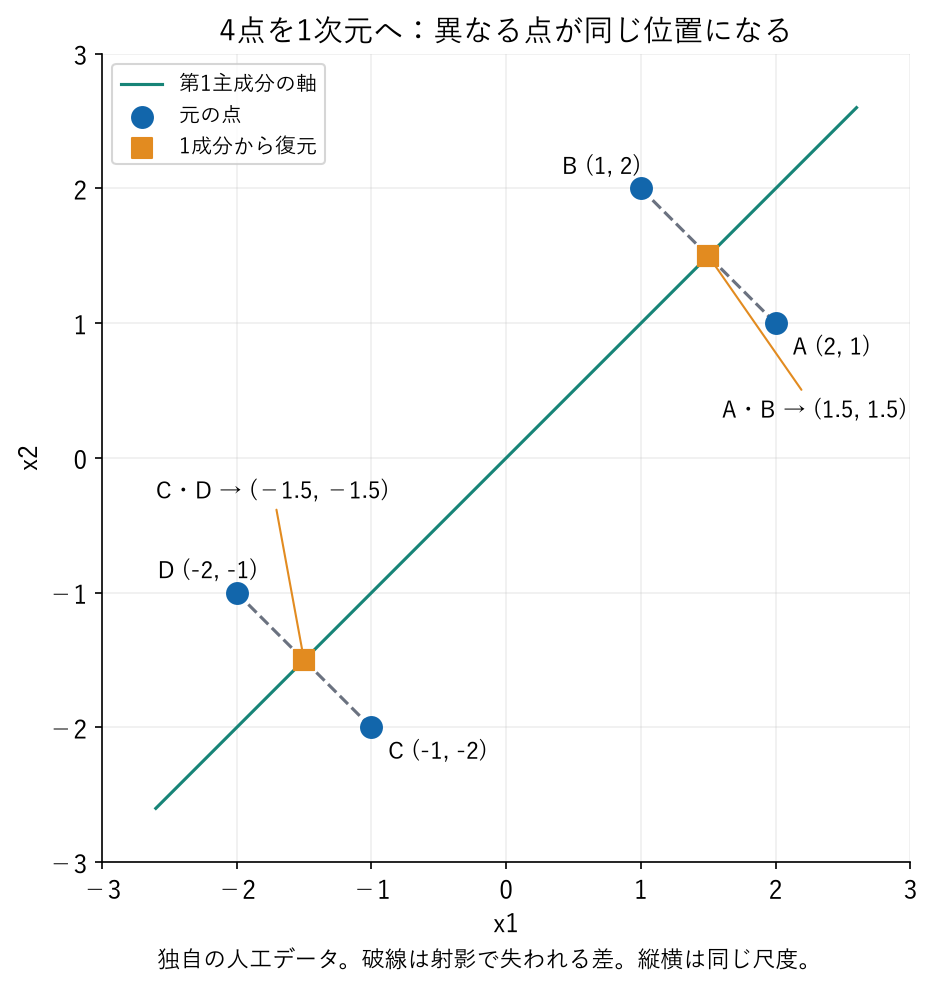
4点と第1主成分への射影。破線の差が1成分への削減で失われます。
AとBは異なる点ですが、第1主成分だけでは同じ位置になります。両者を区別する差は、第2主成分側に残っていました。次元削減で捨てるのは、このような方向の違いです。
一般のデータでは、先に各列の平均を引いてから得点を求め、復元時には平均を足します。また、軸の向きは逆でも構いません。v1と−v1では得点の符号も逆になるため、復元する点は同じです。
軸の係数と、各点の得点を分ける
scikit-learnでは、components_が主成分の軸を表す係数、transformの結果が各データの得点です。今回なら軸の係数は約(0.707, 0.707)、Aの得点は約2.121です。
資料によって「負荷量」という用語の定義が異なることがあるため、係数そのものか、元の変数と主成分得点の相関などを表す値かを確認してください。この記事では曖昧さを避け、軸の係数と得点に分けて説明します。実装の返り値はPCAの公式仕様で確認できます。
寄与率90%は「分散の90%」を意味する
主成分の分散の大きさは、共分散行列(各列の分散と、列同士が一緒に変動する程度を並べた行列)の固有値に対応します。今回の4点では、標本共分散を計算すると次の値になります。
分母はデータ数から1を引いた4−1=3です。例えばx1の二乗和は2²+1²+(−1)²+(−2)²=10なので、分散は10/3になります。この行列の固有値は、第1主成分が6、第2主成分が2/3です。
寄与率は、ある成分の分散を、すべての成分の分散の合計で割ります。
| 残す成分 | その成分の寄与率 | 累積寄与率 |
|---|---|---|
| 第1主成分 | 90% | 90% |
| 第2主成分も追加 | 第2主成分は10% | 100% |
累積寄与率は、先頭から採用した成分の寄与率を足した値です。今回1成分へ縮めると、元の座標系での分散の90%を残し、残り10%に当たる差を落とします。正解率90%でも、どんな目的にも必要な情報の90%を保持したという保証でもありません。
次元数は、目的別に評価する
| 目的 | 次元数を判断する材料 | 注意点 |
|---|---|---|
| 2次元で可視化したい | 第1・第2主成分の得点と累積寄与率 | 図に見えない方向の差が残っている |
| 元データを近似して保存したい | 累積寄与率と復元誤差 | どの単位・尺度で誤差を小さくしたいかを決める |
| 分類・回帰の前処理にしたい | PCAなしと、複数の成分数の検証結果 | 寄与率が高くても予測に必要な差を失いうる |
固有値の大きさを順に並べるスクリープロットも、減り方の変化を探す手掛かりになります。ただし、80%・90%・95%といった値は目的に合わせた候補であり、共通の正解ではありません。今回は2次元の説明例なので、大規模データの最適な成分数を示すものではありません。
単位を変えると、主成分も変わる
同じ4点のx1だけを100倍してみます。例えばmをcmへ変えるような、値の表し方の変更を想定します。対象そのものが変わらなくても、x1の分散は10,000倍になるため、標準化しないPCAはx1方向を強く重視します。
中心化は平均を引く処理、標準化はさらに各列の標準偏差で割り、ばらつきの尺度をそろえる処理です。scikit-learnのPCAは中心化を行いますが、標準化は自動では行いません。
| 入力条件 | 第1主成分の寄与率 | 読み方 |
|---|---|---|
| 元の4点 | 90.0000% | 2列を同じ尺度で扱った結果 |
| x1だけ100倍、標準化なし | 約99.9964% | 単位変更でx1の分散が支配的になった結果 |
| 100倍した後、各列を標準化 | 90.0000% | 単位による尺度差を取り除いた結果 |
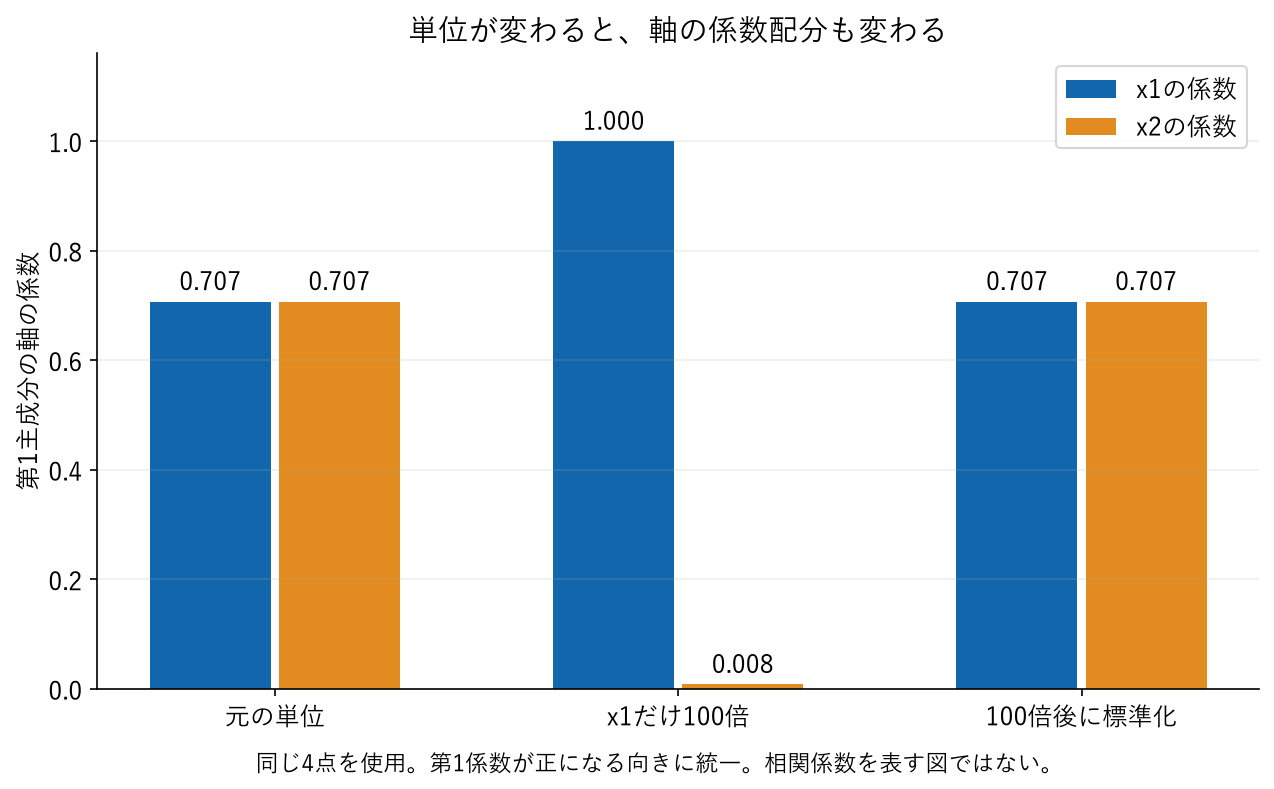
同じ4点を使った軸の係数の比較です。x1の単位を変えると係数が約1と0.008へ偏り、標準化後は約0.707ずつに戻ります。
99.9964%になったから、分析がよくなったわけではありません。何を大きな差とみなすかが変わったため、寄与率の分母も変わっています。異なる前処理の寄与率や復元誤差を、そのまま性能の順位として比べないようにします。
単位の違いを抑えて各項目を同程度に扱いたいなら、標準化が候補になります。一方、同じ単位で測定し、分散の大小そのものを残したい場合には、標準化しない選択もあります。小さいばらつきの列がノイズ中心なら、標準化でその影響を大きくする可能性もあります。公式の尺度変更の例でも、尺度による軸の変化と、標準化の効果がデータに依存する点を確認できます。
寄与率99%以上でも、予測に必要な情報を落とす例
PCAが目的変数を見ずに軸を選ぶ影響を、もう1つの人工データで確かめます。これは仕組みを明確にするための反例で、実データの性能比較ではありません。
学習用の値を、a = −20, −10, 10, 20とb = −1, 1の全組み合わせ8件で作ります。入力はそのままaとbにせず、次の2列へ変換します。
aのばらつきは大きく、bのばらつきは小さい設定です。元の2列はどちらも同じ分散125.5(8件で割る定義)を持つため、標準化しても大小の関係は変わりません。PCAの第1主成分はaに対応し、第2主成分はbに対応します。
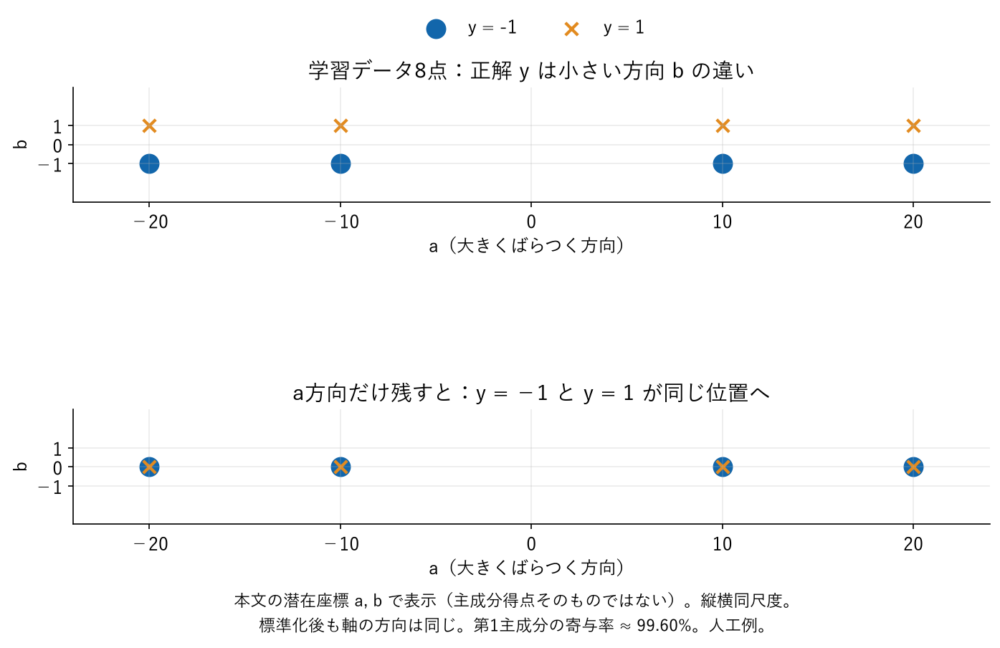
学習用8件をa・bの座標で表示しています。標準化後の主成分得点とは尺度が異なりますが、残す方向と失われる方向は同じです。
第1主成分の寄与率は250/(250+1) ≈ 99.60%です。しかし、予測したい値yはbなので、1成分だけ残すと予測に必要な差を捨てます。
検証用にはaを−15, −5, 5, 15へ変え、bは同じ2値とした8件を用意しました。標準化・PCA・線形回帰は学習用8件だけで学習し、検証用8件のyを予測した結果です。
| PCAで残す成分数 | 学習データの累積寄与率 | 検証RMSE(二乗平均平方根誤差) |
|---|---|---|
| 1 | 約99.60% | 1.000 |
| 2 | 100% | 約0.000 |
RMSEは予測誤差の二乗平均の平方根で、小さいほど誤差が小さい指標です。1成分のモデルは、bが−1か1かを区別できず、ほぼ0を予測します。2成分なら両方の入力情報が残り、ノイズのないこの例では線形回帰で再現できます。
これは「2成分なら高精度になる」という一般的な結果ではなく、低分散方向が予測に必要になるよう設計した例です。scikit-learnの主成分回帰の解説でも、低分散方向と目的変数が強く関係すると、PCAによる削減が予測に不利になることを扱っています。
Pythonで計算と変換範囲を確認する
以下は本記事用に作成したコードです。4点の射影・復元と、8点の予測例を再現します。Python 3.12.13、NumPy 2.5.4、scikit-learn 1.7.2で確認しています。
from itertools import product
from typing import Any
import numpy as np
from sklearn.decomposition import PCA
from sklearn.linear_model import LinearRegression
from sklearn.metrics import root_mean_squared_error
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

x: Any = np.array([[2., 1.], [1., 2.], [-1., -2.], [-2., -1.]])
pca = PCA(n_components=1, svd_solver="full").fit(x)
score = pca.transform(x)
restored = pca.inverse_transform(score)
print("寄与率:", pca.explained_variance_ratio_.round(4))
print("復元座標:", restored.round(3))

units = x * [100., 1.]
for name, data in [("元の単位", x), ("100倍", units),
                   ("100倍後に標準化", StandardScaler().fit_transform(units))]:
    ratio = PCA(svd_solver="full").fit(data).explained_variance_ratio_[0]
    print(name, f"{100*ratio:.4f}%")

train = np.array(list(product([-20., -10., 10., 20.], [-1., 1.])))
valid = np.array(list(product([-15., -5., 5., 15.], [-1., 1.])))
rotation = np.array([[1., 1.], [1., -1.]]) / np.sqrt(2)
for k in [1, 2]:
    # 検証側から軸や尺度を学ばないよう、変換も学習手順にまとめる。
    model = make_pipeline(
        StandardScaler(), PCA(n_components=k, svd_solver="full"), LinearRegression()
    )
    model.fit(train @ rotation, train[:, 1])
    pred = model.predict(valid @ rotation)
    ratio = model[1].explained_variance_ratio_.sum()
    error = root_mean_squared_error(valid[:, 1], pred)
print(k, f"累積寄与率={ratio:.4%}", f"RMSE={error:.3f}")実際の予測モデルで次元数を調整する場合は、PCAも含めて交差検証(分割を変えながら評価する方法)の学習側でやり直します。全データでPCAを学習してから分割すると、評価側の分布を軸の決定に使ったことになります。目的変数を使わない変換でも、この点は変わりません。Common pitfallsの前処理の原則と、データリークの確認方法を参照してください。
使う前に確認すること
| 確認する項目 | 判断へのつなげ方 |
|---|---|
| 欠損値と外れ値 | 補完方法や異常値の扱いを先に決める。大きな外れ値が分散を左右しないか確認する |
| 入力の単位と意味 | 尺度差を消したいのか、分散の大きさを残したいのかで標準化を選ぶ |
| 新しい軸の解釈 | 係数と得点を分け、主成分へ付けた名前を因果的な説明と扱わない |
| 次元数の目的 | 可視化、復元、予測のどの基準を満たしたいかを決める |
| 評価の範囲 | 予測用途ではPCAなしも比べ、次元数選択後に未使用データで評価する |
PCAは、入力が多いときに必ず入れる処理ではありません。変換によって何を見やすくし、何を失ってもよいかを決めて使います。次元数の比較と最終評価の分け方は、交差検証とモデル選択の解説で詳しく説明しています。
コード・数値例は独自に作成しています。利用ライブラリの条件はscikit-learnのCOPYING(BSD 3-Clause)で確認できます。
コメント