特徴量選択は、モデルへ渡す入力項目のうち、どの列を残すかを決める処理です。手軽な統計量で絞るフィルタ法、モデルを繰り返し学習するラッパー法、学習で得た係数や重要度を使う組み込み法があります。選ぶときは選択なしを基準に、予測誤差・残る列数・選択の安定性を比べます。
列を減らせば、計測やデータ管理の負担を下げられる場合があります。ただし、必要な情報まで落とすと予測が悪化するため、「少ないほどよい」とは限りません。この記事では3系統の違いを整理し、同じ合成データで比較した結果とPythonコードを示します。
特徴量選択は、元の入力列を残す方法
住宅価格を予測するなら、面積、築年数、駅までの距離などが特徴量(予測に使う入力項目)です。そのうち面積と築年数を残すのが特徴量選択です。
似た用語でも、得られるものが違います。
| 処理 | 得られるもの | 判断するときの注意 |
|---|---|---|
| 特徴量選択 | 元の列の部分集合 | 列を削った後のモデルを評価する |
| PCA(主成分分析)などの特徴変換 | 複数の列を組み合わせた新しい軸 | 元の列名や単位のまま説明しにくくなる |
| 特徴量重要度の計算 | 学習したモデルでの影響の指標 | 重要度だけでは削除後の予測性能が分からない |
選択と変換は、どちらも入力の次元を減らせますが、残る表現が異なります。元の項目名で管理したい場合は、特徴量選択が候補になります。scikit-learnのFeature selectionでも、入力の一部を選ぶ処理として各手法を説明しています。
3系統は「何を基準に残すか」で比べる
| 系統 | 選択基準と代表例 | 計算負担の傾向 | 得意なこと・弱点 |
|---|---|---|---|
| フィルタ法 | 分散、目的変数との関連など。SelectKBestなど | 最終モデルの反復学習を必要としないものが多い | 多数の候補を絞りやすい。単変量の方法では列同士の組み合わせを見落としうる |
| ラッパー法 | モデルを使って候補集合を探索。RFE、逐次選択など | 探索中に学習を繰り返す | モデルに合わせて探索できる。計算量が増え、別モデルで同じ選択がよいとは限らない |
| 組み込み法 | 学習で得られる係数や重要度。Lasso、木モデルなど | 使用するモデルと設定による | 学習結果を選択へ利用できる。尺度や閾値、モデルの性質に左右される |
フィルタ法:目的に合った統計量を選ぶ
SelectKBestは、指定したスコアで上位k列を残します。回帰のf_regressionは各列と目的変数の線形な関連を評価するため、単独では関連が弱くても、別の列との組み合わせで役立つ特徴量を取りこぼすことがあります。
フィルタ法でも目的変数を使う方法はあります。「モデルを学習しない」ことと「正解を使わない」ことは別です。スコアの選択条件は公式の単変量特徴量選択の説明で確認できます。
ラッパー法:RFEと交差検証を混同しない
RFE(再帰的特徴量除去)は、モデルを学習し、重要度の低い列を削って再学習する処理を繰り返します。通常のRFE自体は、検証データのスコアで残す列数を決めません。指定された列数まで除去します。
一方、scikit-learnのSequentialFeatureSelectorは候補集合を交差検証(データの分割を変えて評価する方法)で評価する方式です。RFECVは残す列数の選択に交差検証を使います。ラッパー法という名前だけで、評価方法や学習回数が同じとは考えないようにします。RFEの公式仕様には、これらの関連手法との違いも記載されています。
組み込み法:重要度を、列を残す規則へつなぐ
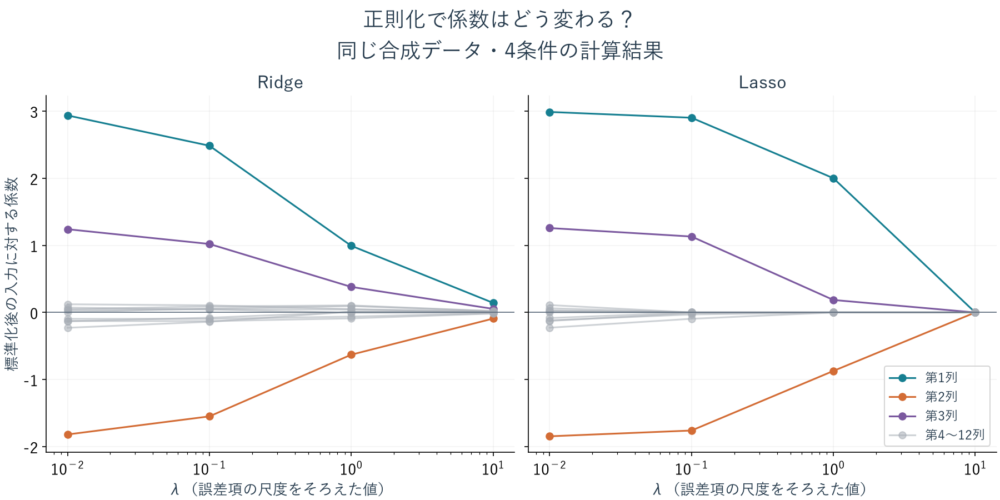
Lassoは、係数の一部を0にすることがあります。SelectFromModelと組み合わせると、係数の絶対値が閾値以上の列を取り出せます。今回の実験では、その列で別のRidge回帰を学習します。Lassoの予測値をそのまま比較する実験とは区別します。
木モデルからも重要度を得られますが、重要度が得られただけで列が自動削除されるわけではありません。どの閾値で残し、選択後に何を学習するかまで決めます。閾値の仕様はSelectFromModel、Lassoの仕組みは正則化とL1・L2の解説を参照してください。
同じデータで「選択なし」と比較する
12列・500件の合成回帰データを作り、先頭400件を開発用、残り100件を最終テスト用として分けました。開発用だけを5分割し、毎回320件で学習、80件で検証します。最終テスト100件は使っていません。
目的変数は3*x0 - 2*x1 + x2 + ノイズです。x3にはx0に小さなノイズを加えた値を入れ、残りは独立な乱数にしています。似た情報を持つ列と、目的変数の生成式に直接使っていない列が混在する条件です。
比較する4方式は、すべて学習側で標準化し、最後にRidge(alpha=1)を学習します。標準化は列の平均とばらつきをそろえる処理です。選択部分だけを次のように変えました。
| 方式 | 固定した設定 | 1分割あたりのモデル学習回数 |
|---|---|---|
| 選択なし | 12列を使用 | 1回 |
| フィルタ | SelectKBest(f_regression, k=4) |
1回。別に統計量を計算 |
| RFE | Ridge(alpha=1)で1列ずつ除去し、4列を残す |
選択用9回+予測用1回=10回 |
| Lasso選択 | Lasso(alpha=0.2)、係数の絶対値が1e-5以上 |
選択用1回+予測用1回=2回 |
RFEでは12、11、…、4列の9段階でモデルを学習します。表の回数は実行時の呼び出しでも確認しました。標準化やスコア計算の回数、最適化内部の反復数は含めていません。異なるアルゴリズムの1回は同じ時間ではないため、10回なら10倍遅いという意味でもありません。
列を減らした結果、誤差はどう変わったか
RMSE(予測誤差の二乗平均の平方根)は小さいほど、今回の目的変数に対する誤差が小さいことを表します。
| 方式 | 検証RMSEの平均 | 分割間の標準偏差 | 残った列数 | 選択集合の平均一致率 |
|---|---|---|---|---|
| 選択なし | 2.074 | 0.090 | 12 | 1.000 |
| フィルタ | 2.034 | 0.072 | 4 | 1.000 |
| RFE | 2.034 | 0.072 | 4 | 1.000 |
| Lasso選択 | 2.053 | 0.081 | 3〜5 | 0.710 |
フィルタとRFEは、5分割すべてで同じx0〜x3を残しました。最終モデルも同じなので、検証誤差も一致しました。この条件ではRFEの反復学習による追加の性能差は得られていません。
いずれの選択方式も、平均誤差は選択なしよりわずかに小さくなりました。ただし、単一の合成データと固定設定の結果です。標準偏差は5個のスコアのばらつきであり、信頼区間や手法間の有意差を表しません。4列やLassoの強さを結果を見て探索した比較でもなく、各方式の最良性能を示すものではありません。
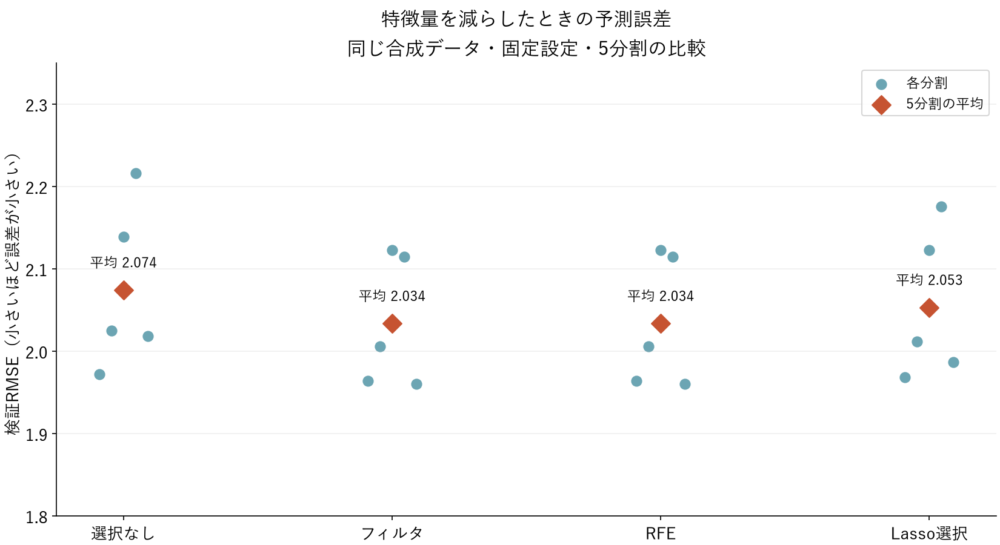
*点は各分割、菱形は平均。差を読めるよう縦軸は1.8から表示しています。独立テスト100件は未評価です。*
相関した列では「何度選ばれたか」も見る
今回のx0とx3の相関係数は、開発用データで約0.9985です。フィルタとRFEは両方を毎回残しました。Lasso選択ではx0は5回、x3は2回選ばれ、生成式に直接使っていないx4とx6も各1回残りました。
選択された列を「原因として必要な列」、削除された列を「無関係な列」と読むことはできません。有限の学習データで、指定した規則が残した結果です。採択頻度はその変動を見つけるために使います。
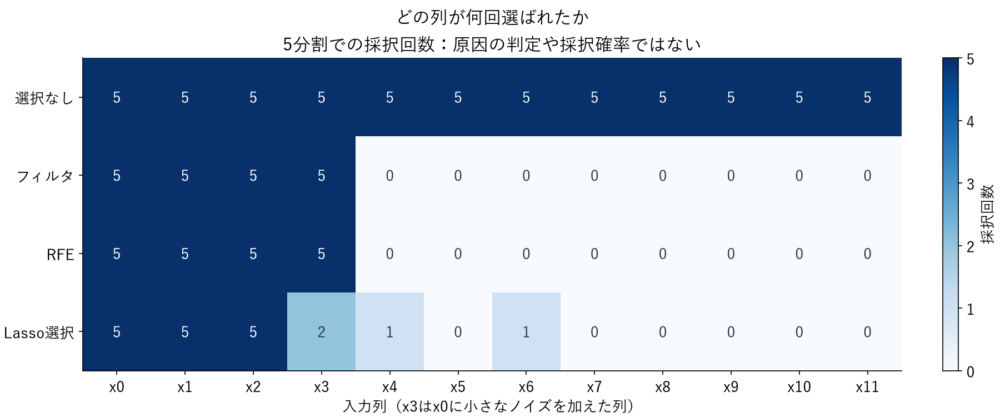
*同じ実験の採択回数。列ごとの因果的な必要性を表すものではありません。*
表の一致率は、2つの選択集合に共通する列数を、どちらかに含まれる列数で割ったJaccard係数です。例えば{x0,x1,x2}と{x0,x1,x2,x3}なら3/4=0.75です。5分割から作れる10組について平均しました。
全列を残せば一致率は必ず1になります。残す列数にも影響されるので、安定性の数字だけで手法を順位付けすることはできません。また、5分割の学習データは重なっています。今回の採択回数を、独立したデータを取り直したときの確率とみなすこともできません。
重要度による削除にも注意が必要です。相関列が似た情報を持つ場合、片方を入れ替えても他方で予測でき、置換重要度が低く見えることがあります。scikit-learnの相関特徴量の例もこの問題を扱っています。列や列のグループを除いたモデルを改めて評価し、削除の影響を確認します。
Pythonで比較を再現する
標準化と選択をPipeline(複数の処理を一つの学習手順にまとめる仕組み)に入れます。各分割で学習側だけにfitすることで、検証側の値や正解を選択へ混ぜない構成になります。Common pitfallsでも、特徴量選択を含む処理の情報混入を注意点として挙げています。
以下は独自に作成したコードです。Python 3.12.13、NumPy 2.5.4、scikit-learn 1.7.2で実行しています。公式サイトのstable版とはバージョンが異なるため、再現時はこの実行環境を基準にしてください。
from itertools import combinations
from typing import Any
import numpy as np
from sklearn.base import clone
from sklearn.feature_selection import SelectKBest, f_regression, RFE, SelectFromModel
from sklearn.linear_model import Ridge, Lasso
from sklearn.metrics import root_mean_squared_error
from sklearn.model_selection import KFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(42)
x: Any = rng.normal(size=(500, 12))
x[:, 3] = x[:, 0] + rng.normal(scale=0.05, size=500)
y: Any = 3*x[:, 0] - 2*x[:, 1] + x[:, 2] + rng.normal(scale=2, size=500)
# 最終テスト100件を手法の比較・調整に使わないため、開発用だけを取り出す。
x, y = x[:400], y[:400]
selectors: dict[str, Any] = {
    "選択なし": "passthrough",
    "フィルタ": SelectKBest(f_regression, k=4),
    "RFE": RFE(Ridge(alpha=1), n_features_to_select=4, step=1),
    "Lasso選択": SelectFromModel(
        Lasso(alpha=0.2, max_iter=10000, tol=1e-8), threshold=1e-5
    ),
}
splits = list(KFold(5, shuffle=True, random_state=7).split(x))
for name, selector in selectors.items():
    scores: list[float] = []
    sets: list[set[int]] = []
    for train, valid in splits:
        # 各分割で独立に学習し、検証側から前処理へ情報を戻さない。
        model = make_pipeline(
            StandardScaler(),
            selector if isinstance(selector, str) else clone(selector),
            Ridge(alpha=1),
        )
        model.fit(x[train], y[train])
        scores.append(float(root_mean_squared_error(y[valid], model.predict(x[valid]))))
        selected = range(12) if isinstance(selector, str) else model[1].get_support(indices=True)
        sets.append(set(int(j) for j in selected))
    agreement = np.mean([len(a & b)/len(a | b) for a, b in combinations(sets, 2)])
    print(name, f"RMSE={np.mean(scores):.3f}", f"SD={np.std(scores):.3f}",
          f"列数={min(map(len, sets))}〜{max(map(len, sets))}", f"一致率={agreement:.3f}")
    print("採択回数:", [sum(j in s for s in sets) for j in range(12)])
ここではRFEの残す列数やLassoの強さを固定しています。これらを調整するなら、検証用の分割をさらに設けるか、外側を性能評価、内側を調整に使う入れ子の交差検証を検討します。内側でも標準化と選択をまとめて学習させます。分割前に全件で列を選んでから同じデータを交差検証すると、Pipelineを後から置いても混入は解消できません。
具体的な混入例はデータリークの解説、評価用と調整用の分け方は交差検証の解説で説明しています。
残す列を決めるときの判断
| 状況 | 最初に比較したい案 | 採用前に確かめること |
|---|---|---|
| 列が多く、探索に時間をかけにくい | 選択なしと単純なフィルタ | 統計量がデータ型や関係に合うか。絞りすぎていないか |
| 使うモデルが決まり、探索の余力がある | RFEや逐次選択 | 学習回数と、より単純な選択を上回る価値があるか |
| 係数や木の重要度を利用したい | 組み込み法を使う選択 | 閾値・入力尺度・選択後のモデルを含めて評価したか |
| 取得に費用がかかる入力を減らしたい | 取得費用も考慮した候補集合 | 許容する予測誤差と、実際に省ける計測・運用負担 |
| 分割を変えると列が大きく入れ替わる | 相関列のグループと採択頻度の確認 | 予測は安定しているか。欠損率や取得しやすさも含めて判断できるか |
選択はモデルの統計的な都合だけでは完結しません。予測する時点で値を取得できるか、将来も同じ品質で用意できるかを確認します。例えば集計後にしか分からない値は、検証スコアが高くても予測時の入力には使えません。
採用条件を決めたら、選択手順とパラメータを固定して開発用データで学習し、最後に未使用のテストで評価します。今回の実験はその前段階の比較です。まず全列の基準を作り、削った後の誤差と運用負担が目的に合うかを確かめると、列を減らす理由が明確になります。
コードと合成データは本記事用に作成しました。利用ライブラリのライセンスはscikit-learnのCOPYING(BSD 3-Clause)で確認できます。
コメント