ハイパーパラメータ調整は、モデルの学習方法や複雑さを決める設定を複数試し、検証結果から選ぶ作業です。候補が少なく、比較したい値が明確ならグリッドサーチ、連続値の広い範囲を決めた候補数で調べたいならランダムサーチが使いやすくなります。手法を選ぶ前に、探索範囲・評価指標・試行予算を固定することが出発点です。
この記事では、同じ16候補・同じ3分割で2手法を比較します。限られた候補数をどの値へ配るか、その結果が乱数でどう変わるかを、独自データと実行コードで確認します。
ハイパーパラメータは、学習の条件を決める設定
学習で求める係数や重みと、その学習の条件を決める値は役割が異なります。scikit-learnの探索ガイドでは、推定器の学習で直接求めない設定をハイパーパラメータとして扱っています。人が決めるだけでなく、探索プログラムから候補を与えることもできます。
| 種類 | 例 | 決める工程 |
|---|---|---|
| 学習されるパラメータ | 線形回帰の係数、ニューラルネットワークの重み | 与えた設定と学習データから求める |
| ハイパーパラメータ | 正則化の強さ、木の最大深さ、PCAの成分数 | 候補を与えて学習・検証し、採用する値を選ぶ |
例えば、PCAで残す成分数も、予測モデルの前処理として使うなら調整候補になります。ただし、調整可能な値をすべて同時に動かす必要はありません。目的に関係する少数の設定から始めると、何を変えて成績が動いたのかを追いやすくなります。
この記事の比較では、SVC(サポートベクトル分類器)のRBFカーネル(距離に応じて類似度を計算する仕組み)を使います。調整するのはCとgammaの2つです。
| 設定 | 変える意味 | 値を解釈するときの注意 |
|---|---|---|
| C | 大きくすると正則化が弱くなる | Ridgeなどのalphaは大きいほど正則化が強くなり、向きが逆 |
| gamma | 大きくすると距離による類似度の減衰が速くなり、近い点の影響が中心になる | 入力の尺度で距離も変わるため、前処理と一緒に考える |
定義はSVCの公式仕様、罰則の考え方は正則化の解説を参照してください。以下の探索範囲は、この人工データで仕組みを確認するための設定です。別のデータでもよい値になるという推奨ではありません。
候補を作る前に、学習回数を数える
グリッドサーチは、指定した候補値の組み合わせをすべて試します。Cを4種類、gammaを4種類にすると、候補は4×4=16通りです。2つの値にそれぞれ10候補を与えれば100通りになり、同じ10候補の設定をもう1つ追加すれば1,000通りになります。
1候補を3分割の交差検証(学習側と検証側を交代させて測る方法)で評価し、選択後に1回再学習する場合、モデルの学習回数は次のとおりです。
最後の1回は、選ばれた設定で探索へ渡した開発用データ全体を学習し直すrefitです。GridSearchCVの公式仕様では、refit=Trueでこの再学習を行います。
| 比較軸 | グリッドサーチ | ランダムサーチ |
|---|---|---|
| 候補の作り方 | 指定した候補値の組み合わせ | 指定した分布やリストから抽出 |
| 候補数 | 候補値の直積で決まる | n_iterで指定する |
| 向く場面 | 少数の候補を漏れなく比較したい | 広い範囲を決めた候補数で調べたい |
| 弱点 | 設定や候補値を増やすと組み合わせが増える | 乱数によって探索点が変わり、よい領域を外す場合がある |
| 最適という意味 | 指定した候補集合で選んだ評価指標が最良 | 今回抽出した候補集合で選んだ評価指標が最良 |
ランダムサーチを16候補にしても、同じ3分割・再学習ありなら49回です。同じ学習回数を割り当てられますが、値によって学習の重さが違うため、同じ秒数になるとは限りません。ここで数えるのはモデルのfit呼び出しで、内部の反復計算数や並列実行時間ではありません。
探索範囲は、下限・上限と刻みをセットで決める
範囲を広くしただけで、よい候補を十分に調べられるわけではありません。試す点をどの領域へ配るかまで決める必要があります。
桁が違う正の値は、対数で考える
例えば0.001から10までを探索するとき、線形の等間隔では大きな値の側へ候補が偏ります。対数刻みは、0.001、0.01、0.1、1、10のように、一定の倍率で値を増やす考え方です。
ランダムサーチでも同じ違いがあります。範囲[0.001, 10]について、線形一様分布と対数一様分布から値を抽出する場合を比べます。
| 区間 | 線形一様分布で入る確率 | 対数一様分布で入る確率 |
|---|---|---|
| 0.001〜0.01 | 約0.09% | 25% |
| 0.01〜0.1 | 約0.90% | 25% |
| 0.1〜1 | 約9.00% | 25% |
| 1〜10 | 約90.01% | 25% |
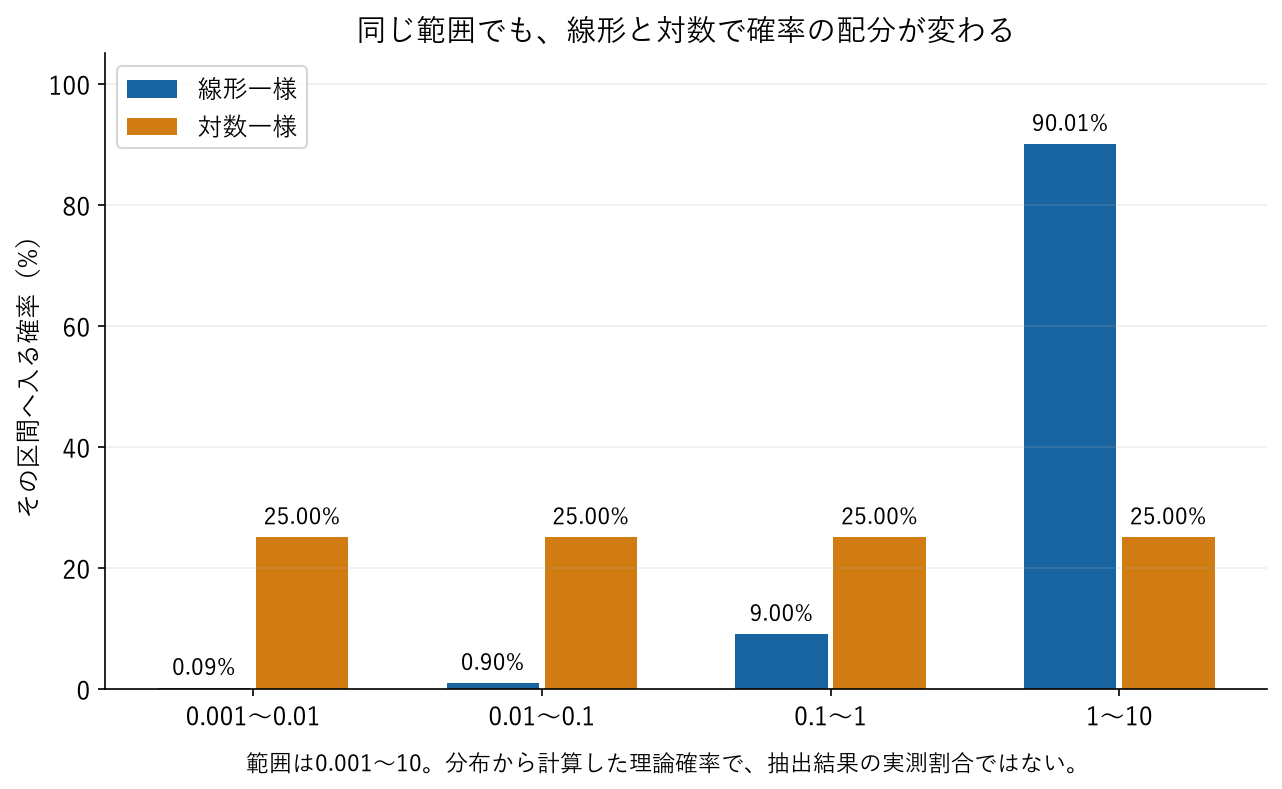
対数一様分布では、同じ倍率幅の区間へ等しい確率を配ります。
線形一様分布では、例えば1〜10の区間は(10−1)/(10−0.001) ≈ 90.01%を占めます。対数一様分布では、どの区間も10倍の幅なので25%ずつです。これは乱数を引いた実測割合ではなく、分布から計算した確率です。
SciPyのloguniformは、この対数一様分布を表します。下限と上限には正の値が必要です。0を試す意味がある設定では、0を別候補にするなど、分布とは分けて設計します。
値の意味に合わせて候補を作る
| 設定の性質 | 候補の作り方 | 避けたい扱い |
|---|---|---|
| 正則化など、何桁も動かす正の連続値 | 対数間隔の候補、またはloguniform | 広い範囲を線形で均等に埋めるだけにする |
| 木の深さ・近傍数などの整数 | 意味のある整数リスト、整数分布 | 連続値をそのまま渡す |
| モデルの種類などのカテゴリ | 有効な選択肢のリスト | 文字列へ大小関係を持たせる |
| 他の設定によって有効・無効が変わる値 | 有効な組み合わせを辞書のリストで分ける | 無意味・無効な組み合わせに予算を使う |
範囲の根拠には、公式仕様上の有効範囲、既定値、入力の尺度、過去の開発用データでの結果を使います。範囲を絞る段階も調整の一部なので、最終テストの成績を見て決めないようにします。
同じ16候補で、探索する点と成績を比べる
独自に作成した比較では、半月形の2クラスを生成するmake_moonsを使いました。600件から開発用450件と保留150件へ層化分割(クラスの比率を保つ分割)し、保留側では評価していません。
開発用450件の3分割を固定し、各候補の正解率を測ります。標準化はPipeline(前処理とモデルを一続きにする仕組み)の中で実行しました。候補評価時は学習側300件だけで標準化し、検証側150件へその変換を適用します。最後の再学習だけは開発用450件を使います。
| 条件 | 設定 |
|---|---|
| データ | make_moons、600件、noise=0.25、random_state=42 |
| 開発用・保留の分割 | 450件・150件、層化、random_state=17 |
| 候補評価 | StratifiedKFold、3分割、shuffle=True、random_state=23 |
| モデル | StandardScaler → RBF SVC |
| Cの範囲 | 0.01〜100 |
| gammaの範囲 | 0.001〜10 |
| グリッド | 各範囲から対数上で等間隔の4点、4×4=16候補 |
| ランダム | 各範囲のloguniformから16候補。探索のseedを0〜4へ変更 |
| 並列・再学習 | n_jobs=1、refit=True、キャッシュなし |
グリッドのCは約0.01, 0.2154, 4.6416, 100、gammaは約0.001, 0.02154, 0.4642, 10です。ここで「4点」は端点を含む4候補を意味します。
16候補でも、1つの設定に試す値の種類数が違う
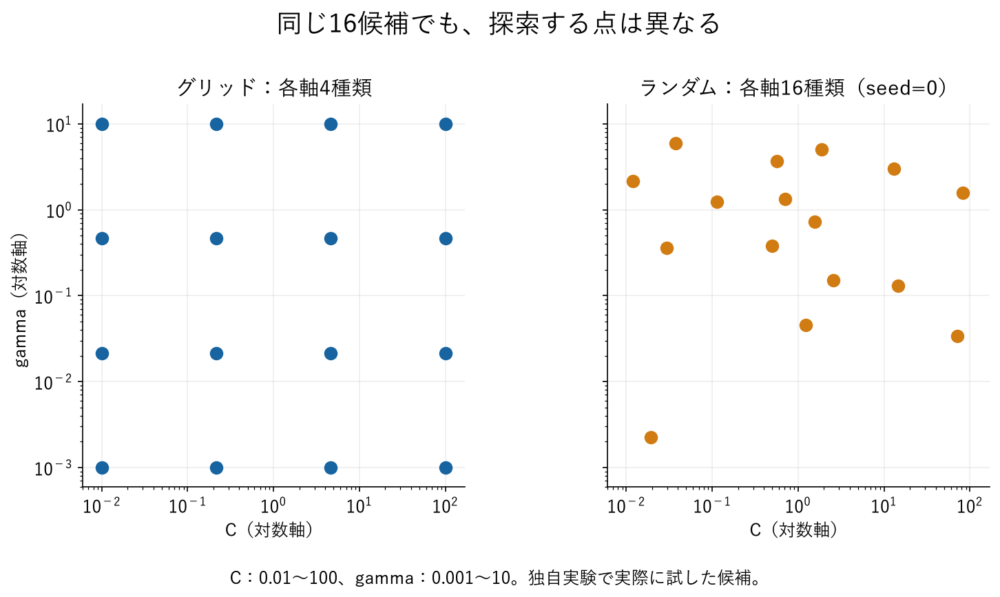
実際に試した候補の座標です。両図の範囲と対数目盛りをそろえています。
グリッドは4種類のCを、4種類のgammaそれぞれと組み合わせます。一方、今回の連続分布からのランダム抽出では、16候補に16種類のCと16種類のgammaが含まれました。
この違いは、特定の設定に効く値が限られている場合の探索効率に関わります。BergstraとBengioの論文は、一部の設定が性能を強く左右する状況とランダム探索の有効性を報告しています。ただし、今回のデータでランダム探索が必ず優れるという根拠にはなりません。
また、RandomizedSearchCVの仕様では、全設定をリストで与える場合は組み合わせを重複させずに抽出し、分布を含める場合は復元抽出(前に選んだ候補を除外しない抽出)になります。連続分布を使った本例で16種類ずつ得られたことと、いつでも重複がないことは分けて考えます。
ランダムサーチの5回を合算して勝敗を決めない
| 探索 | 選択されたC | 選択されたgamma | 選択候補の平均CV正解率 | モデル学習回数 |
|---|---|---|---|---|
| グリッド | 100 | 0.4642 | 94.44% | 49 |
| ランダム seed=0 | 1.8715 | 5.0395 | 94.44% | 49 |
| ランダム seed=1 | 32.0300 | 3.7881 | 94.00% | 49 |
| ランダム seed=2 | 0.0547 | 1.3847 | 91.11% | 49 |
| ランダム seed=3 | 80.1644 | 0.4893 | 94.44% | 49 |
| ランダム seed=4 | 77.7566 | 0.7232 | 94.44% | 49 |
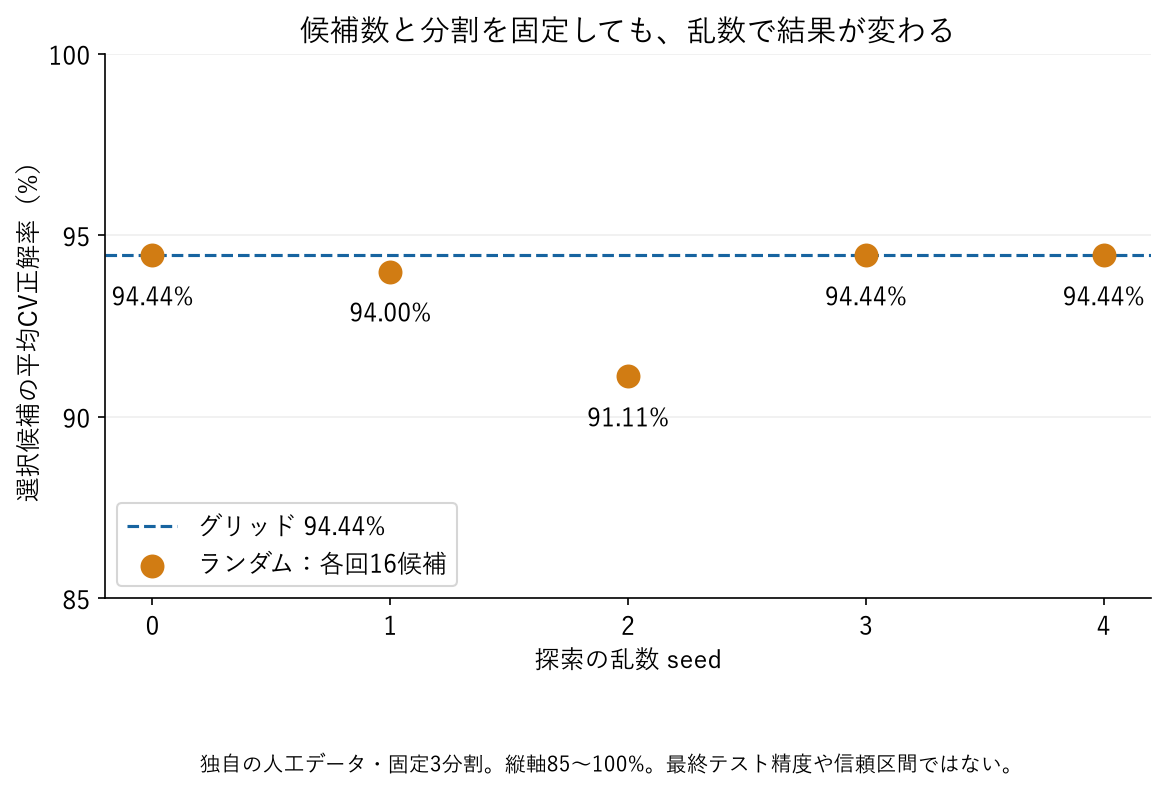
グリッド1回とランダム5回の選択CV値です。各回は16候補であり、最終テスト精度を比較した図ではありません。
CVは交差検証の略です。数値はその探索で選択された候補の3分割平均で、最終テストの正解率ではありません。グリッドでは、Cの上限100が選ばれました。100は今回の候補内で選ばれた値です。範囲を広げれば改善するとは限らないため、上限付近の候補と追加費用を点検します。
ランダム探索は同じ16候補でも91.11〜94.44%へ変動しました。5回の中からよかった回だけを抜き出せば、その選択にも予算を使ったことになります。今回は各回を独立した16候補の探索として並べ、80候補を試した結果を16候補のグリッドに対する優位性とは扱いません。
6探索の合計は294回です。モデルと標準化の呼び出しを記録し、各探索について300件で48回、450件で1回の学習になったことを確認しました。データ・分割・探索範囲は結果に合わせて変更していません。
Pythonで再現し、best_score_の範囲を確認する
掲載コードは本記事用に作成しました。Python 3.12.13、NumPy 2.5.4、scikit-learn 1.7.2で実行しています。
from typing import Any
import numpy as np
from scipy.stats import loguniform
from sklearn.datasets import make_moons
from sklearn.model_selection import (
    train_test_split, StratifiedKFold, GridSearchCV, RandomizedSearchCV,
)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = make_moons(n_samples=600, noise=0.25, random_state=42)
dev, holdout = train_test_split(
    np.arange(len(X)), test_size=0.25, stratify=y, random_state=17
)
cv = list(StratifiedKFold(3, shuffle=True, random_state=23).split(X[dev], y[dev]))
# 各分割の検証データから尺度を学ばないよう、前処理を内側に置く。
model = Pipeline([("scale", StandardScaler()), ("svc", SVC(kernel="rbf"))])
common: dict[str, Any] = dict(
    estimator=model, cv=cv, scoring="accuracy", refit=True,
    n_jobs=1, error_score="raise",
)
grid = {"svc__C": np.logspace(-2, 2, 4), "svc__gamma": np.logspace(-3, 1, 4)}
space = {"svc__C": loguniform(1e-2, 1e2), "svc__gamma": loguniform(1e-3, 1e1)}
for seed in [None, 0, 1, 2, 3, 4]:
    search = (
        GridSearchCV(param_grid=grid, **common) if seed is None else
        RandomizedSearchCV(param_distributions=space, n_iter=16,
                           random_state=seed, **common)
    )
    search.fit(X[dev], y[dev])
    print(seed, f"CV={search.best_score_:.2%}", search.best_params_)
    count = len(search.cv_results_["params"])
    print("候補数:", count, "学習回数の見積もり:", count * len(cv) + 1)
# 保留データは探索方法の比較や範囲の決定に使わない。best_params_は選ばれた設定、best_score_はその候補の交差検証平均です。探索した範囲の外や、候補点の間まで最良と保証する値ではありません。cv_results_には他の候補の結果もあるので、最良の1行だけでなく、近い設定の成績、分割間の変動、失敗した候補を確認します。
この例では失敗を見逃さないようerror_score="raise"を指定しました。候補数を上限として探索を終えますが、経過秒数による自動停止は設定していません。長い探索では、短い試行から費用を見積もり、候補数を減らす、段階に分ける、終了制御のある別の実行基盤を使うといった判断が必要です。
前処理を全データへ先に適用すると、検証側の情報が候補評価へ混ざります。scikit-learnの前処理の注意とデータリークの確認方法で、Pipelineに含める範囲を確認してください。
予算を使い切ったら、範囲と目的を見直す
| 観測した状態 | 次の判断 |
|---|---|
| 最良候補が上限・下限にある | 公式仕様・費用・周辺候補の結果を確認し、必要なら開発用データで範囲を広げる |
| よい候補が狭い領域へ集まる | 追加予算を決め、その領域で細かく比較する |
| 乱数によって結果が大きく動く | 1回の成功だけで手法を選ばず、候補数や分布の妥当性を点検する |
| 設定を変えても目的の改善が得られない | データ・特徴量・モデルの選択へ戻る。探索だけを続けない |
| 時間・候補数の上限に達した | その時点の結果と範囲を記録して終了し、追加探索は別の予算として扱う |
範囲を変えたり探索を追加したりするほど、同じ検証データに合わせ込む余地が増えます。採用する手順を固めてから未使用データで評価する流れは、交差検証と最終評価の解説で扱っています。
探索の記録には、候補範囲と分布、候補数、分割、指標、乱数、前処理、終了理由を残します。そうすると、成績が上がった理由を検討するときにも、値の変更と予算の増加を区別できます。
数値例・コード・図は本記事用の独自作成です。利用ライブラリの条件はscikit-learnのCOPYINGを参照してください。
コメント