正則化(せいそくか)は、学習データへの当てはまりだけを追いすぎないよう、モデルの学習に制約を加える考え方です。 代表的なL1・L2正則化は、予測の誤差に加えて、係数の大きさにも罰則を与えます。
線形回帰では、L1を使うのがLasso(ラッソ回帰)、L2を使うのがRidge(リッジ回帰)です。使う入力を絞れるか確かめたいならLasso、入力を残しながら係数を抑えたいならRidgeを比較します。どちらも、正則化を強めるほど予測がよくなるわけではありません。
この記事では、罰則の計算、標準化の理由、同じ合成データでの比較を順に確認します。過学習そのものの見分け方や、データ追加・早期終了を含む対策は過学習の原因と対策の選び方で扱っています。
L1は係数の絶対値、L2は二乗に罰則を与える
回帰モデルは、入力となる特徴量(予測に使う値)に係数を掛けて予測値を作ります。正則化を使うと、その係数を大きくして学習データへ合わせることにも負担が生じます。
| 比較軸 | L1正則化・Lasso | L2正則化・Ridge |
|---|---|---|
| 罰則の基本形 | 係数の絶対値の和 | 係数の二乗和 |
| 係数の傾向 | 一部がちょうど0になり得る | 全体として大きな係数を抑える |
| 比較する目的 | 少ない入力で予測できるか確認する | 入力を残しながら過度な適合を抑える |
| 主な注意 | 相関する入力があると、残る入力が変わり得る | 不要な入力を自動で取り除く目的には向かない |
Lassoで係数が0になることを、疎(スパース)な係数になると表現します。ただし、選ばれなかった入力が現実に無関係だと証明されたわけではありません。残る入力は、データ、ほかの入力との関係、正則化の強さに左右されます。scikit-learn:線形モデルとLasso
Ridgeも「どんなデータでも各係数が必ず同じ割合で小さくなる」「係数が絶対に0にならない」という意味ではありません。Lassoのように係数を0へ落として入力を選ぶことを主目的とせず、二乗和に罰則を与える方法として捉えます。
係数が3と−1なら、罰則はいくらになる?
ここでは説明用に、2つの係数を \(w=(3,-1)\)、罰則の強さを \(\lambda=0.2\) とします。学習結果ではなく、式への代入例です。
| 手法 | 係数から求める値 | 強さを掛けた罰則 |
|---|---|---|
| L1 | \(\lvert3\rvert+\lvert-1\rvert=4\) | \(0.2\times4=0.8\) |
| L2 | \(3^2+(-1)^2=10\) | \(0.2\times10=2.0\) |
仮に予測誤差の項が1.5なら、罰則を加えた目的関数はL1で2.3、L2で3.5です。ただし、この大小から「L1の予測が優れる」とは判断できません。異なる罰則を足しているため、合計値には予測誤差以外の違いも含まれます。
1つの係数を動かした場合、L1の \(|w|\) は直線的に、L2の \(w^2\) は曲線的に増えます。0の近くと大きな係数では、罰則の増え方が異なります。
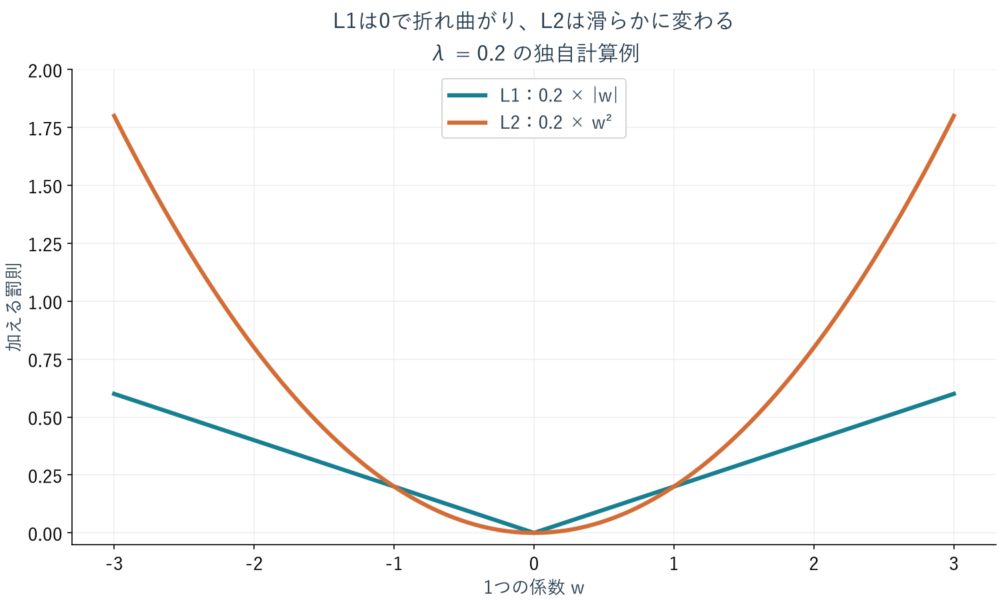
*1係数に対する罰則の独自計算例。2係数の代入表とは対象を分けています。*
L1は0のところで折れ曲がるため、誤差を減らす方向と罰則が釣り合ったとき、係数がちょうど0になる範囲ができます。L2は0の近くでも滑らかに変わります。なお、L2ノルム自体は二乗和の平方根ですが、ここでのL2正則化は平方根を取らない二乗和を使います。scikit-learn:Ridgeの目的関数、Lassoの目的関数
比較前に、入力の尺度とalphaの意味をそろえる
正則化と正規化・標準化は、変更する対象が違う
正則化はモデルを学習するときの制約です。一方、正規化や標準化は、入力データなどの尺度を変える処理を指します。正規化には値を一定範囲へ収めたり、ベクトルの長さをそろえたりする用法があります。この記事では、各列から学習データの平均を引き、標準偏差で割る標準化を使います。
たとえば「長さ1mに係数3を掛ける予測」と「長さ100cmに係数0.03を掛ける予測」は、どちらも3です。しかし係数だけを見ると、二乗は9と0.0009で大きく違います。予測が同じでも、単位によって罰則の受け方が変わるわけです。
このため、Ridge・Lassoを比較するときは列の尺度を確認します。標準化は一般的な出発点ですが、外れ値や変数の意味によって前処理を検討する必要があります。scikit-learn:StandardScaler
平均と標準偏差を求めるのは学習データだけにします。検証データには、その値を使って変換します。全データで先に標準化すると、検証側の情報が学習へ混ざります。具体例は機械学習のデータリークと防止策を参照してください。
RidgeとLassoでは、同じalphaでも尺度が違う
scikit-learnでは、RidgeとLassoの両方に alpha という引数があります。しかし、誤差の足し方が異なります。ここで \(n\) は学習件数、SSEは予測誤差の二乗を全件で足した値です。
| 実装 | 最小化する目的関数 |
|---|---|
| Ridge | \(\mathrm{SSE}+\alpha\sum_j w_j^2\) |
| Lasso | \(\mathrm{SSE}/(2n)+\alpha\sum_j\lvert w_j\rvert\) |
Ridgeの式全体を \(2n\) で割っても、最小にする係数は変わりません。そこで両方を「SSE/(2n)+λ×罰則」という尺度で書くと、対応は次のようになります。
- Ridge:\(\alpha=2n\lambda\)
- Lasso:\(\alpha=\lambda\)
たとえば学習240件で \(\lambda=0.1\) なら、Ridgeのalphaは48、Lassoは0.1です。これは誤差項の尺度をそろえる換算であり、同じλなら係数の数・予測精度・複雑さまで同じになる、という保証ではありません。 罰則の形は異なるので、それぞれ検証して選びます。式の定義はRidge公式仕様とLasso公式仕様に基づきます。
別のモデルへ設定を移すときも、パラメータ名だけで判断しないようにします。たとえば LogisticRegression の C は、小さいほど正則化が強い方向です。scikit-learn:LogisticRegressionのC
同じデータで、係数と予測誤差を比べる
筆者作成の合成データで、正則化なしの通常の最小二乗回帰(OLS)と、Ridge・Lassoを比較しました。実業務の性能を測ったものではなく、強さを変えたときの挙動を確かめる例です。
| 条件 | 設定 |
|---|---|
| 入力 | 標準正規分布から生成した400件・12列、乱数seedは42 |
| 正解の作り方 | 第1列×3 − 第2列×2 + 第3列 + 正規分布のノイズ(標準偏差2) |
| 分割 | 先頭240件で学習、続く80件で検証、残り80件は未使用の最終テスト用 |
| 前処理 | 学習240件だけで標準化の値を求める |
| 比較する強さ | λ=0.01、0.1、1、10を事前に固定 |
| 評価値 | RMSE(二乗誤差の平均の平方根)。小さいほど予測誤差が小さい |
今回は独立に生成した行なので、この固定分割を使っています。時系列や同じ対象の繰り返し観測へ、そのまま流用する分割方法ではありません。RMSEには正則化の罰則を含めず、切片(入力が0のときの定数部分)は罰則の対象にしていません。
| モデル | λ | 実装のalpha | 学習RMSE | 検証RMSE | 0でない係数の数 |
|---|---|---|---|---|---|
| OLS | ― | ― | 1.929 | 1.995 | 12 |
| Ridge | 0.01 | 4.8 | 1.930 | 1.996 | 12 |
| Ridge | 0.1 | 48 | 2.031 | 2.093 | 12 |
| Ridge | 1 | 480 | 3.147 | 3.151 | 12 |
| Ridge | 10 | 4800 | 4.058 | 3.997 | 12 |
| Lasso | 0.01 | 0.01 | 1.929 | 1.981 | 11 |
| Lasso | 0.1 | 0.1 | 1.954 | 1.897 | 6 |
| Lasso | 1 | 1 | 2.616 | 2.456 | 3 |
| Lasso | 10 | 10 | 4.223 | 4.148 | 0 |
この条件では、検証RMSEが最も小さいのはLassoのλ=0.1でした。ただし、これは今回の単一分割・候補範囲での結果です。独立テストを評価していないため、選んだモデルの最終性能はまだ分かりません。
Ridgeは今回の4設定でOLSを上回っていません。Lassoも、λ=1では0でない係数が3個まで減りましたが、検証RMSEはλ=0.1より大きくなりました。列数を減らすことと、予測誤差を減らすことは別の判断です。λ=10では全係数が0になり、切片だけの予測になっています。
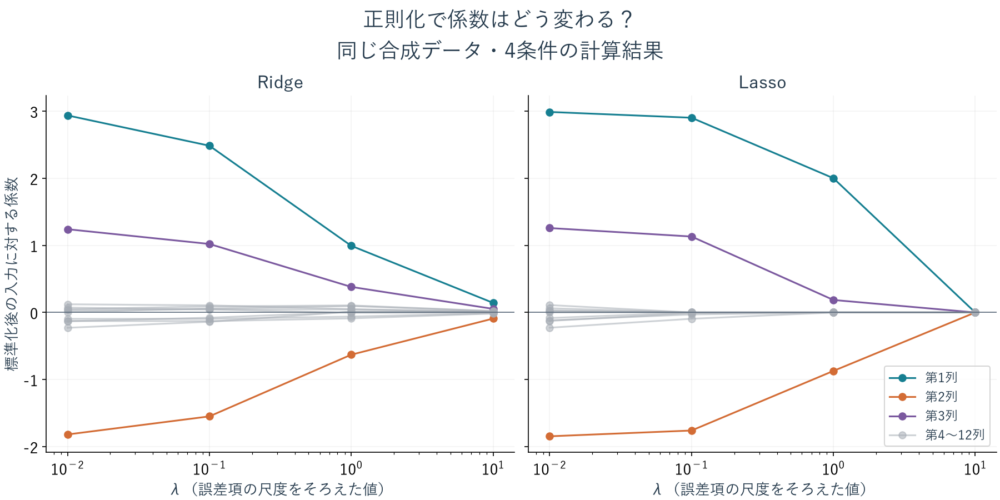
*各手法4点の計算結果を線で結んでいます。灰色の線は第4〜12列。点の間を追加で学習した結果ではありません。*
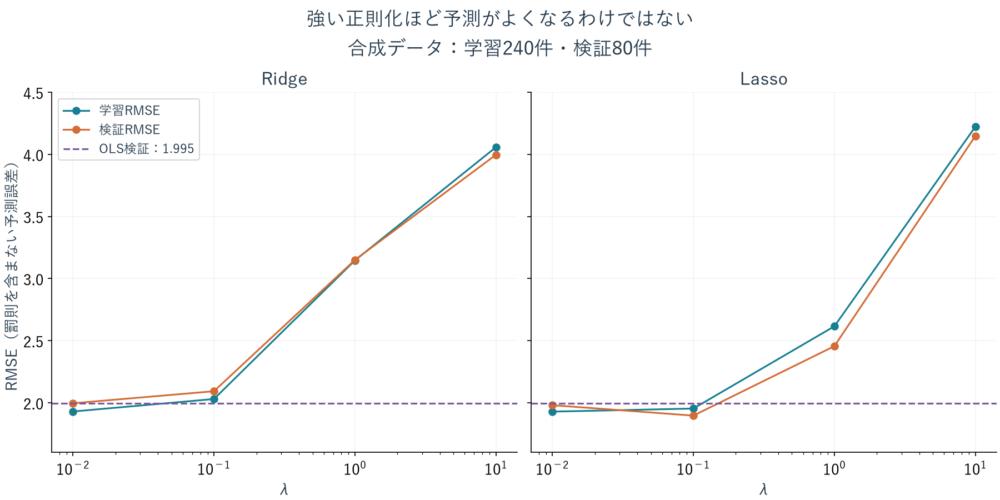
*同じ9条件の予測誤差。破線はOLSの検証RMSEです。独立テスト80件は未評価。*
Pythonで再現する
以下は比較表を出力する独自コードです。Python 3.12.13、NumPy 2.5.4、scikit-learn 1.7.2で実行しました。Pipeline(前処理とモデルをまとめて適用する仕組み)で、学習側だけに標準化の学習を限定します。scikit-learn:前処理とデータリークの注意
from typing import Any
import numpy as np
from numpy.typing import NDArray
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.metrics import root_mean_squared_error
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng: np.random.Generator = np.random.default_rng(42)
X: NDArray[np.float64] = rng.normal(size=(400, 12))
y: NDArray[np.float64] = (
    3 * X[:, 0] - 2 * X[:, 1] + X[:, 2]
    + rng.normal(scale=2, size=400)
)
train: slice = slice(0, 240)
valid: slice = slice(240, 320)
# 最後の80件は、設定を選ぶ間は評価に使わない。
grid: list[float] = [0.01, 0.1, 1.0, 10.0]
models: list[tuple[str, Any]] = [("OLS", LinearRegression())]
for name in ["Ridge", "Lasso"]:
    for lam in grid:
        # RidgeもSSE/(2n)の尺度になるようalphaを換算する。
        estimator: Any = (
            Ridge(alpha=2 * 240 * lam, solver="svd")
            if name == "Ridge"
            else Lasso(alpha=lam, max_iter=10000, tol=1e-10)
        )
        models.append((f"{name} lambda={lam}", estimator))

for name, estimator in models:
    pipe: Any = make_pipeline(StandardScaler(), estimator)
    pipe.fit(X[train], y[train])
    train_rmse: float = root_mean_squared_error(
        y[train], pipe.predict(X[train])
    )
    valid_rmse: float = root_mean_squared_error(
        y[valid], pipe.predict(X[valid])
    )
    nonzero: int = int(np.count_nonzero(pipe[-1].coef_))
    print(f"{name}: {train_rmse:.3f}, {valid_rmse:.3f}, {nonzero}")
出力はモデル名、学習RMSE、検証RMSE、0でない係数数の順です。丸め表示された係数を数え直すのではなく、学習結果の配列で0かどうかを数えています。
手法と強さを選ぶときに確認すること
| 状況 | 比較する候補・確認点 | 引き換えになる点 |
|---|---|---|
| 多くの入力を残して係数を抑えたい | Ridgeを正則化なしと比較する | 入力項目を減らす効果は期待しにくい |
| 少ない入力でも予測できるか調べたい | Lassoで係数数と検証誤差を確認する | 強めると必要な信号まで弱める可能性がある |
| よく似た入力が複数ある | 分割を変えたときの係数も確認し、Elastic Net(L1とL2の併用)を候補にする | 調整する設定が増える |
| 学習・検証の誤差がともに大きくなった | 正則化を弱めた条件と比較する | 弱めすぎると学習データへの適合が増える |
設定を選ぶときは、罰則込みの合計値だけでなく、同じ検証データの予測誤差を比べます。単一分割への依存が気になる場合は、交差検証の仕組みとモデル選択での注意点に沿って、前処理ごと分割の内側で学習します。
今回の換算式を交差検証へ使うなら、Ridgeの \(n\) は各回の学習件数です。全データ件数で換算して、平均損失に対するλが一定だと扱わないようにします。通常は各実装のalpha候補を別々に探索する方法でも構いません。
最後に、Lassoで残った入力をそのまま「現実の原因」と呼ばないことも大切です。データやモデルの選び方によって係数は変わります。予測に必要な入力と、現実の因果関係を分けて判断してください。
コメント