AI研究・論文解説

AI論文記事のカテゴリ画像自分が読んだAI関連の論文について、日本語解説していきます。

特に、AI(LLM, Diffusionモデルなど)を用いた画像処理(Denoiseや画像再構成、超解像などについての技術論文と
上記技術をエッジデバイスなどに搭載するために必要な縮小・軽量化(Quantization, LoRAなど)がメインになります。
AI研究・論文解説
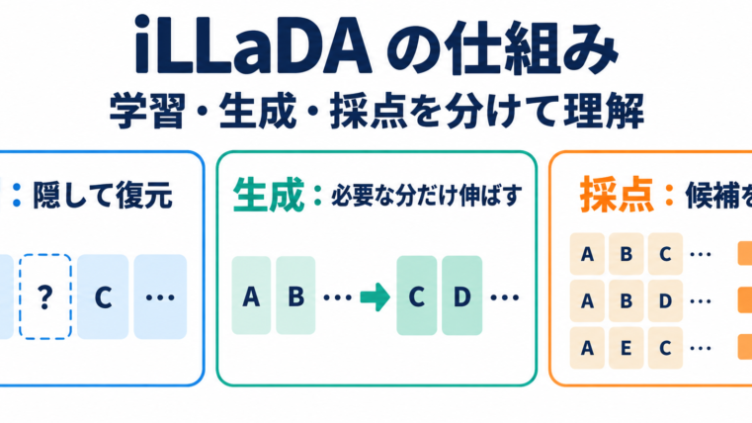
iLLaDAとは?可変長生成と信頼度スコアで理解するLLaDAからの改良

iLLaDAの仕組みを初学者向けに図解。LLaDAからの変更を、SFTのマスク範囲、ブロック単位の可変長生成、選択肢の信頼度スコアに分けて説明します。GQAの共有関係や評価結果の条件も整理します。
AI研究・論文解説

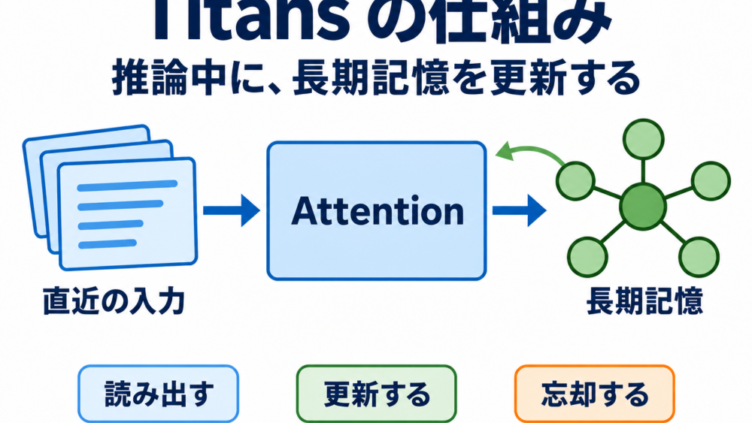
Titansとは?推論中に長期記憶を更新するAIの仕組みを図解

Titans論文を初学者向けに図解。3種類の記憶、読み書き、勾配更新の数値例、モメンタムと忘却、MAC・MAG・MALの構成、KV Cache・MLA・RAGとの違いと実験の限界を解説します。
AI研究・論文解説

DINOv2とは?正解ラベルなしで画像の特徴を学ぶ仕組み

DINOv2とは何かを原論文から解説。正解ラベルなしで学ぶ教師・生徒の仕組み、画像全体とパッチの特徴、DINOとの違い、分類・検索・深度推定への使い方を図解し、ラベル不要の範囲も整理します。
AI研究・論文解説

拡散言語モデルとは?LLaDA論文で理解する文章生成の仕組み

拡散言語モデルはどう文章を作る?LLaDA論文を基に、自己回帰型との違い、マスクを予測して一部を戻す生成過程、事前学習とSFTを図解。BERT・画像拡散との違いや、速度と品質の条件も解説します。
AI研究・論文解説

Self-RAGとは?検索するタイミングと回答の根拠を自己評価する仕組み

Self-RAGとは、必要なときに資料を検索し、関連性・回答の裏付け・有用性を自己評価するLLMの仕組みです。架空の図書館案内と図解で、通常のRAGとの違い、4種類の評価、学習方法、原論文の結果と限界を解説します。
AI研究・論文解説

GRPOとは?複数の回答を比較してLLMを学習させる仕組み

GRPOとは、同じ問題への複数回答を採点し、グループ内の相対評価でLLMを学習させる方法です。DeepSeekMath論文を基に計算例を図解。PPO・DPOとの違い、価値モデルと報酬モデルの役割、同点時の注意点を解説します。
AI研究・論文解説

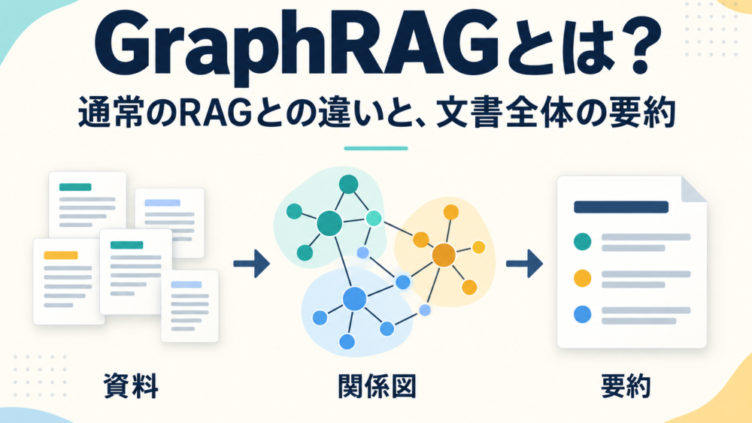
GraphRAGとは?通常のRAGとの違いと文書全体を要約する仕組み

GraphRAGとは、資料の関係図と要約を使って回答する方法です。Microsoft原論文を基に、通常のRAGとの違い、コミュニティ要約、Global・Local Searchを図解。評価結果の読み方、コストと採用時の注意点も説明します。
AI研究・論文解説

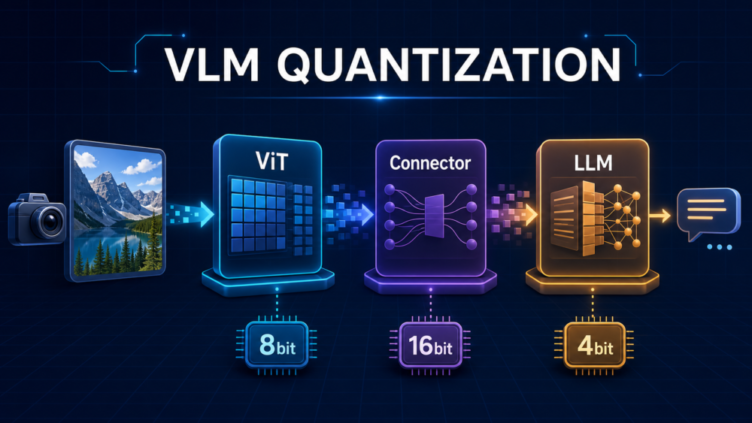
VLMはどこを量子化すべき?ViT・Connector・LLMの感度を論文から解説

VLMはどこを量子化すべきか。BLIP-2とLLaVAをGPTQ・AWQで比較した論文から、ViT、Connector、LLMのタスク別感度、bit配分、評価手順を解説します。
AI研究・論文解説

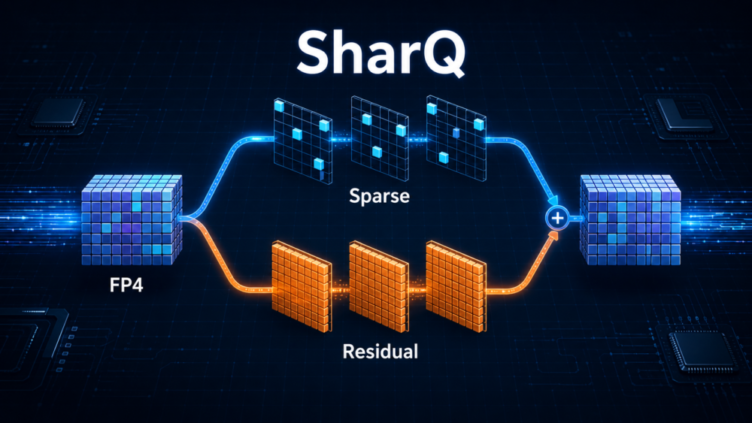
FP4量子化とactivation sparsityを両立するSharQを解説

SharQはLLMのactivationを疎なFP4本体と密なFP4残差へ分け、量子化誤差とsparsity損失を同時に補います。4:8 in-pairs、2経路GEMM、精度・速度、Blackwell依存の制約を原論文から解説します。
AI研究・論文解説

量子化するとLLMは遅くなる?推論tokenが増えるReasoning Token Inflationを解説

LLMをINT4へ量子化して1トークンの生成が速くなっても、推論tokenが増えると総時間は延びる場合があります。Reasoning Token Inflation論文からCTIR、実験結果、対策、評価指標を解説します。
スポンサーリンク