AI開発・実装

AI開発・実装

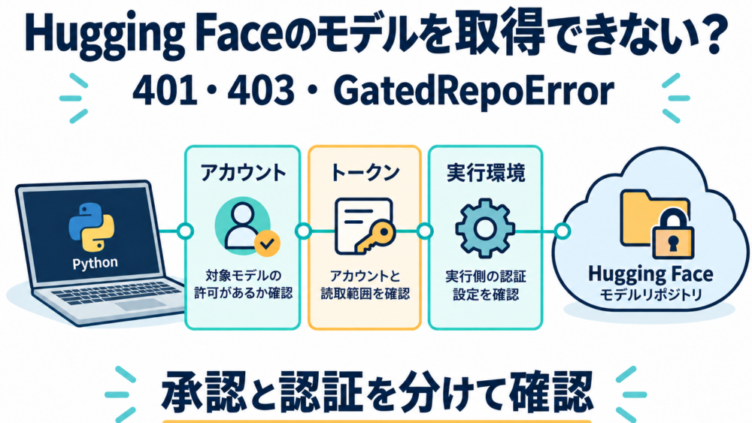
Hugging Faceでモデルをダウンロードできない|401・403・GatedRepoErrorの確認手順

Hugging Faceでモデルをダウンロードできないときの401・403・GatedRepoErrorを解説。アクセス承認、トークンの権限、HF_TOKEN、Colab・WSLの環境差を分け、図とPythonコードで原因を確認します。
AI開発・実装
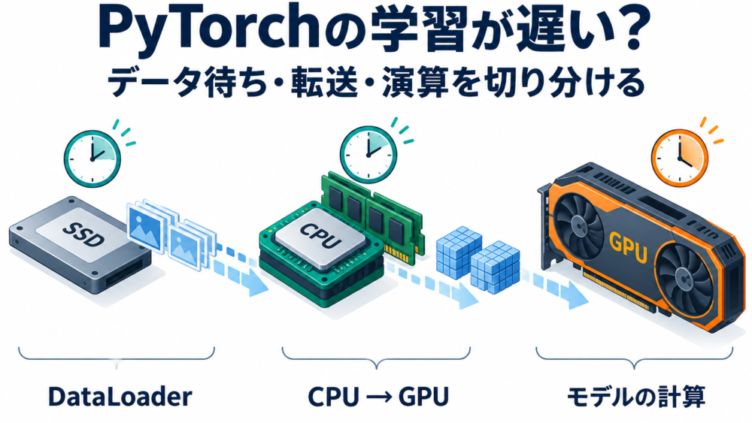
PyTorchの学習が遅い原因は?GPU使用率とDataLoaderの待ち時間を切り分ける

PyTorchの学習が遅い・GPU使用率が低いときに、データ待ち、CPUからGPUへの転送、演算を分けて調べる方法を解説。計測コードとCPU実験、num_workers・pin_memory・先読み設定の比較を図で整理します。
AI開発・実装

PyTorchの「Expected all tensors to be on the same device」対処法|CPU・GPU混在を切り分ける

PyTorchのExpected all tensors to be on the same deviceエラーを、モデル・入力・教師ラベル・一時テンソルの配置から切り分けます。toの再代入、register_buffer、保存データ復元時の注意点をコードと図で解説します。
AI開発・実装

Ollamaの初回応答が遅い原因は?読み込み時間の測り方とkeep_aliveの使い方

Ollamaの最初の回答や放置後の応答が遅いときは、load_duration・入力処理・生成時間を分けて確認。Pythonでの計測、keep_alive、プリロード、メモリ使用とのトレードオフを図解します。
AI開発・実装

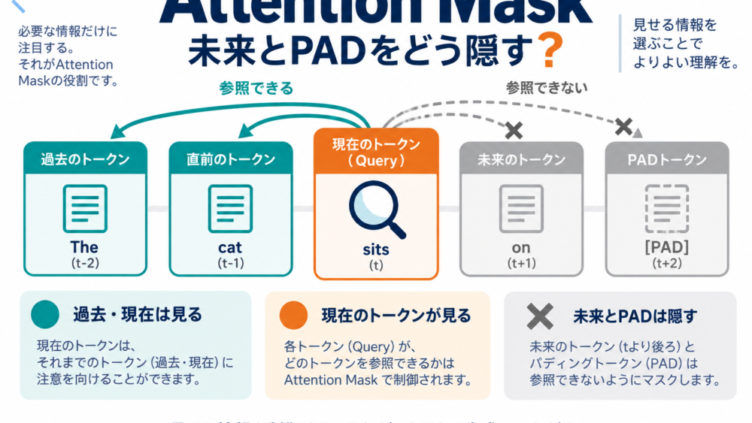
Attention Maskとは?Causal Mask・Padding Maskの違いを図解とPyTorchで理解する

Attention Maskの仕組みを行列図と数値例で解説。Causal MaskとPadding Maskの違い、PyTorchのTrueの意味、マスクの形状と合成、KVキャッシュの位置合わせを実行確認済みコードで学べます。
AI開発・実装

Mac miniのOllamaを別のPCから使う方法|自宅LANで接続・確認する手順

Mac miniのOllamaをWindowsや別のMacから使う手順を解説。macOSアプリ版のOLLAMA_HOST設定、モデル一覧の取得、文章生成、接続できない場合の切り分けとローカル限定への戻し方を整理します。
AI開発・実装

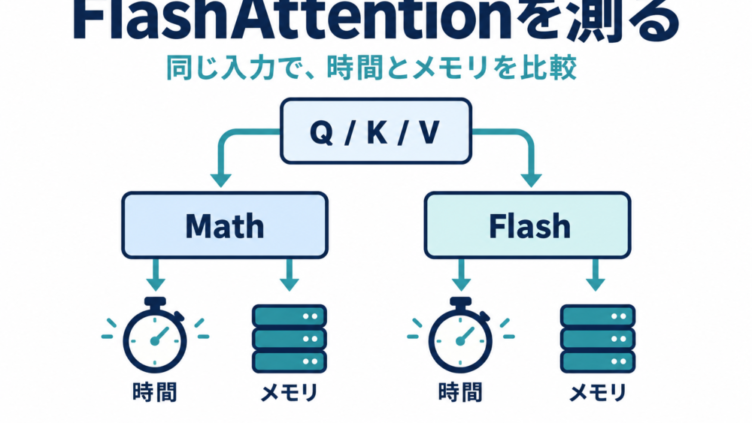
FlashAttentionの速度とGPUメモリを比較する方法|PyTorchの測定コードと注意点

PyTorchのSDPAでMathとFlashAttentionを同じ入力から比較する測定コードを解説。CUDA Eventによる時間計測、追加ピークメモリ、出力差の確認、非対応・メモリ不足やdecode時の注意点を整理します。
AI開発・実装

LM StudioでPDFを読み込んで質問する方法|回答の根拠と読み取り漏れを確認する

LM StudioへPDFを添付して質問する手順を解説。短い文書と長い文書の参照方法、回答と原文の照合、スキャンPDF・OCR・表の読み取りで確認したい点、読めないときの切り分けを紹介します。
AI開発・実装

Ollamaで長文を入れると遅い・メモリ不足になる原因|コンテキスト長と設定の見直し

Ollamaで長文や会話履歴を渡すと遅くなる・メモリ不足になる原因を整理。num_ctxと実入力の違い、KVキャッシュ、同時実行、APIの計測値を使い、条件を一つずつ変えて切り分ける手順を紹介します。
AI開発・実装

MacのOllamaモデルを外付けSSDへ移す方法|保存先変更と再起動後の確認

MacのOllamaモデルを外付けSSDへ移す手順を解説。元データを残すコピー、OLLAMA_MODELSの設定、アプリとMacの再起動後の確認、モデルが見つからないときの切り分け、元に戻す方法を紹介します。
スポンサーリンク