2026-05

AI技術・仕組み

Decoder-only Transformerとは?GPT系LLMの学習と生成を図解

Decoder-only Transformerの構造をGPT-2論文から解説。元のTransformer decoderとの違い、causal mask、次token損失、学習・prefill・decode、KV Cacheまで図と具体例で理解できます。
AI技術・仕組み

RoPEとは?LLMが位置情報を回転で扱う仕組みを図解

RoPEとは、LLMのQueryとKeyを位置に応じて回転する位置表現です。2次元の具体計算、相対位置差が内積へ残る理由、PyTorch実装、標準RoPEと長文向けスケーリングの違いを図解します。
AI技術・仕組み

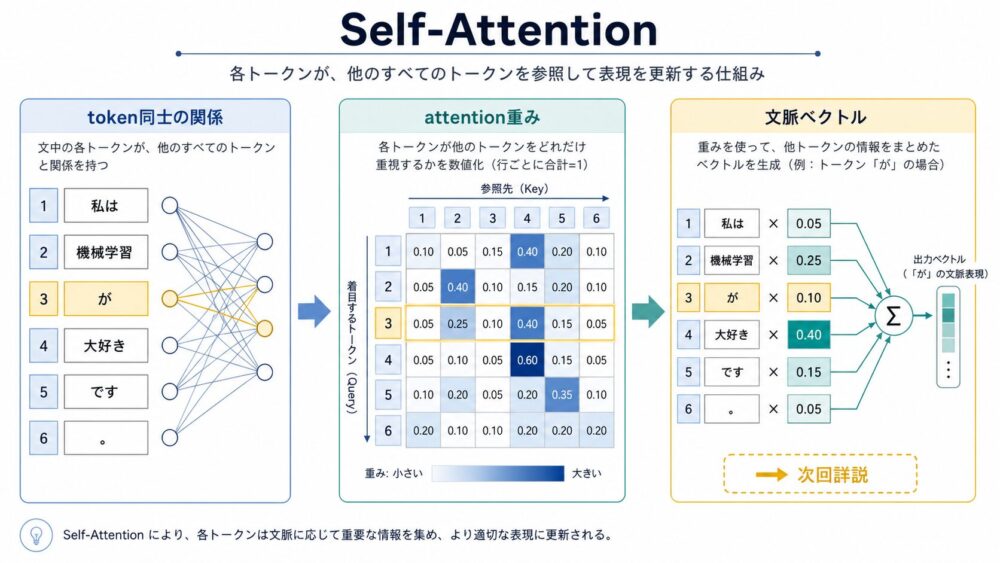
【LLM解説シリーズ】Self-Attentionとは?Scaled Dot-Product Attentionを数式と実装から理解する

Self-Attentionは、TransformerやLLMの中核となるAttention計算です。Attention Is All You Need論文をもとに、Query/Key/Value、Scaled Dot-Product Attention、Multi-Head Attention、causal mask、tensor形状、計算量を初心者にも分かりやすく解説します。
AI研究・論文解説

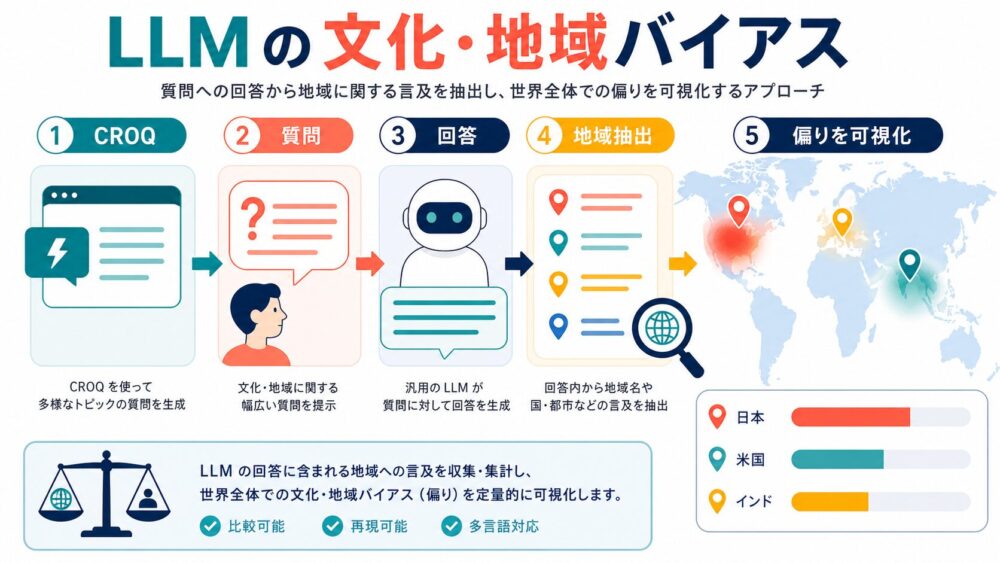
【論文解説】LLMはなぜ日本文化に寄りがちなのか?CROQで見る文化・地域バイアス

LLMが文化に関する曖昧な質問へ答えるとき、どの国や地域を暗黙に選びやすいのかを調べた論文を解説します。CROQデータセット、LLM-as-a-judgeによる地域抽出、入力言語の影響、SFT後に強まる文化・地域バイアスを初心者にも分かりやすく整理します。
AI技術・仕組み

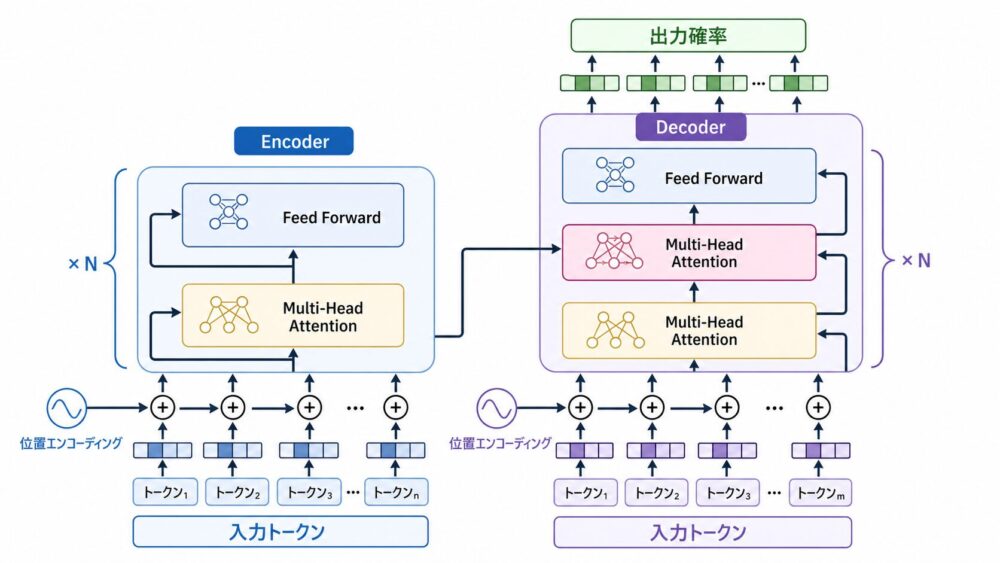
【LLM解説シリーズ】Transformerとは?Attention Is All You Need論文からLLMの基本構造を理解する

Transformerは、Attentionを中心に系列を処理するLLMの基礎アーキテクチャです。Attention Is All You Need論文をもとに、Self-Attention、Multi-Head Attention、Positional Encoding、EncoderとDecoderの違いを初心者にも分かりやすく解説します。
AI技術・仕組み

Bahdanau Attentionとは?加法型Attentionの計算とSelf-Attentionとの違い

Bahdanau Attentionとは、RNN翻訳のDecoderがEncoder出力を動的に参照する加法型Attentionです。score、softmax、context vectorの具体計算とSelf-Attentionとの違いを図解します。
AI技術・仕組み

Embeddingとは?LLMが単語や文章をベクトルで表す仕組みをBERT論文から解説

Embedding(埋め込み)とは、token IDをベクトルへ変換するLLMの入口です。BERT論文をもとに、token embedding、segment embedding、position embedding、Masked Language Modeling、文脈化表現を初心者にも分かりやすく解説します。
AI技術・仕組み

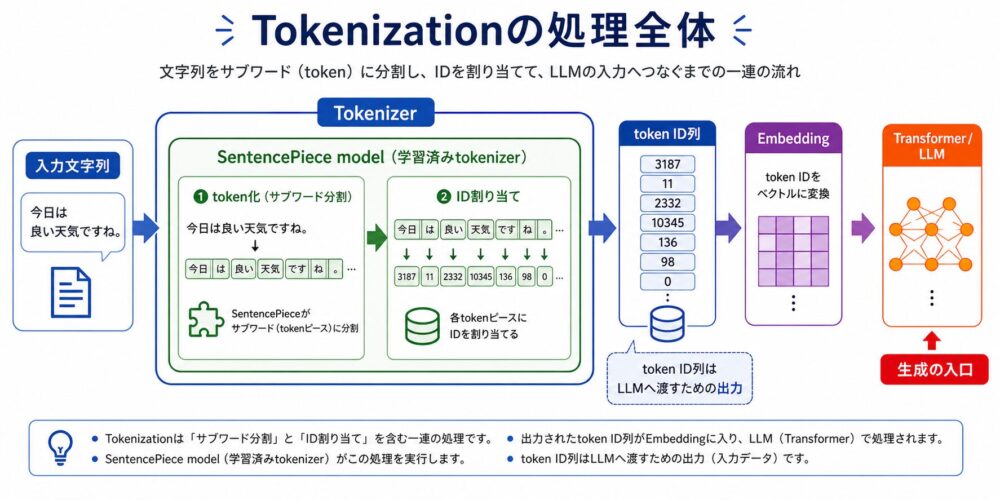
Tokenizationとは?SentencePiece論文からLLMのトークン化を解説

Tokenization(トークン化)とは、文章をLLMが扱えるtoken IDの列に変換する処理です。SentencePiece論文をもとに、サブワード、BPE、Unigram、可逆なdetokenization、日本語LLMでの注意点を解説します。
AI技術・仕組み

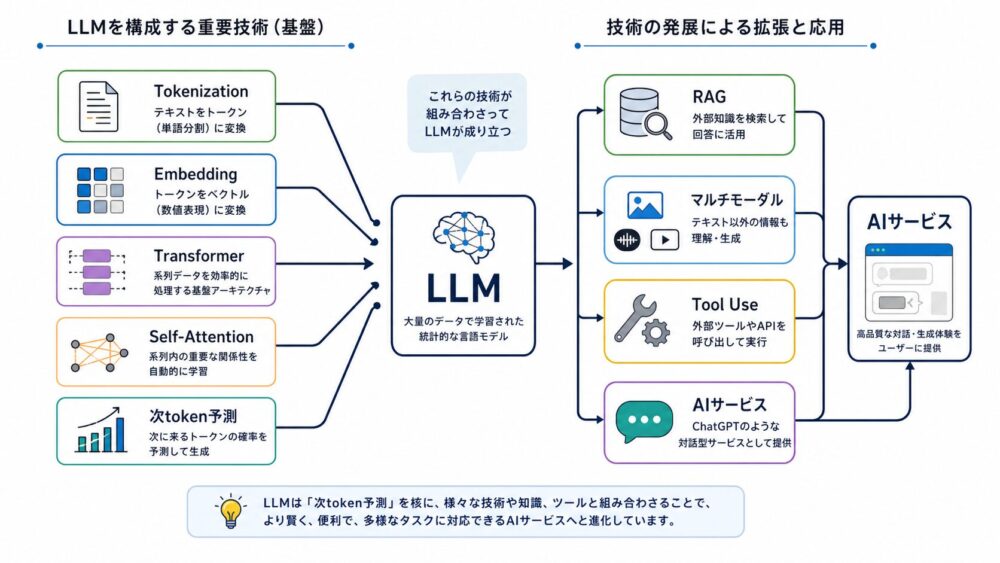
LLMとは?ChatGPTの原点をGPT-3論文から読み解く

LLM(大規模言語モデル)とは何かを、GPT-3論文をベースに解説します。Transformer、次トークン予測、Few-shot学習、ChatGPTにつながる技術的背景を整理します。
AI研究・論文解説

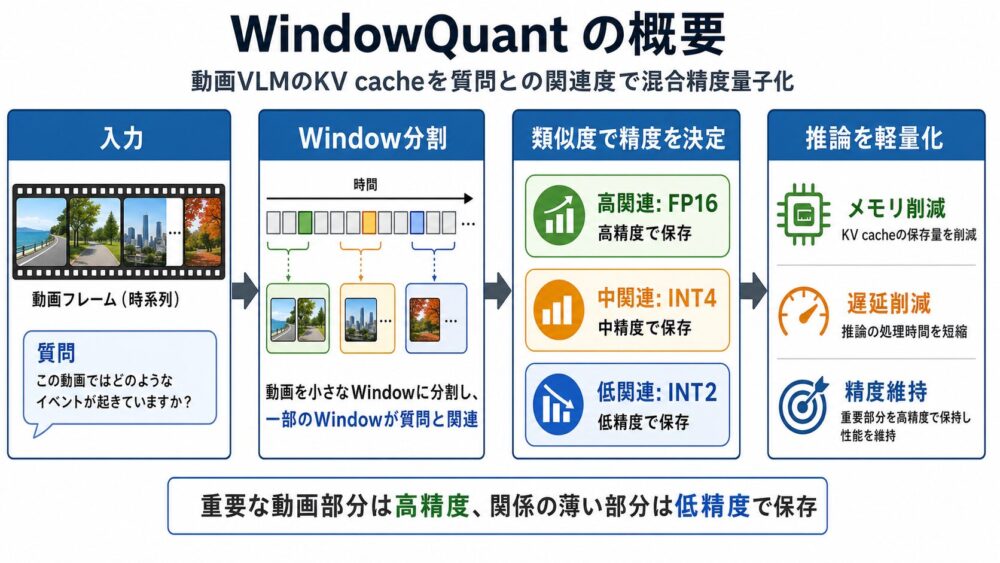
【論文解説】WindowQuantとは?動画VLMのKV Cacheを軽量化する混合精度量子化手法を解説

動画VLMの推論で問題になるKV Cacheのメモリ使用量と遅延を削減する手法「WindowQuant」を解説します。質問との関連度に応じて動画windowごとにFP16、INT4、INT2を使い分ける混合精度量子化の仕組み、KV Cacheの基礎、実験結果を整理します。
スポンサーリンク