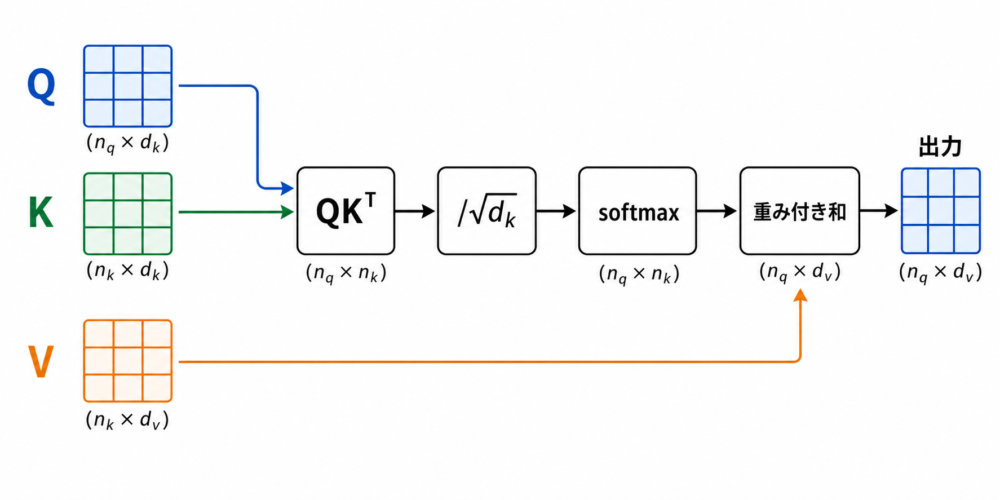
Self-Attention(自己注意機構)は、同じ入力列の中で参照先ごとの重みを計算し、その情報を混ぜて各位置の表現を更新する仕組みです。 QとKで重みを決め、Vを重み付きで足し合わせます。同じ層の各位置の出力を順番に待つ必要がないため、入力がそろっている範囲は行列演算でまとめて計算できます。
ただし、通常の自己回帰生成では、次の入力となるトークンを一つずつ確定するため、文章全体を一度に生成できるわけではありません。この記事では、QKVの式、並列化できる理由、学習と生成の違いを、図・数値例・PyTorchのコードでつなげて説明します。
Self-AttentionのQ・K・Vは何をする?
トークンは、文章をモデルへ渡すために分割した単位です。単語全体の場合もあれば、単語の一部や記号の場合もあります。モデル内部では、それぞれが埋め込みなどのベクトル(数値の並び)として扱われます。
あるトークンの表現を更新するために、同じ列の各位置からどれだけ情報を取り込むかを決めます。この重みは学習済みの固定表ではなく、入力に応じて計算されます。
| 名前 | 役割 | 計算で使う場所 |
|---|---|---|
| Q:Query | 更新したい位置からの照合用ベクトル | Kとの内積を取る |
| K:Key | 参照先となる位置の照合用ベクトル | Qとの相性スコアを作る |
| V:Value | 重みに応じて取り込む情報 | 最後に重み付きで足し合わせる |
入力表現を行列 \(X\) とすると、学習される3組の重み行列を使って次のように変換します。
同じ入力から作っていても、変換に使う行列が違うため、Q・K・Vは一般に異なる値になります。「照合に使う情報」と「出力へ混ぜる情報」を分けて学習できる点が、この構成の特徴です。
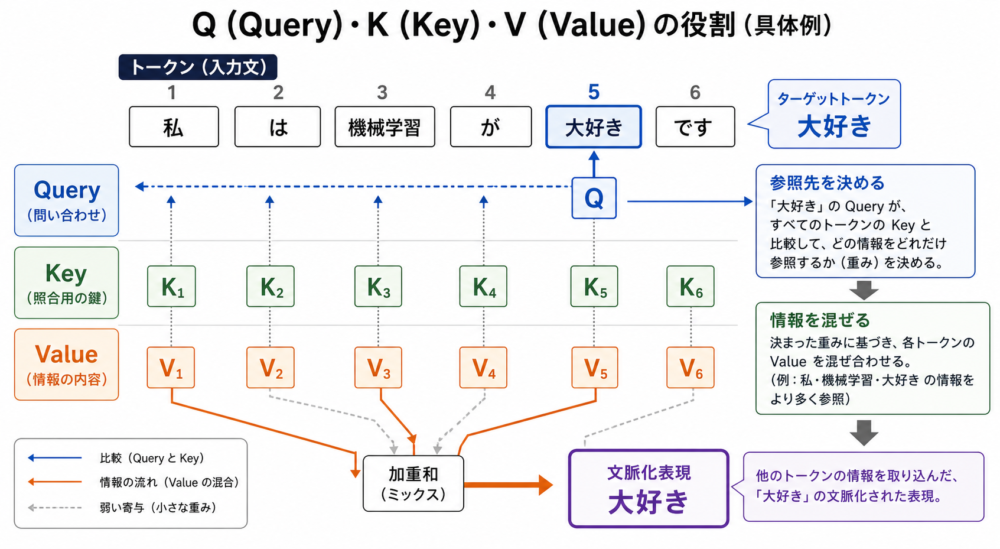
図の「大好き」が「私」や「機械学習」を参照する関係は、役割を理解するための例です。実際のモデルの重みを測定した図ではなく、日本語の分割も説明用に単純化しています。head(独立した投影とAttention計算の単位)が必ず主語・目的語を担当する、と決まっているわけではありません。
Self-Attentionの「Self」は、自分自身だけを見るという意味ではなく、Q・K・Vの元が同じ系列であることを示します。別の系列を参照するCross-Attentionでは、通常QとK/Vの出所が異なります。どの位置を参照できるかは、後述するマスクでも制限できます。
基礎となる式はVaswaniらのAttention Is All You Needの第3節で確認できます。
Self-Attentionはなぜ並列計算できる?
RNNには同じ層の「前の出力待ち」がある
RNN(前の状態を次へ渡して系列を処理するニューラルネットワーク)の基本形では、位置 \(t\) の状態 \(h_t\) を求めるために、前の位置の状態 \(h_{t-1}\) が必要です。
入力 \(x_1,x_2,x_3\) が最初からあっても、\(h_3\) は \(h_2\) を待ち、\(h_2\) は \(h_1\) を待ちます。行列演算そのものや複数の入力例を並列化する余地はありますが、基本的なRNNでは一つの系列内にこの依存の鎖が残ります。
Self-Attentionは前の層の表現を参照する
Self-Attentionの位置 \(i\) の出力を \(y_i\) とすると、その計算に使うのは、現在の層への入力から作った \(q_i\) と、参照を許可された位置のK・Vです。同じAttention層の出力 \(y_{i-1}\) が先に完成している必要はありません。
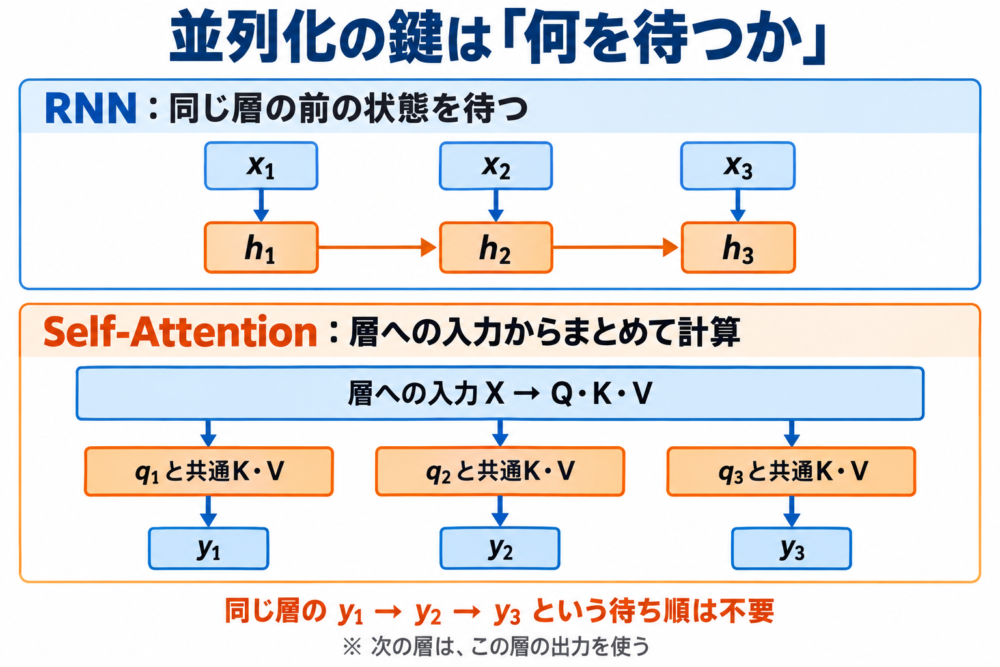
図で注目するのは矢印の出発点です。Self-Attentionでは、各出力は共通の入力側K・Vを参照します。出力同士を順番につなぐ矢印はありません。このため、各位置のQueryをQという行列に並べ、\(QK^T\) の行列積として一括計算できます。
ここでいう「並列」は、すべての積和演算が物理的に同じ瞬間に終了する、という意味ではありません。GPU(多数の演算を並列に実行するプロセッサ)の資源やメモリに合わせて分割して実行できます。また、Transformerの層を重ねる場合、次の層は前の層の出力を使うため、層と層の依存関係は残ります。
| 比較軸 | 基本的なRNN | Self-Attention |
|---|---|---|
| 同じ層の位置間依存 | 前の位置の状態が必要 | 同じ層の他位置の出力は不要 |
| 入力列がそろっているとき | 系列内の逐次依存が残る | 複数位置を行列演算へまとめられる |
| 離れた位置の参照 | 間の状態を経由する | マスクで許可されれば直接参照できる |
| 主な負担 | 系列方向の待ち時間 | 全位置ペアを扱う計算量・メモリ量 |
依存関係の比較は、原論文の第4節とSelf-Attention and Positional Encoding(Dive into Deep Learning)でも説明されています。
Scaled Dot-Product Attentionの計算を追う
基本式は次のとおりです。まずマスクのない場合を考えます。
\(K^T\) はKの行と列を入れ替えた転置行列、\(d_k\) はQueryとKeyの次元数です。softmaxは、各Queryについて、参照先のスコアを合計1の重みへ変換します。この行ごとの正規化が、どの情報をどれだけ混ぜるかを決めます。
| 段階 | 操作 | 出てくるもの |
|---|---|---|
| 1 | \(QK^T\) | 各Queryと各Keyの内積スコア |
| 2 | \(\sqrt{d_k}\) で割る | 大きさを調整したスコア |
| 3 | 参照先の方向へsoftmax | Queryごとに合計1となる重み |
| 4 | 重みの行列とVを掛ける | 情報を混ぜた各位置の出力 |
なぜ次元数の平方根で割る?
QueryとKeyの各成分が独立で平均0・分散1という単純化した仮定では、\(d_k\) 個の積を足す内積の分散は \(d_k\) になります。標準偏差は \(\sqrt{d_k}\) なので、その値で割るとスコアの大きさをそろえやすくなります。
大きすぎるスコアをsoftmaxへ入れると、一部の重みへ極端に集中し、勾配(学習時の更新方向を決める変化率)が小さくなる場合があります。平方根で割るのは、その問題を抑えるためです。実際の学習済みベクトルが常にこの独立性の仮定を満たす、という主張ではありません。
3つのValueを混ぜる数値例
計算を手で追えるよう、1head、\(d_k=d_v=1\) の人工例にします。最初のQueryを \(q_1=1\)、3つのKeyを \([0,\ln 2,\ln 3]\)、Valueを \([2,4,8]\) とします。\(\ln\) は自然対数です。
次元数が1なのでスケールは \(\sqrt{1}=1\)。内積スコアは \([0,\ln 2,\ln 3]\) となり、softmaxの分子は \([e^0,e^{\ln 2},e^{\ln 3}]=[1,2,3]\) です。分母は6なので、重みは \([1/6,2/6,3/6]\) になります。
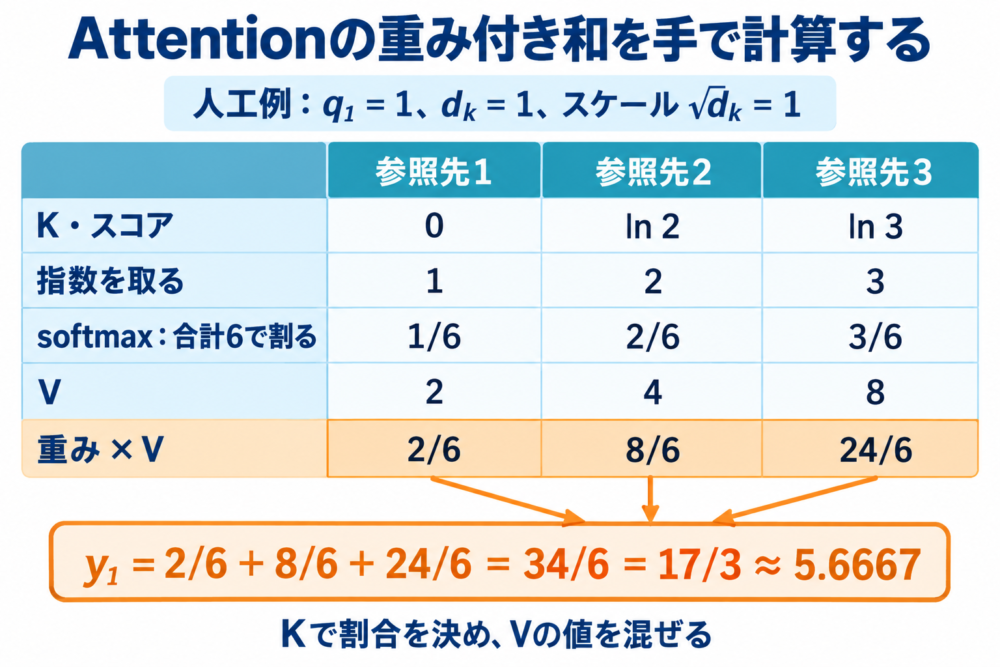
Kは「混ぜる割合」を決め、Vは「実際に足す値」として使われています。数値は計算説明用に作ったもので、単語の意味やモデルの学習結果を表すものではありません。
テンソル形状とMulti-Head Attention
テンソルは、多次元の配列です。バッチサイズを \(B\)、系列長を \(T\)、head数を \(H\)、headごとの次元を \(D\) とすると、Q/K/Vの次元を同じにした基本形は次の形状になります。
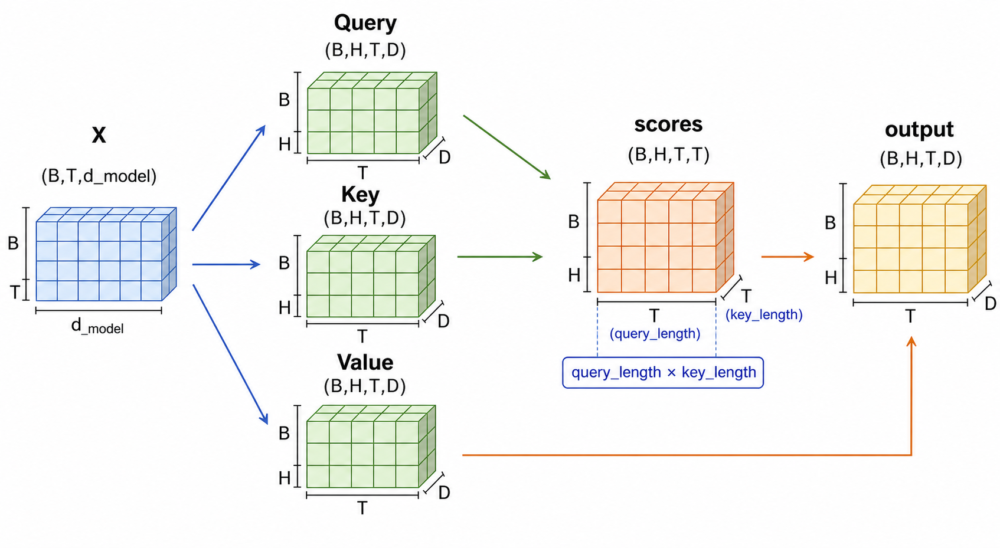
| 配列 | 形状 | 読み方 |
|---|---|---|
| 入力X | (B, T, d_model) |
各入力例の各位置に特徴ベクトルがある |
| Q・K・V | (B, H, T, D) |
headごとに変換した特徴 |
| スコア・重み | (B, H, T, T) |
行がQuery位置、列がKey位置 |
| headごとの出力 | (B, H, T, D) |
各位置でVを混ぜた結果 |
図は4次元配列を立体で模式化したものです。正確な次元の対応は表を基準にしてください。一般のAttentionではQとKの次元 \(d_k\) とVの次元 \(d_v\) を分けることもできます。
Multi-Head Attentionは、異なる学習済み投影を持つheadでAttentionを計算し、出力を連結してさらに線形変換する仕組みです。
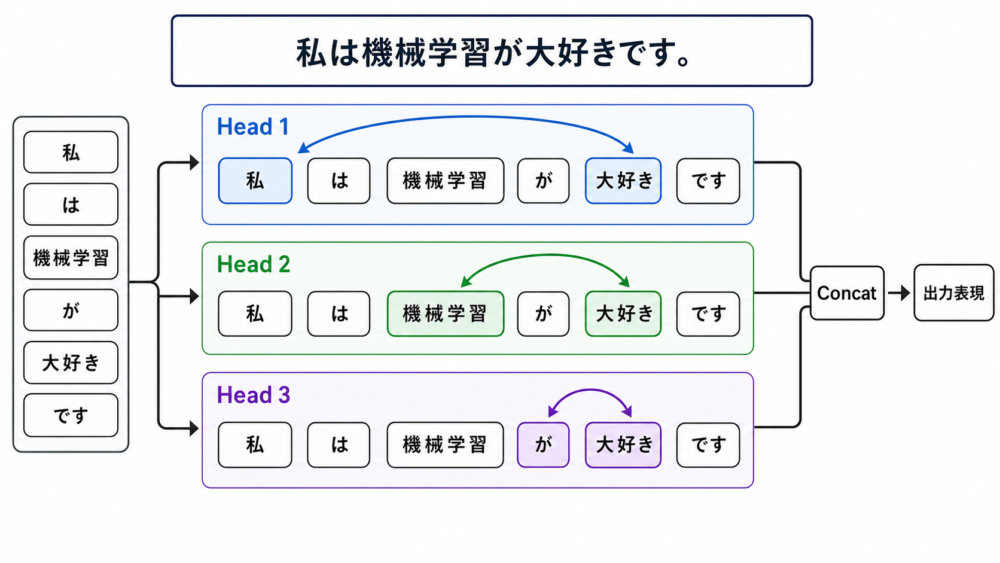
図の関係線は、headごとに異なる参照を学習し得ることを示す例です。どのheadがどの文法関係を担当するかを人が固定しているわけではありません。図では省略していますが、連結後には上式の \(W^O\) による変換があります。
head方向とトークン位置方向は、別々の並列化の軸です。headを一つにしても、入力がそろっていれば位置方向の計算を行列へまとめられます。
マスクがあっても並列計算できる?
マスクは、参照してよいQueryとKeyの組み合わせを指定するものです。許可しない組み合わせを除外しても、各出力が同じ層の別の出力を待たない点は変わりません。
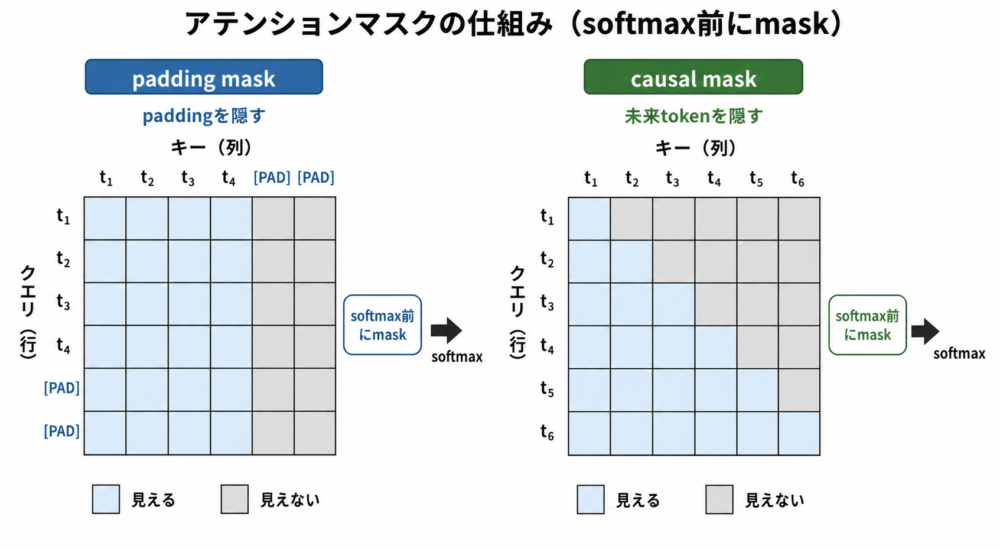
| マスク | 隠すもの | 目的 |
|---|---|---|
| Padding Mask | 長さをそろえるために加えたPADのKey位置 | 埋め草を情報として取り込まない |
| Causal Mask | 各Queryより未来側のKey位置 | 次トークン予測で答えを先に見ない |
Causal Maskでは、位置 \(i\) は自分を含む位置 \(i\) 以前を参照できます。その位置の出力から「次のトークン」を予測するように、正解ラベルを一つずらします。
数式では、許可する位置へ0、禁止する位置へ \(-\infty\) を置いた行列Mをsoftmaxの前に足します。
前の数値例で3つ目のKeyを禁止すると、重みは \([1/3,2/3,0]\) へ変わります。softmax後に最後の重みを0にするだけの \([1/6,2/6,0]\) とは違い、許可された位置だけで合計1になります。
すべてのKeyを禁止した行では、通常のsoftmaxをそのまま適用すると定義できない計算になります。禁止スコアを有限の最小値で置き換えるだけでは、一様な重みになってしまう場合もあります。以下のコードでは各行で最低一つを許可し、全マスク行を作りません。Padding MaskでPADのKey列を隠しても、PADのQuery行の出力が自動で消えるとは限らない点にも注意が必要です。
APIごとの真偽値の意味やPAD位置の損失処理は、Attention Maskとは?Causal Mask・Padding Maskの違いを図解とPyTorchで理解するで詳しく説明しています。
学習は並列なのに、なぜ生成は順番に進む?
学習時は正解の入力列がそろっている
自己回帰言語モデルの学習では、通常、正解系列を入力へ与え、その各位置で次のトークンを予測させます。この方法をteacher forcingと呼びます。
説明用の単位で文を「私は/猫が/好き/です」と分けると、入力を「私は、猫が、好き」、正解ラベルを「猫が、好き、です」と並べられます。予測結果が外れていても、次の位置の入力には正解の「猫が」がすでに用意されています。このため、Causal Maskで未来を隠しつつ、全位置の出力と損失をまとめて求められます。
生成時は次の入力をまだ持っていない
通常の自己回帰生成では、「私は」から選んだ次トークンが「猫が」なのか「犬が」なのかによって、その後の入力が変わります。次トークンを選んでから入力へ追加し、次の予測を行うという順序が必要です。
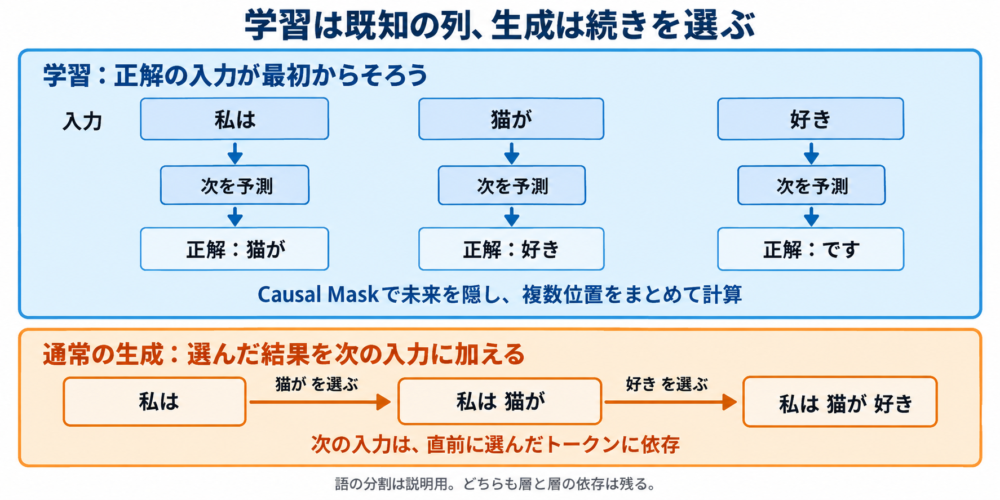
| 場面 | 最初に分かっている入力 | まとめて計算できる範囲 | 順序が残る部分 |
|---|---|---|---|
| 通常の学習 | 正解系列 | マスクを適用した複数位置 | 層の依存、学習更新の順序 |
| Prefill | ユーザーが渡したプロンプト | 既知のプロンプト内の複数位置 | 層の依存 |
| Decode | プロンプトと生成済みの続き | 現在位置でのhead・特徴・参照先の演算など | 次の生成位置は選んだトークンに依存 |
Prefillは入力プロンプトを処理する段階、Decodeは続きを生成する段階です。KV Cache(過去のKeyとValueを保存して再利用する仕組み)は、Decodeで過去のK/Vを毎回作り直す負担を減らします。しかし、次のトークンを確定する順序そのものはなくしません。仕組みはHugging FaceのHow caching worksで確認できます。
この説明は通常の自己回帰生成を対象とします。複数候補を先に計算して検証する生成手法などは、ここでは扱いません。
PyTorchで「一括計算」と「行ごとの計算」を比べる
前の人工例を3つのQueryへ広げ、行列積でまとめた結果と、Queryを1行ずつ処理した結果が一致することを確認します。QKVはあらかじめ与え、学習される投影・位置情報・出力投影・残差接続は省略しています。
import math
import torch
from torch import Tensor
from torch.nn import functional as F

# 手計算の値と対応させるため、小さな人工QKVを使います。
q: Tensor = torch.tensor([[1.0], [2.0], [3.0]], dtype=torch.float64)
k: Tensor = torch.tensor([[0.0], [math.log(2.0)], [math.log(3.0)]], dtype=torch.float64)
v: Tensor = torch.tensor([[2.0], [4.0], [8.0]], dtype=torch.float64)
scores: Tensor = (q @ k.T) / math.sqrt(q.shape[-1])
weights: Tensor = torch.softmax(scores, dim=-1)
together: Tensor = weights @ v
rowwise: Tensor = torch.cat([
    torch.softmax((row @ k.T) / math.sqrt(q.shape[-1]), dim=-1) @ v
    for row in q.split(1, dim=0)
], dim=0)
torch.testing.assert_close(together, rowwise)
assert math.isclose(together[0, 0].item(), 17.0 / 3.0)

# (batch, head, position, feature)にそろえ、公式APIと照合します。
official: Tensor = F.scaled_dot_product_attention(
    q[None, None], k[None, None], v[None, None], dropout_p=0.0
)[0, 0]
torch.testing.assert_close(together, official)

# この正方形マスクでは自分自身を許可し、全マスク行を避けます。
allowed: Tensor = torch.ones(3, 3, dtype=torch.bool).tril()
causal: Tensor = torch.softmax(scores.masked_fill(~allowed, -torch.inf), dim=-1) @ v
official_causal: Tensor = F.scaled_dot_product_attention(
    q[None, None], k[None, None], v[None, None],
    attn_mask=allowed, dropout_p=0.0,
)[0, 0]
torch.testing.assert_close(causal, official_causal)
print(f"first row: {together[0, 0].item():.4f}")
print("matrix / rowwise / SDPA: OK")
print("causal / SDPA: OK")
この例の allowed=True は「参照を許可する」です。PyTorchのSDPA公式リファレンスにある意味に合わせています。別APIでは真偽値の意味が逆になる場合があります。また、比較時にランダムなdropoutを入れないよう、dropout_p=0.0 を明示しています。
PyTorch 2.14.0+cpuで実行し、次の出力を確認しました。GPUの速度測定は行っていません。
first row: 5.6667
matrix / rowwise / SDPA: OK
causal / SDPA: OK
この照合は、計算の意味が一致することを確認するものです。CPUで一致を確認できても、GPUで何倍速くなるかは分かりません。処理時間は入力形状、データ型、実行するカーネルなどによって変わります。
並列化できても、長文で重くなる理由
バッチとheadを一つに固定すると、密なAttentionのスコア計算は \(O(T^2d_k)\)、Vの加重和は \(O(T^2d_v)\) です。これは計算量が系列長Tの二乗に応じて増えることを示します。QKVを作る投影などの費用は別にあります。
単純な実装で (T, T) のスコア行列を全て保存すると、メモリにも二乗の負担が生じます。
| 系列長T | 1headのスコア要素数 | 1要素2bytesの場合 |
|---|---|---|
| 1,000 | 1,000,000 | 約2 MB |
| 8,000 | 64,000,000 | 約128 MB |
| 32,000 | 1,024,000,000 | 約2.048 GB |
MB・GBは10進表記です。この表はスコア行列一つだけの見積もりで、バッチ数、head数、QKV、勾配、他の層の保存領域を含みません。例えばheadが8個なら、このスコア領域だけでも8倍になります。
すべての実装が、この大きな中間行列をメモリへ丸ごと保存するわけではありません。FlashAttention原論文は、タイル単位の計算などによってメモリ入出力と中間保存を減らします。密なAttentionを計算するという内容を保ったまま実装を効率化するもので、全ペアの演算量が自動的に線形になるわけではありません。
詳しくはFlashAttentionの仕組みへ進んでください。並列化は「計算順序の制約を減らすこと」、メモリ最適化は「保存と転送の負担を減らすこと」と分けると、各技術の目的を整理しやすくなります。
出典と関連資料
- Attention Is All You Need(Vaswaniら)
- Self-Attention and Positional Encoding(Dive into Deep Learning)
- scaled_dot_product_attention(PyTorch 2.14)
- How caching works(Hugging Face)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Daoら)
図は概念を説明するための独自生成画像です。数値例は本文の計算から作成し、実際の学習済みモデルのAttention重みやGPU性能を測定したものではありません。

コメント