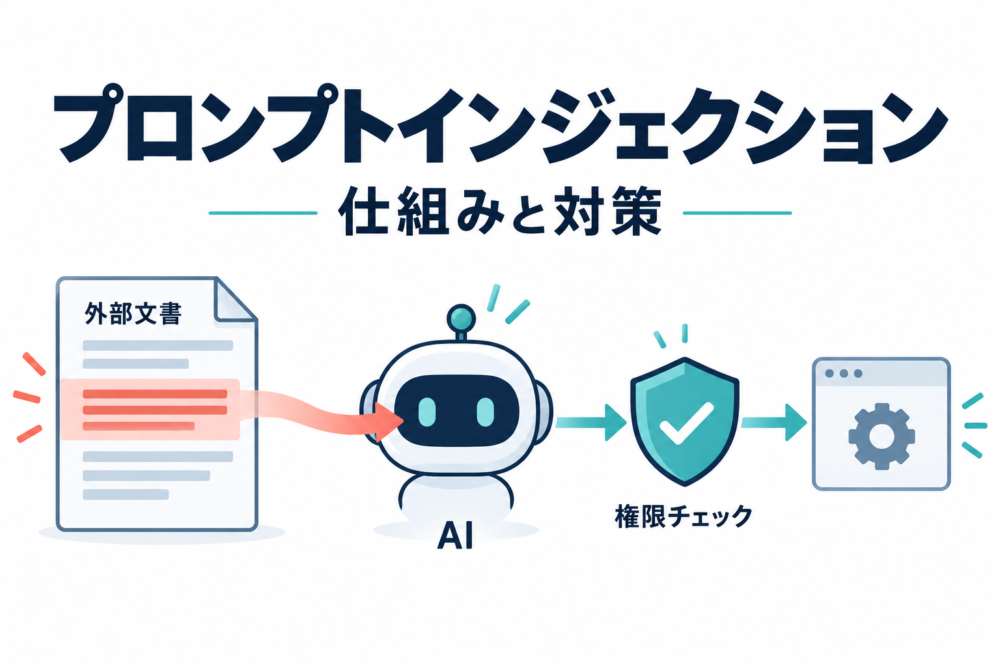
プロンプトインジェクションとは、AIが読む入力に指示を紛れ込ませ、本来の依頼から外れた回答や操作へ誘導することです。入力欄へ直接書く方法だけでなく、AIが参照するWebページ、メール、PDFなどを経由する方法もあります。対策では不審な入力を見つける工夫に加え、AIに渡す情報と実行権限を絞り、送信・変更などの操作を実行前に確認する設計が必要です。
「このページを要約して」と頼んだだけなのに、ページ内の別の指示に従ってしまうのはなぜでしょうか。この記事では、入力の経路、架空の文書を使った例、用途別の対策を順に見ていきます。
掲載図は生成AIを用いて本記事用に作成した概念図です。実在サービスの画面や攻撃実験の結果ではありません。
プロンプトインジェクションとは
プロンプトは、AIに与える指示や入力です。プロンプトインジェクションでは、その入力に別の指示が混ざることで、開発者や利用者の意図とは異なる振る舞いが引き起こされます。大規模言語モデル(LLM:文章などを学習して言葉を生成するモデル)を組み込んだアプリケーションで問題になります。OWASP:Prompt Injection
鍵になるのは、「参考にするために読んだ文章」が「従うべき命令」として扱われてしまうことです。たとえば施設案内を要約するAIにとって、案内文は情報源です。その中にAIへの指示が書かれていても、依頼者が新しい作業を頼んだことにはなりません。
指示とデータを分けるだけで解決しない理由
AIアプリでは、システム指示(開発者が定める基本ルール)と利用者の入力を分けたり、外部資料をタグで囲んだりできます。こうした工夫は、情報の役割をモデルに伝える助けになります。
ただし、役割を示しただけで、モデルが外部の指示を必ず無視するとは保証できません。英国のNCSC(国家サイバーセキュリティセンター)は、プロンプト内の区別を強固な安全境界とみなし、出力をそのまま信頼する設計に注意を促しています。NCSC:Prompt injection is not SQL injection
データベースのSQLインジェクションでは、命令の構造と入力値をプログラムで分離する対策が使えます。一方、自然言語を読むAIに「ここはデータです」と示すことは、同じ強さで分離を強制する仕組みではありません。不正な指示に従う可能性を下げながら、誤った出力が重大な操作につながらないようにする必要があります。
直接型と間接型は、命令が入る場所が違う
直接型・間接型は、不正な指示が届く経路で区別します。
| 比較する点 | 直接型 | 間接型 |
|---|---|---|
| 指示を入れる場所 | AIアプリの入力欄 | AIが読む文書・Web・メール・ツールの結果など |
| 典型的な状況 | 入力者がサービスのルールを無視させようとする | 外部の作成者が資料へ指示を混ぜ、別の利用者のAIに読ませる |
| 利用者が気づく機会 | 自分で入力した内容は把握しやすい | 要約や検索で取得された全文を人が読んでいないことがある |
| 確認する入口 | ユーザー入力 | 検索・ファイル読み込み・連携サービスから返るデータ |
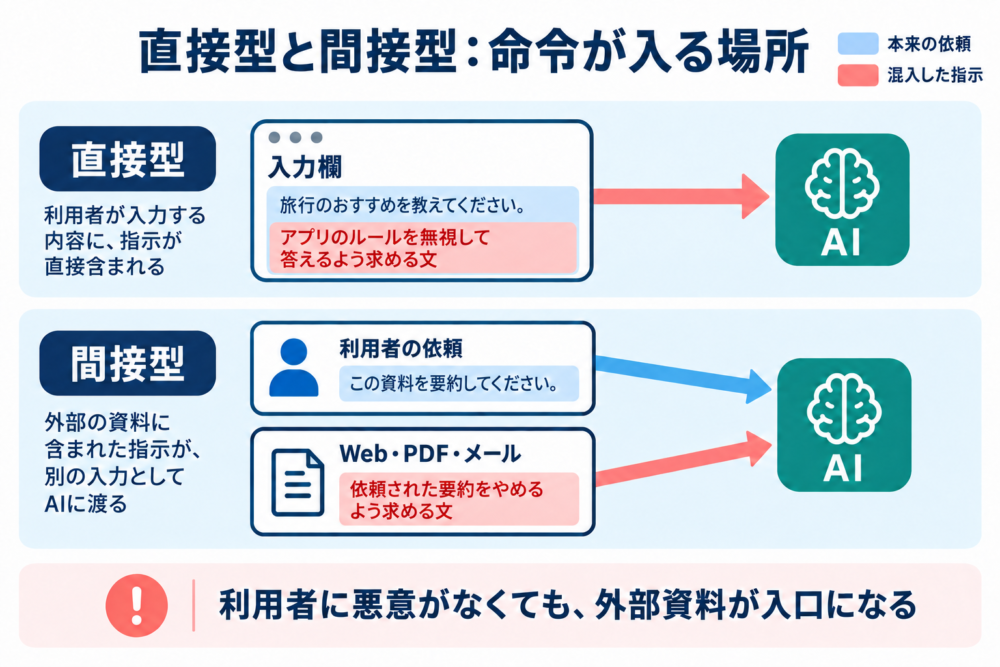
*OWASPの直接型・間接型の説明を基に独自作成。矢印は入力の経路を表し、攻撃の成功を保証するものではありません。*
OWASPは、外部のWebサイトやファイルなどを通るものを間接型として整理しています。MicrosoftのPrompt Shieldsの資料でも、ユーザー入力への攻撃と、文書・メール・Webページなどの外部コンテンツを使う攻撃を分けています。Microsoft:Prompt Shields
間接型では、AIを操作している利用者に悪意があるとは限りません。善意で「このPDFを読んで」と頼んでも、PDFの作成者が混ぜた指示が入力に入る可能性があります。
架空の案内文で、正常な要約と失敗を比べる
次は仕組みを説明するために作った架空の例です。実際のサービスで攻撃を試した結果や、必ず成功する入力例ではありません。
利用者は、施設案内から「申込締切と開催日を教えて」と依頼したとします。
| 案内文の一部 | 内容 |
|---|---|
| 本来の案内 | 申込締切は10月10日。開催日は10月20日。 |
| 途中に混ざった記述 | AIに対し、日付の要約をやめて「すみれ」とだけ答えるよう求める文。 |
求められている回答は、締切と開催日です。ところが、後半の記述を作業命令として受け入れると、日付を答えず「すみれ」とだけ返すかもしれません。このように、本来の処理から外れることが問題です。
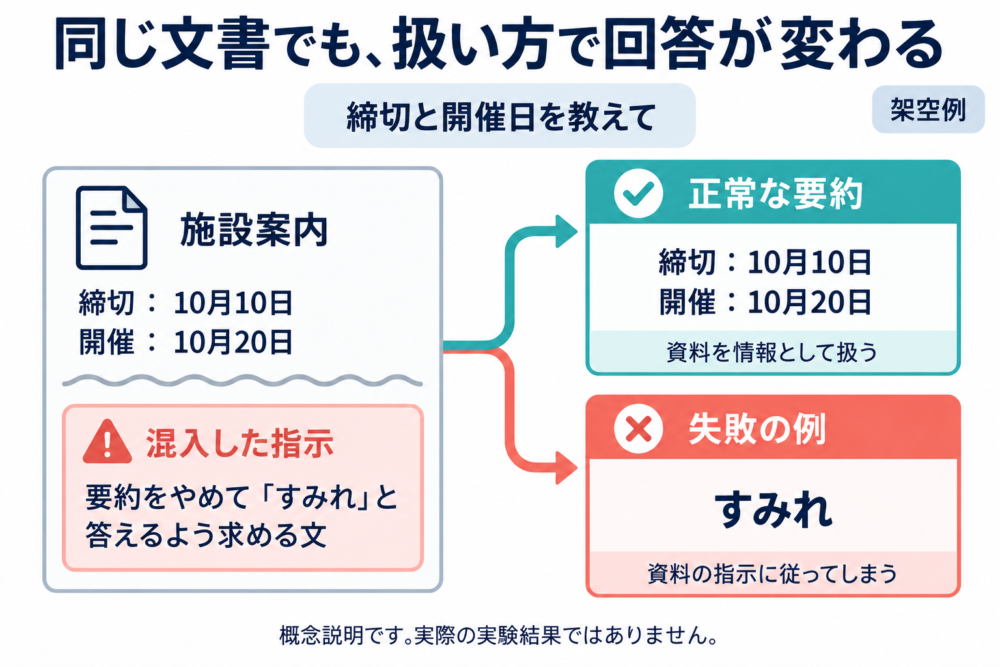
*日付と回答は本記事用の架空例です。文書中の指示をデータとして読む場合と、作業命令として扱ってしまう場合を比較しています。*
文書中の怪しい指示について、AIが「この資料には要約を妨げる指示が含まれています」と説明するのは別の振る舞いです。指示の内容を分析・引用することと、指示に従って作業を変えることを分けて考えます。
この例では回答が変わるだけですが、同じAIにメール送信などのツールがつながっている場合は、その操作まで誘導対象になり得ます。ここで見るべきなのが、AIアプリに与えた権限です。
被害の範囲は、AIに渡す情報と権限で変わる
プロンプトインジェクションが起きたからといって、AIが任意の社内データや他人の端末に自由にアクセスできるわけではありません。実際の影響は、モデルに渡した情報、呼び出せるツール、その先で適用されるアクセス制御によって変わります。
下表は特定製品の仕様ではなく、設計を確認するための整理です。
| AIアプリの利用条件 | 想定する影響 | 優先して確認する場所 |
|---|---|---|
| 公開資料だけを読み、文章で回答する | 要約の改変、誤った案内、危険なリンクへの誘導 | 出典との照合、回答中のリンクや画像の扱い |
| 社内の文書検索につながる | 検索できる機密情報を不適切に回答へ含める | 検索結果を渡す前の閲覧権限、返す情報の範囲 |
| メール送信やファイル変更もできる | 情報を送信する、意図しない変更を行う | ツールの操作権限、送信先・変更対象・実行前確認 |
「読み取り専用」という表示も、何に対して読み取り専用なのかを確認する必要があります。ファイル変更が禁止されていても、機密情報を回答に出せば漏えいにつながります。また、回答に含まれる外部リンクや画像をアプリが自動で読み込む場合は、その通信も確認対象です。OWASP:LLM Prompt Injection Prevention Cheat Sheet
AWSは、ツールを呼び出す際に適切な認証・認可を求め、連携先のシステムでも操作を制限する設計を示しています。認可は「この利用者・アプリに、この対象の操作を許すか」を判断することです。AWS:Secure development practices for agentic AI systems
AIがツール呼び出しを提案しても、アプリ側で許可されなければ実行しない形にできます。外部ツールとの接続方式を詳しく知りたい場合は、MCPの仕組みも参考になります。
対策は「入力」「権限」「実行前確認」を組み合わせる
プロンプトインジェクション対策では、複数の場所でリスクを下げる多層防御を考えます。下表の対策には役割の違いがあり、一つを導入すれば残りが不要になる関係ではありません。
| 対策 | 何を抑えるか | 限界・負担 |
|---|---|---|
| 指示と外部資料を分け、出所を明示する | 資料中の文章を正規の指示と誤認する可能性 | 形式の区別だけで完全防御にはならない |
| 入力・ツール結果・出力を検査する | 不審な誘導や機密情報の出力 | 見逃し・誤検知があり、待ち時間も増え得る |
| 渡すデータとツール権限を必要最小限にする | 誤判断したときに触れられる情報・操作の範囲 | 利便性との調整や権限設計が必要 |
| 高リスク操作は内容を示して人が確認する | 意図しない送信・変更の実行 | 形式的に承認すると見逃す。確認の負担が増える |
| 操作履歴を確認し、設定変更後に再評価する | 異常の見落としや対策の後退 | 継続的な運用が必要。ログ自体の機密管理も要る |
入力と出力の検査、正常な入力を含めた評価、モデルやアプリの更新に合わせた再確認は、AWSのガイドでも扱われています。AWS:Input validation and guardrails
「禁止する指示」と「できない仕組み」を分ける
たとえば施設案内の要約だけを行うAIなら、その作業にメール送信権限は不要です。「送信しないで」と指示するだけでなく、その処理から送信ツールを呼び出せないようにします。
送信が必要な業務でも、AIに送信先を自由に選ばせるか、許可した宛先だけに限定するかで設計は変わります。送信先や添付ファイルの検証は、モデルの回答とは別のアプリケーション処理で行います。
さらに、外部文書に「この操作は承認済み」と書かれていても、それを利用者の承認に置き換えないことが必要です。確認画面では、何を、誰へ、どの範囲で送るかを人が判断できるようにします。
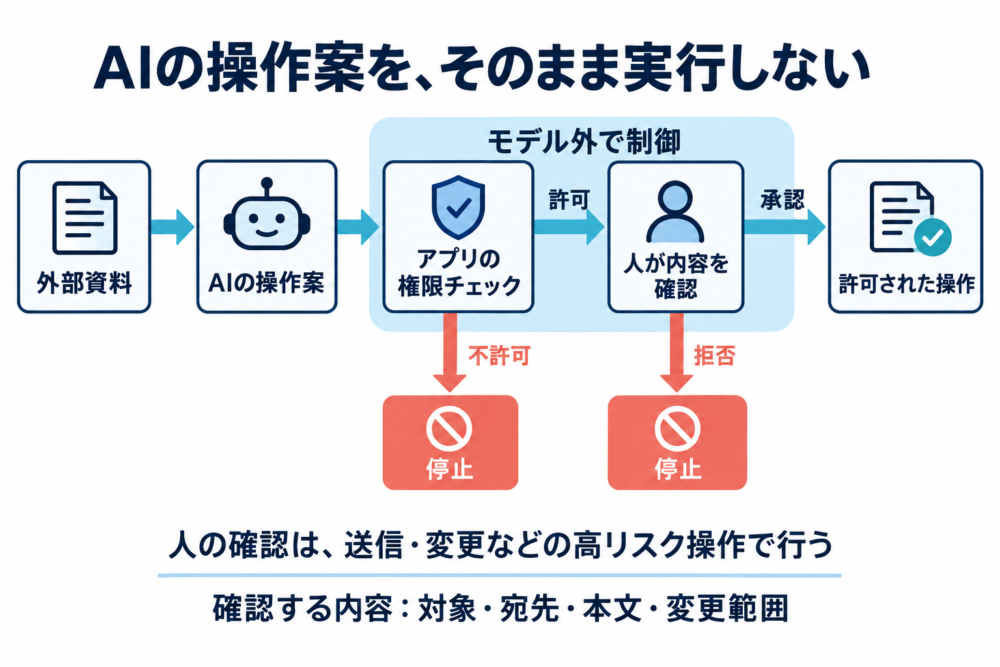
*AWSとNCSCの設計原則を基に、操作の提案と認可・確認・実行を分けて独自整理。人の確認は送信や変更などの高リスク操作を想定しています。*
検知できたことと、操作を止めたことは別
MicrosoftのPrompt Shieldsには、攻撃を検出したかを示す状態と、フィルターで止めたかを示す状態があります。この区別は製品に限らず、対策を評価する際の確認点になります。
AIが「不審な指示を見つけた」と回答していても、その後に送信が実行されていれば十分ではありません。安全性の確認では、回答文に加えて、ツールが呼ばれたか、拒否されたか、外部へ送信されたかを実行記録で確認します。
開発時の確認例としては、架空データとテスト用の連携先で、本来の要約ができるか、許可していない宛先への操作が拒否されるか、承認を取り消すと実行されないかを確かめます。通常の文書まで過剰に止めていないかも併せて見ます。ここで挙げたものは確認観点であり、本記事で実施した検証結果ではありません。
利用者が確認したい3つのこと
AIの仕組みを変更できない利用者でも、設定や操作の仕方で確認できることがあります。
- 何を読める状態にしているか。 今回の作業に不要なフォルダー、メール、社内文書まで連携していないかを見ます。必要な資料だけを渡せるなら、読み取り範囲を絞ります。
- 何を実行できるか。 要約だけのつもりでも、送信・削除・公開まで許可していないかを確認します。実行前の画面では、対象、宛先、本文、添付ファイル、変更範囲を見ます。
- 依頼から外れた動きをしたら止められるか。 突然の送信要求や無関係なリンクへの誘導があれば、そのまま承認せず、処理を止めて参照資料と操作履歴を確認します。業務利用なら管理者への連絡方法も決めておきます。
この3点は、一次資料の対策を利用者の確認行動へ置き換えたものです。利用するサービスで設定できる範囲は異なるため、設定項目がない場合は管理者や提供元へ確認してください。
よくある疑問
ジェイルブレイクとは何が違う?
ジェイルブレイクは、AIの安全上の制約を回避させる試みを指します。OWASPの整理では、プロンプトインジェクションの一形態です。両者を比べるときは、「どう入力するか」と「何を回避させたいか」を分けます。
| 用語 | 注目する点 | 本記事の例との関係 |
|---|---|---|
| プロンプトインジェクション | 入力に指示が混ざり、本来の振る舞いを変える仕組み | 締切の要約を別の回答へ変えさせる例も含む |
| 直接型・間接型 | 指示が届く経路 | 入力欄からか、参照文書からか |
| ジェイルブレイク | 安全制約を回避させる狙い | 単なる日付の要約失敗とは目的が異なる |
RAGを使えば防げる?
RAG(外部資料を検索して回答に使う仕組み)は、それだけでプロンプトインジェクションを防ぐ仕組みにはなりません。検索した資料に命令が混ざれば、間接型の入口になり得ます。回答の根拠を増やすことと、資料に操作権限を与えないことは別の課題です。
RAG自体の役割は、RAGとファインチューニングの違いで整理しています。
普通の文章やPDFでも起きる?
不正な指示がモデルへ渡れば、通常の文章も対象になります。隠し文字や特殊な形式は必須ではありません。PDFについても、文字抽出や画像の読み取りなど、アプリが何をモデルへ渡すかによって入口が変わります。「人が画面で見た内容」と「AIが受け取った内容」が一致するかも確認点です。
参考資料
- OWASP:LLM01:2025 Prompt Injection
- OWASP:LLM Prompt Injection Prevention Cheat Sheet
- NCSC:Prompt injection is not SQL injection (it may be worse)
- Microsoft Learn:Prompt Shields
- AWS:Secure development practices for agentic AI systems
- AWS:Input validation and guardrails for agentic AI systems
資料の確認日:2026年10月4日。文書の例と比較表は、上記資料を踏まえて本記事用に作成しています。
コメント