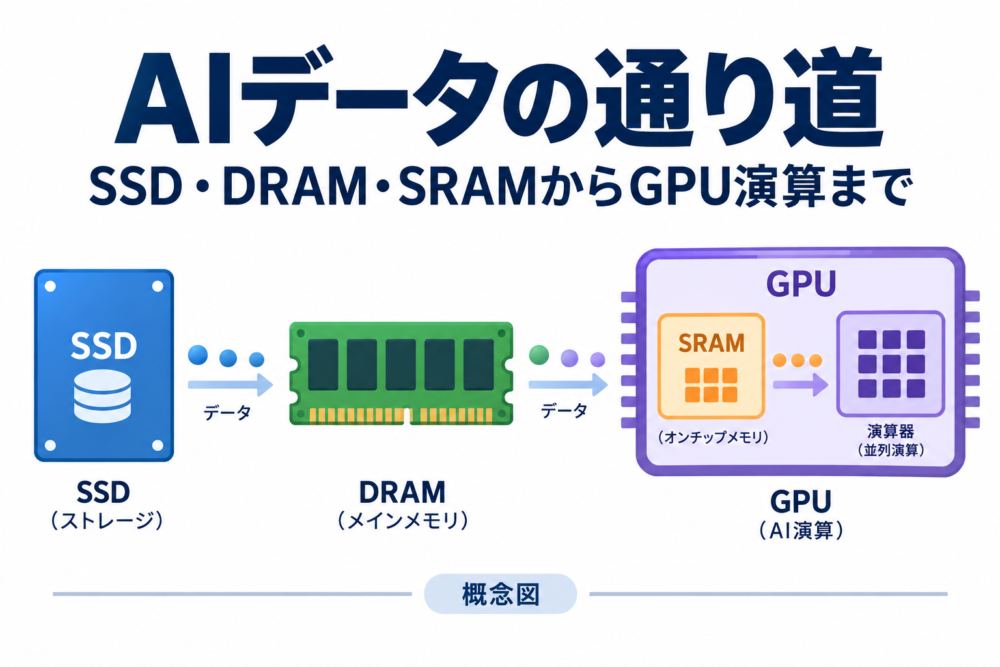
AIモデルはSSDに保存され、実行時にはメモリへ読み込まれます。GPUが計算するときは、その中から必要な値を取り出し、内部の小さな記憶領域で使い回します。「モデルを保存する場所」「実行中に置く場所」「演算の直前に値を保持する場所」を分けると、PC内部のデータの流れが見えてきます。
本記事では、モデルの重みW(学習によって決まった数値の集まり)と入力Xを追いかけます。初めはCPU側メモリとGPU専用メモリが分かれた構成を使い、後半で共有メモリの場合を説明します。
図は一般原理を説明するための概念図です。RTX Sparkなど特定製品の実配線、部品の面積比、実測速度を表すものではありません。GPU内部の用語は主にNVIDIA CUDAのモデルに沿います。
保存・配置・演算を、一つの地図で見る
典型的な独立GPU構成では、SSDにあるモデルファイルをCPU側の主記憶へ読み込み、GPU用に確保したメモリへ必要なデータを転送します。GPUはそこから値を読み、演算結果を書き戻します。CPU側で結果を表示・保存する場合は、必要な結果を取り出します。
このとき、CPUはプログラムを進め、転送や計算を指示する役割を担います。CPUが関与することと、すべてのデータがCPUの演算器を通過することは別です。 転送にはDMA(CPUが各バイトを読み書きする代わりに、装置側の機構がメモリ間でデータを運ぶ仕組み)も使われます。
GPUへ計算を依頼する単位をカーネル(GPU上で多数の処理を並列に実行する関数)と呼びます。CPUからのカーネル起動指示と、重みや入力の転送は、図の矢印を分けて追ってください。CUDA Refresher:プログラミングモデル
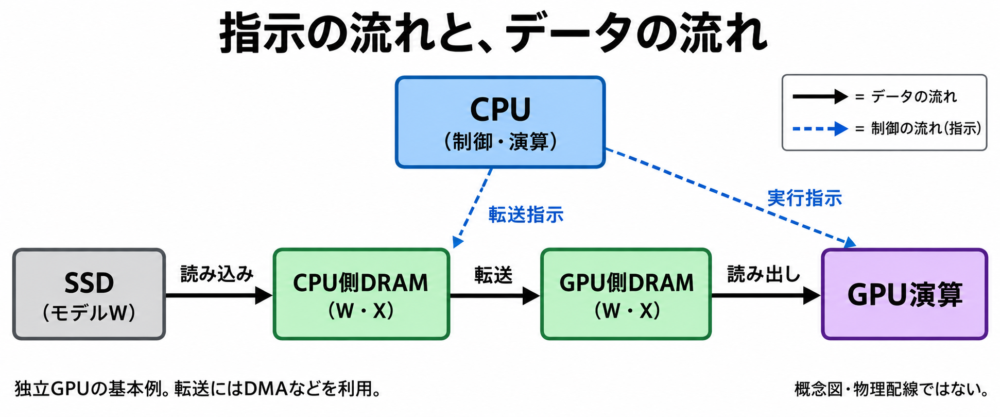
CUDAの処理モデルを基に作成した概念図。実線はデータ、破線は制御指示。Xの準備処理は省略しています。
SSD・DRAM・SRAMは、何が違うのか
CPU・GPUは処理を実行する装置の名前です。一方、DRAM・SRAMはデータを記憶する技術の名前で、キャッシュは記憶領域の使い方を指します。
| 用語 | 何を表すか | この説明での主な用途 | 得意なことと制約 |
|---|---|---|---|
| SSD | データを保存する装置 | モデルファイル、入力、保存結果 | 電源を切っても保持できる。演算器へ細かい値を供給する作業メモリとは用途が異なる |
| DRAM | Dynamic RAMという記憶技術 | CPUの主記憶、GPU用の大容量メモリ | 容量を確保しやすい。保持には電源とリフレッシュが必要 |
| SRAM | Static RAMという記憶技術 | CPU・GPU内のキャッシュなど | 小さな領域へ素早くアクセスしやすい。大容量化には面積などのコストがある |
| キャッシュ | データの一部を近くに保持する仕組み | 繰り返す読み出しを近くで満たす | 使いたい値が入っていれば役立つ。容量不足や置き換えで入っていない場合もある |
| レジスタ | 演算に使う値を保持する記憶領域 | 入力値、途中結果、累積値 | 演算器から利用しやすい。使える数が限られる |
一般的なSSDはNANDフラッシュ(電源を切っても値を保持する記憶技術)を使います。DRAMは記憶セルの電荷を維持するためにリフレッシュ(保持内容を定期的に維持する動作)を行います。SRAMはDRAMのような周期的リフレッシュを必要としませんが、通常のSRAMも電源を切れば内容を失います。Micron:SSDの仕組み、IBM:DRAM、Infineon:SRAM、Infineon:SRAMセルと揮発性
VRAM(GPU用の画像・演算データを置くメモリ)という呼び方も、SRAMと同じ分類ではありません。現在のGPUで使われるGDDRやHBMはDRAMの仲間です。「GPUのメモリはすべてSRAM」と覚えると、大容量の保存先とチップ内部の小さな作業領域を混同してしまいます。Micron:Graphics memory、Micron:High-bandwidth memory
モデルの重みWを、SSDから実行用メモリへ移す
起動時の読み込みと、推論中の読み出しを分ける
ここでは、必要なモデルの重みをGPUメモリに置けるアプリを想定します。流れは次のようになります。
- SSDから読む。 アプリがモデルファイルを開き、重みWを利用できるようにする。
- 実行時の置き場所を用意する。 CPU側の主記憶やGPUメモリに領域を確保し、形式や配置を整える。
- GPU側へ配置する。 独立GPUでは、必要な重みWや入力XをGPUがアクセスするメモリへ転送する。
- 推論を繰り返す。 配置済みのWと、その時点のX・途中結果を使って計算する。
重みが実行用メモリに残っていれば、演算のたびにSSDから同じモデルファイルを読み直す必要はありません。 SSDを速くする効果は、モデルを読み込む場面と、配置済みのモデルで計算する場面で分けて考えます。
ただし、メモリに収まらないデータを別の場所へ逃がすオフロードや、必要な部分だけ読み込む実装では、実行中にも転送が発生します。ロード時間と推論時間は、アプリの配置方式を確認してから比べる必要があります。
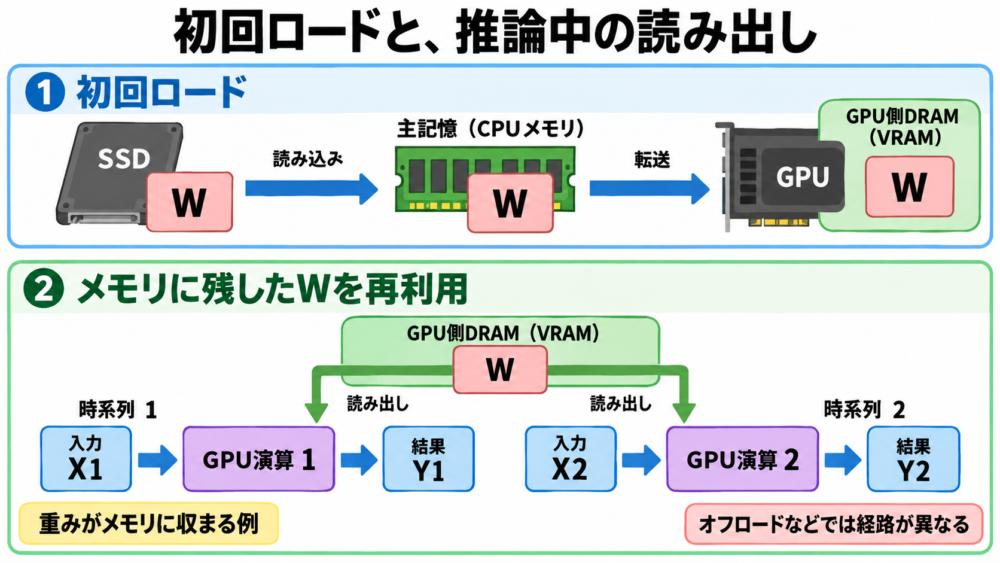
重みWを保持できる場合の説明例。図の二つの演算は、同じGPUで行う異なる時点の処理です。
ファイル全体を最初にコピーするとは限らない
例えばPyTorchには、mmap(ファイルを仮想アドレス空間へ対応付ける仕組み)を利用する読み込み方法があります。この場合、OSが必要な部分を物理メモリへ読み込むため、ファイル全体を一度にCPUメモリへコピーする方法とは動きが異なります。
図の「SSD→主記憶」は、読み込みの役割を示しています。実際にいつ、どの単位で読むかは、ファイル形式、OSのキャッシュ、アプリのロード方法に依存します。PyTorch:チェックポイントからのモデル読み込み
GPUの中へ拡大する:DRAMから演算器まで
GPU側へ配置されたWは、GPU内部のすべての記憶領域へ一括で移されるわけではありません。実行する命令に応じて必要な部分が読み出されます。
メモリコントローラー(メモリへの読み書き要求を調整する回路)がDRAMとの通信を扱い、GPU内部にはL2キャッシュ、その内側にSM(Streaming Multiprocessor:複数の演算器や記憶領域を含む実行ブロック)が並びます。一般的なCUDAの説明モデルでは、複数のSMがL2を利用し、SM内にL1キャッシュ、Shared Memory、レジスタがあります。
| 場所 | 主な役割 | 何と区別するか |
|---|---|---|
| GPUが使う大容量DRAM | W、X、出力、途中の配列などを置く | GPUチップ内の小さな記憶領域 |
| L2キャッシュ | 複数のSMから利用するデータの一部を保持 | モデル全体を置く領域 |
| SM内のL1キャッシュ | 演算に近い場所で読み出しに応える | プログラムが用途を決めるShared Memory |
| SM内のShared Memory | 協調するスレッド間でデータを保持・再利用 | CPUとGPUが共有する主記憶 |
| レジスタ | 各スレッドが使う値や途中結果を保持 | 大きな配列全体の保存先 |
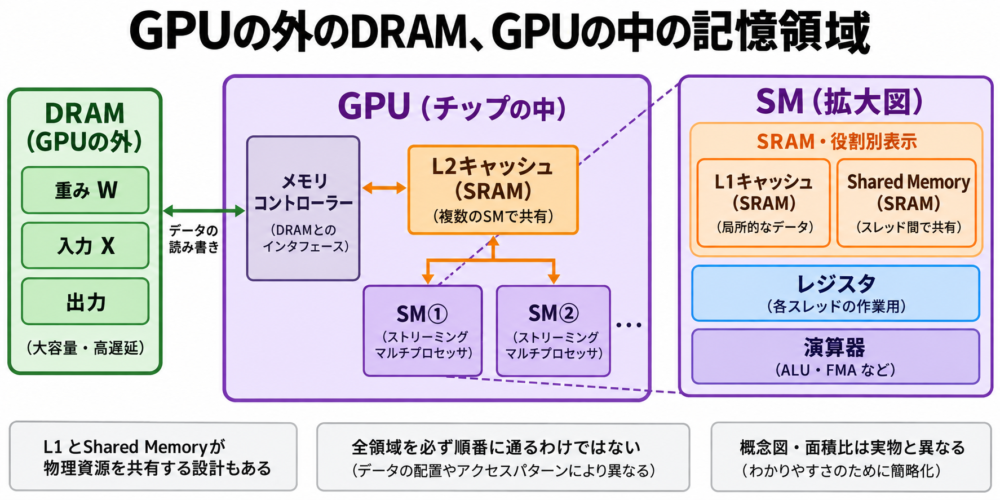
CUDAのハードウェアモデルを基に作成した概念図。ALUは算術・論理演算器、FMAは乗算と加算を組み合わせる演算を指します。枠は役割の区別です。
スレッドは並列処理の単位です。Shared Memoryは、基本的には同じスレッドブロック(協調して実行するスレッドの集まり)から使う領域として考えると理解しやすくなります。対応GPUにはブロック間で利用する拡張もありますが、本記事は基本形を扱います。CUDA Programming Model
L1とShared Memoryの物理資源を共有する設計もあるため、図中の枠は役割の区別です。また、「DRAM→L2→L1→Shared Memory→レジスタ」という一本道が、すべての命令に必須という意味ではありません。 キャッシュの利用方法やShared Memoryを経由するかどうかは、命令・プログラム・GPU世代に依存します。
local memoryは「近いメモリ」とは限らない
CUDAのlocal memoryは、スレッドごとに使うという論理的な範囲を表す名前です。物理的にはデバイスメモリ側にあり、レジスタに収まらない値などの保存先になります。レジスタ不足で値が外へ退避することをスピルと呼びます。「local」という単語だけで、チップ内の高速SRAMと判断しないことが大切です。CUDA:Writing SIMT Kernels
同じ値を近くに置くと、何が減るのか
キャッシュは、要求された値が近くにあるかを調べる
あるデータを要求したとき、利用するキャッシュにそのデータがあればキャッシュヒットです。なければキャッシュミスとなり、より下位の階層へ要求を進めます。
例えば「L1にはないがL2にはある」場合と、「L2にもなくDRAMから読む」場合では、データが届く経路が変わります。読み出すたびにSSDまで戻るわけではありません。ここでは実行用DRAMに配置済みのデータを考えています。
キャッシュは容量が限られ、別のデータによって内容が入れ替わります。そのため、同じ値を再度使う場合でも、毎回必ずヒットするとは限りません。CUDA Best Practices Guide:メモリ階層
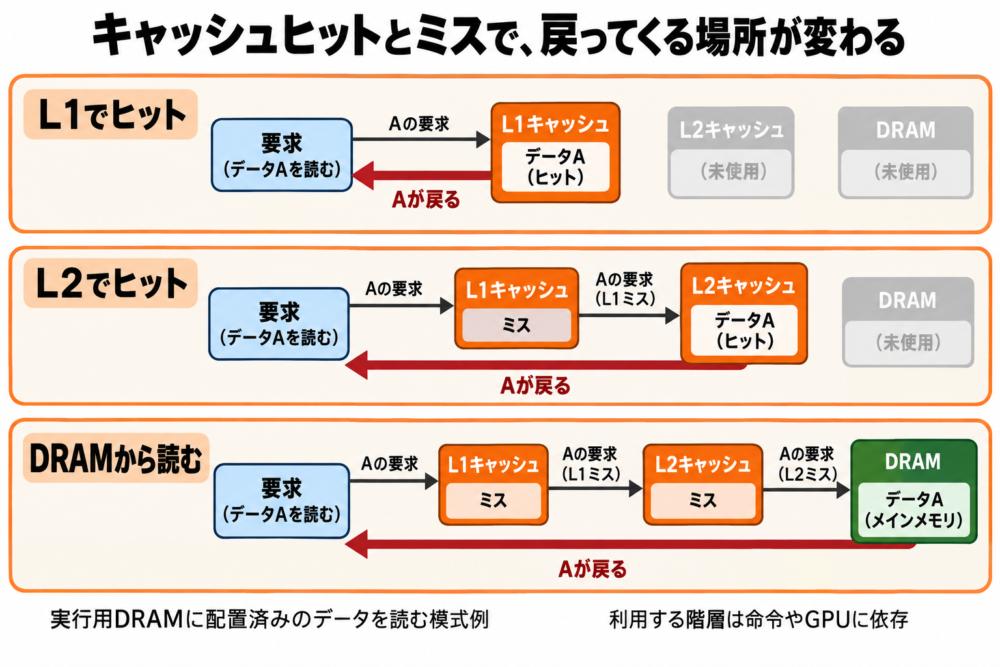
要求先と値が戻る場所を示す模式例。図中のDRAMはGPUが利用する大容量メモリを指し、CPU側メモリへ毎回戻る意味ではありません。
Shared Memoryは、再利用する部分をプログラムが選ぶ
Shared Memoryを利用するカーネルでは、再利用する値をプログラムが指定して読み込み、協調するスレッドが使います。たとえば大きな行列からタイル(計算しやすい小さな部分行列)を切り出し、その部分を使って複数回の計算を進める方法です。
| 方法 | 誰が保持を管理するか | 利点 | コスト・条件 |
|---|---|---|---|
| キャッシュ | 主にハードウェア | 専用のコピー処理を書かずに再利用が効く | 必要なデータが残るかはアクセスや容量次第 |
| Shared Memory | プログラムが用途や読み込みを指定 | 協調処理で再利用する範囲を決められる | 容量、読み込み処理、スレッド間同期が必要 |
| レジスタ | コンパイラーによる割り当てが中心 | スレッド内で途中の値を保持できる | 使用量が多いと同時実行数やスピルに影響 |
説明用に、4個の値A・B・C・Dを4回の計算で使う場合を考えます。毎回4個を要求すれば、論理的な要求は4×4=16個分です。最初に4個を近くへ読み込み、以後そこで使い回せれば、元の領域への要求は4個分、残りは近くでの再利用にできます。
この16対4は、説明用に数えた値の要求数です。実機ではキャッシュやまとめ読みが働くため、DRAMの転送回数や実行時間がそのまま4分の1になるとは限りません。Shared Memoryへの書き込みや同期も必要です。CUDA Best Practices Guide:メモリ最適化
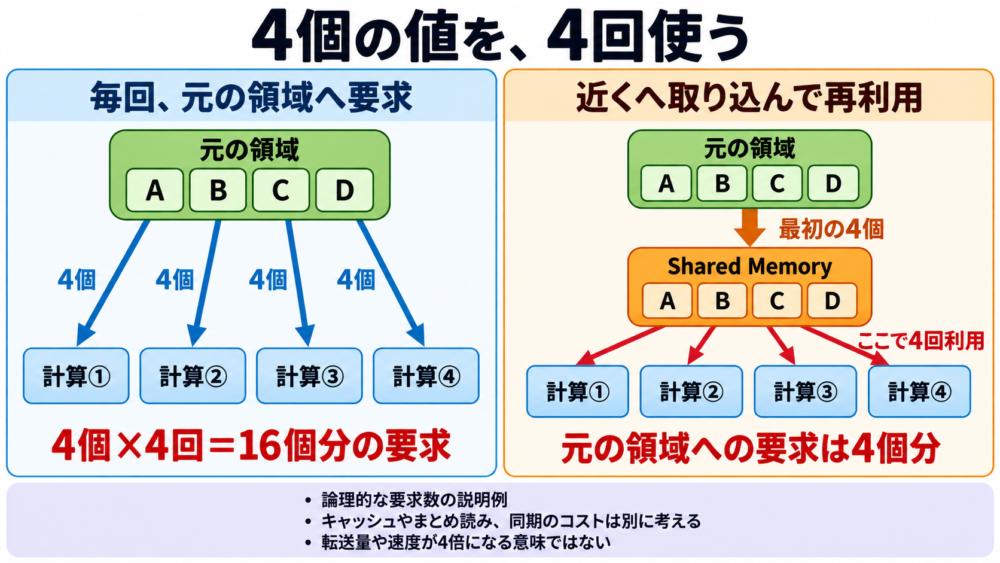
筆者による説明用の数え方。16対4は元の領域に対する論理要求数で、実測転送量や速度比ではありません。
行列積を実装するときは、タイルに必要な容量、同じ値を使う回数、スレッド間で待ち合わせる位置を一緒に考えます。再利用を増やしても、そのための読み込みや同期が増えれば効果は変わります。
計算が終わった結果は、どう戻るのか
ここでは入力Xと重みWから得た出力をYとします。GPUは演算中の値をレジスタなどに保持し、必要な結果を出力用のメモリ領域へ書き込みます。その後にCPUで使う場合は、処理完了を確認してから必要なYを読み出します。
独立GPU構成ではGPUメモリからCPU側メモリへのコピーが必要になる場合があります。Yを続くGPU処理で使うなら、その場に置いたまま次のカーネルへ渡せます。中間結果を毎回CPUへ戻す設計では、戻すたびに転送が増えます。
表示と保存も別の処理です。結果を画面に出しただけでは、ファイルとしてSSDへ保存したことにはなりません。保存する場合は、アプリが結果をファイルの形式に整え、OSを通じて書き込みます。CUDA Refresher
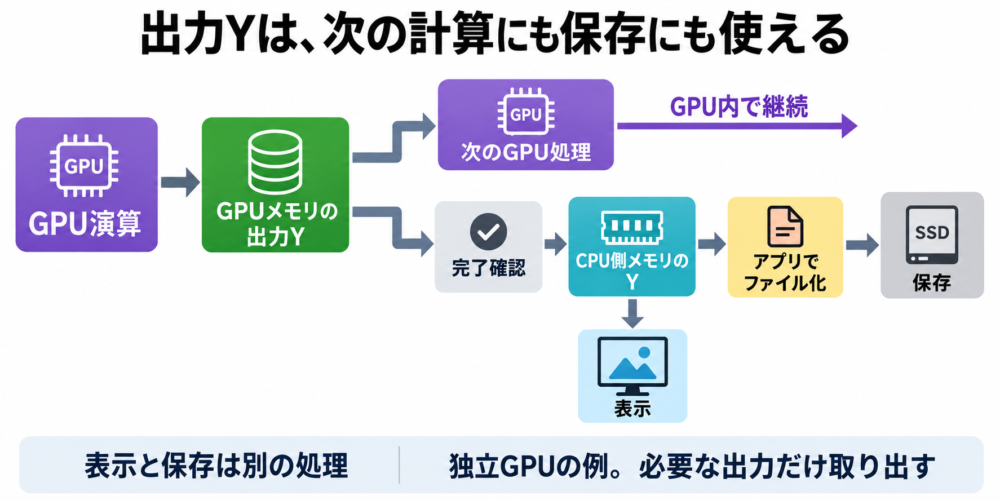
出力Yの用途に応じた経路の例。CPUで利用する前に必要な計算・転送の完了を確認します。
共有メモリや直接転送なら、経路はどう変わるか
| 構成・方式 | 変わる経路 | 残る処理・確認点 |
|---|---|---|
| 独立GPUで明示的にコピー | CPU側DRAMからGPU側DRAMへ配置する | 転送完了とカーネル実行の順序を管理する |
| CPU・GPUが物理メモリを共有 | 同じ領域を両方が利用できれば、別のDRAMへのコピーを減らせる | GPU内部への読み出し、キャッシュ、同期、形式変換は考慮する |
| GPUDirect Storage対応構成 | ストレージとGPUメモリ間でCPU側の中継バッファを避けられる | 対応ハードウェア・ソフトウェア・I/O条件が必要 |
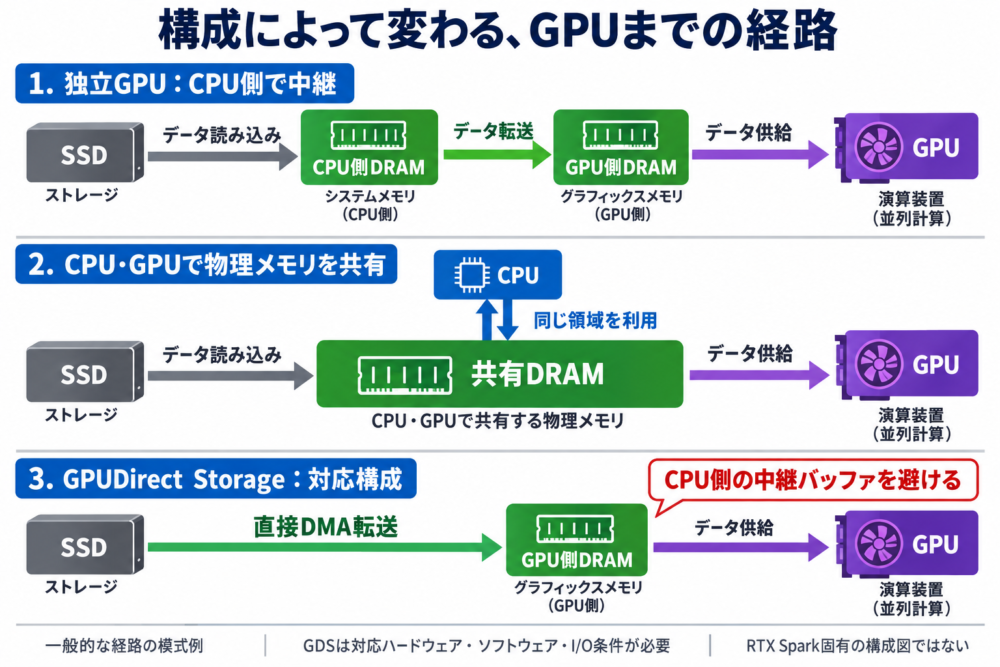
CUDAとGPUDirect Storageの説明を基に作成。実配線ではなくデータ経路の違いを示しています。
ユニファイドメモリ構成でも、GPU内部の演算器がDRAM上の値を使うためのデータ移動は残ります。共有する物理メモリと、GPU内のShared Memoryの違いは、関連記事のユニファイドメモリとは?CPU・GPUの共有とデータ転送を図解で整理しています。
GPUDirect Storageは、対応環境でCPU側の中継バッファを避けるDMA経路を提供します。これはSSDから演算器がそのままモデルを実行するという意味ではなく、GPUメモリへのデータ搬入経路を変える仕組みです。本記事では一般的な方式の違いとして紹介しており、RTX Sparkや手元のPCで使えることを保証する説明ではありません。NVIDIA:GPUDirect Storage Overview
待ち時間を調べるなら、どの区間かを分ける
データ経路が分かると、「AIが遅い」という一つの症状を、確認する区間へ分けられます。次の表は原因を断定するものではなく、計測の出発点です。
| 状況 | 最初に区別すること | 確認する例 |
|---|---|---|
| モデルを開くまでが長い | ファイル読み込みと、形式変換・初期化 | ストレージI/O、初回と2回目の差、ロードのログ |
| GPU計算開始まで待つ | 入力準備とCPU・GPU間転送 | CPU処理時間、転送量、同期の位置 |
| 配置済みでも計算が遅い | 演算とGPU内のメモリアクセス | カーネル実行時間、メモリ転送、再利用の状況 |
| 容量を超えると急に遅い | オフロードや再読み込みが始まっていないか | 実行時メモリ量と転送ログ |
| 結果の取得や保存が長い | GPU完了待ち、結果コピー、ファイル書き込み | 各処理の完了時刻 |
製品発表との関係を知りたい場合は、RTX Spark搭載PCとは?IFA 2026発表とローカルAIの仕組みを図解へ進んでください。
PCの構成を見るときは、「このデータはいまどこにあり、次にどこで使われるか」を一つずつ追うと、容量不足と転送待ち、演算時間を分けて考えられます。
コメント