ハルシネーションとは、生成AIが、事実と異なる内容や根拠のない内容をもっともらしく出力する現象です。文章が自然で、数字や出典まで添えられていても、それだけで正しいと判断することはできません。
回答を使う前に役立つのが、内容を一つずつの主張に分け、元資料の該当箇所と照合することです。この記事では、意味と原因を整理したうえで、数字・出典・条件を確認する方法を架空のアンケートで説明します。
ハルシネーションとは
たとえば、実在しない資料名を示す、元資料と違う数字を書く、資料にはない理由を補って断定する、といった出力が問題になります。NIST(米国国立標準技術研究所)は、誤った内容を確信的に提示する現象を「Confabulation」と呼び、入力との不整合や、回答を正当化するために作られた引用にも注意を向けています。NIST AI 600-1 §2.2
AIの文脈で使う「幻覚」という訳語は、出力の誤りを説明する比喩です。人間が意図的に嘘をつくときの心理を、そのままAIに当てはめると仕組みを捉えにくくなります。また、架空の物語を頼んで得た創作と、事実を尋ねて得た誤情報では、求めている正確さが違います。ここでは調べ物や資料の要約など、根拠に沿った回答が必要な場面を扱います。
具体例:数字の誤りと資料にない主張を分ける
次の「あおばワークショップ参加者調査」は、確認方法を説明するための架空資料です。AIの回答例も説明用に作成したもので、特定のモデルを動かした実験結果ではありません。掲載図は生成AIを用いて本記事用に作成した概念図です。
| 元資料に書かれていること | 内容 |
|---|---|
| 調査時期 | 2026年9月 |
| 回答者数 | 200人 |
| 「満足」と回答した人数 | 120人 |
| 年齢別の集計 | 行っていない |
この資料について、「回答者は200人で、満足率は75%。特に20代の満足度が高い」と説明されたとします。文章全体を正しいか間違いかの二択で判断せず、主張を分けて確かめると問題が見えます。
| 回答の主張 | 照合する内容 | 判断 |
|---|---|---|
| 回答者は200人 | 元資料の回答者数 | 資料と一致 |
| 満足率は75% | 120人 ÷ 200人 × 100 = 60% | 資料の数字から計算すると矛盾 |
| 20代の満足度が高い | 年齢別の集計の有無 | この資料では確認できない |
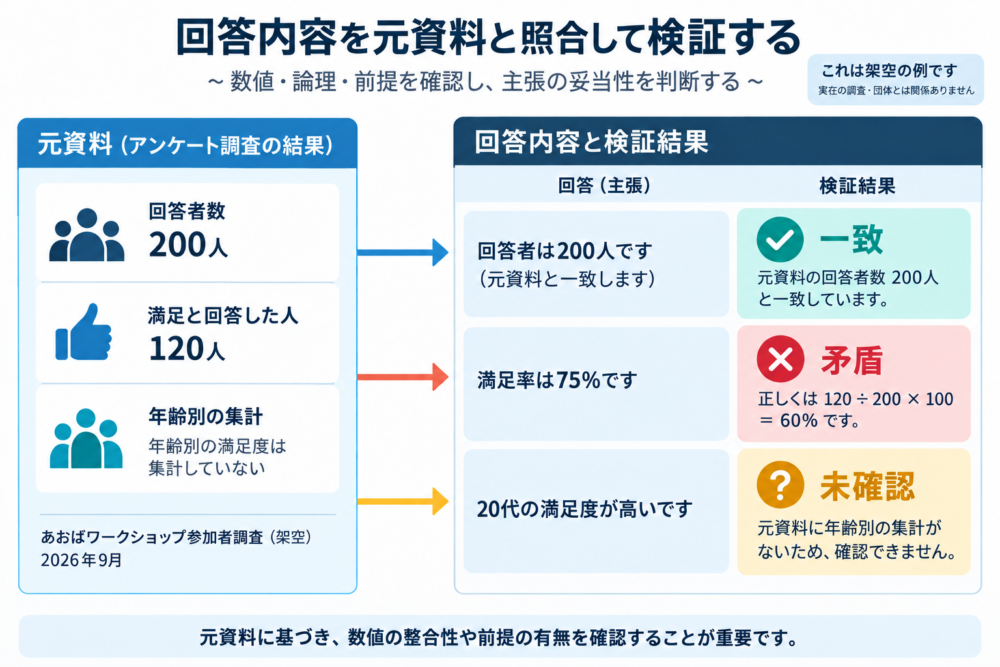
*本文の架空資料を基に独自作成。実際のAI出力や調査結果ではありません。*
満足率は、120 ÷ 200 = 0.6、百分率へ直すと60%です。75%という説明は、今回の集計条件と食い違っています。
一方、「20代の満足度が高い」は、手元の資料だけでは真偽を決められません。根拠がないため要約に採用できませんが、未確認というだけで「20代の満足度は高くない」と反対の結論を出すこともできません。
この違いを踏まえ、要約は「2026年9月の調査では、回答者200人のうち120人が満足と回答した。回答者に占める割合は60%。年齢別の傾向はこの資料では分からない」と直せます。対象が回答者であることも残し、参加者全員の結果へ広げないようにします。
Microsoftの公式資料でも、Groundedness(出力が元資料に根拠を持つ度合い)は、与えられた情報との関係で説明されています。ここから本記事では、資料との一致と、現実の事実としての正しさを別々に確認する方針を取ります。古い案内を忠実に要約しても、現在の案内として正しいとは限らないからです。Microsoft Groundedness detection
なぜ生成AIはもっともらしく間違えるのか
自然に続く文章と、確かめられた事実には違いがある
LLM(大規模言語モデル)は、大量の文章から学んだパターンと入力を使い、続くトークン(文章を処理する単位)を予測して文章を生成します。この仕組みで正しい説明も作れますが、一文ごとに原資料を開いて真偽を確認する処理が、自動的に保証されるわけではありません。
NISTは、こうした統計的な生成が、正確な内容とともに不正確・不整合な内容も生み得ると説明しています。読みやすさだけを手がかりにすると、回答の中に混じった小さな誤りを見落とします。NIST AI 600-1 §2.2
情報が足りない場面でも回答を埋めてしまう
質問に答えるための資料が入力に含まれていない、対象の時期や製品の版が曖昧、覚えている情報が不確か、といった状況では、断定できる根拠が足りません。それでも具体的な日付や数字が出力されると、利用者には調査済みの答えのように見えます。
OpenAIの2025年の研究解説は、学習と評価の設計にも目を向けています。正解した数を中心に評価し、回答を控えることに得点を与えない条件では、不確かな質問にも推測で答える方が評価され得る、という説明です。これは原因の一つを説明する研究であり、すべての誤りを同じ理由で説明するものではありません。OpenAI「言語モデルでハルシネーションがおきる理由」
したがって、利用時には「分からない」と答えられる条件を用意しつつ、返された回答の根拠を確認する必要があります。
AIの回答を確認する5つの手順
以下は、本記事で提案する確認の進め方です。全文を均等に読み直すより、結論に影響する固有名詞・数字・日付・条件から照合すると、確認対象を絞れます。
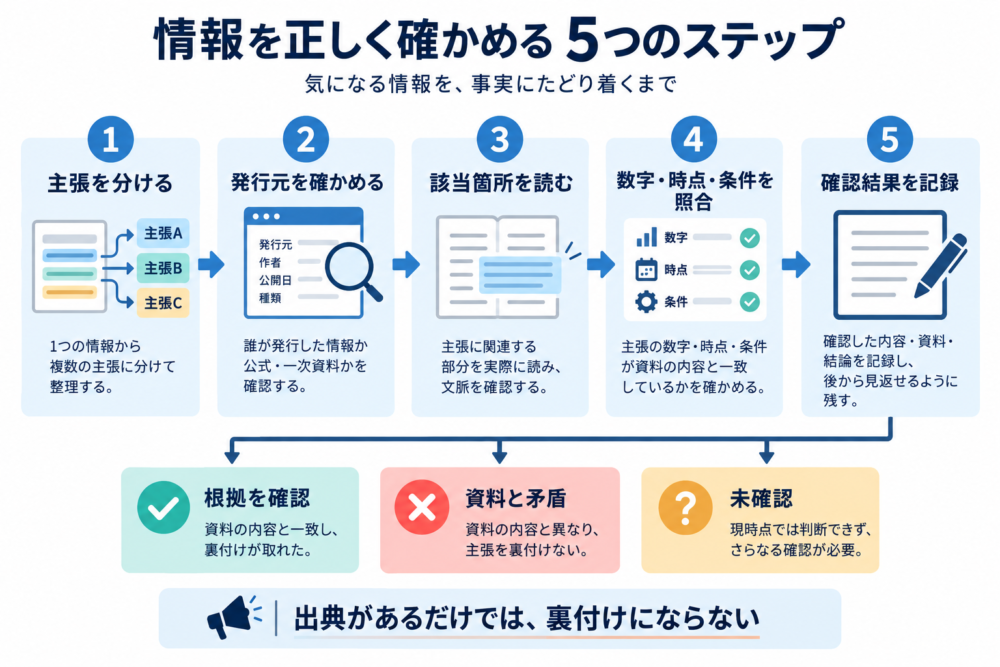
*本記事で提案する確認手順。出典の実在確認と主張の照合を分けています。*
1. 確認する主張を短く分ける
「A社が2026年に機能Bを公開し、処理時間が半分になった」なら、会社名、公開年、機能の存在、改善幅は別の主張です。一つが正しくても、残りまで正しいとは限りません。上のアンケート例でも、回答者数と満足率を分けることで、正しい部分を残して修正できました。
2. 出典を開き、発行元と資料の実在を確認する
URLが付いていたら実際に開きます。論文なら著者・題名・掲載先、製品情報ならメーカー・型番、統計なら調査主体と資料名を確認します。リンクが開かない場合は、資料名で発行元のサイトを探す方法もあります。
検索して見つからないだけで、資料が存在しないと断定するのは早計です。移転や公開範囲の制約もあり得るため、見つけられない間は「出典未確認」として扱います。AIに別のURLを作らせ続けるより、発行元から辿り直す方が確認の経路を把握できます。
3. その出典が、主張を裏付けているか読む
実在するページが見つかっても、回答の裏付けになるとは限りません。該当する段落・表・注記まで開き、書かれている内容と回答を対応させます。
アンケートなら「回答者200人」の記載を見つけたあと、満足した人数と集計対象を確認します。資料名が正しいことを確かめるだけでは、75%という誤りも、年齢別の根拠不足も残ります。
4. 数字、単位、時点、適用条件を照合する
割合は分子と分母を確認し、必要なら計算機で再計算します。日付は公開日だけでなく、調査時期や適用開始日も見ます。仕様や操作手順なら、対象の版・地域・プランが一致しているかを調べます。
| 確認対象 | 見落としやすいずれ | 確認する場所 |
|---|---|---|
| 数字・割合 | 回答者と全参加者の取り違え | 集計対象、分子、分母 |
| 単位 | 人と件、月額と年額の混同 | 表の見出し、注記 |
| 日付 | 発表日と利用開始日の混同 | 本文の時点・適用日 |
| 対象条件 | 別の版や地域の情報を適用 | 型番、バージョン、対象範囲 |
5. 確認できない部分を残したまま、利用可否を決める
確認結果は「根拠を確認」「資料と矛盾」「未確認」に分けて記録します。未確認の部分が結論を左右するなら、追加資料を探すか、担当者へ確認してから使います。確認できた部分だけで足りるなら、回答の範囲をそこまでに絞ります。
先ほどの例では、年齢別の傾向を落とせば、回答者数と満足率を使った要約を作れます。根拠不足を想像で埋めないことが、実際の修正につながります。
ハルシネーション対策は役割を分けて組み合わせる
指示で、使う資料と答えられない場合の扱いを決める
資料を渡して要約を頼むときは、回答の範囲を具体的に指定できます。たとえば、次のような依頼です。
添付資料に書かれた内容だけを使って要約してください。数字には集計対象と該当箇所を付け、計算した値は式も示してください。資料から分からない点は「資料では確認できない」と書き、推測を事実として補わないでください。
これは確認しやすい回答を得るための指示例です。指示に従っているかは出力を見て確かめます。機密資料を使う場合は、組織で許可された環境と情報の範囲に従ってください。
資料の版や未決事項を整理して渡す方法は、コンテキストエンジニアリングの解説で詳しく扱っています。
RAGや検索を使っても、情報源と回答の確認は残る
RAG(検索拡張生成)は、検索で取得した資料を使って回答を生成する仕組みです。Google Cloudは、出力を検証可能な情報源へ結び付けるGrounding(根拠付け)が、内容を作り上げる可能性を減らすと説明しています。Google Cloud Grounding overview
この仕組みを使う場合も、何が見つかり、何を根拠に答えたかを見る必要があります。たとえば、検索結果が旧版だけなら、回答も現在の条件に合わない可能性があります。資料が適切でも、要約で条件が抜けたり、資料にない説明が加わったりしていないかを照合します。これは検索と生成を別々の段階として確認する、本記事の実務上の整理です。
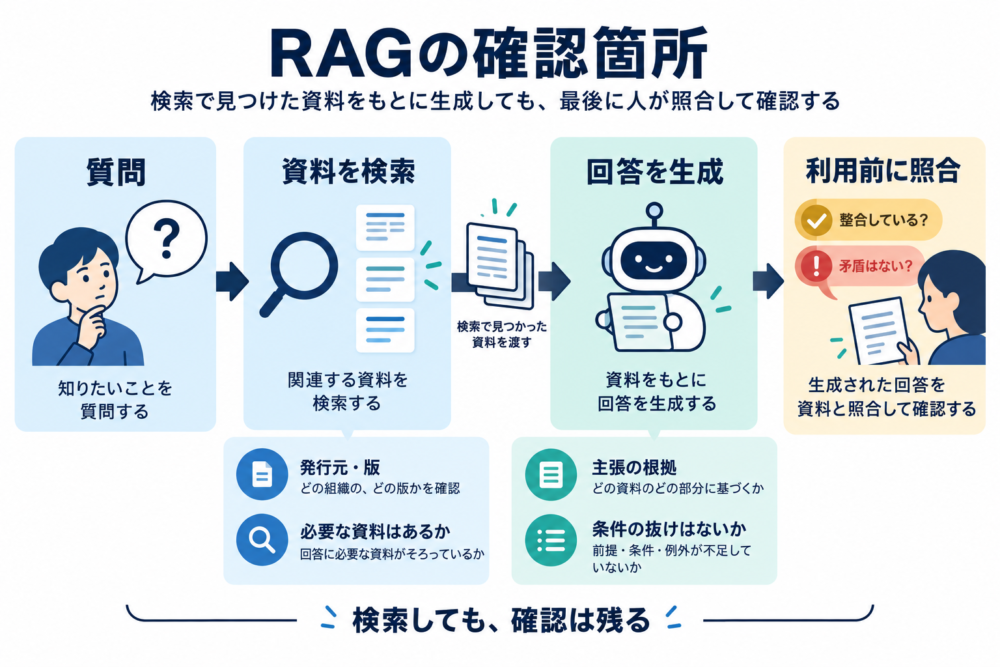
*Google Cloudの根拠付けの説明を基に、確認箇所を独自に整理。*
| 対策 | 担当する役割 | 残る限界・負担 |
|---|---|---|
| 資料と回答範囲を指示する | 何に基づいて答えるかを明確にする | 指示遵守と資料の正しさは別途確認が必要 |
| 検索・RAGを使う | 必要な外部情報を回答時に参照させる | 検索漏れ、古い資料、生成時の解釈のずれを確認する |
| 元資料と人が照合する | 主張と根拠、対象条件を確認する | 時間がかかり、分野の知識が必要な場合がある |
| 計算機などで再計算する | 数値処理を検算する | 元の数字や式の選び方は確認が必要 |
「どの方法なら完全に防げるか」だけを考えると、確認する場所が曖昧になります。資料を選ぶときは発行元と版を、回答を使うときは主張と該当箇所の対応を確認します。
よくある疑問
同じAIに「本当ですか」と聞き直せば十分ですか?
訂正のきっかけにはなりますが、聞き直した回答にも誤りが含まれる可能性があります。追加の説明も生成された文章なので、最終的には元資料の該当箇所で確認します。別のAIも同じことを答えた、という一致だけを根拠にしないようにします。
出典付きの回答は信用できますか?
確認先がある点は役立ちます。信用できるかを判断するには、出典の実在、主張を支える記述、資料の時点と対象条件まで照合します。URLの本数を数えるだけでは判断できません。
自信のある書き方なら正確ですか?
断定口調は正確さの証明になりません。NISTが指摘するように、誤った説明にも根拠らしい引用や論理が添えられることがあります。言い切りの強さより、主張と原資料の対応を見てください。
参考資料
- NIST, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile(AI 600-1)
- OpenAI, 言語モデルでハルシネーションがおきる理由
- Microsoft Learn, Groundedness detection
- Google Cloud, Grounding overview
資料確認日:2026年10月4日。
コメント