Kas

AI研究・論文解説

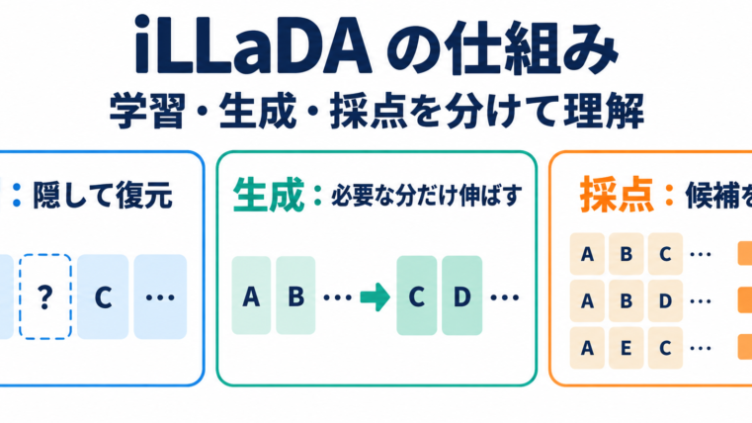
iLLaDAとは?可変長生成と信頼度スコアで理解するLLaDAからの改良

iLLaDAの仕組みを初学者向けに図解。LLaDAからの変更を、SFTのマスク範囲、ブロック単位の可変長生成、選択肢の信頼度スコアに分けて説明します。GQAの共有関係や評価結果の条件も整理します。
AI研究・論文解説
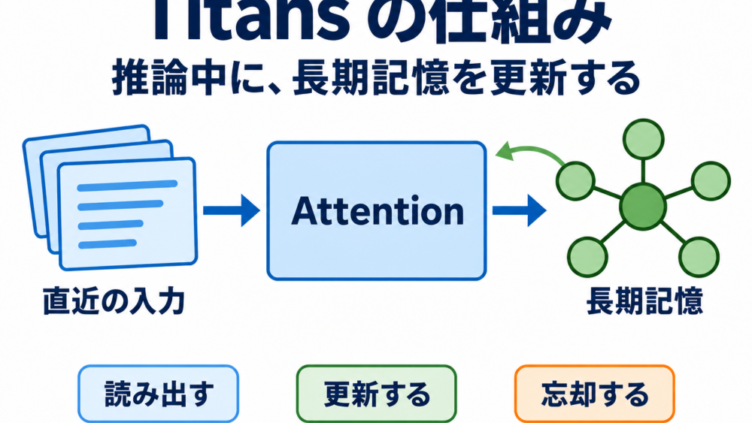
Titansとは?推論中に長期記憶を更新するAIの仕組みを図解

Titans論文を初学者向けに図解。3種類の記憶、読み書き、勾配更新の数値例、モメンタムと忘却、MAC・MAG・MALの構成、KV Cache・MLA・RAGとの違いと実験の限界を解説します。
AI技術・仕組み

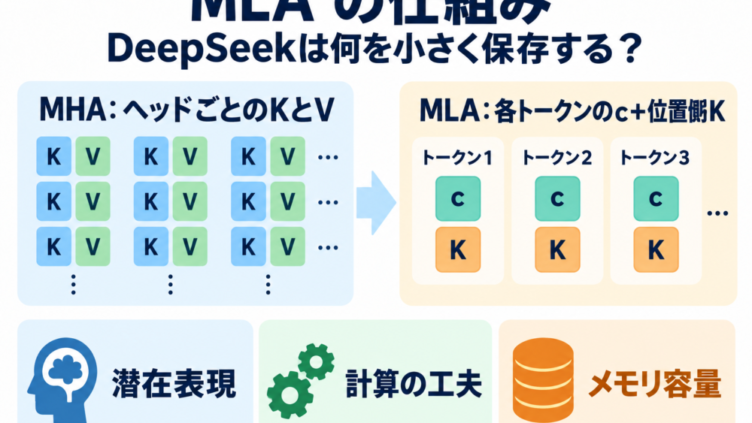
MLAとは?DeepSeekがKV Cacheを小さくする仕組みを図解

DeepSeekのMLAを初学者向けに図解。KV Cacheの共同圧縮、計算順序の工夫、RoPEの分離、GQAとの違い、実設定を使った容量計算とGPU上で効果が出る条件を解説します。
AI技術・仕組み

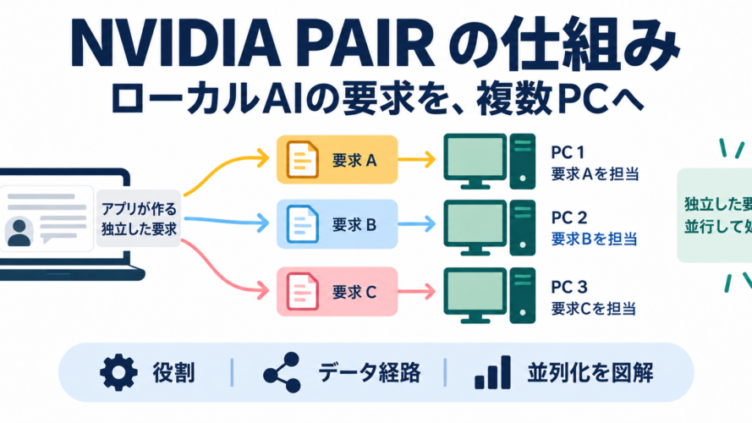
NVIDIA PAIRとは?複数PCにローカルAIの推論を振り分ける仕組み

NVIDIA PAIRの役割と推論リクエストの分散を図解。Ollama・LM Studioとの分担、CPU・GPUへのデータ経路、モデル配置、VRAMを合算しない理由、並列化の用途とベータ版の制約を解説します。
AI技術・仕組み

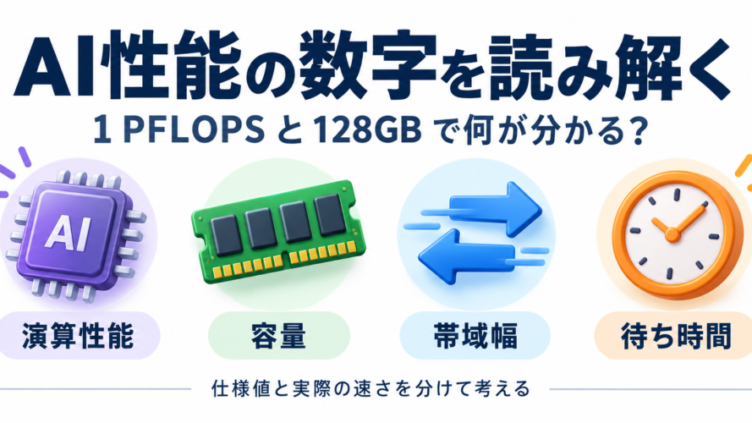
「1 PFLOPS」「128GB」でAI性能は分かる?RTX Sparkから学ぶ性能指標

RTX Sparkの最大1 PFLOPS・128GBを入口に、AIの演算性能、メモリ容量、帯域幅、待ち時間を図解。FP4の条件、必要容量と転送時間の計算、TTFT・ITL、実測を比較するときの確認点を解説します。
AI技術・仕組み

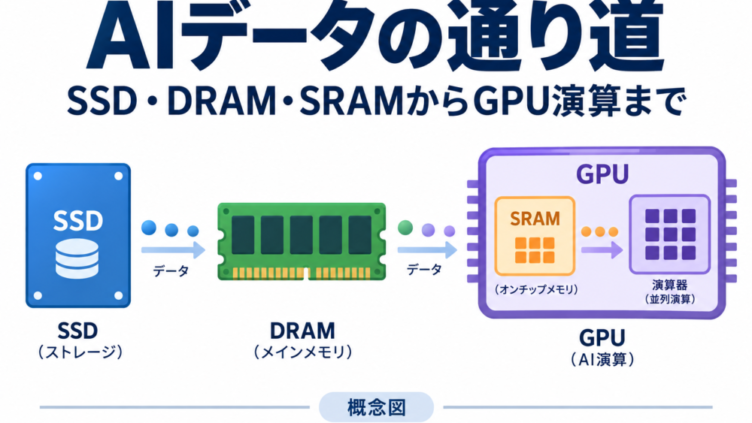
AIのデータはどこを通る?SSD・DRAM・SRAMからGPU演算まで

AIモデルがSSDから読み込まれ、DRAM・キャッシュ・Shared Memory・レジスタを使ってGPUで演算される流れを図解。CPUの指示とデータ転送、SRAMとVRAMの違い、再利用、結果保存までを説明します。
AI技術・仕組み

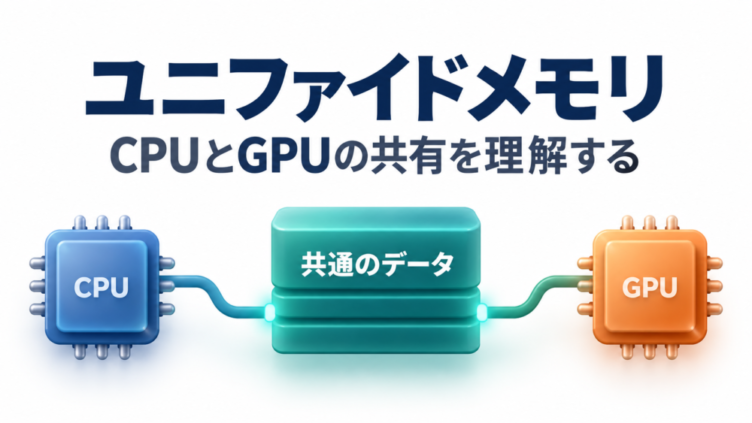
ユニファイドメモリとは?CPU・GPUの共有とデータ転送を図解

ユニファイドメモリとVRAMの違いを図解。CPU・GPUの物理共有、CUDA Unified Memory、GPU内Shared Memoryを区別し、仮想アドレス、ページ移動、同期、バッファ再利用、AIに必要な容量の考え方を説明します。
AIニュース・サービス

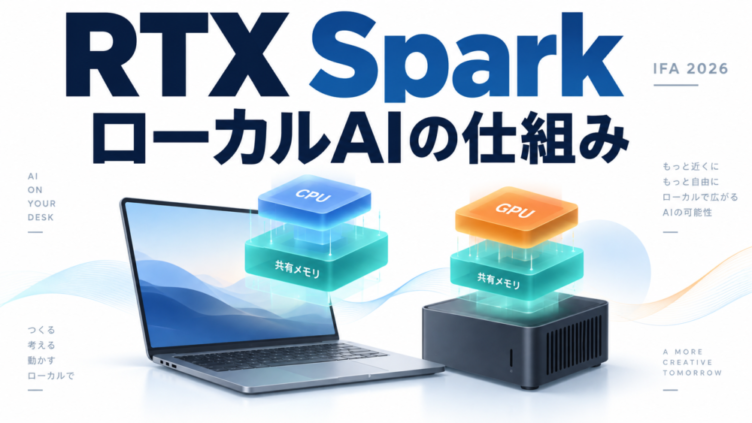
RTX Spark搭載PCとは?IFA 2026発表とローカルAIの仕組みを図解

IFA 2026で紹介されたRTX Spark搭載PCを解説。Acer・Lenovoの発表、DGX Sparkとの違い、CPU・GPU・ユニファイドメモリ・SRAMの役割、文書要約のデータ転送を図解し、最大1PFLOPと128GBの読み方を整理します。
カメラ

AFモードの違いを技術解説|AF-S・AF-C・AF-Aとフォーカスエリアの選び方

AF-S・AF-C・AF-Aの動作と、単点・ゾーン・全域・追尾の違いを図解。瞳AFとの役割分担、合焦優先、親指AFも解説し、人物・子ども・鳥・静物を撮るときの設定例と失敗の切り分けを整理します。
AI開発・実装

Mac miniのOllamaを別のPCから使う方法|自宅LANで接続・確認する手順

Mac miniのOllamaをWindowsや別のMacから使う手順を解説。macOSアプリ版のOLLAMA_HOST設定、モデル一覧の取得、文章生成、接続できない場合の切り分けとローカル限定への戻し方を整理します。
スポンサーリンク