ユニファイドメモリは、PCの製品仕様では主にCPUとGPUが共通の物理メモリを利用する構成を指します。同じデータを別々のメモリへコピーする工程を減らせますが、計算に必要な読み書きや処理順序の管理は残ります。また、CUDA Unified MemoryやGPU内部のShared Memoryは、共有する対象や目的が異なります。
RTX Spark搭載PCの発表とローカルAIの仕組みでも、大容量のユニファイドメモリが特徴として挙げられています。この記事では製品の最大仕様から一歩進み、「何を共有するのか」「どの転送を減らせるのか」「なぜ同期が必要なのか」を順に見ていきます。
図は公式資料の概念を基に独自に作成した説明図です。特定製品の実際の配線・チップ配置・性能測定を表すものではありません。製品とソフトウェアの記述は2026年9月19日時点の資料に基づきます。
「共有メモリ」は、何を共有するかで意味が変わる
最初に、似た名前の三つの仕組みを分けておきましょう。
| 用語 | 共有するもの・相手 | 理解するための問い |
|---|---|---|
| 製品仕様のユニファイドメモリ | CPUとGPUなどが利用する物理メモリ | データはどこに置かれているか |
| CUDA Unified Memory | CPUとGPUから扱えるよう管理されたメモリ | アクセスに合わせて配置や移動をどう管理するか |
| GPUのShared Memory | GPU内で協力するスレッド群が使う作業領域 | 演算の近くでデータをどう再利用するか |
CUDA(NVIDIAのGPU計算環境)の用語と、PCの仕様表にある容量表示を同じ意味で読むと、理解が混ざりやすくなります。この記事では、最初の意味を「物理メモリの共有」と呼び、必要に応じてほかの二つと区別します。
出典:Apple siliconのシステム構成、CUDAのUnified and System Memory、CUDA Programming Model
CPUとGPUが同じ物理メモリを使うとは
CPU(中央処理装置)はアプリの処理を進めたり、条件を判断したりします。GPU(多数の演算を並列に進めるプロセッサ)は画像処理やAIの行列計算などを担います。どちらも、計算するデータをメモリから読み込む必要があります。
独立GPUでは、CPU側とGPU側のメモリが分かれる
一般的な独立GPU搭載PCには、CPU側のシステムメモリと、GPU側のVRAM(GPU専用のメモリ)があります。CPU側で用意したデータをGPU側のメモリに置いて処理する場合、その間でコピーが必要です。両者はPCIe(PC内部の機器を接続する規格)などで接続されます。
物理メモリを共有する構成では、CPUとGPUが共通のDRAM(実行中のデータを置く大容量メモリ)へアクセスします。対応するソフトウェアでは、CPUが用意したデータと同じ領域をGPUも利用できます。
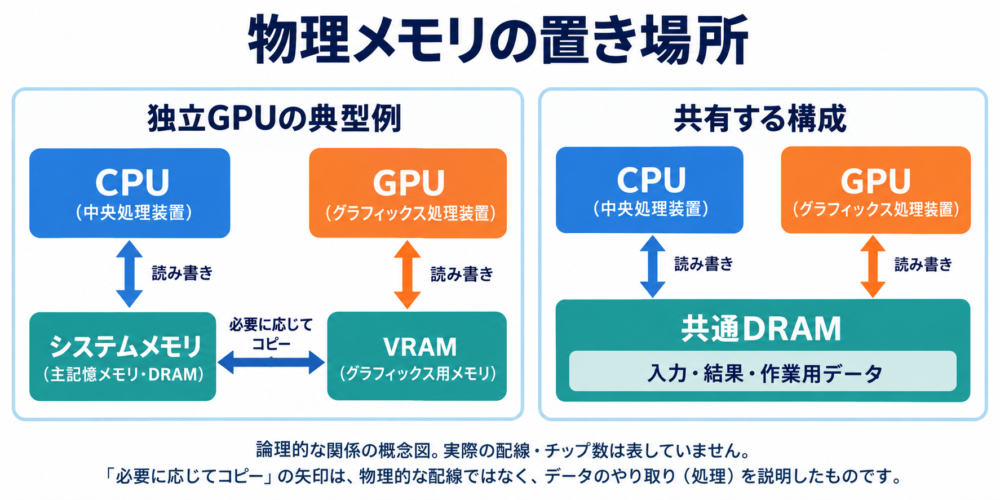
図中のDRAMの箱は論理的な領域です。一つの箱で描いていても、実際には複数のメモリチップや通信経路から構成される場合があります。また、物理的に共有されていても、どのプロセッサがどの領域を使えるかはOSや実行環境が管理します。
共有することと、速さは別々に見る
| 比較軸 | 独立GPUの典型的な構成 | 物理メモリを共有する構成 |
|---|---|---|
| データの置き場所 | CPU側とGPU側に分かれる | 共通の物理メモリを利用する |
| CPUからGPUへ処理を渡す際 | GPU側へのコピーが必要になる場合がある | 同じ領域を扱えれば、そのコピーを減らせる |
| 容量の考え方 | システムメモリとVRAMの各制約を確認する | OS・CPU処理・GPU処理の合計を考える |
| 転送の制約 | CPU–GPU間の接続とGPU側メモリの帯域を分けて考える | 共有メモリへの帯域と同時アクセスの競合を考える |
| 向きやすい処理の例 | GPU内にデータを保持して繰り返し計算する | CPUとGPUが同じデータを受け渡して処理する |
独立GPUでもデータを最初に転送し、GPU側に保持したまま多数の計算を行えば、転送の割合を小さくできます。一方、共有構成でもメモリを読む速度やGPUの演算能力が不足すれば、処理は速くなりません。共有という一つの特徴だけで製品の優劣は決まりません。
画像を処理する例:減らせるコピーと残る転送
CPUで画像を読み込み、GPUで明るさを調整し、その結果をCPUで確認する処理を考えます。画像はメモリ上で画素の数値の配列として保持されます。
独立したメモリを使う例では、CPU側に入力を用意し、GPU側へコピーしてから計算します。計算結果をCPU側のメモリに必要とする場合は、結果も戻します。
共有構成では、CPUが書いた入力領域をGPUが読み、共通DRAM内の出力領域へ結果を書き、その結果をCPUが読みます。ここで省けるのは、主に「別の物理メモリへ同じデータを受け渡すコピー」です。
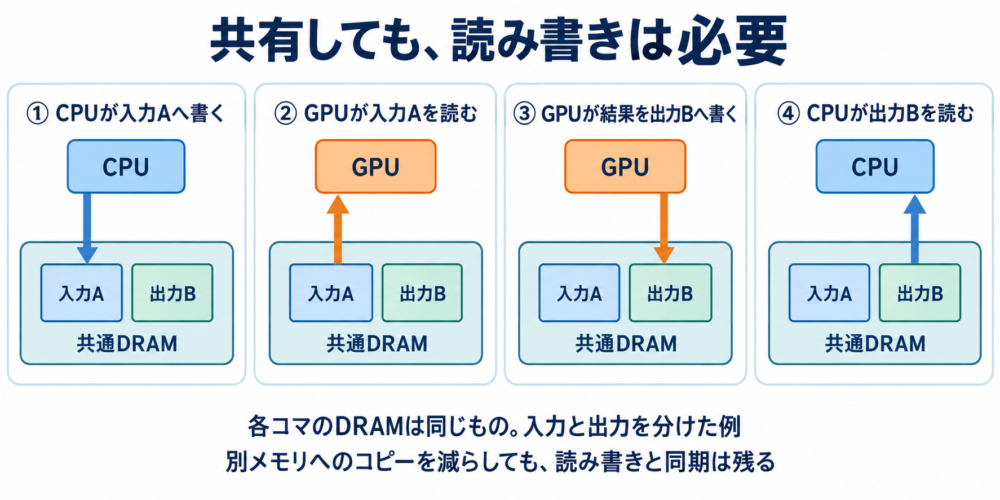
入力Aと出力Bを分けたのは、元画像を保ったまま結果を作る例だからです。共有メモリになっても、入力・出力・中間結果がすべて一つの領域で済むわけではありません。アルゴリズムによっては元データを上書きできますが、可能な条件は処理ごとに違います。
さらに、アプリが要求する画像形式へ変換する場合や、別のライブラリへデータを渡す場合には、共有構成でも新しい領域へのコピーが発生することがあります。ハードウェアが共有できることと、アプリがその共有を利用していることは分けて確認します。
「ゼロコピー」は、ゼロ転送という意味ではない
ゼロコピーは、文脈によって「明示的な複製を省く」「別メモリへのコピーを省く」といった意味で使われます。演算器はデータを読む必要があるため、DRAMからGPU内部への転送まで消えるわけではありません。
また、独立GPUがCPU側のメモリを直接読む方式でも、コピーを省けることがあります。その場合はCPU–GPU間の接続を通ってデータを読みます。コピーをなくす代わりに、アクセスのたびの通信が負担になることもあります。
出典:CUDAのUnified and System Memory、NVIDIAのメモリアクセス方式比較
仮想アドレスが同じでも、置き場所が同じとは限らない
プログラムは通常、メモリチップ上の直接の位置ではなく、仮想アドレス(プログラムから見えるメモリの住所)を使います。OSやハードウェアは、仮想アドレスと物理メモリの対応を管理します。
この「住所」と「実際の置き場所」を分けると、CUDAの説明が読みやすくなります。
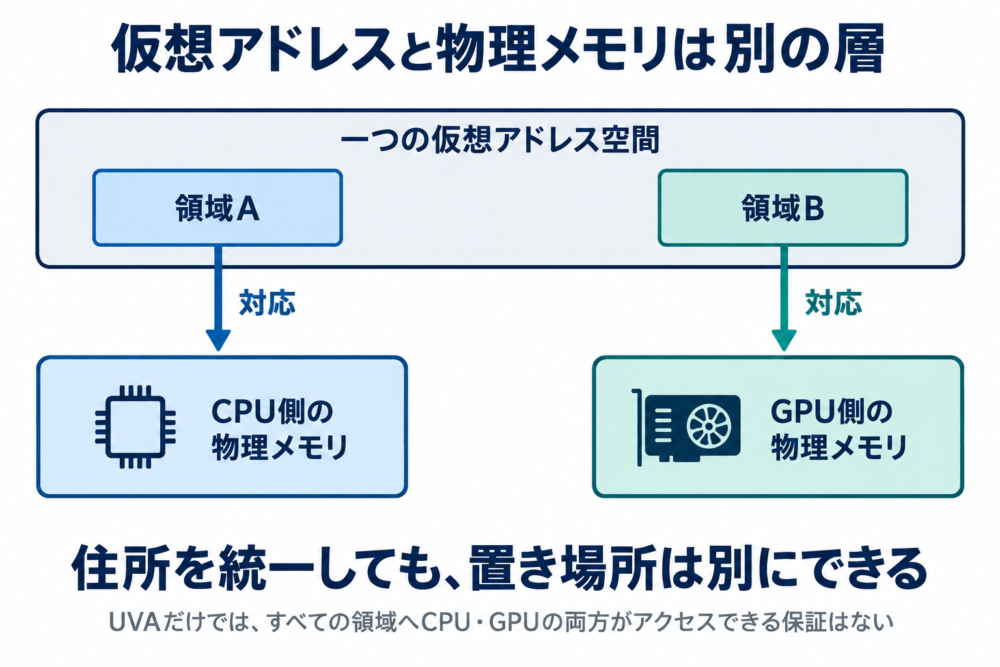
CUDAのUVA(Unified Virtual Addressing:統一された仮想アドレス空間)では、CPU側やGPU側のメモリ領域を一つのアドレス空間の中で扱います。しかし、アドレス空間が統一されても、物理メモリの配置まで一つになるとは限りません。
UVAだけで任意の領域をCPUとGPUの両方から読み書きできると考えるのも早計です。実際にアクセスできるかは、その領域の確保方法や対応機能に依存します。「住所を統一して識別できる」と「両者が利用できるように管理される」は、異なる機能です。
出典:CUDA:Unified Virtual Address Space
CUDA Unified Memoryでは、配置や移動を管理する
CUDA Unified Memoryは、CPUとGPUから利用できるメモリを提供するための仕組みです。代表的な方法として、cudaMallocManagedというAPI(ソフトウェアから機能を呼び出す窓口)でmanaged memoryを確保します。環境によっては、通常のメモリ確保で得た領域も対象になります。
必要なデータをページ単位で移す例
ページは、メモリを管理するために区切った一定サイズの領域です。ページ移動に対応する構成では、CPU側にあるデータをGPUが必要としたとき、ドライバがGPU側へ移して使えるようにする場合があります。
- CPUがデータを書き、CPU側のメモリにページが置かれる。
- GPUがそのデータへアクセスする。
- GPU側で利用できるようにページを移し、アドレスの対応を更新する。
- GPUがデータを使って計算する。
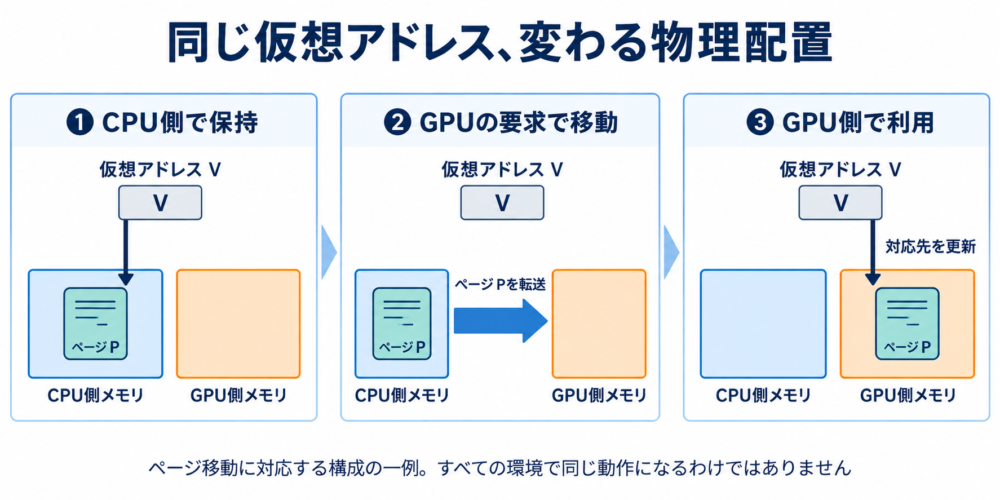
図は自動移動が起きる一例です。プログラムに明示的なコピー処理が見えなくても、内部ではデータ移動が発生しています。移動先で繰り返し使えば利点がありますが、CPUとGPUが交互に書き換えて移動を繰り返すと、待ち時間が増える場合があります。
プリフェッチ(必要になる前にデータを移すこと)で待ち時間を計算と重ねられる場合もあります。ただし、転送量そのものが必ず減るわけではなく、先に移したデータを使わなければ余分な転送になります。
出典:NVIDIA:Unified Memoryの移動と性能
すべての環境が同じように移動するわけではない
CUDA Unified Memoryの実装は、GPU、OS、ドライバ、CPUとGPUの接続方式によって異なります。ページを移す構成に加え、離れたメモリを直接参照する構成や、ハードウェアが整合性を助ける構成もあります。
| 仕組みの例 | データの扱い | 考慮する負担 |
|---|---|---|
| 明示的なコピー | アプリが別領域へのコピーを指示 | コピーの管理と転送時間 |
| ページ移動 | 管理機構が配置を変える | 移動の発生時の待ち、往復するデータ |
| 遠隔メモリへの直接アクセス | 置き場所を保ったまま接続越しに読む | アクセスごとの遅延や接続帯域 |
| 同じ物理メモリを利用 | CPUとGPUが共通領域へアクセス | メモリ帯域、競合、同期 |
これらは排他的な製品分類ではなく、同じシステムでも領域やアクセス方法によって組み合わされます。
開発時には、たとえばconcurrentManagedAccess(managed memoryへの並行アクセスを支える対応属性)などを実機で調べます。WindowsやWSLを含む制限付きの構成では、同時アクセスや容量超過の扱いに制約があります。製品仕様に「ユニファイドメモリ」と書かれているだけで、特定のCUDA機能まで使えるとは判断できません。
出典:CUDA Unified Memoryの対応レベルと制約
共有メモリでも、なぜ同期が必要なのか
CPUが画像データの前半を書き換えている間に、GPUがその画像を読み始めたらどうなるでしょうか。GPUが新しい前半と古い後半を読むなど、意図した一つの入力として扱えない可能性があります。
同期(処理の順序や完了をそろえる仕組み)は、このような競合を防ぎます。入力を書き終えてGPUへ渡し、GPUが結果を書き終えてからCPUが読む、という順序を成立させます。
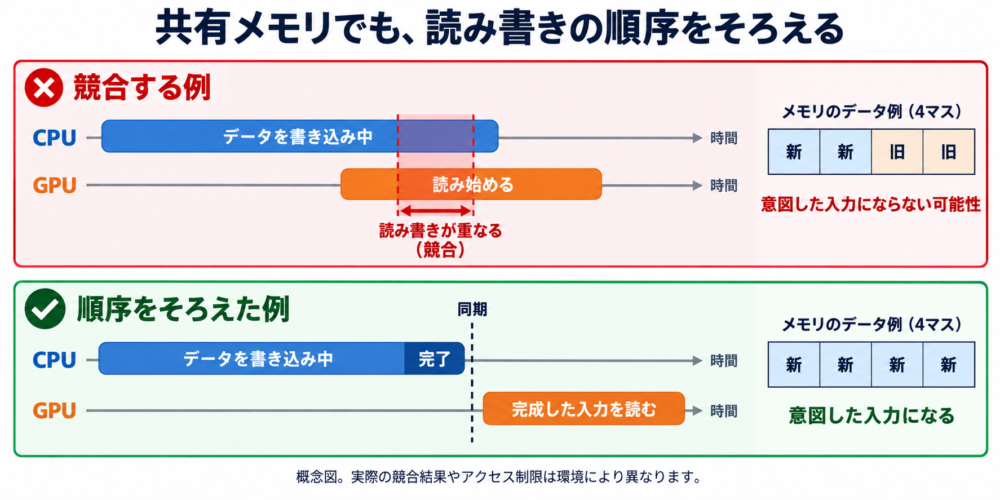
図の失敗例は、意図したデータが得られない理由を示したものです。実際の結果は実装に依存し、CUDAの対応レベルによってはアクセス自体が許可されず、エラーになる場合もあります。
コヒーレンシと同期を区別する
CPUやGPUは、データの一部をキャッシュ(よく使うデータを近くに保持する領域)に置きます。コヒーレンシは、同じメモリ位置への書き込みについて、複数のキャッシュなどの見え方を整合させる性質です。
この仕組みがあっても、「画像全体を書き終えた」「次の処理を始めてよい」というアプリの都合までは自動的に判断されません。複数の要素からなる更新の完了を保証するために、適切なAPIで実行順序と読み書きの可視性を管理します。
| 確認すること | 主に扱う問題 |
|---|---|
| コヒーレンシ | 同じ位置のデータについて整合した状態を扱えるか |
| 同期 | 必要な処理の完了を待ち、意図した順序で読み書きできるか |
複数のバッファを使えば、待ち時間と引き換えに容量を使う
バッファは、一時的なデータを置く領域です。同じバッファをCPUとGPUが交互に使うだけでは、一方が待つ時間が増えます。
そこで、GPUがフレームAを処理している間にCPUが別のバッファへフレームBを準備する、といった方法があります。処理を重ねられる一方、複数フレーム分の領域が必要になります。また、GPUが使い終えた領域だけをCPUが再利用する管理も欠かせません。
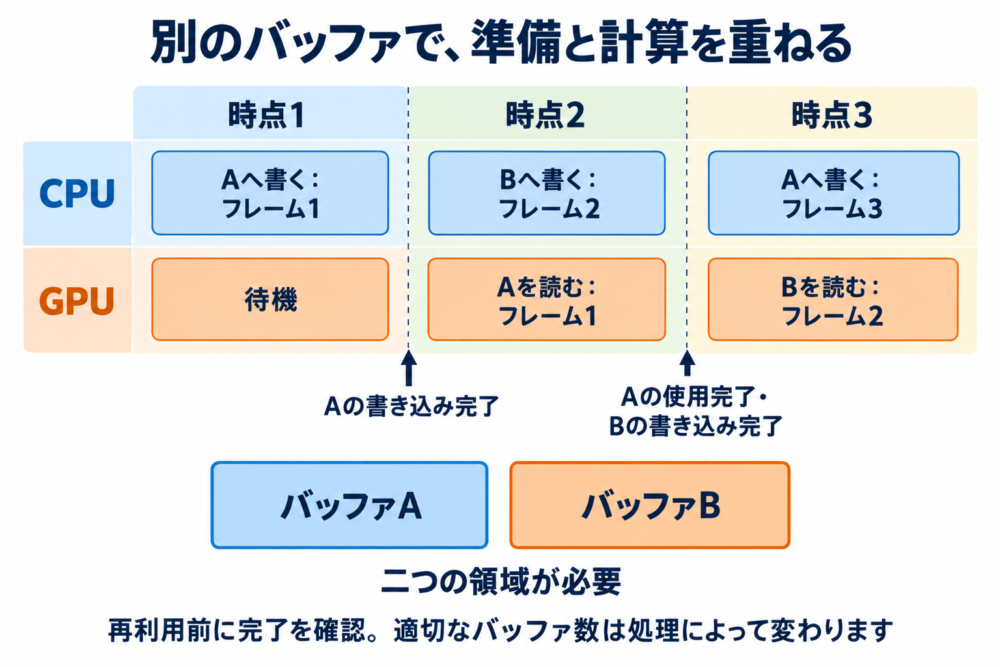
図は二つのバッファで役割を分ける例です。適切なバッファ数は処理の流れによって変わります。Appleの資料では、動的なデータをCPUとGPUが競合せず利用する方法として、三つのバッファと同期が説明されています。
GPU内部のShared Memoryは、誰と共有するのか
GPUのShared Memoryは、CPUとGPUが共通に使う大容量DRAMとは別の領域です。基本的には、GPU上で同じスレッドブロック(協力して処理する実行単位の集まり)に属するスレッド間で利用します。
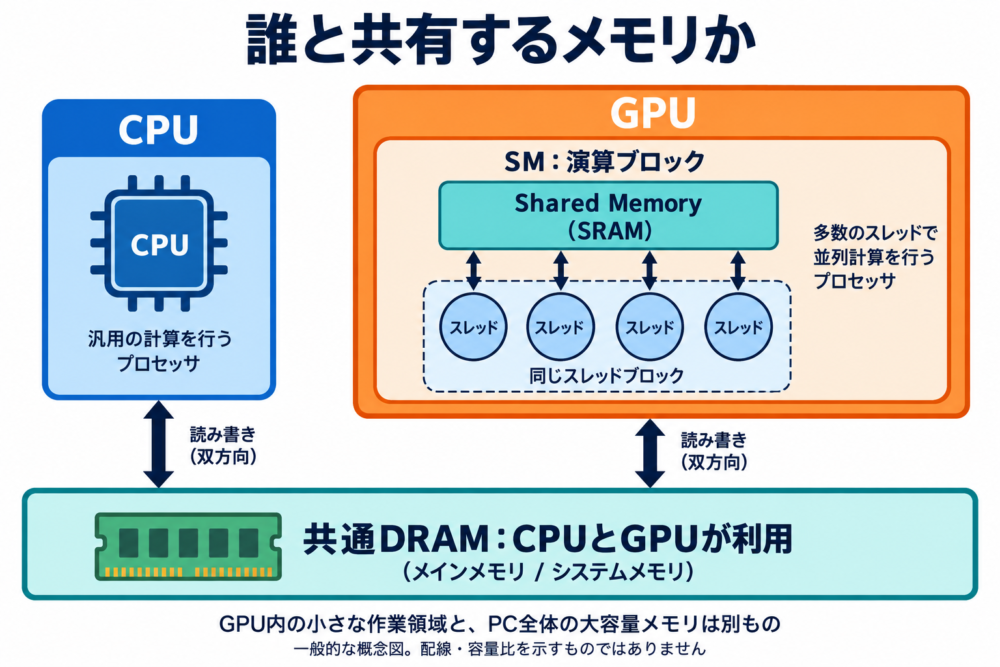
図では、GPUの中のSM(Streaming Multiprocessor:演算ブロック)を一つ取り出しています。SM内の小容量の作業領域へ必要なデータを置けば、複数のスレッドが再利用できます。
このような領域には、チップ内で高速にアクセスするためのSRAM(小容量の高速メモリに使う記憶回路)が使われます。大容量を確保するDRAMとは、役割と回路の作りが異なります。
したがって、PCの「64GBユニファイドメモリ」とGPUコードの「Shared Memory」は、容量を足し合わせたり、同じ作業領域の別名として扱ったりできません。また、Shared Memory上でスレッドが協力する際にも、データの準備完了をそろえる同期が必要になる場合があります。
出典:CUDA Programming Model:SMとスレッドブロック
容量はOSやアプリも含めて考える
64GBのユニファイドメモリを搭載していても、64GBすべてをAIモデル専用に使えるわけではありません。OSやほかのアプリに加え、AI処理自体も重み以外の領域を使います。
以下は、すべて同じ十進表記のGBでそろえた説明用の仮定です。実際のOS使用量や特定モデルの推奨容量を示す値ではありません。
| 用途 | 仮定した使用量 |
|---|---|
| モデルの重み | 30GB |
| KVキャッシュ | 8GB |
| 計算の作業領域 | 6GB |
| OS・ほかのアプリなど | 8GB |
| 合計 | 52GB |
| 64GBから引いた残り | 12GB |
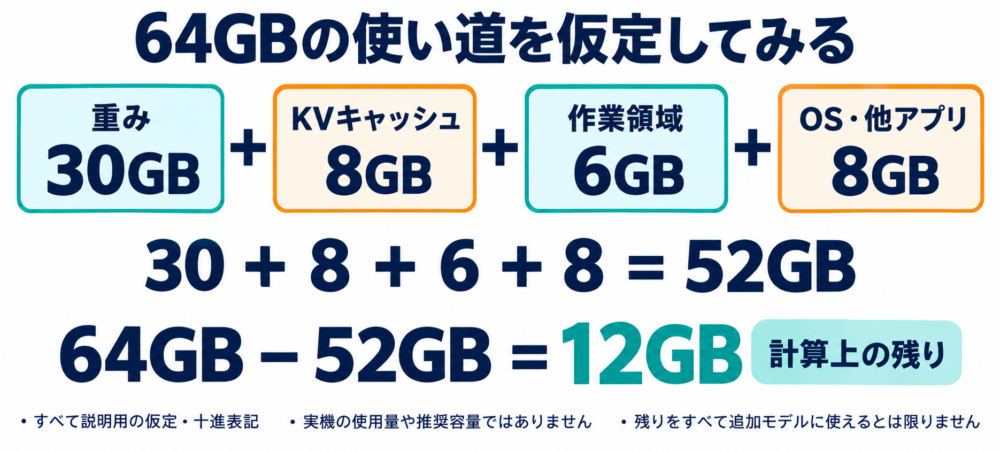
この12GBを、そのまま追加モデルに使えると保証する計算ではありません。実行中の一時的な領域、利用できる上限、メモリの確保方法などによって余裕は変わります。
KVキャッシュは、LLM(大規模言語モデル)が過去の入力に関する計算結果を保存する領域です。長い文書を扱ったり同時処理を増やしたりすると、重みが同じでも必要容量が増えます。仕組みはKV Cacheとは?LLMの生成を高速化する仕組みで解説しています。
重みの容量を抑える量子化(数値を少ないビット数で表す処理)については、LLMの量子化とメモリ・速度・精度の関係も参考になります。
大きな容量を扱えることと、速く処理できることは別
容量が十分でも、データを供給するメモリ帯域(単位時間に読み書きできるデータ量)が足りなければ、演算器が待ちます。CPUとGPUが同時に大量のデータを読む場合は、共有する経路の競合も問題になります。
対応するCUDA環境では、GPUの物理メモリ容量を超えるmanaged memoryを扱う仕組みもあります。しかし、必要なデータを頻繁に入れ替える状態になると、移動が処理時間の大きな部分を占めます。これは物理共有メモリの容量が増えることとは異なる方法です。
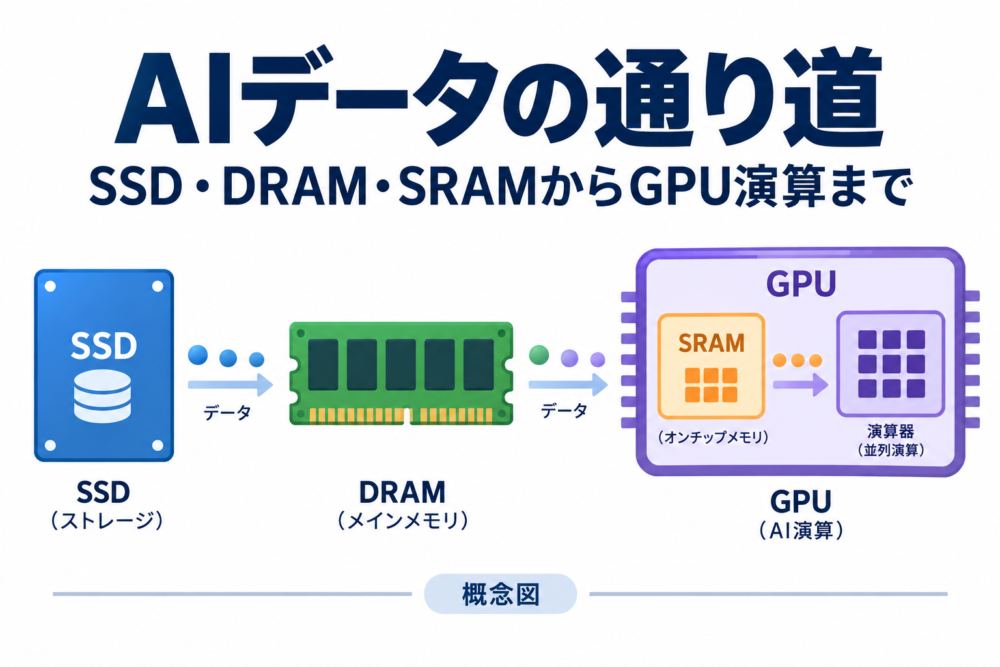
SSDへのスワップ(メモリの内容をストレージへ退避する仕組み)も、DRAMと同じ速度の容量を追加するものではありません。CPU・GPU・DRAM・SSDのどの経路で待っているのかを分けて考える必要があります。
RTX SparkやMacを見るときの確認ポイント
Apple siliconではCPUとGPUが同じメモリを使う構成が説明されており、RTX Sparkもユニファイドメモリを採用しています。ただし、共有という共通点だけで、接続方式、実効帯域、OS、利用できるGPU計算環境まで同じと考えることはできません。
RTX Sparkは製品仕様として最大128GBのLPDDR5X(低消費電力向けDRAM規格)を掲げています。どの程度をGPU処理に利用できるか、必要なCUDA機能が使えるかは、対象機種とソフトウェアの条件を確認します。本記事ではRTX Spark固有のCUDA属性を実測していません。
出典:Apple siliconのシステム構成、RTX Spark公式仕様
| やりたいこと | 共有メモリが役立つ条件 | 確認したい点 |
|---|---|---|
| CPUとGPUを使う画像処理 | 同じ入力や結果を渡せる | 余分な形式変換・コピー、同期、複数バッファの容量 |
| ローカルLLM | 重みと作業領域を無理なく保持できる | モデル形式、文脈長、実際の利用上限、メモリ帯域 |
| GPU中心の長い計算 | データを保持し繰り返し使える | 共有の有無だけでなく演算性能と供給速度 |
| CUDAプログラムの開発 | 必要なメモリ機能が対象環境で使える | OS・GPU・ドライバ、device属性、実際のページ移動 |
一般のアプリ利用者は、搭載容量だけでなく、使いたいアプリの対応条件と実行時の使用量を見ます。開発者はそこからさらに、誰がどのデータを使うか、いつ完了するか、どのコピーや移動が発生するかを追います。
ユニファイドメモリの利点を判断するときは、「共有」という名前を、置き場所・アクセス方法・処理順序に分けて読み解くと、容量や速度の数字を用途に結び付けやすくなります。
コメント