PyTorchで「Expected all tensors to be on the same device」と表示されたら、エラーが出た演算に参加するテンソルの .device を確認し、意図した配置へそろえます。モデルをGPUへ移していても、入力・教師ラベル・処理途中で作ったテンソルがCPUに残っていると、演算を続けられないことがあります。
特に見落としやすいのは、x.to(device) の戻り値を受け取っていないケースです。テンソルを移動するときは x = x.to(device) と書きます。
この記事は、単一のNVIDIA GPUで通常の学習・推論を行うケースを中心に説明します。PyTorchのdevice(テンソルの配置先)とdtype(数値の型)を分けて考え、エラーが出る場所から確認できるようにします。モデルを複数GPUへ自動配置する仕組みには、最後に示す別の注意点があります。
エラーが出た行から、調べるテンソルを絞る
エラー末尾だけでなく、トレースバック(呼び出し履歴)で自分のコードのどの演算が失敗したかを見ます。次の表の対象について .device を比較してください。
| 止まった場所 | 配置を調べる対象 | よくある修正 |
|---|---|---|
model(x) |
モデルの重み、入力 x、モデル内で使う定数 |
モデルと入力の移動漏れを直す |
criterion(logits, y) |
予測値、教師ラベル、損失関数が保持する重み | y = y.to(device)、必要なら損失関数も移す |
| 加算、結合、マスク処理 | 演算の全入力と、その直前に作ったテンソル | 作成時に device を指定する |
| 保存データを読み込んだ直後 | 読み込んだ状態、モデル、入力 | 復元先と実行時の配置を分けて確認する |
optimizer.step() |
パラメータ、勾配、optimizerの内部状態 | 復元手順と対象optimizerの状態を確認する |
torch.cuda.is_available() が False の場合は、先にPyTorchでtorch.cuda.is_available()がFalseになる原因と確認手順を確認してください。GPU認識の問題と、認識済みGPUへデータを配置する問題では調べる場所が異なります。
CPUとGPUに分かれていると、なぜ演算できないのか
テンソルは、数値を多次元の配列として保持するPyTorchのデータ構造です。形状や数値の型に加えて、「CPU側にあるか」「どのGPU側にあるか」という配置情報を持ちます。
たとえば、cpu にあるベクトルと cuda:0 にあるベクトルを足そうとすると、通常の加算は配置の不一致で失敗します。CUDA(NVIDIA GPUで計算するための基盤)を使える状態でも、CPU上のテンソルが自動でGPUへ移るとは限りません。GPU間の通常演算にも配置上の制約があります。PyTorch公式:CUDA semantics
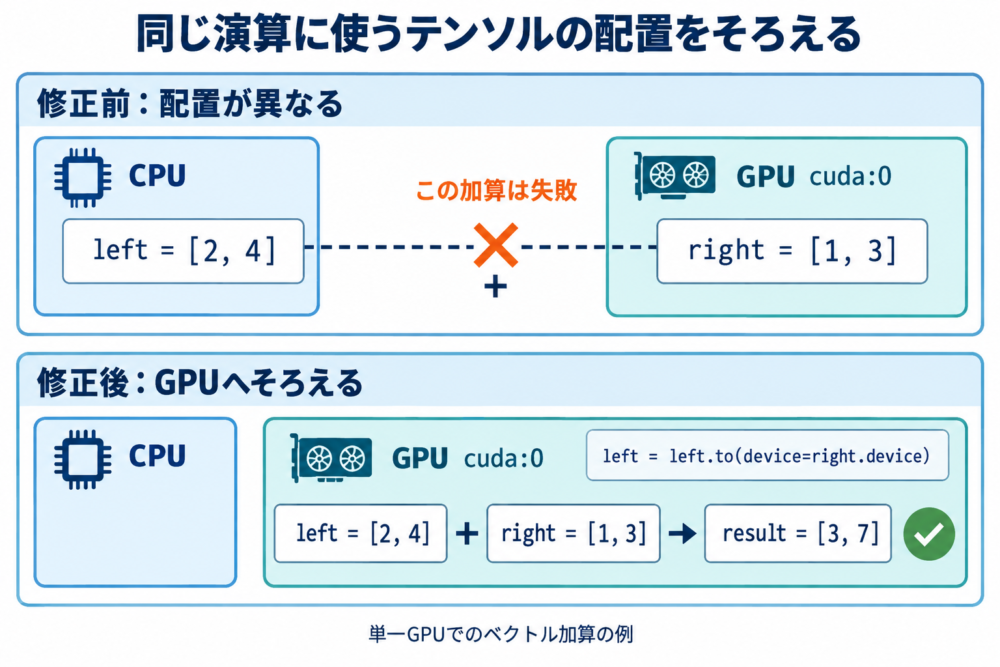
図1:同じGPU上でベクトル加算する例。PyTorchのCUDA仕様を基に作成した概念図です。
小さな失敗例と修正
以下はCUDAが使える環境を前提とした再現用コードです。意図的に配置を分けています。
import torch

if not torch.cuda.is_available():
    raise RuntimeError("この再現例にはCUDA対応の実行環境が必要です")

device: torch.device = torch.device("cuda:0")
left: torch.Tensor = torch.tensor([2.0, 4.0], device="cpu")
right: torch.Tensor = torch.tensor([1.0, 3.0], device=device)

print(left.device, right.device)
result: torch.Tensor = left + right
最後の加算が配置の不一致で失敗する例です。PyTorchのバージョンや失敗した演算によって、エラー全文やデバイス名の表示順は変わります。「Expected all tensors…」という文字列との完全一致だけで判断せず、cpu、cuda:0 などの表示を確認します。
この例ではGPU側で計算したいので、加算の行を次のコードへ置き換えます。
# rightと同じ場所で加算するため、移動結果をleftへ代入する。
left = left.to(device=right.device)
result: torch.Tensor = left + right
print(result.device)
修正後は両方が cuda:0 に配置され、そのGPU上で加算できる条件が整います。一般には、どちらを移すかはモデルの実行場所に合わせて決めます。大きなモデルやデータを何度も往復させる修正は、不要な転送を増やします。
掲載コードの確認範囲: Pythonの構文と公式API仕様を確認しています。執筆環境にはPyTorchが導入されていないため、この記事のCUDAコードは実機実行済みの結果として掲載していません。エラーの再現と修正の成否は、利用中の環境で確認してください。
.to(device) を書いたのに直らない理由
Tensor.to() は、指定した配置・型のテンソルを返します。CPUからGPUへ変える場合は、GPU上のコピーが戻り値になります。戻り値を受け取らずに呼ぶだけでは、元の変数 x が指すテンソルは変わりません。 同じ配置・型を指定した場合は、自身が返されることもあります。PyTorch公式:Tensor.to
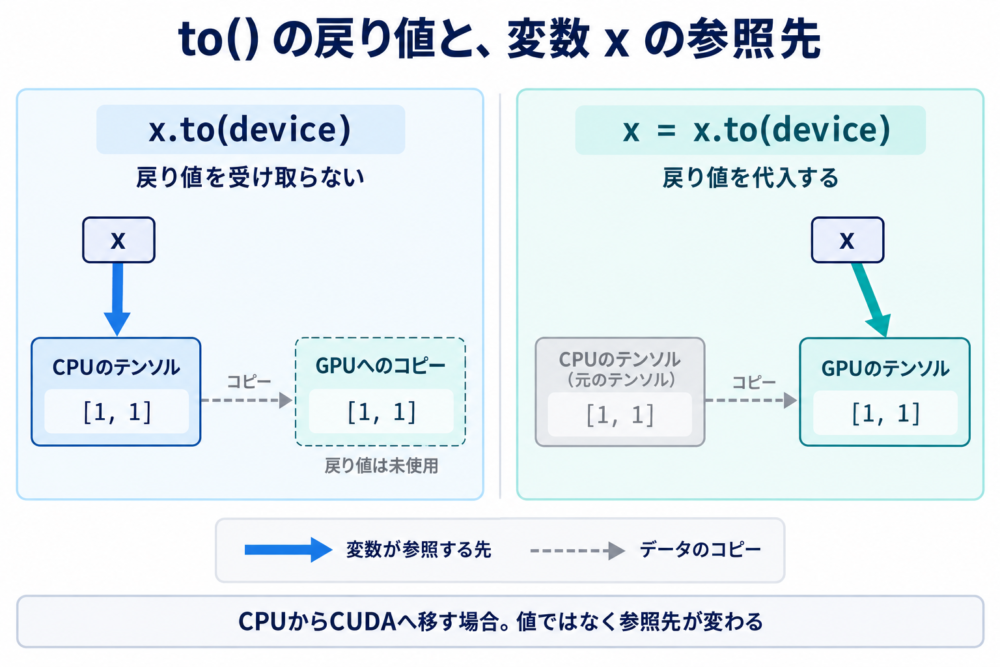
図2:CPUからGPUへコピーしても、戻り値を代入しなければ変数の参照先は変わりません。灰色の元テンソルは説明用で、常に残り続けることを意味しません。
import torch

device: torch.device = torch.device("cuda:0")
x: torch.Tensor = torch.ones(2, device="cpu")

# 戻り値を捨てると、xはCPU側のテンソルを参照したままになる。
x.to(device)
print(x.device)

# 後続の処理でGPU側のテンソルを使うため、変数を更新する。
x = x.to(device)
print(x.device)一方、model.to(device) は nn.Module(層やモデルを表す仕組み)のメソッドで、登録されたパラメータやバッファを移動してモデル自体を更新します。名前が同じ .to() でも、対象による違いがあります。
| 対象 | .to(device) の扱い |
書き方の目安 |
|---|---|---|
テンソル x |
移動結果を戻り値として受け取る | x = x.to(device) |
モデル model |
登録されたパラメータ・バッファを更新し、自身を返す | model = model.to(device) として統一してもよい |
| 辞書やリスト | コンテナ全体にTensorの .to() は使えない |
中のテンソルを取り出して移す |
モデルの移動対象は、Python変数すべてではなく、PyTorchがモデルの一部として登録しているものです。この範囲が、後述する「モデル内の定数だけCPUに残る」原因につながります。PyTorch公式:Module
モデル・入力・教師ラベルを確認する
モデル全体の配置を調べたいとき、最初のパラメータだけを見ても、ほかの層がCPUに残っている可能性があります。エラー調査では、登録済みのパラメータ(学習対象の重みなど)とバッファ(学習対象ではないがモデルが保持する状態)を名前付きで列挙すると、移動漏れを見つけやすくなります。
次の断片は、手元の model、入力 x、教師ラベル y を定義した後に挿入します。
for name, parameter in model.named_parameters():
    print("parameter", name, parameter.device, parameter.dtype)

for name, buffer in model.named_buffers():
    print("buffer", name, buffer.device, buffer.dtype)

print("input", x.device, x.dtype, tuple(x.shape))
print("target", y.device, y.dtype, tuple(y.shape))
named_buffers() に出るのは登録したバッファです。通常の属性として保存したテンソルまで漏れなく表示する診断にはならないため、自作モデルでは forward() 内の変数も確認します。
分類モデルで1ステップを実行する最小構成
次は、入力・モデル・教師ラベルの配置をそろえた独立実行用の例です。実データの読み込みを省き、配置の確認に必要な処理だけに絞っています。
import torch
from torch import nn

device: torch.device = torch.device(
    "cuda:0" if torch.cuda.is_available() else "cpu"
)
model: nn.Module = nn.Linear(4, 3).to(device)

# 移動後のモデルのパラメータをoptimizerへ渡す。
optimizer: torch.optim.Optimizer = torch.optim.SGD(
    model.parameters(), lr=0.01
)
criterion: nn.Module = nn.CrossEntropyLoss()

x: torch.Tensor = torch.randn(5, 4, device="cpu")
y: torch.Tensor = torch.tensor([0, 2, 1, 0, 2], dtype=torch.long)
x = x.to(device)
y = y.to(device)

optimizer.zero_grad(set_to_none=True)
logits: torch.Tensor = model(x)
loss: torch.Tensor = criterion(logits, y)
loss.backward()
optimizer.step()

print("device:", logits.device, "loss:", loss.item())
CUDAが使えないときはCPUで動かす構成です。CPUで最後まで進んでも、GPU側の配置を検証したことにはならないため、出力された device を確認してください。
実際の学習でDataLoader(データを読み込み、バッチ単位にまとめる仕組み)を使う場合は、受け取ったバッチごとに入力と教師ラベルを移します。最初のバッチだけ移しても、以後に読み込むデータには反映されません。
配置をそろえても、dtypeは用途に合わせる
上のコードでは、予測値は浮動小数点、教師ラベルはクラス番号を表す整数です。CrossEntropyLoss にクラス番号形式で渡す教師ラベルは torch.long にします。確率分布を教師として渡す場合は条件が異なります。PyTorch公式:CrossEntropyLoss
y.to(logits) は配置だけでなく型も logits に合わせるため、このクラス番号形式には適しません。配置だけ合わせたい場合は y = y.to(device=logits.device) と指定します。
また、クラスごとの重みを指定した nn.CrossEntropyLoss(weight=class_weights) など、損失関数自身がテンソルを保持する場合は、その配置も確認します。モデルを移しただけでは、別に作った損失関数まで自動で移動するわけではありません。
処理途中で作るテンソルがCPUに戻っていないか
入力をGPUに置いていても、forward() 内で torch.zeros(...) や torch.arange(...) を新しく呼ぶと、作成先の指定によってはCPU上に生成されます。通常の初期設定ではCPUになるため、処理途中で加えるマスクや添字も確認します。
既存のテンソル x を基準に作れば、デバイス番号を各所へ書き込まずに済みます。
| 作りたいもの | 書き方 | 引き継ぐもの・注意点 |
|---|---|---|
x と同じ形のゼロ配列 |
torch.zeros_like(x) |
形状・配置・型をそろえる |
| 別の形のゼロ配列 | x.new_zeros((2, 3)) |
配置・型を引き継ぎ、形状は別指定 |
| 整数の添字 | torch.arange(x.shape[1], device=x.device) |
配置を指定。整数引数なら通常は整数型 |
| 真偽値のマスク | torch.ones_like(x, dtype=torch.bool) |
配置・形状を使い、型は真偽値へ変更 |
zeros_like と new_zeros の引き継ぎ範囲は、それぞれの公式仕様で確認できます。PyTorch公式:zeros_like、PyTorch公式:Tensor.new_zeros
添字の型と配置の指定はPyTorch公式:arangeも参照してください。
基準にするテンソルにも注意が必要です。CPU上の x から作れば、新しいテンソルもCPUになります。「どの演算に渡すか」を基準に、作成元や device を決めます。
モデル内の定数が移動しないときは、登録方法を確認する
自作モデルで self.offset = torch.tensor(...) と書いても、通常のテンソル属性はバッファとして登録されません。model.to(device) の対象に含めたい学習不要の状態は、register_buffer() で登録します。
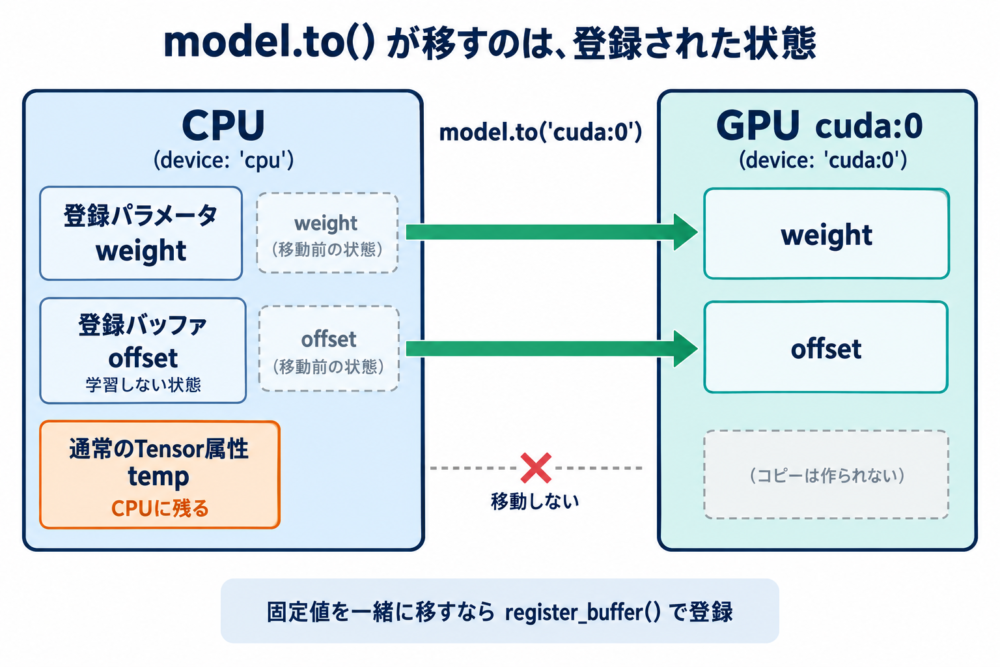
図3:CPU上のモデルをGPUへ移す例。矢印の左は移動前、右は移動後を表します。通常のTensor属性は登録した状態と区別します。
たとえば、入力から差し引く固定の基準値を保持する小さなモデルは、次のように書けます。
import torch
from torch import nn


class CenterInput(nn.Module):
    """固定の基準値を差し引く層。"""

    offset: torch.Tensor

    def __init__(self) -> None:
        """初期化する。

        Args: なし。
        Returns: なし。
        Raises: テンソル確保に失敗した場合のRuntimeError。
        Example: layer = CenterInput()
        """
        super().__init__()
        # 学習対象にせず、モデルの移動と保存に追従させる。
        self.register_buffer(
            "offset", torch.tensor([0.25, 0.50, 0.75, 1.00])
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """入力から基準値を引く。

        Args: xは末尾の次元が4の浮動小数点テンソル。
        Returns: xと同じ形のテンソル。
        Raises: 配置や形状が演算条件を満たさない場合のRuntimeError。
        Example: CenterInput()(torch.ones(2, 4))
        """
        return x - self.offset


device: torch.device = torch.device(
    "cuda:0" if torch.cuda.is_available() else "cpu"
)
layer: CenterInput = CenterInput().to(device)
x: torch.Tensor = torch.ones(2, 4, device=device)
print(layer.offset.device, layer(x).device)
登録バッファは既定で state_dict(保存・復元に使う名前付きの状態)にも含まれます。保存不要なら persistent=False にできますが、その場合もバッファとしてのデバイス移動は対象です。PyTorch公式:Module.register_buffer
複数の層をPythonのリストに入れている場合
self.layers = [nn.Linear(...), ...] のような通常のリストでは、中の層が子モジュールとして登録されません。モデルの一部として列挙・移動したいときは nn.ModuleList を使います。順番に適用するだけなら nn.Sequential も候補になります。PyTorch公式:ModuleList
| 保持するもの | 用いる仕組み | 判断する点 |
|---|---|---|
| 学習で更新する独自の重み | nn.Parameter |
optimizerへ渡す学習対象にする |
| 学習不要でモデルと一緒に動かす状態 | register_buffer() |
保存の要否も指定できる |
| 複数の層 | nn.ModuleList |
呼び出す順序や分岐は自分で実装する |
| 層を順番に適用するまとまり | nn.Sequential |
単純な直列構成に向く |
同じ値を毎回 .to() する修正より、モデルの状態として正しく登録する方が、移動漏れを防ぎやすくなります。
保存データを読み込んだ後に発生する場合
torch.load(..., map_location=...) は、保存されていたテンソルの読み込み先を指定します。モデルの実行場所、入力の配置、optimizer(重みを更新する処理)の状態は、それぞれ確認が必要です。
次は、自分で保存した nn.Linear(4, 3) の state_dict を linear-weights.pt から読み込む例です。保存ファイルは、この構造に対応する信頼できるものを用意してください。
import torch
from torch import nn

device: torch.device = torch.device(
    "cuda:0" if torch.cuda.is_available() else "cpu"
)
model: nn.Module = nn.Linear(4, 3)

# 読み込み時の配置を一度CPUにそろえ、実行先は後で明示する。
state: dict[str, torch.Tensor] = torch.load(
    "linear-weights.pt", map_location="cpu", weights_only=True
)
model.load_state_dict(state)
model = model.to(device)
model.eval()

x: torch.Tensor = torch.randn(2, 4, device=device)
with torch.no_grad():
    output: torch.Tensor = model(x)
print(output.device)
この例の load_state_dict() は既定の assign=False を使っています。assign=True や特殊な読み込み方式では扱いが変わるため、その方式の仕様に従ってください。weights_only=True を指定していても、出所不明のファイルを安全とみなして読み込まないようにします。PyTorch公式:torch.load、PyTorch公式:Saving and Loading Models
学習を再開するときは、モデルの重みだけでなくoptimizerの状態も復元することがあります。optimizer.step() で失敗するなら、モデルの移動後にoptimizerを構築しているか、保存時とパラメータのグループ構成が対応しているか、復元した状態がその実装の想定どおりかを確認します。PyTorch公式:Optimizer.load_state_dict
optimizer内のテンソルを機械的にすべてGPUへ移す方法は、共通の修正として扱いません。 実装やオプションによっては、ステップ数などのスカラー状態をCPUに保持するためです。エラーの対象と、使用中のoptimizerの仕様を照合します。PyTorch公式実装:optimizer.py
配置をそろえるときの注意点と、修正後の確認
cuda:0 と cuda:1 は別のGPUです。両方がCUDAだから一致していると判断せず、デバイス番号まで確認します。Apple Siliconで mps(Metalを使うGPU実行先)を使う場合も配置の確認は必要ですが、この記事のCUDA専用再現コードはそのまま使えません。
また、「常に全テンソルが同じ場所でなければならない」と一般化しすぎないことも大切です。演算によってはCPU上の0次元スカラーを受け付けます。実際に失敗した演算と、その入力条件を調べます。PyTorch公式:Tensor Attributes
モデルを複数GPUへ分割する仕組みや、device_map="auto" などの自動配置を使っている場合は、意図して複数の配置先を利用しています。この記事の単一GPU用コードを使ってモデル全体を一つのGPUへ移すと、ライブラリが管理する配置やメモリ計画を崩す可能性があります。その場合は使用中のライブラリの入力配置・実行手順を優先してください。Hugging Face公式:Big Model Inference
単一GPUのコードを修正したら、全データを流す前に小さな1バッチで次を確認します。
- エラーが出た演算の入力と、対応するモデル状態が意図したdeviceにある。
model(x)と損失計算が通り、dtypeと形状も用途に合っている。- 学習なら
loss.backward()とoptimizer.step()まで完了する。 - 次のバッチや、保存後に復元した状態でも配置が維持される。
配置を直した後に CUDA out of memory が出た場合は、GPUへ載せたデータの容量を調べる段階です。PyTorchのCUDA out of memory対処法|GPUメモリ不足の原因を切り分けるで、配置エラーとは分けて確認できます。
参考資料
- PyTorch:CUDA semantics
- PyTorch:Tensor.to
- PyTorch:Module
- PyTorch:CrossEntropyLoss
- PyTorch:zeros_like
- PyTorch:Tensor.new_zeros
- PyTorch:ModuleList
- PyTorch:torch.load
- PyTorch:Saving and Loading Models
- PyTorch:Optimizer.load_state_dict
公式資料は2026年9月22日に確認しています。
本文図は公式仕様を基に独自構成し、AIで生成した概念図です。実行画面やベンチマーク結果を示すものではありません。
コメント