差分プライバシー(Differential Privacy)は、特定の1人分などのデータが加わっても、公開される結果の確率分布が大きく変わらないように制限する、数学的なプライバシー保証です。適切に調整したノイズ(ランダムなゆらぎ)を集計や学習に加えることが、代表的な実現方法です。ノイズを加えるだけで自動的に保証が得られるわけではなく、守る単位・ノイズ量・公開回数などの条件を合わせて設計します。
この記事では、40人と41人という架空の人数集計から仕組みを説明します。ε(イプシロン)の意味、精度との兼ね合い、AI学習に使う際の注意点まで順に見ていきます。
差分プライバシーは「1人分が結果に与える影響」を制限する
あるアンケートで「週に1回以上、自転車に乗る」と答えた人数を公開するとします。1人につき回答は1件で、データ集合Dでは該当者が40人です。そこに「はい」と回答したAさんの1件を加えたD’では、41人になります。以下の数値と人物は全て説明用の架空例です。
| データ集合 | 違い | 正確な該当人数 |
|---|---|---|
| D | Aさんの回答を含まない | 40人 |
| D’ | DにAさんの回答1件を加える | 41人 |
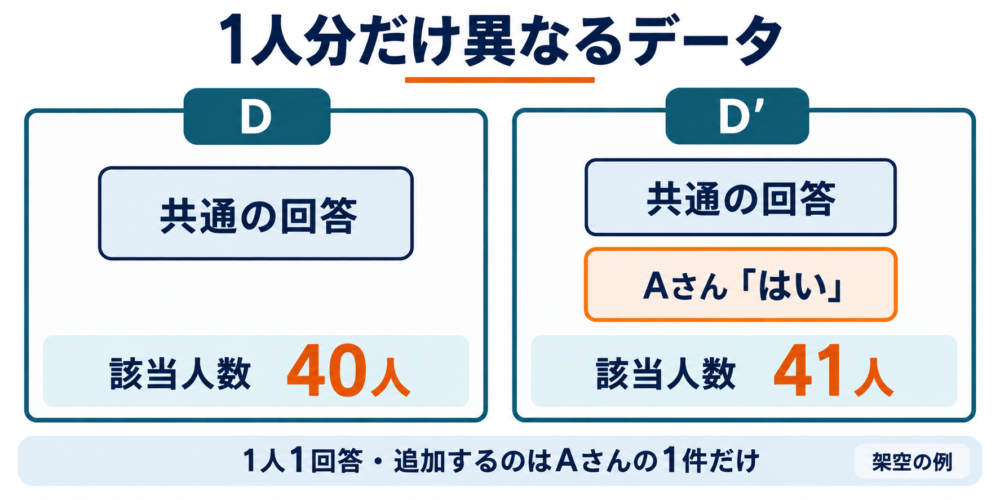
図:1人1回答の架空例。40人・41人は条件に該当する人数です。
他の回答を全て知っている相手に、正確な合計41人を渡すと、Aさんの寄与を推測する手がかりになります。氏名を集計表から消していても、出力された数字から情報が分かる場合がある、という問題です。
差分プライバシーでは、このように守りたい単位だけが異なる二つを隣接するデータ集合として比較します。本記事では「1人の回答1件の追加・削除」を隣接関係にします。置き換えを使う定義もあるため、実際の仕様では何を隣接とするかの確認が必要です。出典:東京大学 Taura Laboratory「差分プライバシー」
比べるのは、1回の数字ではなく出力の確率分布
例えば人数にランダムなノイズを加えれば、同じDを処理しても出力は毎回変わり得ます。DとD’から、どちらも似た範囲の値が出るように設計することで、出力から1人の有無を区別する手がかりを制限します。
ここでの保証は「Dなら必ず40、D’でも必ず40にする」という意味ではありません。どの範囲の結果が、どのくらいの確率で出るかを比べます。同じ結果が一度出たことや、二つの実測値が近かったことだけでは、差分プライバシーを満たした証明にはなりません。
εとノイズ量を、人数集計で計算する
保護の強さを表すパラメータがεです。まず、δ(デルタ)を使わない純粋なε-差分プライバシーの定義を見ます。処理をM、公開結果の任意の集合(例えばある数値範囲)をSとすると、全ての隣接するD・D’と全てのSについて、次を満たす必要があります。
Pr[M(D)がSに入る] ≤ exp(ε) × Pr[M(D’)がSに入る]
Prは確率、exp(ε)は自然指数関数です。DとD’を入れ替えた向きも含めて成り立つ条件なので、片方のデータだけで特定の結果が極端に出やすくなることを抑えます。εが小さいほど、この倍率の上限は1に近づきます。出典:Taura Laboratoryの定義
ε=1ならexp(1)は約2.72です。これは上の式で使う確率の倍率であり、「漏えい確率が1%」「匿名化率が何%」という数字ではありません。
感度1なら、ラプラスノイズの尺度は1÷ε
必要なノイズ量を決めるには、感度(隣接するデータ集合の間で、集計値が変わり得る最大幅)を求めます。今回の「1人1回答の該当人数」では、1人の追加・削除によって変わる人数は最大1です。したがって感度Δfは1になります。
感度は、手元のDとD’の差だけを測った値ではありません。許した全ての隣接データ集合についての最大値です。1人が何件も寄与できる集計なら、同じ前提で1とは置けなくなります。
代表的なラプラス機構では、0を中心とするラプラス分布からノイズZを引き、集計値に足します。ノイズの広がりを決める尺度bは、次のように設定します。NIST「Counting Queries」が、件数集計への適用を説明しています。
公開する値 = 正確な集計値 + Z、ZはLaplace(0, b)、b = Δf ÷ ε
| ε | exp(ε):定義の倍率上限 | 今回のb = 1÷ε | ノイズの絶対値の平均的な大きさ |
|---|---|---|---|
| 0.5 | 約1.65 | 2 | 2人分 |
| 1 | 約2.72 | 1 | 1人分 |
| 2 | 約7.39 | 0.5 | 0.5人分 |
右端は、このラプラス分布における絶対値の期待値です。誤差の最大値ではありません。 b=1でも、ノイズの大きさが1人分を超えることはあります。負の値や小数の出力も起こり得るため、人数として表示する際の丸め方などは別途決めます。
同じ感度・同じ機構なら、εを小さくすると保護条件が厳しくなり、その代わりにノイズが広がります。人数40と41にそれぞれこのノイズを加えた理論上の分布を描くと、εによる違いを確認できます。図の縦軸は確率密度で、ある範囲の確率は曲線の下の面積に対応します。これは数式から計算した図で、実データの測定ではありません。
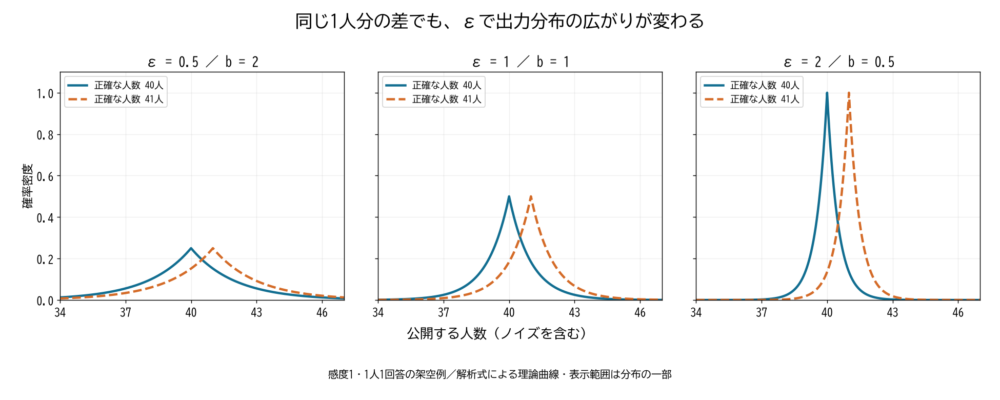
図:ラプラス分布の解析式から計算した理論曲線。実データの測定ではありません。
δがある保証は、εだけでは比べられない
AI学習などでは、(ε, δ)-差分プライバシーという形も使われます。上の不等式の右辺に+δを加えた定義で、純粋なε-DPの条件を緩めたものです。
δはその緩和を表す加法項であり、εと合わせて確認します。δをそのまま「このシステムで個人情報が漏れる確率」と読み替えるのは適切ではありません。NIST SP 800-226は、δや保護単位などが異なる保証を、εの数字だけで比較する危険を説明しています。
公開を繰り返すと、プライバシー予算も積み上がる
同じ集計に毎回独立したノイズを加え、何度も新しい値を公開すると、受け手はそれらをまとめて分析できます。一つ一つが差分プライバシーを満たしていても、組み合わせたときの保証を別に評価する必要があります。
この累積のプライバシー損失を管理するのが、プライバシー予算という考え方です。お金の予算ではなく、分析・公開を通じて許す損失の上限を扱います。
例えば、同じ対象データに対してε=0.2の純粋な差分プライバシー機構を3回使い、その結果を全て公開する場合、基本的な合成定理で全体は最大0.6として評価できます。
全体の保証:ε=0.2 + 0.2 + 0.2 = 0.6として評価できる
これは加算による上界です。常に損失が厳密に0.6になるという意味ではなく、方式や条件に応じてより精密な評価もあります。出典:NIST「Differential Privacy for Privacy-Preserving Data Analysis」
同じ公開結果の再表示は、再問い合わせと区別する
一度作った差分プライバシー付きの集計値を保存し、その同じ値だけからグラフを描いたり表示し直したりする処理では、追加のプライバシー損失は発生しません。元の機密データを追加で参照しない後処理では保証が悪化しない、という性質によります。NIST「post-processing invariance」
| 操作 | 予算を考える際の扱い |
|---|---|
| 元データから、新しいノイズ付き集計値を作って公開 | 新たな公開として累積を評価する |
| 保存した同じ公開値を、別のグラフで表示 | 元データを参照しない後処理なら追加損失なし |
| 公開値を、元データの正確な集計と照合して補正 | 元データへの追加アクセスがあり、後処理性だけでは保証できない |
ダッシュボードを更新する場合は、画面を描き直すだけなのか、機密データへ再問い合わせしているのかを分ける必要があります。
中央型と局所型では、誰を信頼するかが違う
ノイズを入れる場所によって、生データを扱う主体も変わります。中央型と局所型の違いは、単なる処理場所の違いにとどまりません。
| 方式 | データとノイズの流れ | 信頼の前提・トレードオフ |
|---|---|---|
| 中央型 | 管理者が生データを集め、集計などを保護して公開 | 管理者を信頼する必要がある一方、集計に対して効率よくノイズを設計できる |
| 局所型(ローカル型) | 各利用者側でランダム化してから管理者へ送る | 収集者に生データを渡す前に保護する一方、同じ課題では精度や必要データ数の負担が大きくなりやすい |
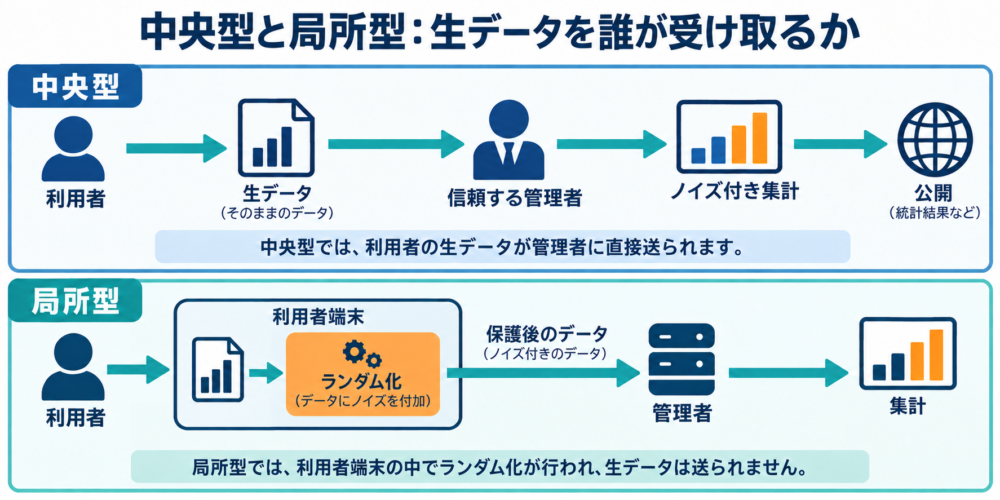
図:中央型と局所型の基本的な信頼関係を示した独自の模式図。
NIST「Threat Models for Differential Privacy」は、中央型が信頼できる管理者を前提とすることを説明しています。集計の公開結果に差分プライバシーを適用していても、その管理者が保存する生データの流出まで防げるわけではありません。
局所型でも、端末の実装や送信する識別情報まで自動的に安全になるわけではありません。「誰に、何を見せる設計か」を決めてから、精度と運用負担を比較します。
匿名化・暗号化・連合学習と、守る対象を比べる
データを守る技術は、役割を分けて組み合わせるものです。次の表は、それぞれの主な目的を整理したものです。
| 方法 | 主に扱うこと | それだけでは決まらないこと |
|---|---|---|
| 氏名削除などの匿名化処理 | データに含まれる識別の手がかりを減らす | 別情報との照合や複数公開を含めた推測への保証 |
| 暗号化 | 鍵を持たない相手から通信・保存内容を隠す | 復号された分析結果から何が推測できるか |
| 連合学習 | データを各拠点に置いたままモデルを共同学習する | 共有する更新や学習済みモデルからの情報漏えいの上限 |
| 差分プライバシー | 定義した保護単位の違いが出力分布へ及ぼす影響を制限する | 生データのアクセス制御、全ての情報流出や運用上の問題 |
ここでの匿名化は一般的なデータ加工の話で、法令上の区分を判定するものではありません。また、集団全体の傾向から個人について推測できることまで、差分プライバシーが全て消すわけではありません。
連合学習と差分プライバシーは併用できます。学習する場所を分散させたうえで、共有する情報に保護を加える設計です。モデルを共同で育てる流れは、連合学習の仕組みと注意点で解説しています。
AI学習ではDP-SGDと「1人・1件」の違いを押さえる
AIでは、公開する集計値だけでなく、学習済みモデルもデータに依存した出力と考えられます。学習データの各記録がモデルに及ぼす影響を制限するための代表的な方法が、DP-SGD(差分プライバシーを組み込んだ確率的勾配降下法)です。
基本の流れでは、勾配(モデルの重みを調整する方向と大きさを表す量)について次を行います。
- 学習例ごとに勾配を求める。
- 各勾配の大きさに上限を設ける。これをクリッピングと呼ぶ。
- 制限した勾配を集約し、適切なガウスノイズ(正規分布に従うゆらぎ)を加えてモデルを更新する。
- サンプリングや反復回数などを含め、学習全体のプライバシー損失を評価する。
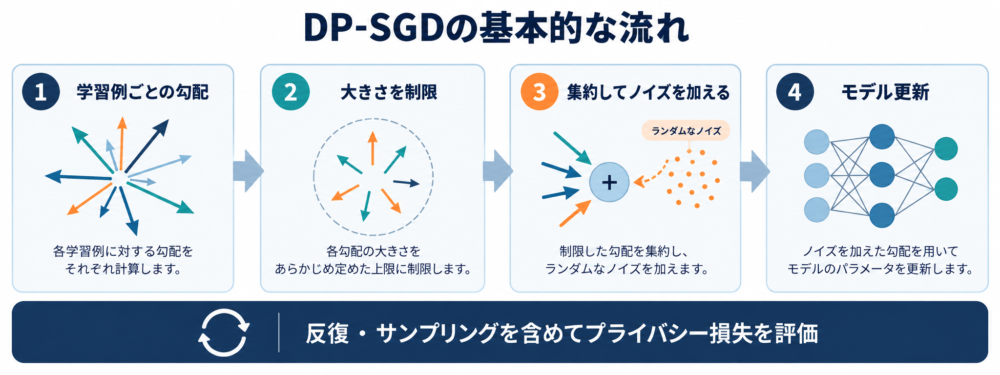
図:DP-SGDの基本処理。反復全体に対するプライバシー損失の評価も必要です。
TensorFlow Privacyの公式紹介は、クリッピングとノイズを用いる学習を説明しています。反復を含めた保証の評価は、Abadiらの「Deep Learning with Differential Privacy」で扱われています。
単に出来上がったモデルの回答へノイズを付けることと、学習全体に対する保証を設計することは区別します。ノイズ量だけでなく、各例の影響をどこまでに制限したか、学習を何回繰り返したかも結果を左右します。
1人が複数の記録を持つなら、1件の保護では足りない場合がある
冒頭の集計では「1人1回答」としていました。しかし、利用ログや学習用の文章では、同じ人が何件も記録を持ちます。
| 保護単位 | 隣接するデータ集合の違い | 読み取る際の注意 |
|---|---|---|
| 1件単位 | ある人の記録を1件だけ追加・削除 | 同じ人の残りの記録まで、同じ強さで一括保護する保証ではない |
| 1人単位 | ある人に対応する全記録を追加・削除 | 1人が寄与できる件数や量の上限を含めて設計する |
例えば、1人が10件の文章を提供している場合、1件だけを守る保証と10件全体を守る保証は異なります。εが同じでも、保護単位が違えば数字だけを並べて優劣を決められません。出典:NIST SP 800-226「Unit of Privacy」
導入時はεだけでなく、保証の条件を確認する
導入を検討する際は、「差分プライバシー対応」という名前よりも、何についての保証かを確認します。以下は、本記事の一次資料を基に整理した確認項目です。
| 確認項目 | 具体的に確かめること |
|---|---|
| 守る単位 | 1件、1人、1日など、何が異なるデータ集合を比較するか |
| パラメータ | εとδ、保証の種類、合成の計算方法が明記されているか |
| 信頼する主体 | 生データを見られるのは誰か。中央型・局所型のどちらか |
| データの寄与 | 1人の件数や値の範囲をどう制限し、感度を求めたか |
| 公開の範囲 | 集計結果、モデル、途中のログなど、何を外へ出すか |
| 繰り返し利用 | 再学習・追加集計・再公開を含め、予算をどう管理するか |
| 有用性 | 全体だけでなく、小さい集団や必要な分類で誤差が許容できるか |
| 実装 | 保証の根拠と、実装・乱数・データ処理の検証があるか |
NISTの実装バグに関する解説が示すように、数学的に正しい機構でも、実装で感度やノイズ量を誤れば保護は成立しません。この記事の数値例や理論図は仕組みを理解するためのもので、実システムの安全性を検証した結果ではありません。
最初に「何を公開したいか」と「誰のどの記録を守りたいか」を決めると、必要な保証と精度を比較しやすくなります。そのうえで、許容する誤差と公開回数をそろえた条件で方式を評価するのが、検討の出発点になります。
コメント