
短い質問なら動くOllamaが、長い資料や会話履歴を渡すと急に遅くなる。その場合は、コンテキスト長、実際の入力の長さ、同時実行数を分けて確認します。まずコンテキスト長を大きくするだけでは、必要なメモリが増えて症状を悪化させることがあります。
この記事では、ローカルで動かすモデルを対象に、設定を一つずつ変えて原因を絞る手順を整理します。公式資料を2026年9月17日に確認した内容で、実機の速度やメモリ使用量を比較したベンチマークではありません。モデルとOllamaのバージョンによって、設定の効き方や表示項目は変わります。
まず「どこで遅いのか」を分ける
長文で遅くなるときも、返答が始まるまで待つ場合と、文字が出始めた後も遅い場合では、最初に調べる場所が違います。
| 症状 | 最初に確認すること | 比較する条件 |
|---|---|---|
| 最初の1回だけ待ち時間が長い | モデルをメモリへ読み込む時間 | 読み込み直後と、モデルが残っている次の実行 |
| 長文のとき、返答が始まるまで長く待つ | 入力の処理量、会話履歴、キャッシュの有無 | 同じコンテキスト設定で短文と長文 |
| 生成が始まってからも遅い | CPU/GPUへの配置、モデルサイズ、ほかの処理 | 同じ入力・出力条件で負荷をそろえる |
| 長文や複数リクエストでメモリ不足になる | コンテキスト設定と同時実行数 | 1モデル・1リクエストに絞った状態 |
| 速くなったが、資料の冒頭を踏まえなくなった | 入力が収まっているか、アプリ側の履歴整理 | 根拠に必要な情報を残した状態で回答品質も確認 |
この表だけで原因が確定するわけではありません。推論に時間をかけるモデルでは、考える処理も返答開始までの待ち時間に影響します。アプリ側の待ち行列や通信時間もあるため、画面の印象とサーバー側の計測値を分けて見ます。
1. バージョンと実際の割り当てを記録する
まず、普段使っている環境のターミナルで次を実行します。
# 比較の前後で同じモデルと実行条件か確認するために記録する
ollama --version
ollama list
ollama ps
ollama listは保存済みモデルの一覧、ollama psはメモリに読み込まれているモデルの一覧です。何も読み込まれていなければ、ollama psにモデルは表示されません。
生成中または生成直後のollama psで、モデル名とともにPROCESSORとCONTEXTを確認します。PROCESSORはCPU/GPUへの配置を調べる手掛かり、CONTEXTは割り当てられているコンテキスト長の確認に使えます。SIZEをGPUプロセス全体のメモリ使用量と同一視せず、OSやGPUの監視表示も併せて確認してください。
表示項目がないバージョンでは、実行中モデルを取得するAPIのcontext_lengthも確認候補です。項目が返らない場合、既定値を推測して記録するのは避けます。
公式のContext length、FAQ、Modelfileには、コンテキスト長の既定値について異なる記載があります。この記事では「何も指定しなければ必ずこの値」とは決めず、バージョン、指定した値、実際の表示をセットで残します。
2. コンテキスト設定と入力の長さを区別する
コンテキストは、モデルが一度の処理で参照できる情報の範囲です。長さはトークン(モデルが文章を扱う単位)で数えます。日本語の文字数とトークン数は一致しません。
Ollamaのnum_ctxはコンテキストウィンドウの大きさを指定する設定です。一方、実際の入力には、今回の質問だけでなく、システム指示や会話履歴、アプリが追加した検索結果なども含まれます。回答を生成するための余地も必要です。
たとえば「短い質問+大きいnum_ctx」と「長い資料+同じnum_ctx」は、同じ条件ではありません。前者では確保する領域の影響、後者では入力を処理する仕事量の増加も考えます。
実行時のメモリには、主に次のものが含まれます。
| 要素 | 何に使うか | 負荷を変える主な条件 |
|---|---|---|
| モデル本体の重み | 学習済みのパラメーターを保持する | モデルサイズ、重みの量子化方式 |
| KVキャッシュ | Attentionで使うキーと値を保持し、再計算を減らす | コンテキスト長、同時実行、モデル構造、キャッシュの精度 |
| 処理用の領域など | 演算や実行基盤が一時的に使う | バックエンド、処理方式、実行条件 |
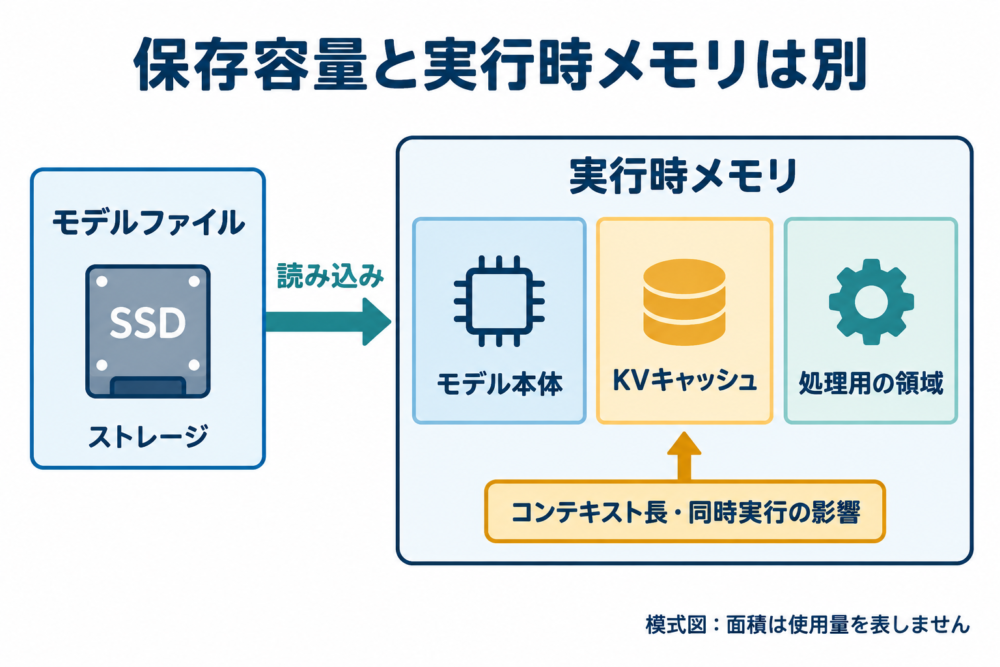
KVキャッシュ(過去のトークンに対応するキーと値の保存領域)は、一般的なTransformerで長文時のメモリ増加を考える重要な要素です。ただし、モデル構造や実行基盤で挙動が異なるため、「コンテキストを2倍にすると全メモリも2倍」とは限りません。原理はHugging FaceのCaching解説を参照できます。
MacのユニファイドメモリはCPUとGPUが共有するメモリです。「RAMとVRAMを別枠で足せる」と考えず、ほかのアプリを含むメモリ使用量やメモリプレッシャーも確認します。また、モデルファイルを外付けSSDへ移して空くのは保存容量で、推論時のメモリ不足がそのまま解決するわけではありません。
3. 1モデル・1リクエストで、設定を一つずつ比べる
ほかのクライアントからのリクエストを止め、新しい会話で比較します。各条件は新しい会話から始め、同じモデルのタグ・量子化方式を使います。出力の上限や推論モードもそろえ、前の条件で追加された会話履歴を次へ持ち越さないようにします。
以下のYOUR_MODEL:TAGは、ollama listで確認した保存済みモデル名へ置き換えてください。
# モデルの取り違えや自動ダウンロードを避けるため、保存済みの名前を使う
ollama show YOUR_MODEL:TAG
ollama run YOUR_MODEL:TAG
ollama runの対話画面で、次のように指定できます。これはOSのシェルに入力するコマンドではありません。
/set parameter num_ctx 40964096は比較用の一例で、どの環境でも安全・最適という意味ではありません。必要な入力と回答が収まり、モデルと環境で扱える値を選びます。設定後に質問を送り、別のターミナルでollama psを確認してください。対話画面での設定が、別のアプリやAPIリクエストにも引き継がれるとは考えないようにします。
余裕がある環境なら、次のように分けて比べると、設定容量と実入力の影響を混同しにくくなります。
| 条件 | 入力 | num_ctxの例 |
比較の目的 |
|---|---|---|---|
| A | 短い同一の質問 | 4096 | 基準を作る |
| B | Aと同じ質問 | 8192 | 設定する容量だけを増やした影響を見る |
| C | 資料を追加した長い入力 | 8192 | Bから実入力を増やした影響を見る |
8192を確保できない環境で、この表をそのまま実行する必要はありません。メモリ不足が出たら比較を止め、前の値へ戻します。最初のモデル読み込みが含まれる実行と、読み込み済みの実行も分けて記録します。
繰り返し実行では入力がキャッシュされることがあり、同じ文章の2回目だけ速くなっても、設定変更の効果とは断定できません。モデルの常駐状態とキャッシュの条件をそろえるか、違いを記録して比較します。FAQとGenerate APIで設定・計測項目を確認できます。
メモリが足りない場合は、回答品質も一緒に確認する
| 変更 | 期待できる効果 | トレードオフ・確認点 |
|---|---|---|
| 不要な履歴や資料を減らす | 入力処理の負荷を減らす | 回答に必要な根拠まで除かない |
必要な範囲までnum_ctxを下げる |
コンテキスト用のメモリ負荷を抑える | 入力と回答の余地が収まるか確認する |
| 小さいモデルや別の量子化を使う | モデル本体の負荷を抑える | 指示追従・正確さが変わるため同じ課題で再評価する |
| 同時実行を減らす | 同時に確保する領域を抑える | リクエスト全体の処理件数や待ち時間に影響する |
| 不要なモデルをアンロードする | ほかのモデルが使うメモリを空ける | 次に使うときに読み込み時間が発生する |
不要なモデルは、ollama psで名前を確認してからollama stop YOUR_MODEL:TAGでアンロードできます。これは保存済みファイルの削除ではありません。CLIのリファレンスを参照してください。
4. APIの時間を読み、入力処理と生成を分ける
画面の待ち時間だけでは判断しにくいときは、API(アプリケーション間の通信規約)の応答に含まれる時間を確認します。ここではローカルのOllamaへ1件ずつ送ります。
次をUTF-8のrequest.jsonとして保存し、YOUR_MODEL:TAGを保存済みモデル名へ置き換えます。比較したい文章はpromptへ入れてください。JSON文字列内の改行は\n、引用符は\"と書きます。
{
  "model": "YOUR_MODEL:TAG",
  "prompt": "比較に使う同じ質問をここに入れます。",
  "stream": false,
  "keep_alive": "5m",
  "options": {
    "num_ctx": 4096,
    "num_predict": 128,
    "temperature": 0
  }
}num_predictは生成するトークン数の上限です。ここでは出力が長くなり過ぎないよう128を指定していますが、回答が途中で終わる場合があります。推論モードを持つモデルではその設定も固定し、短い出力上限で十分な回答が得られるか確認してください。
Mac・Linuxでは次のコマンドで応答をresult.jsonへ保存します。WindowsのPowerShellでは、同じ行の先頭をcurl.exeに置き換えてください。
# 条件ごとの計測値を残すため、比較時は出力ファイル名も分ける
curl --fail --silent --show-error http://localhost:11434/api/generate -H "Content-Type: application/json" --data-binary @request.json -o result.json
stream: falseは、完了後にまとめて応答を受け取る指定です。この方法では、最初のトークンが届くまでの時間であるTTFTを直接測っていません。
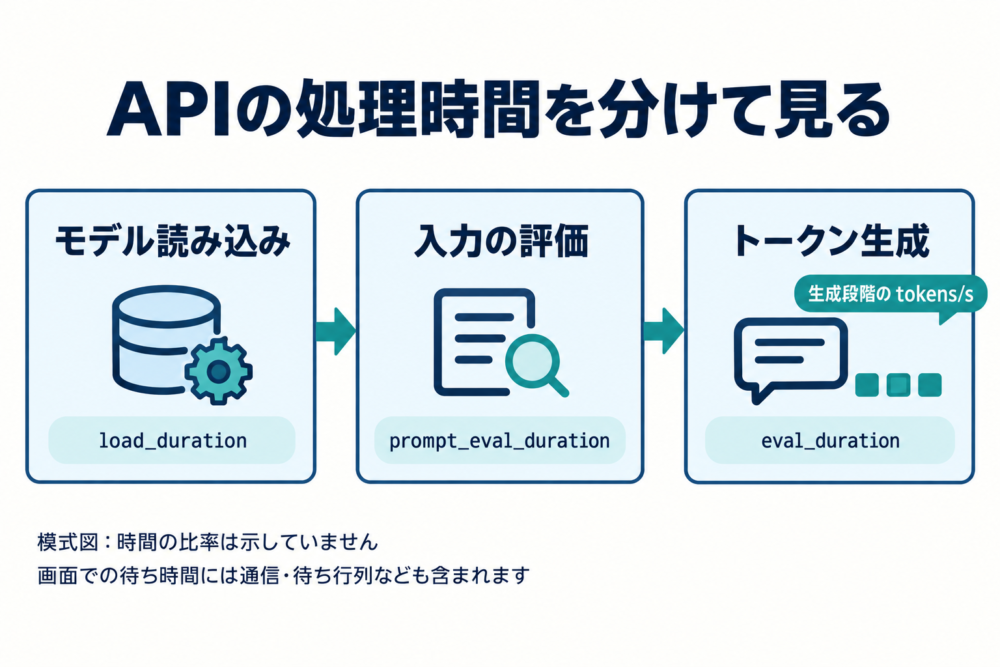
応答内の時間はナノ秒です。主に次を見ます。
| 項目 | 読み取れること | 注意点 |
|---|---|---|
load_duration |
モデルの読み込みにかかった時間 | 初回と常駐中の実行を分ける |
prompt_eval_duration |
キャッシュされていない入力の評価時間 | 実入力とキャッシュ条件を併記する |
prompt_eval_count |
入力側のトークン数 | 文字数として読まない |
prompt_eval_cached_count |
キャッシュされた入力のトークン数 | バージョンによって返らない場合がある |
eval_duration / eval_count |
生成処理の時間と生成トークン数 | 生成段階の速度を計算する材料 |
total_duration |
APIが報告する全体の処理時間 | クライアントで観測した待ち時間と区別する |
以下をread_metrics.pyとして保存し、Python 3で実行すると、秒へ換算できます。存在しない項目はゼロと決めつけず、N/Aにしています。
import json
import logging
from pathlib import Path
from typing import Any

logging.basicConfig(level=logging.INFO, format="%(levelname)s: %(message)s")
data: dict[str, Any] = json.loads(Path("result.json").read_text(encoding="utf-8-sig"))
if "error" in data:
    raise SystemExit("Ollamaからエラーが返っています。result.jsonを確認してください。")

for key in ("load_duration", "prompt_eval_duration", "eval_duration", "total_duration"):
    value: Any = data.get(key)
    seconds: str = f"{value / 1_000_000_000:.3f} s" if isinstance(value, (int, float)) else "N/A"
    logging.info("%s = %s", key, seconds)

for key in ("prompt_eval_count", "prompt_eval_cached_count", "eval_count"):
    logging.info("%s = %s", key, data.get(key, "N/A"))

count: Any = data.get("eval_count")
duration: Any = data.get("eval_duration")
# 未提供の計測値やゼロ秒を、実測の生成速度として扱わないために分岐する
if isinstance(count, (int, float)) and isinstance(duration, (int, float)) and duration > 0:
    logging.info("generation = %.2f tokens/s", count / (duration / 1_000_000_000))
else:
    logging.info("generation = N/A")
python3 read_metrics.pyWindowsでPythonをpyから起動している場合は、py -3 read_metrics.pyとします。
ここで求めたtokens/sは生成段階の平均で、読み込みや入力処理を含む全体の速さではありません。load_durationとprompt_eval_durationを足しても、通信・待ち行列・推論・画面描画を含むTTFTそのものにはなりません。計測項目の意味はGenerate APIの公式リファレンスに基づきます。
入力処理と生成の仕組みを掘り下げたい場合は、LLMのPrefillとDecodeの違いも参考になります。
5. 同時実行とキャッシュ設定は、基本条件をそろえてから見直す
1件ずつなら動くのに、アプリ経由や複数人で使うとメモリ不足になる場合は、同時実行を確認します。OllamaのOLLAMA_NUM_PARALLELはモデルごとの並列リクエスト数、OLLAMA_MAX_LOADED_MODELSは同時に読み込むモデル数に関わります。前者を増やすと、同時に扱うコンテキスト用のメモリも増えます。
これらはサーバー側の設定です。クライアントのターミナルに環境変数を設定しても、すでに起動しているアプリやサービスへ反映されるとは限りません。変更前の値を控え、実際にOllamaを起動する方法に合わせて設定し、再起動後に確認します。OS別の方法はFAQの環境変数設定を参照してください。
OLLAMA_MAX_QUEUEで待ち行列を長くしても、1件の処理が速くなるわけではありません。混雑時の問題は、同時実行中の処理と、待機している処理を分けて調べます。
KVキャッシュの量子化は、品質も評価できる場合に試す
さらにメモリを抑えたい場合は、Flash Attention(Attentionのメモリアクセスを効率化する処理)とKVキャッシュの量子化が候補になります。現在のFAQでは、Flash Attentionは対応するバックエンドやデバイスで自動的に使われると説明されています。すべての環境で手動有効化が必要とは限りません。
OLLAMA_KV_CACHE_TYPEにはf16、q8_0、q4_0があり、量子化したKVキャッシュはFlash Attentionが前提です。メモリを減らせる一方で、品質への影響はモデルや課題に依存します。設定を変えるなら、長い資料からの根拠抽出など実際の用途で回答を比較し、元の設定へ戻せるようにしてください。FAQのFlash Attention・KVキャッシュの説明が判断の出発点になります。
改善しないときに残す記録
次の記録があると、入力処理、モデルの配置、同時実行のどこで差が出るかを追いやすくなります。
- Ollamaのバージョン、モデルの完全な名前と量子化方式
- 指定した
num_ctxと実行中のCONTEXT、PROCESSOR - 実入力のトークン数、出力の上限、履歴・推論モードの条件
- 読み込み済みかどうか、キャッシュの有無、同時実行数
- APIの計測値、OS側のメモリ状況、発生したエラー
エラーが続く場合は、Troubleshootingのログ確認手順からOSに合う保存先を確認します。ログを共有するときは、プロンプトやパスなど機密情報が含まれていないか確認してください。
長文で困ったときは、まず1件ずつの条件に戻し、必要な情報が収まるコンテキスト長で試します。そこから入力、設定容量、モデル、同時実行のうち一つだけを変え、速度とメモリに加えて、回答に必要な情報が保たれているかを確認していきましょう。

コメント