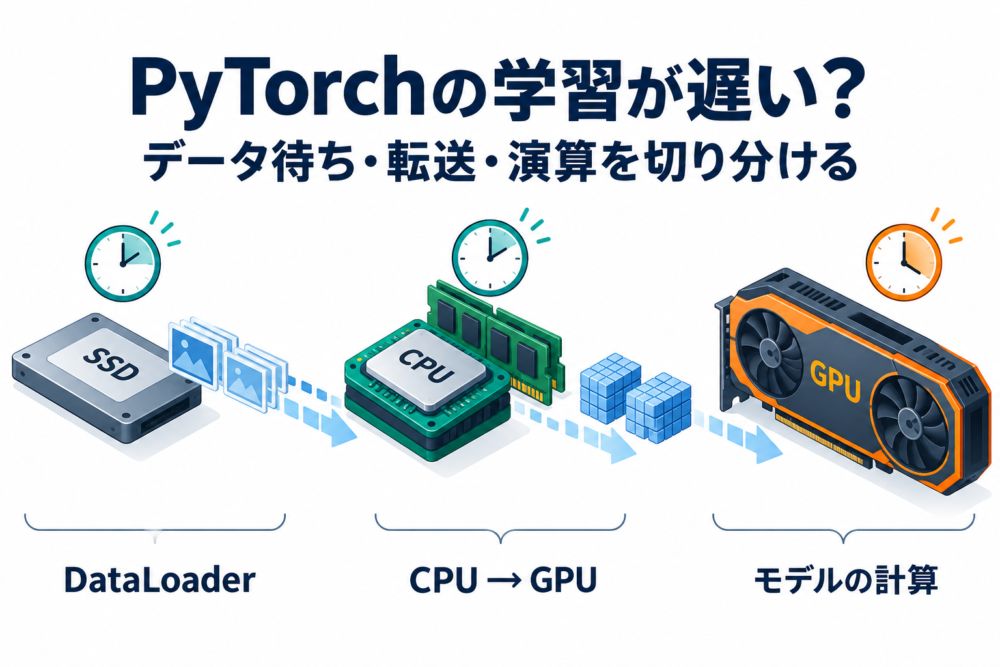
PyTorchの学習が遅く、GPU使用率も低いときは、データを待つ時間・CPUからGPUへ転送する時間・モデルを計算する時間を分けて確認します。num_workersを増やす前に、どの段階で待っているかを調べると、効果のない設定変更を減らせます。
原因調査では処理を区切って測り、改善効果は通常の学習全体の時間で判断します。区切りごとにGPUの完了を待つ計測は、処理の重なりを変えてしまうためです。
この記事では、単一GPUの一般的なPyTorch学習ループを対象に、DataLoader(データを取り出し、バッチ単位にまとめる仕組み)の調整方法を説明します。CPUで実行した小さな比較実験と、手元の学習へ組み込める計測コードも掲載します。
症状から最初に調べる場所を決める
| 見えている症状 | 調べる場所 | 最初の比較 |
|---|---|---|
| GPUが動いたり止まったりする | 次のバッチ待ち、CPU前処理、転送 | 区間ごとの待ち時間を測る |
| 最初のバッチだけ特に遅い | worker起動、ファイルキャッシュ、初回の演算準備 | 初回と2回目以降を分ける |
| 毎epochの先頭で待つ | workerの作り直し | 同じDataLoaderでpersistent_workersを比較 |
num_workersを増やすと遅くなる |
プロセス間の受け渡し、CPUやストレージの競合 | 0・2・4などを順に測る |
| GPUへの転送が長い | バッチ容量、ページ固定、細かな転送回数 | pin_memoryと転送設定を確認 |
| GPUが動き続けても学習が遅い | 演算量、バッチサイズ、モデル実装 | GPU上に用意したデータでも遅いか調べる |
GPU使用率は手掛かりですが、その値だけでは待ちの原因を特定できません。たとえばnvidia-smiのGPU使用率は、サンプル期間内にGPUのカーネル(GPU上の実行処理)が動いていた時間の割合です。演算器をどれほど効率よく使ったかや、VRAM(GPU用メモリ)が何割埋まっているかとは異なります。NVIDIA公式:nvidia-smi
学習データがGPUへ届くまでの経路
画像を使う学習では、おおむね次の処理がつながっています。
- SSDやネットワークからファイルを読む。
- CPUで画像のデコード、リサイズ、データ拡張を行う。
- 複数のサンプルをバッチにまとめ、CPU側のメモリへ置く。
- バッチをGPU側のメモリへ転送する。
- GPUで予測、損失計算、逆伝播、重み更新を行う。
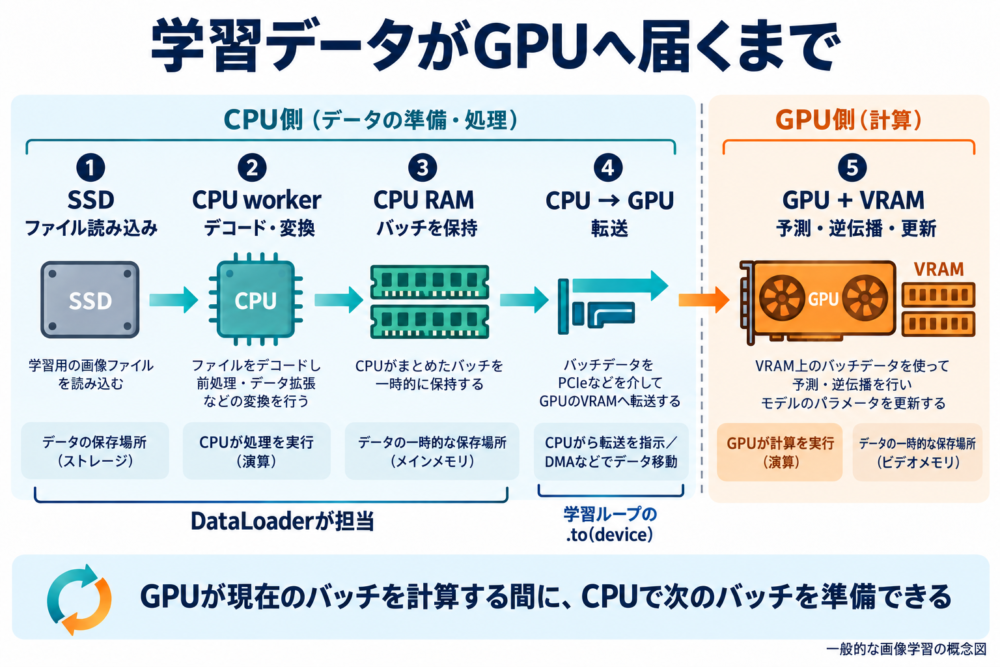
図:DataLoaderはCPU側でバッチを準備し、学習ループの.to(device)などでGPUへ転送します。DMAはCPUが転送を指示した後、専用の仕組みでメモリ間のデータを移す方式です。独自に作成した概念図です。
DataLoaderのworker(データの取り出しなどを担当する別プロセス)を使うと、GPUが現在のバッチを計算している間に、CPU側で次のバッチを準備できます。num_workers=0では、データの取り出しを学習側と同じプロセスで行います。必要なworker数は、データの処理内容・CPU・GPU・保存場所によって変わります。PyTorch公式:Performance Tuning Guide
ただし、CPUで先に準備できても、GPUへの転送が詰まれば学習は待ちます。逆に、データがすでにRAMにあり取り出しが軽い場合は、workerの管理や受け渡しの方が負担になることがあります。
SSD・DRAM・GPUの役割を整理したい場合は、AIのデータはどこを通る?SSD・DRAM・SRAMからGPU演算までも参照してください。
「次のバッチ待ち」と「前処理の時間」は同じではない
next(iterator)にかかった時間は、学習側のプロセスが次のバッチを受け取るまで待った時間です。workerが事前に準備できていれば、CPU前処理に時間がかかっていても、next()は短時間で返ります。
したがって、次のように読み分けます。
| 計測値 | 分かること | その値だけでは分からないこと |
|---|---|---|
next()の待ち |
学習側から見た、バッチの供給待ち | ファイル読み込み・デコード・バッチ作成の内訳 |
| 転送区間 | .to()から転送完了までのホスト側経過時間 |
純粋な転送帯域だけの性能 |
| 学習区間 | CPUの呼び出しとGPU完了待ちを含む、学習処理の経過時間 | GPUカーネルだけの実行時間 |
| epoch全体 | 一定量のデータを処理する実際の所要時間 | 遅い処理の詳細な内訳 |
epoch(データセットを一巡する単位)の最初には、worker起動や最初の読み込みが含まれます。初回の時間を、定常的なバッチの時間と混ぜないようにします。
CUDAの処理は、Pythonの呼び出しより後まで続く
CUDA(NVIDIA GPUで計算するための基盤)の処理は非同期で進むため、Python側で関数を呼び終えただけではGPUの計算が終わっていないことがあります。time.perf_counter()だけで前後を囲むと、処理を投入した時間を測ってしまう場合があります。
torch.cuda.synchronize()は、対象デバイス上の処理の完了を待ちます。区間の境界へ入れると原因調査に使いやすくなる一方、普段は重なっていたCPU・GPUの処理を変えてしまいます。PyTorch公式:CUDA synchronize
診断では区間ごとに同期し、性能比較ではepochの前後だけ同期する、という2段階で使い分けます。診断値の合計や診断中のsamples/sを、通常時の学習性能と扱わないことが重要です。
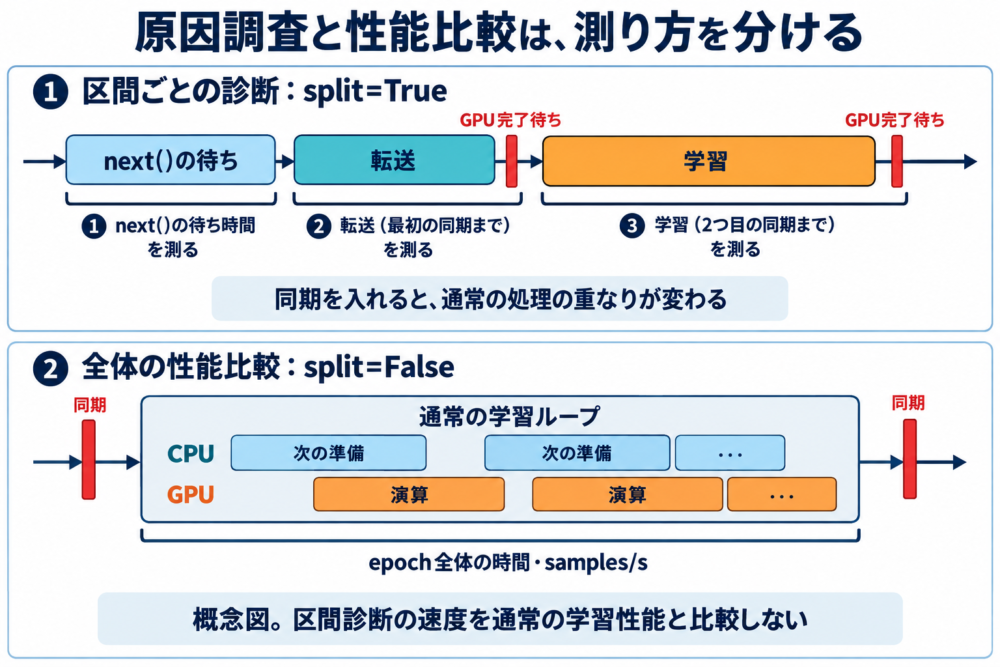
図:区間診断では転送と学習の完了をそれぞれ待ちます。全体計測は開始前の同期が終わってから、終了側の同期が完了するまでを測ります。時間幅は実測値を表していません。
読み込み・転送・学習を分けて測るコード
以下は、DataLoaderが(入力, クラス番号の教師ラベル)を返す分類モデル向けの計測関数です。split=Trueで区間を診断し、split=Falseでepoch全体を測ります。モデルとoptimizer(重みを更新する処理)は、呼び出す前に用意します。
対象はCPUまたは単一CUDAデバイスです。辞書形式のバッチ、独自損失、勾配蓄積、分散学習には、その学習ループに合わせた変更が必要です。下の関数は実際に学習して重みを更新するため、比較時にはモデルの初期状態や学習条件もそろえてください。
"""A diagnostic epoch timer for CPU or one CUDA device."""
from statistics import mean
from time import perf_counter

import torch
from torch import nn
from torch.utils.data import DataLoader


def wait_device(device: torch.device) -> None:
    """Wait for CUDA work before taking a host timestamp.

    Args: device is cpu or cuda.
    Returns: None.
    Raises: RuntimeError if CUDA synchronization fails.
    Example: wait_device(torch.device('cpu'))
    """
    if device.type == 'cuda':
        torch.cuda.synchronize(device)


def measure_training_epoch(
    model: nn.Module,
    loader: DataLoader,
    optimizer: torch.optim.Optimizer,
    device: torch.device,
    split: bool = False,
) -> dict[str, float]:
    """Train one epoch and measure whole-run or synchronized stage timings.

    Args: model is on device; loader returns (features, class-index labels).
        optimizer belongs to model; device is cpu/cuda; split enables diagnostic barriers.
    Returns: Epoch seconds and samples/s; split also returns mean stage milliseconds.
    Raises: ValueError for an empty loader or unsupported device; RuntimeError for training failure.
    Example: measure_training_epoch(model, loader, optimizer, torch.device('cpu'))
    """
    if device.type not in {'cpu', 'cuda'}:
        raise ValueError('This example supports cpu or cuda only')
    criterion: nn.Module = nn.CrossEntropyLoss()
    model.train()
    wait_device(device)
    epoch_start: float = perf_counter()
    iterator = iter(loader)
    iterator_ms: float = (perf_counter() - epoch_start) * 1000
    samples: int = 0
    rows: list[tuple[float, float, float]] = []
    while True:
        start: float = perf_counter() if split else 0.0
        try:
            x, y = next(iterator)
        except StopIteration:
            break
        loaded: float = perf_counter() if split else 0.0
        x = x.to(device, non_blocking=device.type == 'cuda')
        y = y.to(device, non_blocking=device.type == 'cuda')
        if split:
            wait_device(device)
        transferred: float = perf_counter() if split else 0.0
        optimizer.zero_grad(set_to_none=True)
        loss: torch.Tensor = criterion(model(x), y)
        loss.backward()
        optimizer.step()
        if split:
            wait_device(device)
            ended: float = perf_counter()
            rows.append((loaded - start, transferred - loaded, ended - transferred))
        # item() would add a synchronization point to the ordinary measurement path.
        samples += x.shape[0]
    wait_device(device)
    elapsed: float = perf_counter() - epoch_start
    if samples == 0:
        raise ValueError('The loader must contain at least one batch')
    result: dict[str, float] = {'epoch_s': elapsed, 'samples_per_s': samples / elapsed}
    if split:
        result.update(
            iterator_ms=iterator_ms,
            next_wait_ms=mean(row[0] for row in rows) * 1000,
            transfer_ms=mean(row[1] for row in rows) * 1000,
            train_ms=mean(row[2] for row in rows) * 1000,
            first_next_wait_ms=rows[0][0] * 1000,
        )
return result呼び出しを確認する小さな例です。上の関数と同じPythonファイルの末尾へ置けます。実データを診断するときは、TensorDatasetとモデルを自分のものへ置き換えます。
from torch.utils.data import TensorDataset

if __name__ == "__main__":
    device: torch.device = torch.device(
        "cuda:0" if torch.cuda.is_available() else "cpu"
    )
    dataset: TensorDataset = TensorDataset(
        torch.randn(1024, 32), torch.randint(0, 4, (1024,))
    )
    loader: DataLoader = DataLoader(dataset, batch_size=64, num_workers=0)
    model: nn.Module = nn.Linear(32, 4).to(device)
    optimizer: torch.optim.Optimizer = torch.optim.SGD(
        model.parameters(), lr=0.01
    )

    # 初回と定常に近いepochを分けるため、別々に記録する。
    print("first:", measure_training_epoch(model, loader, optimizer, device))
    print("next:", measure_training_epoch(model, loader, optimizer, device))
    print("diagnostic:", measure_training_epoch(
        model, loader, optimizer, device, split=True
))samples_per_sは1秒あたりの処理サンプル数です。iterator_msはイテレータ作成時間、first_next_wait_msは最初のnext()の待ち、next_wait_msは全バッチの待ち時間の平均を表します。初回だけ突出する場合は、平均だけで判断しないようにします。
この診断は、同じデバイス上のほかの処理も同期の影響を受けます。測定中の別ジョブや不要なログ出力を減らしてください。また、loss.item()のようにGPUの値をPythonへ取り出す処理は同期を生むことがあるため、通常モードの計測ループには入れていません。
コードのCPU分岐は、PyTorch 2.5.1+cpuで、worker数0と2・両計測モードの学習処理を確認しています。CUDA分岐の実機計測と、以下の転送設定による速度改善は未検証です。 GPU側は公式仕様に基づく計測例として、利用環境で確認してください。
num_workersは0から比較する
num_workersは、データの取り出しを担うプロセスの数です。画像デコードやCPU前処理が重ければ、並列化で供給を改善できる可能性があります。一方、プロセスの起動、データの受け渡し、CPU・ストレージの競合も増えます。
最初は0 → 2 → 4など少数の候補を比較し、全体のsamples/sが改善しなくなったら増加を止めます。この数字は比較を始める例であり、CPUコア数から一意に決まる推奨値ではありません。
RAM上の軽いデータで行ったCPU実験
今回は、RAM上に用意した4096件×64要素のfloat32テンソルを、64件ずつ取り出しました。元データは1 MiBで、データファイルの読み込み・画像変換・モデル学習・GPU転送を含みません。worker起動時のPythonやライブラリの読み込みは測定に含みます。workerを増やす管理コストが見えやすい、小さな条件です。
CPUはIntel Core i7-7700、WSLから見える論理CPU数は8です。WSL上のPython 3.12.3、PyTorch 2.5.1+cpu、NumPy 1.26.4を使い、子プロセスの起動方式はspawnを明示しました。これは新しいPythonプロセスからworkerを起動する方式です。親プロセスのPyTorch演算スレッド数は1、shuffle=False、pin_memory=False、workerありのprefetch_factor=2としています。
各設定を3回実行し、それぞれ同じDataLoaderで2 epochを最後まで読み切りました。表はepoch全体の時間の中央値です。起動や先読みを含め、iter(loader)の直前から測っています。persistent_workers=Falseでは、読み切った際のworker終了の待ち時間も含みます。
| num_workers | persistent_workers | 初回epoch | 2回目のepoch |
|---|---|---|---|
| 0 | False |
15.2 ms | 12.1 ms |
| 2 | False |
1832.2 ms | 1792.8 ms |
| 2 | True |
1545.8 ms | 66.2 ms |
この結果から判断できるのは、このように取り出しが軽いデータでは、workerを増やす方が遅くなり得るという点です。実画像の読み込みや重い前処理では結果が変わるため、表の設定をそのまま推奨値にはしません。WSLでspawnを明示した実験であり、Windowsネイティブ環境やGPU学習の速度を測ったものでもありません。
pin_memoryとnon_blockingは何を変えるのか
pin_memory=Trueは、返すテンソルをページ固定メモリへ配置するための設定です。ページ固定とは、転送中にCPU側のデータを置いたメモリページが退避されないようにする仕組みです。CPUからCUDA GPUへデータを渡す場面で検討します。
x.to(device, non_blocking=True)は、転送のたびにCPU側で完了を待つ動作を減らせる設定です。CPUが次の処理へ進みやすくなることと、GPUの転送と演算が実際に重なることは区別します。
同じCUDA stream(GPU処理を順に並べる実行キュー)へ転送と演算を投入すると、そのstream内の処理順に従います。転送と別バッチの演算を重ねるには、別stream、ページ固定した転送元、対応する転送エンジンなどの条件が必要です。独自の先読み処理では、データの寿命と処理の依存関係も管理しなければなりません。PyTorch公式:pin_memoryとnon_blockingの解説
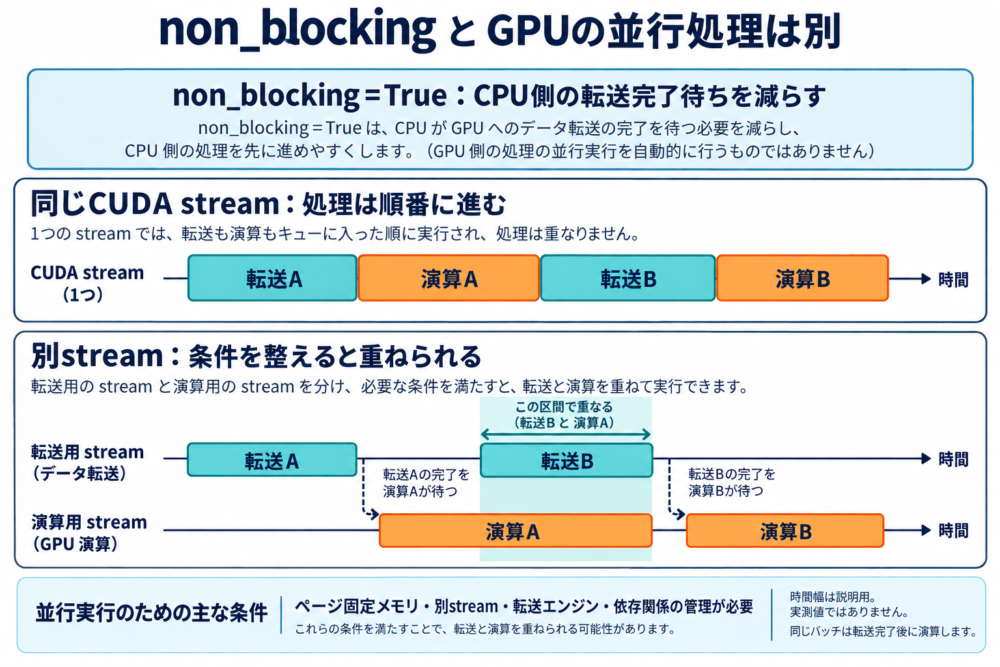
図:転送Bと演算Aのように、別バッチの処理を重ねる例です。同じバッチの演算は、その転送の完了を待ちます。独自の概念図であり、本文の計測コードはこの別stream処理を実装していません。
通常の単一GPU学習で試すなら、次のように設定します。datasetとdeviceは定義済みとします。
loader: DataLoader = DataLoader(
    dataset,
    batch_size=64,
    num_workers=2,
    pin_memory=device.type == "cuda",
)

for x, y in loader:
    x = x.to(device, non_blocking=device.type == "cuda")
    y = y.to(device, non_blocking=device.type == "cuda")
# 転送設定だけを比較するため、以降の学習処理は同じ条件にする。ページ固定には処理コストとCPUメモリ上の負担もあります。学習ループの中で毎回手動のpin_memory()を追加する方法を、無条件な高速化として使わないでください。DataLoaderでの設定を基準に、同じ条件の全体時間で比較します。
epoch先頭の遅さと、先読みの量を調整する
persistent_workers=Trueは、データセットを一巡した後もworkerを維持する設定です。同じDataLoaderを次のepochでも使う場合に、workerの作り直しを減らせます。num_workers=0では使えません。
workerが保持するDatasetの状態も残ります。epochごとに親側のDatasetを書き換えても、子プロセスへ自動で同じ変更が伝わると考えないようにします。乱数やデータ拡張の再現性も含めて確認します。PyTorch公式:DataLoader
prefetch_factorは、workerごとに先読みするバッチ数です。workerが2、係数が2なら、全workerで4バッチ分を先読みする設定になります。待ちの揺れを吸収しやすくなる一方、保持するデータ量が増えます。
たとえば1バッチのテンソルが32 MiBなら、4バッチで128 MiBです。これは先読みしたバッチ内容だけの概算で、実際にはDatasetの複製、処理途中のデータ、共有メモリ、ページ固定用の領域なども必要です。RAM使用量の上限保証として使わないでください。
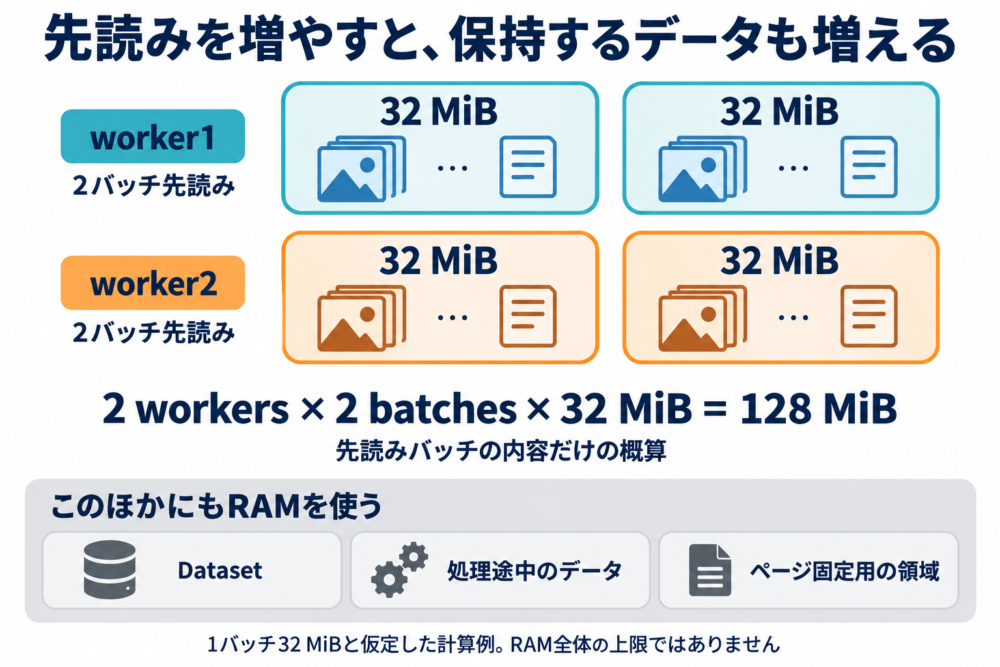
図:1バッチを32 MiBと仮定した例です。Datasetや処理途中のデータなどもRAMを使うため、先読みバッチだけの計算をプロセス全体の使用量とは扱いません。
| 設定 | 改善を期待する箇所 | 負担・確認事項 |
|---|---|---|
num_workersを増やす |
読み込み・CPU前処理の供給 | 起動・受け渡し・CPU競合・RAM消費 |
pin_memory=True |
CPUからGPUへの転送 | ページ固定のコストとCPUメモリ |
non_blocking=True |
CPU側の転送完了待ち | GPU転送と演算の重なりは別途条件が必要 |
persistent_workers=True |
epochをまたぐworker起動 | 子プロセスとDataset状態が残る |
prefetch_factorを増やす |
一時的な供給の遅れ | RAMや共有メモリの使用量が増える |
設定は一つずつ変えます。num_workers=0の基準ではprefetch_factorを指定せず、persistent_workers=Falseにしておくと比較しやすくなります。
待ち時間が長かったときの次の確認
バッチ待ちが長い:読み込みと前処理を分ける
workerを増やしても改善しない場合は、ストレージやCPU処理の内訳を調べます。ファイルを読む部分とデコード・変換部分を、それぞれDatasetの中で計時すると分けられます。ただし、細かなログを全サンプルで出すと、それ自体が負担になるため、少数のデータで調べます。
一時的にデータ拡張を外す、読み込み済みの同じ形のテンソルを渡す、といった比較も原因を絞る手段になります。入力内容や処理条件が変わる比較なので、その結果を本来の学習性能や精度として扱わないようにします。
転送や学習が長い:DataLoader以外も見る
転送が長ければ、バッチ容量、細かいテンソルを何度も転送していないか、不要なCPUへの戻しがないかを確認します。演算が短すぎる小さなモデルでは、Python側の呼び出しが全体に占める割合も大きくなります。
さらに詳しく調べる場合は、torch.profiler(CPUとGPUの処理を記録する機能)で、GPU処理とCPUの空き時間を確認します。親プロセスの記録だけでworker内の前処理すべてが見えるとは限りません。PyTorch公式:Profiler
Attention演算の測定へ進む場合は、FlashAttentionの速度とGPUメモリを比較する方法|PyTorchの測定コードと注意点も参考になります。配置エラーでコードが止まる場合は、PyTorchのCPU・GPU混在エラー対処法で先に実行条件を整えます。
Windows・WSL・コンテナでは環境条件も記録する
Windowsなどspawnを使う環境では、workerから読み込めるよう、Datasetクラスや関数をモジュール直下に定義し、実行部分をif __name__ == "__main__":で囲みます。Notebook内だけで定義した関数やlambdaは、そのままworkerへ渡せない場合があります。切り分け時には.pyファイルとnum_workers=0から確認します。PyTorch公式:プラットフォームごとのDataLoader動作
WSLでLinux側から多数の小さなファイルを読む場合は、Windows側の/mnt/cや/mnt/dにあるデータと、Linux側のファイルシステムにあるデータを比較する余地があります。Microsoftも、LinuxツールではLinux側にファイルを置くことを性能面から推奨しています。元データの保存先をいきなり変更せず、小さなコピーで確認します。Microsoft公式:WSLのファイルシステム
Linuxコンテナでworkerのbus errorや共有メモリ関連エラーが出る場合は、/dev/shm(プロセス間でデータを共有するメモリ領域)の容量も確認します。worker数、バッチサイズ、先読み量を減らす比較ができます。共有メモリ内のファイルを、ほかの処理への影響を確認せず削除する対処は避けます。PyTorch公式:Data Loading Optimization
改善したかどうかは、同じ条件の全体時間で判断する
診断で候補を絞った後は、区間ごとの同期を外した通常モードで比べます。データ件数、バッチサイズ、モデル、精度形式、データ拡張、保存場所をそろえ、初回epochと2回目以降のepochを分けて記録します。ファイルキャッシュの影響もあるため、初回と2回目の差をworker起動だけの効果とは判断しません。
数回繰り返した時間とsamples/sに加え、CPUメモリ使用量も残すと、速さと負担を比較できます。バッチサイズやデータ拡張を変えた場合は学習条件も変わるので、最終的な精度や収束も別に確認します。
GPU使用率が上がっても全体時間が短くならなければ、その設定変更を採用する根拠は十分ではありません。「どこを待っていたか」と「同じ学習が何秒で終わったか」を組み合わせて判断します。
参考資料
- PyTorch:DataLoader
- PyTorch:Performance Tuning Guide
- PyTorch:pin_memoryとnon_blocking
- PyTorch:Data Loading Optimization
- PyTorch:CUDA synchronize
- PyTorch:Profiler
- NVIDIA:nvidia-smi
- Microsoft:WSLのファイルシステム
仕様は2026年9月22日に確認しています。CPUの限定実験と、公式仕様に基づくGPU計測・設定の説明を区別して記載しています。
コメント