連合学習(Federated Learning)は、各端末や組織に学習データを残し、モデルの更新情報を持ち寄って共同でAIを学習する方法です。生データを一か所へ集めにくい場合でも、複数の参加者のデータを学習へ生かせます。ただし、更新情報からの漏えい、通信の負担、拠点ごとのデータの偏りには別途対処が必要です。
この記事では、3つの工場が共同でモデルを学習する架空例を使い、情報が移動する順序と平均の計算を説明します。計算は仕組みを理解するための例であり、実際に学習を実行した結果や性能測定ではありません。資料の確認日は2026年10月9日です。掲載図は本記事用に生成AIで作成した独自の模式図です。
連合学習とは?データの場所と学習の場所を分けて考える
たとえば、工場A・B・Cが製品の検査画像を持ち、それぞれ不良品を検出するAIを作りたいとします。画像には製造上の機密が含まれるため、他工場や共通サーバーへそのまま送ることは難しい、という設定です。
連合学習なら、各工場の計算機で自分の画像を使って学習し、その結果生じたモデルの更新情報を共有します。モデルは、入力から予測を出すための計算の仕組みです。そこで調整する数値をパラメータと呼びます。
以下は、共通のモデルを中央サーバーで集約する基本形と、ほかの学習方法を比べたものです。
| 比較軸 | 中央集約型の学習 | 連合学習の基本形 | 各拠点だけの単独学習 |
|---|---|---|---|
| 生データの場所 | 学習用の中央環境へ集める | 各拠点に残す | 各拠点に残す |
| 主に共有するもの | 学習データ | 学習したモデルのパラメータや更新差分など | 共同学習用には共有しない |
| ほかの拠点の情報の利用 | 集めたデータを直接学習する | 更新情報の集約を通じて反映する | 基本的には利用しない |
| 利点 | データ全体の確認や学習の管理をまとめやすい | 生データを集めず共同学習できる | 参加者間の調整が少ない |
| 主な負担 | データの移送・集中管理 | 各拠点の計算環境、通信、集約、共同運用 | 自拠点のデータだけで精度を確保する必要 |
「端末の中でAIを動かすこと」とも区別が必要です。学習済みモデルで答えを出す処理は推論といい、端末で推論するだけなら共同学習は発生しません。推論の要求を複数PCへ振り分ける仕組みは、NVIDIA PAIRとローカルAIのルーティングで扱っています。
Google Researchは2017年の発表で、AndroidのGboardにおけるクエリ候補の改善を連合学習で試験していると報告しました。これは当時の報告であり、現在の全機能が同じ方式で動くことを示すものではありません。Google Research:Federated Learning
3拠点が同じモデルを育てる流れ
ここでは、各工場が同じ種類の検査項目を持ち、同じ構造のモデルを学習する場合を考えます。全3拠点が参加する1回の往復を、ラウンドと呼びます。
- 同じモデルを配る。 中央サーバーが、そのラウンドの出発点となるモデルをA・B・Cへ送ります。
- 各拠点で学習する。 AはAの画像、BはBの画像、CはCの画像を使い、決めた回数だけモデルの数値を調整します。
- 更新情報を持ち寄る。 各拠点が更新後のパラメータ、または出発点からの差分などをサーバーへ送ります。検査画像そのものは送りません。
- 集約して次へ進む。 サーバーが更新情報を合わせ、できた共通モデルを次のラウンドへ配ります。
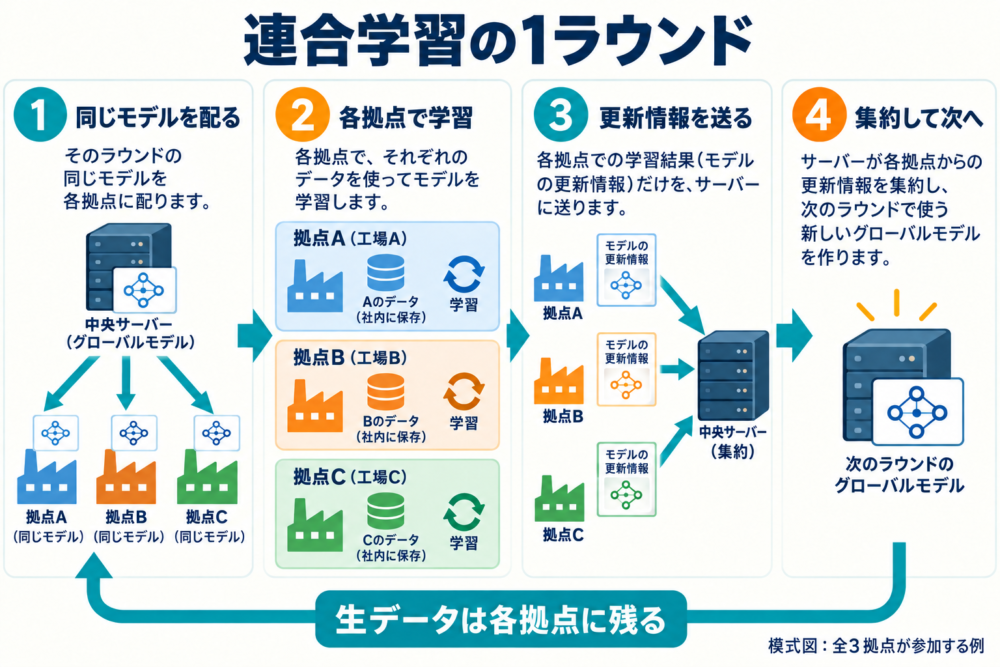
*FedAvgの原論文を基に独自構成。全3拠点が参加する1ラウンドの模式図です。*
共有する情報の形式や集約の方法は方式によって異なります。以下では、局所的に学習したモデルのパラメータを平均するFedAvg(Federated Averaging)を取り上げます。各ラウンドを同じモデルから始める点も、この説明の前提です。McMahanら:FedAvgの原論文
FedAvgの計算例:3拠点なら3等分とは限らない
FedAvgの基本的な考え方では、各拠点のデータ件数に応じて重みを付けた平均を使います。モデルには通常多数のパラメータがありますが、計算を追いやすくするため、対応する1つの成分だけを見てみます。
全3拠点が同じモデルから学習を始め、同じラウンドで次の値を返したと仮定します。数値はすべて説明用です。
| 拠点 | 学習データの件数 | 学習後の1成分の値 | 平均に使う重み | 重みを掛けた値 |
|---|---|---|---|---|
| A | 100 | 2 | 100 ÷ 400 = 0.25 | 0.25 × 2 = 0.5 |
| B | 200 | 4 | 200 ÷ 400 = 0.50 | 0.50 × 4 = 2.0 |
| C | 100 | 8 | 100 ÷ 400 = 0.25 | 0.25 × 8 = 2.0 |
合計は400件です。集約後の値は、次のようになります。
(100 × 2 + 200 × 4 + 100 × 8) ÷ 400 = (200 + 800 + 800) ÷ 400 = 4.5
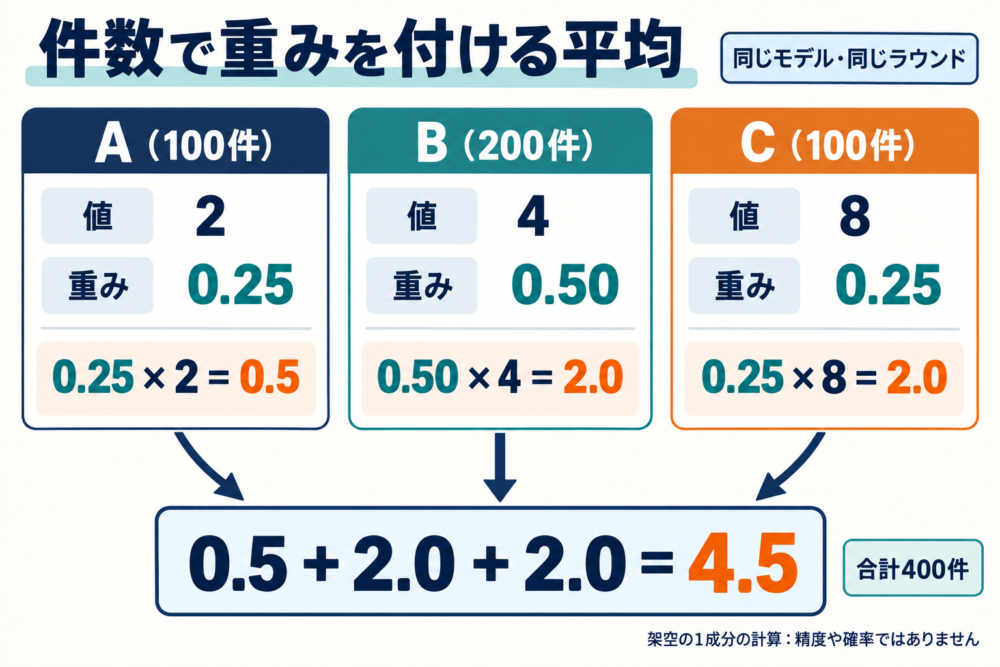
*本文の架空計算を図示。同じモデルの1成分の値であり、精度や確率ではありません。*
拠点を均等に扱った単純平均は、(2 + 4 + 8) ÷ 3 ≈ 4.67です。この例の4.5との違いは、Bのデータ件数がAやCの2倍あることによります。平均する基準が「参加者1つを同じ重さにするか」「データ1件を同じ重さにするか」で変わります。件数の重みは、各拠点のデータ品質や、拠点間の利益の公平さまで表すものではありません。
ここで平均したのは、モデル内部の対応する数値です。4.5は精度でも、不良品である確率でもありません。 また、別々の設計・初期値で独立に作ったモデルなら、数値を混ぜるだけで同じように機能するとは限りません。
この計算は、原論文のFedAvgを理解するため、全拠点参加の場合に絞ったものです。実際には参加者の選び方、脱落時の扱い、集約の重みも学習設計に含まれます。
「水平・垂直」と「端末・組織」は別の分類
連合学習の種類を読むときは、何を分類しているかを見ると整理できます。水平・垂直は主にデータの持ち方、クロスデバイス・クロスサイロは参加者の構成に関する区別です。
| 分類の軸 | 種類 | 典型的なデータ・参加者 | 設計上の違い |
|---|---|---|---|
| データの持ち方 | 水平連合学習 | 同じ項目を持つが、対象となる人・製品などが異なる | 共通の項目・モデルで局所学習しやすい。今回の工場例はこれに当たる |
| データの持ち方 | 垂直連合学習 | 重なる対象について、参加者が異なる項目を持つ | 対象の対応付けや、異なる情報を連携する手順が必要 |
| 参加者の構成 | クロスデバイス | 多数のスマートフォンなど | 接続、電池、参加できる時刻などの変動を扱う |
| 参加者の構成 | クロスサイロ | 複数の企業・病院などの組織 | 組織間の学習条件や運用責任を調整する |
たとえば、複数企業が同じ検査項目を使う場合は「水平」かつ「クロスサイロ」と整理できます。垂直連合学習では参加者の持つ項目が異なるため、先ほどの同一モデルの平均をそのまま当てはめることはできません。NEC技報:連合学習の基本方式、Kairouzら:Advances and Open Problems in Federated Learning
生データを送らなくても、保護対策は必要
更新情報は学習データから計算されるので、元のデータについての手掛かりを含むことがあります。Zhuらの研究では、共有された勾配(モデルの数値をどの方向へ調整するかを示す情報)から、画像や文章を復元できる場合が示されました。これは、すべての連合学習で常に完全復元できるという意味ではなく、更新情報を無条件に安全とは扱えない根拠です。Deep Leakage from Gradients
保護対策も、対象ごとに分けて考えます。
| 対策 | 主に守る対象 | それだけでは決まらないこと |
|---|---|---|
| 通信の暗号化 | 経路上での盗み見 | 正規の受信先が読める更新情報からの推測 |
| セキュア集約(個別入力を隠して集計する仕組み) | サーバーに個々の参加者の更新をそのまま見せないこと | 集約結果や完成モデルから得られる情報。参加者数・脱落・結託などの前提も確認が必要 |
| 差分プライバシー(特定の個人などのデータの有無による出力の違いを確率的に抑える保証) | 定義した保護単位についての情報漏えい | 保護の強さ、ノイズによる精度への影響、誰を信頼する設計か |
セキュア集約は個別の入力を隠して集約結果を得るための技術です。差分プライバシーは、たとえば更新の影響を制限して適切なノイズを加えるなど、出力から得られる情報を抑えるために使います。両者は目的が異なり、組み合わせる設計もあります。Bonawitzら:Practical Secure Aggregation、Kairouzら:プライバシーの論点
機密データを扱う計画では、誰に何を見せないのかを先に決める必要があります。連合学習を採用したという理由だけで、必要な保護や運用条件を満たしたと判断することはできません。
通信とデータの偏りが、使い勝手を左右する
生データを送らなくても、通信は繰り返す
連合学習では、モデルの配布と更新情報の回収を繰り返します。そのため、通信量はモデルの大きさ、参加する拠点数、ラウンド数、圧縮や保護の方法に左右されます。生データを集めないことから、通信費が必ず小さくなるとは結論できません。
各拠点にも学習するための計算環境が必要です。遅い拠点や一時的に参加できない端末がある場合、どこまで待つか、どの更新を採用するかも運用に関わります。
同じ件数でも、データの中身は違う
工場Aは製品Xが中心、BはXとYが混在、CはYが中心だったとします。このように参加者ごとにデータの傾向が異なる状態は、非IID(独立・同一分布という仮定が成り立たない状態)の問題として扱われます。
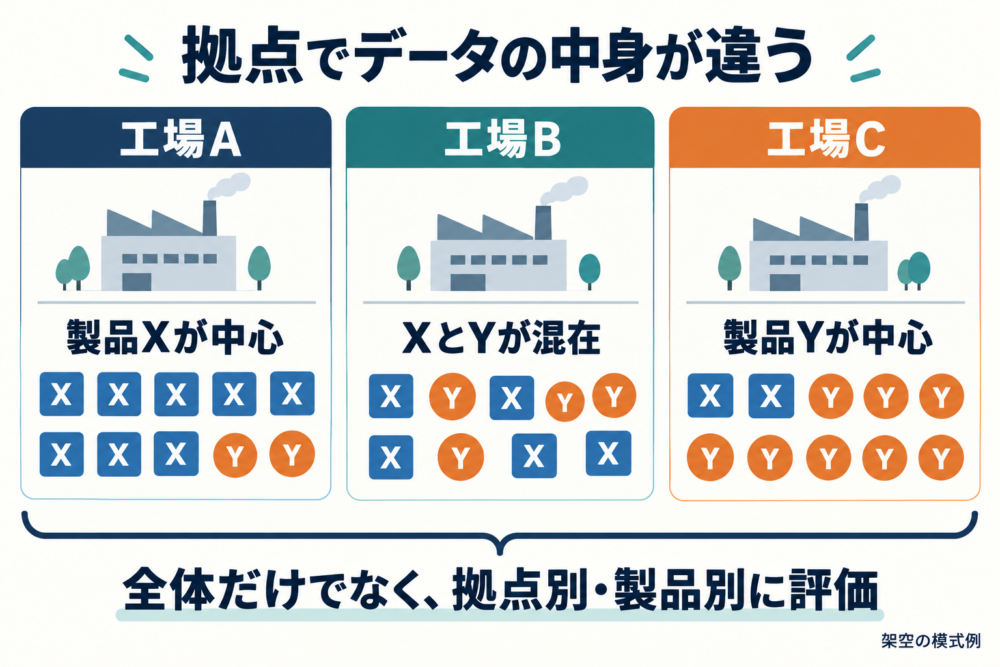
*非IIDの概念を架空の製品構成で示した独自の模式例。図中の個数は実データの割合ではありません。*
件数による加重平均だけでは、その違いが解消されたとは判断できません。全体の評価が良くなっても、ある工場で扱う製品の不良を見逃すようになれば、その工場には使いにくいモデルです。
そのため、共通モデルを全体で評価するだけでなく、拠点別・製品別にも確かめる必要があります。共通モデルを各拠点向けに調整する方法もありますが、何を共有し、どこを個別化するかという設計が増えます。データの分布差と個別化の関係は、Kairouzらの連合学習サーベイで整理されています。
通信、プライバシー、悪意ある更新、個別化は別々の課題です。たとえば参加者が誤った更新を送る問題は、通信を暗号化するだけでは防げません。参加者の管理や更新の検査も含めて検討します。NTTデータ数理システム:連合学習の課題
導入前は、単独学習との差を拠点別に確かめる
連合学習は、生データの集中を避けながら共同学習したい場合の選択肢です。実際に採用する価値があるかは、各拠点が単独で学習する場合と、運用の負担も含めて比べると判断しやすくなります。
ここまでの制約を踏まえ、本記事では小規模な試行で次の項目を確認することを勧めます。
| 確認項目 | 工場例での確認方法 | 判断への使い方 |
|---|---|---|
| 学習したい課題 | 不良品の定義、画像形式、検査条件を拠点間で確認する | 同じモデルを共同で学習できる前提があるか |
| 比較の基準 | 各拠点の単独学習モデルと連合学習モデルを、学習に使っていない同一の評価データで比べる | 評価条件の違いを効果と取り違えない |
| 拠点ごとの結果 | 全体の精度に加え、工場別・製品別の見逃しと誤検出を見る | 利益や不利益が一部へ偏っていないか |
| 運用負担 | 学習時間、送受信量、参加できなかった拠点を記録する | 精度の変化に見合う負担か |
| 共有・保護の範囲 | 更新情報、集約結果、ログを誰が見られるか確認する | 必要な保護対策が設計されているか |
| 共同運用の取り決め | モデルの利用範囲、更新失敗時の扱い、参加終了時の対応を決める | 継続して共同学習を運用できるか |
採否の基準は試行の前に決めます。たとえば「全体の精度だけで合格にせず、どの工場でも見逃しが許容範囲に収まること」を条件にすると、平均値の改善に隠れた問題を確認できます。
最初に押さえたいのは、手元に残すデータ、外へ送る更新情報、集約後に評価するモデルの3つです。これらを分けると、連合学習で解決できる問題と、保護・通信・精度の面で別に確かめるべきことが見えてきます。
コメント