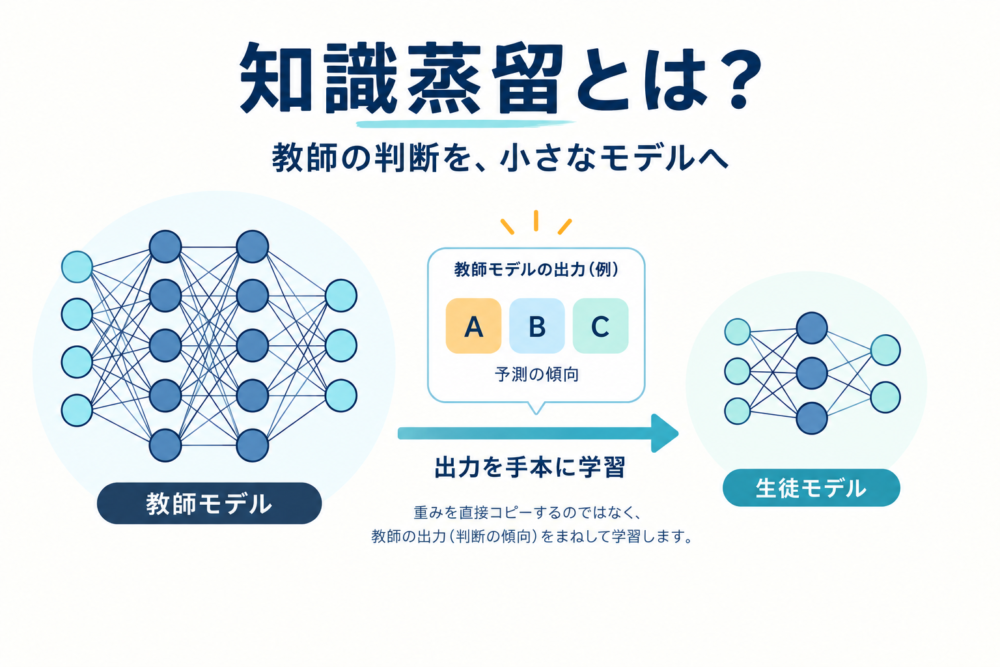
知識蒸留(Knowledge Distillation)は、教師モデルの出力などを手本に、生徒モデルを学習させる方法です。小型化に使う場合は、配備したい小さなモデルを生徒として用意し、大きな教師の判断を学習に利用します。量子化が数値の表し方を変えるのに対し、蒸留は生徒の学習方法を工夫する点が違います。
ここでは、猫・犬・車を分類する架空の例を使い、何を教師から受け取るのか、温度を変えると確率がどう変わるのかを追います。最後に、量子化・プルーニングとの使い分けと、効果を確かめるための比較条件を整理します。
知識蒸留とは?教師の振る舞いを生徒の学習に使う
教師モデルは学習の手本を出すモデル、生徒モデルはその手本から学ぶモデルです。「知識を移す」といっても、教師の重み(学習で調整された内部の数値)をそのままコピーする必要はありません。入力に対してどのような出力を返すかを学習目標にすれば、異なる構造のモデルにも、その振る舞いを近づけられます。
Hintonらの論文「Distilling the Knowledge in a Neural Network」は、大きなモデルや複数モデルの組み合わせが持つ予測の情報を、配備しやすいモデルへ移す方法を説明しています。本記事では、学習済みの教師を固定するオフライン蒸留の基本形を扱います。
学習には教師を使い、推論には生徒を使う
学習時には、同じ分類対象を教師と生徒へ入力します。教師の予測を手本にして生徒の出力との差を計算し、生徒の重みを更新します。教師側は固定しておくため、この段階で教師自身を学び直させる処理はありません。
学習後の推論(新しい入力に対して予測を返す処理)には、生徒を使います。生徒だけを配備するこの構成では教師を毎回呼び出す必要がなく、小さい生徒を選ぶことが実行時の負担を減らす出発点になります。Keras公式の蒸留例も、学習では教師の出力を参照し、呼び出し時には生徒の出力を返す構成です。
| 段階 | 教師モデルの役割 | 生徒モデルの役割 |
|---|---|---|
| 蒸留の学習 | 固定した重みで手本を出す | 手本や正解と比較し、重みを更新する |
| 学習後の推論 | この基本形では呼び出さない | 新しい入力を受けて予測する |
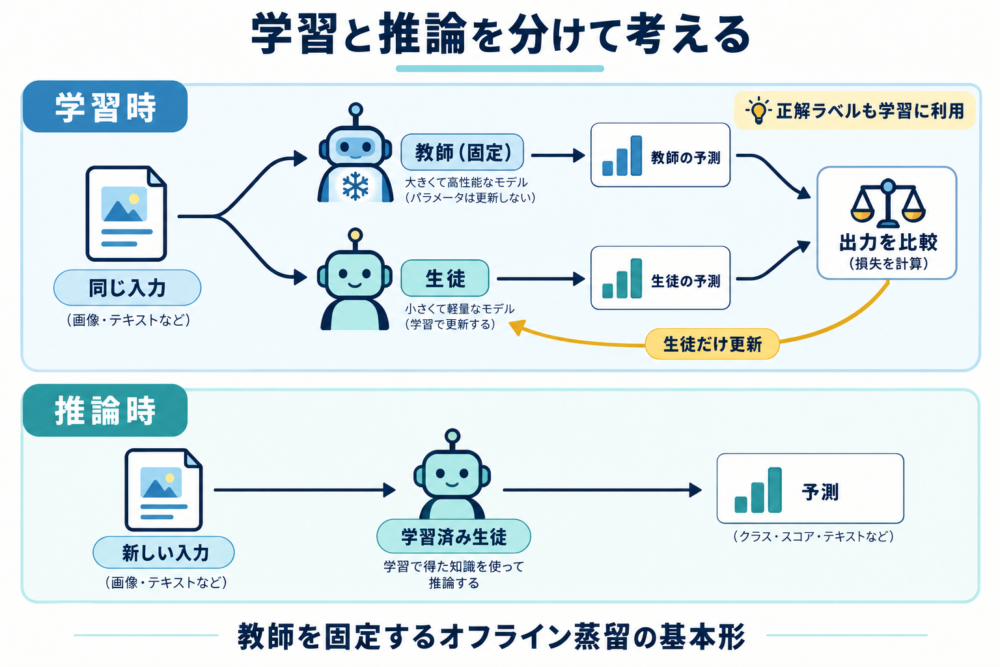
図:教師を固定するオフライン蒸留の基本形を示した独自の模式図。
蒸留という名前だけで、小型化の程度までは決まりません。生徒をどの構造・大きさにするかと、その生徒をどう学習させるかは、分けて考える必要があります。
正解ラベルだけでは伝わらない、教師の確率
猫の画像に「猫」という正解を付けると、3クラスの学習目標は「猫1、犬0、車0」と表せます。これがハードラベル(正解を一つに決めたラベル)です。
一方、教師の予測には、猫以外の選択肢にも値があります。例えば次のような確率を考えます。数値は説明用の架空例で、実際のモデルを測定した結果ではありません。
| 学習の手本 | 猫 | 犬 | 車 |
|---|---|---|---|
| 正解のハードラベル | 100% | 0% | 0% |
| 教師の予測確率 | 約66.5% | 約24.5% | 約9.0% |
ハードラベルから分かるのは正解が猫だということです。教師の確率には、それに加えて「この入力では、車より犬に高い値を付ける」という判断の傾向が残っています。このような確率分布を学習の目標にしたものを、ソフトターゲットと呼びます。
PyTorch公式の蒸留チュートリアルも、最大の予測だけでなく、出力分布全体に含まれる情報を使う考え方を説明しています。生徒は「猫と答える」だけでなく、他の候補との関係も手本にできます。
この値は教師の判断です。犬の24.5%が、現実の正しさや安全性を保証する数字になるわけではありません。教師の誤りや偏りも学習目標に入り得るため、教師との一致と、実際の課題で正しいことは別々に確認します。
温度を変えると、学習の手本はどう変わるか
ソフトターゲットを作る際には、温度という係数Tを使うことがあります。温度は物理的な熱ではなく、出力の確率をどれほどなだらかにするかを調整する数値です。
計算の出発点はロジット(確率へ変換する前のスコア)です。各ロジットをTで割り、指数関数を適用してから、全クラスの合計で割ります。この変換がsoftmax(複数のスコアを合計1の確率へ変換する関数)です。原論文の式1では、クラスiの確率を次の形で表しています。
クラスiの確率 = exp(ロジットi ÷ T) ÷ 全クラスのexp(ロジット ÷ T)の合計
expは自然指数関数です。ここでは、猫・犬・車のロジットをそれぞれ2・1・0と置きます。T=1で計算した結果が、先ほどの約66.5%・24.5%・9.0%です。
| 計算段階 | T=1 | T=2 |
|---|---|---|
| ロジットをTで割る | 2、1、0 | 1、0.5、0 |
| expを計算する | 約7.389、2.718、1.000 | 約2.718、1.649、1.000 |
| 合計 | 約11.107 | 約5.367 |
| 各値を合計で割る | 約66.5%、24.5%、9.0% | 約50.6%、30.7%、18.6% |
T=2の猫の確率なら、2.718 ÷ 5.367 ≒ 0.506です。丸める前の値で計算しているため、表の表示値だけで再計算すると末尾に差が出ます。百分率の合計も、丸めにより100%からわずかにずれることがあります。
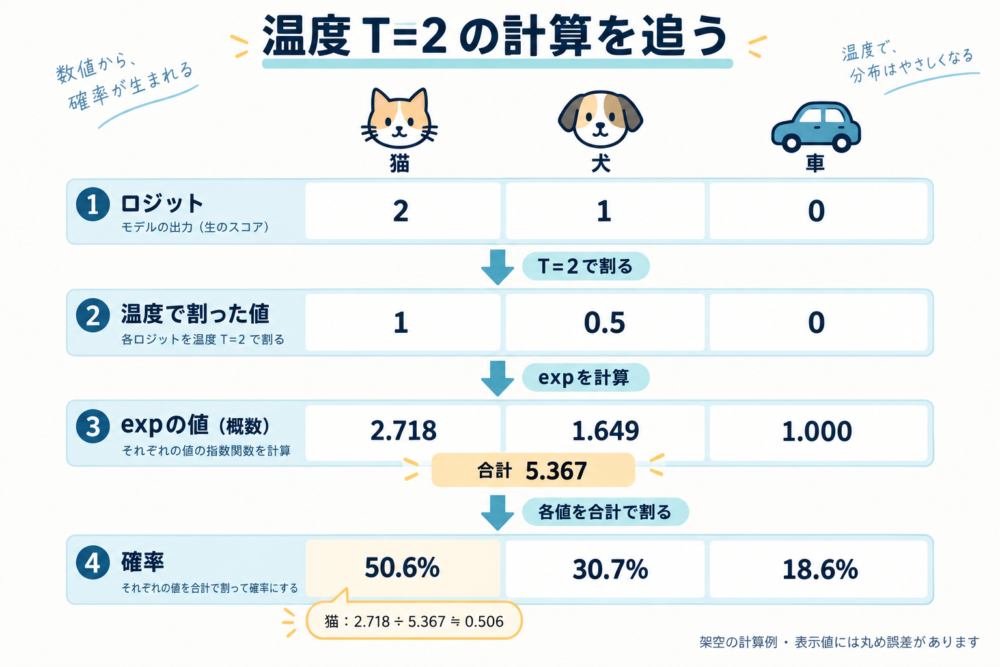
図:架空のロジットから確率を求める計算例。表示値には丸め誤差があります。
温度を上げると、この例では猫への集中が弱まり、犬や車にも確率が広がります。順位は猫・犬・車のままです。これは教師を再学習した結果ではなく、同じロジットを別の温度で変換した結果です。
蒸留で分布を比較するときは、教師だけでなく生徒にも同じ温度を適用します。温度を高くすれば精度が必ず上がるわけではないため、値は検証用データで選びます。本記事のT=2は計算を追うための設定です。原論文の基本形では、学習後の推論はT=1で行います。
生徒は「正解」と「教師」の両方に近づく
確率を作っただけでは、生徒は変わりません。次に必要なのが損失(学習で小さくしたい予測のずれ)です。正解ラベルがある場合は、次の二つを組み合わせる構成が使えます。
| 損失の項目 | 比べるもの | 役割 |
|---|---|---|
| 正解ラベルに対する項 | 生徒の予測と正解 | 課題の正解へ近づける |
| 蒸留の項 | 同じ温度で計算した教師と生徒の分布 | 教師の判断の傾向へ近づける |
Keras公式例では、前者をα、後者を1−αの比重で組み合わせています。蒸留側には、分布のずれを測るKLダイバージェンスを使い、温度による勾配の大きさの変化を補うためT²を掛けています。勾配は、重みをどちらへ調整するかを決めるための量です。
全体の損失 = α × 正解ラベルの損失 + (1−α) × T² × 蒸留の損失
この式のαは、正解ラベル側の比重です。資料によってαを掛ける側が異なることがあるので、記号だけで設定値を比べず、どちらの項を重くしているかを確認します。計算後に更新するのは生徒の重みであり、教師は固定したままです。出典:Keras公式例
出力分布を合わせる方法のほかに、中間層の特徴(モデル内部で作る表現)を学習に使う方式もあります。PyTorch公式例では、それらを別の損失として扱っています。蒸留すべてが上の一つの式になるわけではありません。
量子化・プルーニングとの違い
モデルの軽量化では、何を変えるかを比較すると混同しにくくなります。
| 手法 | 主に変えるもの | 学習との関係 | 利点と引き換えになる条件 |
|---|---|---|---|
| 知識蒸留 | 生徒の学習目標。教師の出力などを利用する | 生徒の学習が必要 | 生徒の構造を選べる一方、教師の実行や学習の費用がかかる |
| 量子化 | 重みや中間計算の数値表現。低いビット数などにする | 学習後に変換する方式と、量子化を考慮して学習する方式がある | メモリ削減を狙える一方、誤差と実行環境への適合を確認する |
| プルーニング(枝刈り) | 重みや結合など。不要な部分をゼロ化・削減する | 方式によって再学習や調整を行う | 疎な構造などを作れる一方、削り方と実行系の対応が効果を左右する |
TensorFlowの学習後量子化ガイドには、学習済みモデルの数値を低精度へ変換する方式が説明されています。一方、量子化を考慮した学習では、推論時の量子化を学習中に模擬します。そのため「蒸留は学習が必要、量子化は必ず学習不要」と分けると不正確です。
枝刈りでは、重みをゼロにしただけで保存容量や実行時間がその割合だけ減るとは限りません。ゼロの多い数値を効率よく保存・計算できる形式や実行系が必要です。TensorFlowのプルーニング解説も、モデル圧縮と推論時の効果を区別して説明しています。
これらは組み合わせて検討できます。例えば、蒸留で学習した生徒を量子化した場合は、「蒸留まで」と「量子化も加えた後」を分けて評価すると、精度や速度がどの段階で変わったかを追えます。数値表現の仕組みは、LLM量子化の解説で詳しく扱っています。
言語モデルでは、生成した文章を教材にする方式もある
生成AIの「蒸留」を読む際は、生徒に渡しているものも確認したいところです。教師の出力確率を渡す場合と、教師が生成した文章を学習データとして渡す場合では、必要な情報が違います。
| 渡すもの | 生徒の学習に使える情報 | 確認する条件 |
|---|---|---|
| 出力の確率分布 | 候補ごとの確率の違い | 必要な確率が取得でき、教師と生徒の出力項目を対応付けられるか |
| 教師が生成した文章 | 入力に対する回答や文章の系列 | 生成文の品質と、対象用途をカバーするデータか |
Kim・Rushの「Sequence-Level Knowledge Distillation」は、機械翻訳で教師が生成した文章の系列を生徒の学習に使う研究です。本文で扱った3クラスの確率に近づける方法と、生成した文章を教材にする方法を区別する手がかりになります。
生成文だけを受け取った場合、その一文から教師の全候補の確率分布をそのまま得られるわけではありません。どの蒸留方式を実行できるかは、教師から何を取得できるかにも左右されます。モデル・データ・生成出力の利用条件についても、使う提供元ごとに確認が必要です。
蒸留の効果は、同じ生徒モデルとの比較で確かめる
小さいモデルが大きいモデルより速く動いても、その差のすべてを蒸留の効果と考えることはできません。モデル構造を小さくした効果と、教師から学んだ効果を分けるには、蒸留せずに学習した同じ生徒モデルも比較に入れます。
Keras公式例は、生徒と同じ構造のモデルを別に用意し、蒸留あり・なしを比較しています。これを実際の検討へ広げるなら、次の3者を用意する方法が考えられます。
| 比較対象 | この比較で知りたいこと |
|---|---|
| 教師モデル | 元の品質と実行負担はどの程度か |
| 蒸留なしの生徒 | 小さい構造だけで、どこまで解けるか |
| 蒸留ありの生徒 | 同じ構造に教師の手本を加えて、品質がどう変わるか |
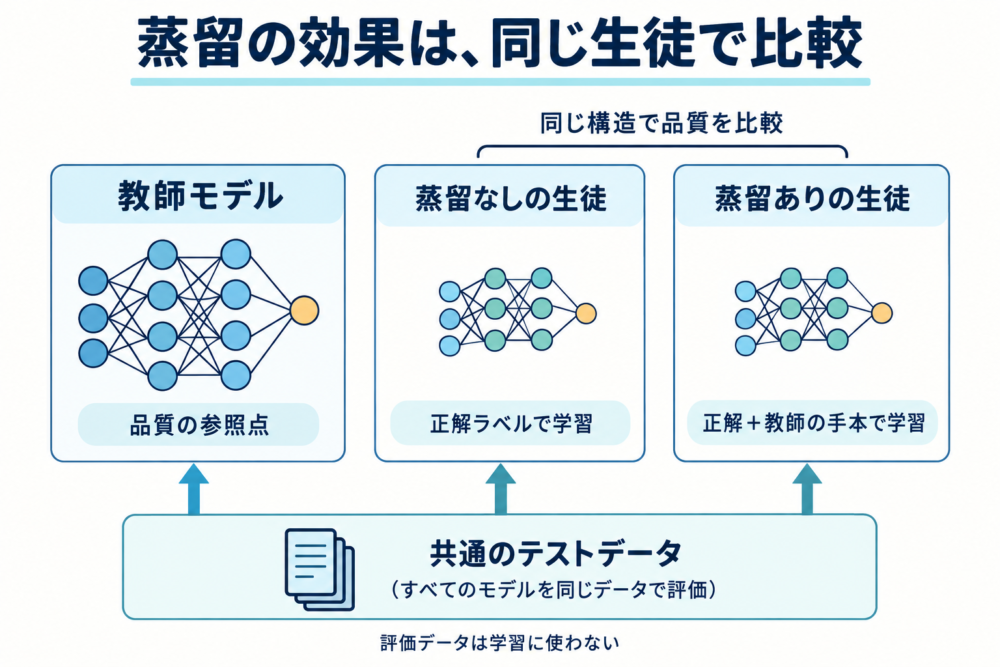
図:蒸留の効果を確認するための比較設計。性能測定の結果を示す図ではありません。
以下は、比較時にそろえる条件と評価項目についての筆者の提案です。ここでモデルの学習や速度測定を実施したわけではありません。
| 観点 | 比較時にそろえる・記録する条件 | 判断したいこと |
|---|---|---|
| 品質 | 学習に使っていない共通の評価データ、前処理、クラス別の成績 | 全体の正解率だけでなく、特定の入力で悪化していないか |
| 学習条件 | 生徒の構造、初期化、データ、学習回数。温度・損失の比重・乱数条件も記録 | 改善が教師の手本によるものか、学習条件の差によるものか |
| 推論速度 | 同じ機器・実行ソフト・入力サイズ・同時処理数 | 配備先で必要な応答時間を満たすか |
| メモリ | モデルファイルの容量と実行中の最大使用量 | 保存できるだけでなく、実際に動かせるか |
| 費用 | 教師の準備・出力生成・生徒の学習・更新時の再実行 | 推論時の節約に対して、導入・維持の負担が見合うか |
温度や損失の比重を選ぶ検証用データと、最後の成績を測るテストデータは分けます。教師の出力に似ているかだけで採用を決めず、使いたい用途の正解・品質基準に照らすことが必要です。
試行を始めるなら、「手元の端末で動く生徒の大きさ」と「許容できる品質低下」を先に決めると比較しやすくなります。その条件で蒸留なしの生徒を評価し、教師の手本を加える価値があるかを確かめる、という順序です。
コメント