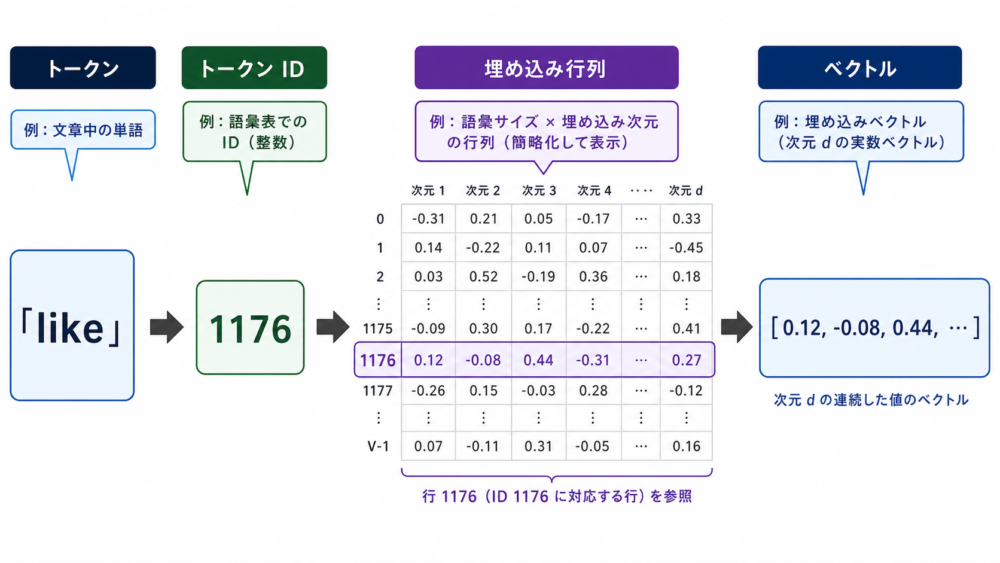
Embedding(埋め込み)とは、単語や文章などのデータを、モデルが計算に使えるベクトル(数値の並び)で表すこと、またはその表現です。文章同士の類似度を比べる検索にも、LLM(大規模言語モデル)の入力処理にも使われます。ただし、token IDをベクトルへ変える入力層と、文章全体を検索用のベクトルへ変えるモデルは、同じものではありません。
この記事では、まずEmbeddingの意味と用途を整理し、その後にBERT原論文を使って入力表現と文脈化の仕組みを説明します。実装例まで読むと、IDに対応するベクトルを取り出す処理が、BERT全体のどの部分なのかを確認できます。
Embeddingは何に使うのか
文字列のままでは、ニューラルネットワークで内積や足し算を行えません。そこで、学習したモデルを使って数値の表現へ変換します。画像などにもEmbeddingはありますが、ここではテキストを扱います。
| 目的 | ベクトル化する対象 | その後に行うこと |
|---|---|---|
| 言語モデルへの入力 | token(テキストを分割した処理単位)のID | 周囲のtokenとの関係を計算する |
| 文分類・抽出 | 文脈を反映したtokenや系列の表現 | 分類器などでタスクに合う出力を得る |
| 類似文検索 | 質問や文章全体 | 比較可能な空間で類似度を計算する |
たとえば「パスワードを忘れた」という質問から「ログイン情報の再設定」という文書を探す用途では、文字列の完全一致だけでなく、学習した表現の近さを利用できます。ただし、どの表現が近くなるかは、モデルの学習目的とデータに依存します。数値に変換するだけで意味検索が完成するわけではありません。
入力Embedding・文脈化表現・文章Embeddingの違い
| 種類 | 作り方 | 何が変わるか | 注意点 |
|---|---|---|---|
| 入力token embedding | token IDに対応する行を行列から取り出す | 学習済みの同じモデルでは、同じIDは同じ行 | この段階では周囲の文を読んでいない |
| 文脈化表現 | BERTなどで入力列全体を処理する | 同じtokenでも周囲の文に応じて表現が変わる | tokenごとの出力が、そのまま文章検索用とは限らない |
| 文章Embedding | 文章をモデルで処理し、用途に合う方法で集約する | 文章全体を比較するベクトルを得る | 学習目的・集約方法・評価対象を確認する |
ここでの「集約」は、複数のtokenの情報を文章単位の表現にまとめることです。Sentence-BERT論文は、事前学習済みBERTを基に、文同士をコサイン類似度で比較できる表現を学習する方法を示しました。BERTの先頭token [CLS] の出力を取り出すことと、検索に適した文章Embeddingを得ることは区別します。
ベクトルの近さをどう比べるのか
コサイン類似度は、2つの非ゼロベクトルの向きがどれくらい近いかを測る指標です。内積をそれぞれの長さで割ります。
計算だけを理解するため、\(a=[1,0]\)、\(b=[0.8,0.6]\)、\(c=[0,1]\)を考えます。これは学習モデルの出力ではなく、説明用に作った値です。
| 比較 | 内積 | ベクトルの長さ | コサイン類似度 |
|---|---|---|---|
| \(a\) と \(b\) | \(1\times0.8+0\times0.6=0.8\) | どちらも1。\(b\)は\(\sqrt{0.8^2+0.6^2}=1\) | \(0.8/(1\times1)=0.8\) |
| \(a\) と \(c\) | \(1\times0+0\times1=0\) | どちらも1 | \(0/(1\times1)=0\) |
この例では、\(b\)の方が\(a\)と近い向きです。実際の文章でも近さを計算できますが、0.8という値を「意味が80%同じ」とは解釈しません。モデルごとに値の分布は異なり、採用する閾値は対象データで評価する必要があります。Sentence Transformersの公式資料では、文章をベクトル化した後に類似度を計算する手順と、コサイン以外の指標も説明されています。
異なるモデルのベクトルは、次元数が同じでも座標の意味がそろっているとは限りません。質問と文書には、そのモデルが指定する対応した変換方法を使います。
入力Embeddingの仕組み:IDから行列の行を取り出す
ここからは、Embeddingのうち、token IDを入力ベクトルへ変換する層を見ます。
日本語では「埋め込み」と訳されます。
表紙のID・数値は説明用の例であり、特定のモデルの実測値ではありません。たとえば、token ID 1176 を [0.12, -0.08, 0.44, ...] のような数値列へ変換します。
この数値列は、単なる番号ではなく、ニューラルネットワークの中で足し算、内積、Attention(入力同士の関係を重み付きで見る仕組み)などの計算に使える表現です。
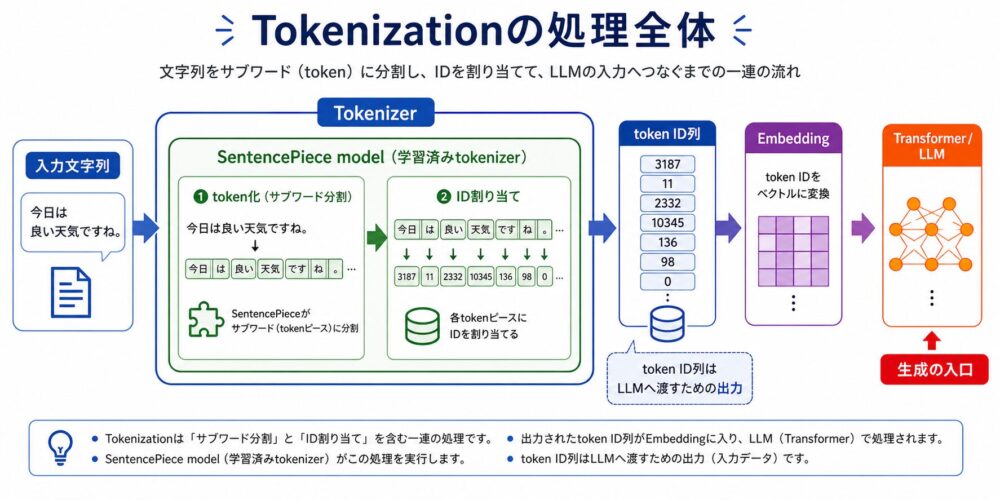
前回のTokenization編では、文章がtoken列とtoken ID列へ変換されるところまで見ました。
しかし、Transformer(Attentionを中心に系列を処理するニューラルネットワーク)は、101 や 7592 のような整数IDを、そのまま意味として理解するわけではありません。
入力層では、各IDに対応するベクトルをEmbedding行列から取り出します。IDの数値の大小そのものが、意味の近さを表すわけではありません。
語彙サイズを \(V\)、Embedding次元を \(H\) とすると、Embedding行列は次の形になります。
token ID \(i\) に対するEmbeddingは、行列 \(E\) の \(i\) 番目の行です。
この \(x_i\) がtokenの初期表現です。BERTでは、さらに位置と文の所属の情報を加えます。
| 表現 | 例 | 役割 |
|---|---|---|
| 文字列 | I like transformers |
人間が読む入力 |
| token | [I, like, transformers] |
tokenizerが作る単位 |
| token ID | [146, 1176, 19081] |
語彙表上の整数 |
| Embedding | [[...], [...], [...]] |
モデルが計算するベクトル |
LLM技術全体の中で見ると、Embeddingは「文字列処理」と「ニューラルネットワーク計算」をつなぐ入口です。
Tokenizationが文章をID列にする処理だとすれば、EmbeddingはそのID列をモデル内部のベクトル空間へ写す処理です。
Embeddingを使うことで、似た使われ方をするtokenが、学習を通じて近い方向のベクトルになりやすくなります。
ただし、Embeddingそのものに最初から人間が解釈できる意味が入っているわけではありません。
大量のテキストで学習する過程で、意味や構文に関係するパターンが重みとして獲得されます。
BERT論文から読み解く
BERT論文は、Embeddingを理解するうえで重要な題材です。
理由は、BERTが単にtoken IDをベクトルに変換するだけでなく、Transformer Encoderを通じて、文脈に応じて変わる表現を作る代表的なモデルだからです。
ここからは、BERT論文の内容を「Embeddingをどう作り、どう文脈化するか」という観点で読み解きます。
論文情報
| 項目 | 内容 |
|---|---|
| 論文タイトル | BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding |
| 著者 | Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova |
| 初版公開日 | 2018年10月11日 |
| 改訂版 | 2019年5月24日 v2 |
| 分野 | Computation and Language |
| arXiv | BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding |
| DOI | 10.48550/arXiv.1810.04805 |
論文概要
BERTは、Bidirectional Encoder Representations from Transformersの略です。
論文では、Transformer Encoderを使い、左右両方の文脈を反映した言語表現を事前学習する方法を提案しています。
BERTをEmbedding解説の題材にする理由は、次の3点です。
| 観点 | BERT論文から分かること |
|---|---|
| 入力表現 | token、文の所属、位置を足し合わせて入力Embeddingを作る |
| 文脈化 | Transformer Encoderによって、同じtokenでも文脈に応じた表現へ変わる |
| 転用 | 事前学習済みモデルを、分類、抽出、質問応答などへFine-tuningする |
つまり、BERTは「Embeddingとは何か」を理解するだけでなく、「EmbeddingがLLM内部でどのように意味を持つ表現へ変わるのか」を理解するための入口になります。
従来技術の課題
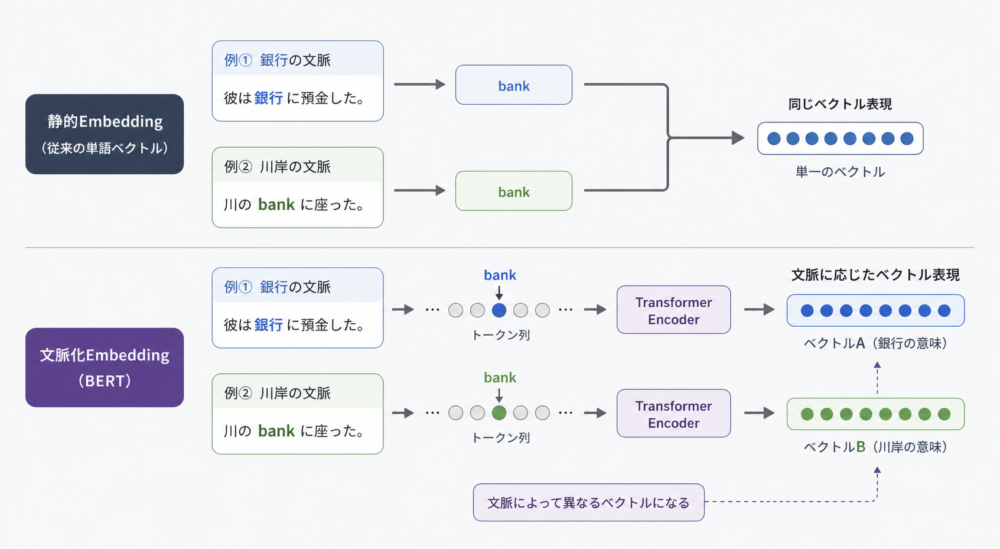
BERT以前にも、word2vecやGloVeのようなEmbedding技術は広く使われていました。
これらは静的Embedding(同じ単語に原則として同じベクトルを割り当てる表現)として有用でした。
しかし、静的Embeddingには、多義語や文脈依存の表現を扱いにくいという課題があります。
たとえば、bank という英単語は「銀行」と「川岸」の意味を持ちます。
静的Embeddingでは、この2つの意味が1つのベクトルに混ざりやすくなります。
I deposited money at the bank.
I sat on the bank of the river.
また、BERT以前の多くの言語モデルは、左から右、または右から左の片方向文脈を使っていました。
そのため、単語の意味を決めるために左右両方の文脈を深く使う設計が難しい、という課題がありました。
| 観点 | 従来技術での課題 | BERTが狙った方向 |
|---|---|---|
| 多義語 | 同じ単語が同じ表現になりやすい | 文脈ごとに表現を変える |
| 文脈 | 片方向の情報に偏りやすい | 左右両方の文脈を見る |
| タスク転用 | タスクごとに特徴量設計が必要 | 事前学習済みモデルをFine-tuningする |
この課題に対して、BERTはMasked Language Modeling(入力の一部を隠して元tokenを予測する事前学習タスク)を使い、双方向文脈を学習できるようにしました。
BERTの入力表現:3種類のEmbeddingを足し合わせる
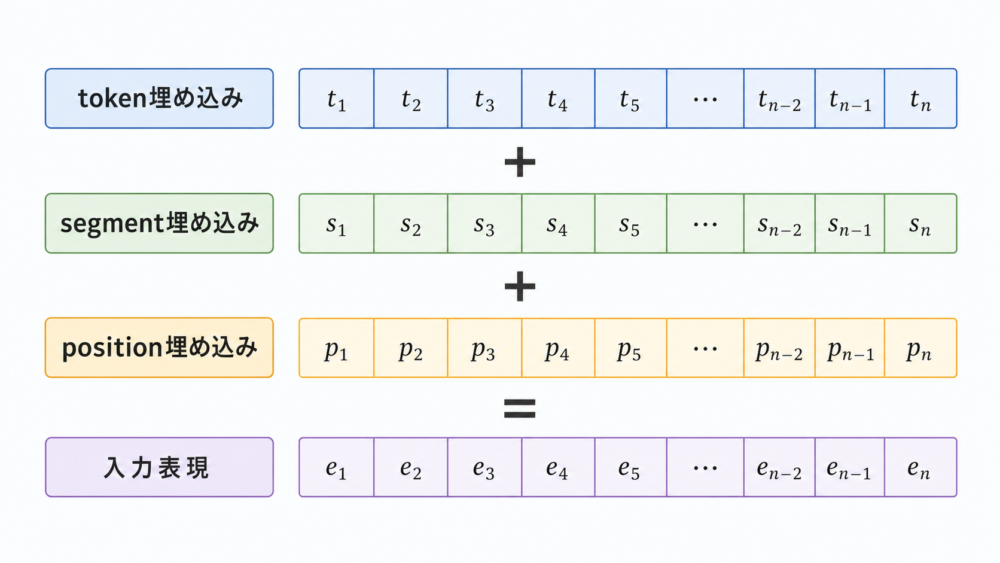
BERT論文で重要なのは、入力表現が単一のtoken embeddingだけではない点です。
各入力位置の表現は、次の3種類のEmbeddingの和として作られます。
ここで、\(t_i\) はtoken ID、\(s_i\) は文A/Bを示すsegment ID、\(i\) は系列内の位置です。式は加算部分を表しており、BERTの公式実装では、この後にLayerNorm(各tokenの特徴量の尺度を整える処理)とdropoutを適用します。
| Embedding | 何を表すか | BERTでの役割 |
|---|---|---|
| token embedding | token IDに対応する初期表現 | WordPiece tokenをベクトル化する |
| segment embedding | tokenが文Aか文Bか | 文ペアタスクやNSPで入力の所属を区別する |
| position embedding | tokenの位置 | Transformerに語順情報を与える |
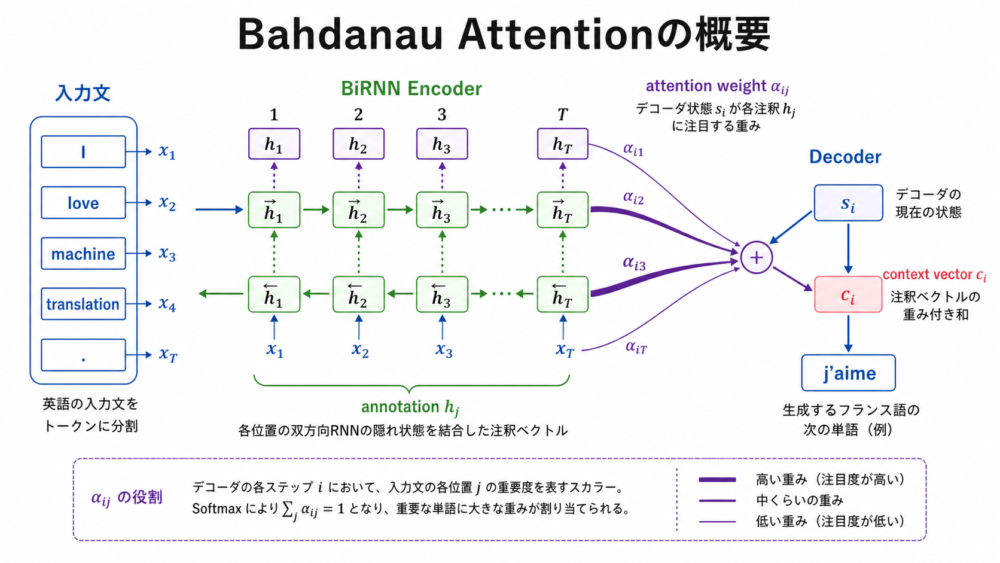
Self-Attentionは、入力同士の関係を計算する強力な仕組みです。
一方で、Attentionだけではtokenの順番を直接持ちません。
そのため、position embeddingを足して、どのtokenが何番目にあるかを伝えます。
WordPieceと特殊tokenで入力列をそろえる
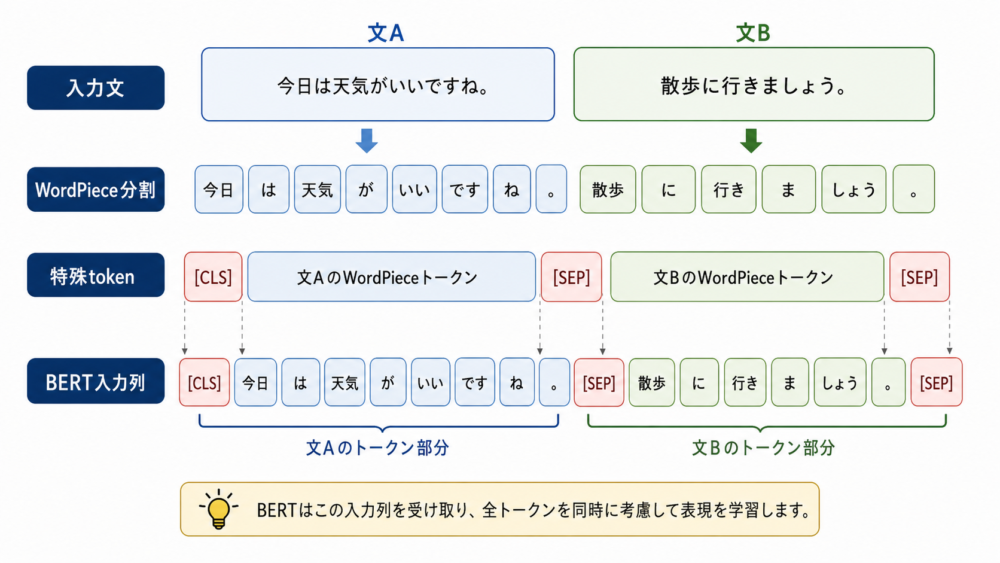
図の日本語の分割は説明用の模式例です。実際の分割はtokenizerの語彙や前処理に依存します。BERT原論文は、WordPiece(単語をサブワードへ分割する方式)を使います。
WordPieceは、未知語を減らしながら語彙サイズを抑えるためのtokenization手法です。
論文では、30,000 tokenの語彙が使われています。
入力には、通常の単語やサブワードだけでなく、特殊tokenも含まれます。
| token | 役割 |
|---|---|
[CLS] |
系列の先頭に置かれ、分類タスクの代表表現として使われる |
[SEP] |
文の区切りや文ペアの境界を示す |
[MASK] |
Masked Language Modelingで予測対象を隠す |
文ペアを入力する場合は、次のような形になります。
[CLS] my dog is cute [SEP] he likes playing [SEP]このとき、前半の文にはsegment A、後半の文にはsegment BのEmbeddingが足されます。
tokens:   [CLS] my dog is cute [SEP] he likes playing [SEP]
segment:    A   A  A   A   A    A    B    B      B     B
position:   0   1  2   3   4    5    6    7      8     9
この3つの情報を足し合わせることで、BERTは「どのtokenか」「どちらの文か」「何番目か」を同時に受け取ります。
Masked Language Modelingで双方向文脈を学ぶ
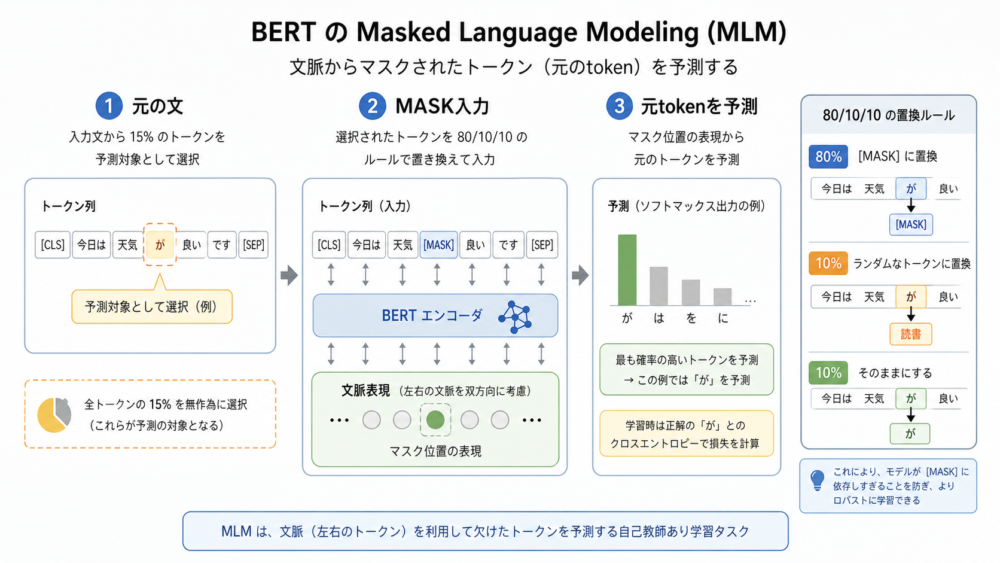
Masked Language Modelingは、BERTの中心的な学習目的です。
BERTはTransformer Encoderを使うため、各tokenが左右両方の文脈を参照できます。
双方向に参照できるモデルで、入力を変えずに各位置の元tokenを予測すると、正解そのものを参照できてしまいます。
そこでBERTは、入力tokenの一部を隠し、その元tokenを当てるように学習します。
論文では、入力tokenの15%を予測対象にします。
ただし、選ばれたtokenをすべて [MASK] に置き換えるわけではありません。
| 選ばれたtokenの処理 | 割合 | 狙い |
|---|---|---|
[MASK] に置換 |
80% | 予測対象を明示的に隠す |
| ランダムtokenに置換 | 10% | 入力のノイズに頑健にする |
| そのまま残す | 10% | [MASK] がFine-tuning時に出ない差を緩和する |
損失は、予測対象になった位置だけで計算します。
\(M\) は予測対象位置の集合、\(\tilde{x}\) は80/10/10の規則を適用した入力です。選ばれても元のtokenを残す場合があります。
この学習により、各tokenの表現は周囲の文脈を使って意味を補う方向へ調整されます。
Next Sentence Predictionで文ペア関係を学ぶ
BERT論文では、Masked Language Modelingに加えて、Next Sentence Prediction(2つの文が連続しているかを判定する事前学習タスク)も使われています。
入力は文Aと文Bのペアです。
50%は実際に連続する文、50%はランダムに選んだ文Bです。
モデルは [CLS] の最終表現を使い、文Bが文Aの次に来るかを分類します。
| 学習目的 | 単位 | 何を学ばせたいか |
|---|---|---|
| MLM | token | 文脈から欠けた語を補う |
| NSP | 文ペア | 2文の関係を判定する |
ここで説明したのは原論文のBERTの学習設計です。Embedding一般の必須条件ではありません。
文脈化Embeddingとして下流タスクへ転用する
BERTの価値は、事前学習済みの文脈化表現を下流タスクへ転用できる点にあります。
論文では、タスクごとに大きな専用モデルを作るのではなく、BERT本体を初期化に使い、最後に小さな出力層を足してFine-tuning(事前学習済みモデルを特定タスクに追加学習すること)します。
| タスク | 使う表現 | 例 |
|---|---|---|
| 文分類 | [CLS] の最終表現 |
感情分類、自然言語推論 |
| token分類 | 各tokenの最終表現 | 固有表現抽出 |
| 質問応答 | 各tokenの開始/終了スコア | SQuAD形式の抽出型QA |
注意点として、BERTの [CLS] 表現をそのまま汎用のsentence embeddingとして使うと、用途によっては期待ほど強くない場合があります。
文検索は上表の原論文のタスクと分けて考えます。Sentence-BERTは、文同士の類似度を計算するために調整した表現の例です。
BERTが文脈化表現を作れても、検索精度は対象データで別途評価します。
実験結果
BERT論文では、GLUE、MultiNLI、SQuADなど、複数の自然言語理解タスクで当時のstate-of-the-art(当時最高水準)を更新したと報告されています。
arXiv概要では、GLUE score 80.5%、MultiNLI accuracy 86.7%、SQuAD v1.1 Test F1 93.2、SQuAD v2.0 Test F1 83.1が示されています。
| 評価 | 論文で示された結果の意味 |
|---|---|
| GLUE | 文分類や含意認識など複数タスクの総合評価 |
| MultiNLI | 文ペアの自然言語推論性能 |
| SQuAD v1.1 | 抽出型質問応答で答え範囲を当てる性能 |
| SQuAD v2.0 | 答えが存在しない質問も含む質問応答性能 |
この結果は、BERTの文脈化Embeddingが単独の特徴量として便利というだけでなく、Fine-tuningによって幅広いNLPタスクへ適応できることを示しています。
ただし、2018年当時の比較であり、現在の生成LLMの性能を直接比較するものではありません。
BERTは、入力全体を処理するEncoder型モデルです。ここで紹介した評価は分類・推論・抽出のタスクであり、対話文生成の評価ではありません。
実装者視点で見るEmbedding
実装では、Embeddingは巨大な行列です。
語彙サイズ \(V\) と隠れ次元 \(H\) が大きくなるほど、Embedding層のパラメータ数も増えます。
語彙サイズを30,000、隠れ次元をBERT Baseの768とした概算では、\(30,000\times768=23,040,000\)、約2,300万パラメータです。実際のチェックポイントの語彙サイズで値は変わります。
これはモデル全体の中でも無視できないサイズです。
| 設計項目 | 実装上の注意 |
|---|---|
| 語彙サイズ | 大きいほどEmbedding行列が重くなる |
| 位置長 | 最大系列長を超える入力は切り詰めや分割が必要 |
| segment ID | 単文タスクではすべて0にする実装が多い |
| padding | attention maskと合わせて扱う必要がある |
| weight tying | 出力層とEmbeddingを共有する設計もある |
Embeddingの差し替えは、tokenizerの差し替えと強く結びつきます。
token IDとEmbedding行列の行が対応しているため、tokenizerだけ変えると、同じIDが別のtokenを指してしまう可能性があります。
Fine-tuning済みモデルでは、tokenizer、Embedding、出力層をセットで管理する必要があります。
実装例:BERT風の入力Embeddingを作る
以下は、BERT風にtoken embedding、segment embedding、position embeddingを足し合わせる最小例です。
例はPyTorchを利用し、LayerNormとdropout(学習中に一部の値を落とす処理)も含めています。重みは新規初期化され、Transformer Encoderも学習済み重みもありません。文章の意味検索に使える出力を得るコードではなく、入力層の形を理解するための例です。
import logging

import torch
from torch import Tensor, nn

logger = logging.getLogger(__name__)


class BertStyleInputEmbedding(nn.Module):
    """Build BERT-style input embeddings from token, segment, and position IDs.

    Args:
        vocab_size: Number of tokens in the tokenizer vocabulary.
        hidden_size: Embedding dimension used by the Transformer encoder.
        max_position_embeddings: Maximum sequence length supported by the model.
        segment_vocab_size: Number of segment IDs. BERT uses two for sentence A/B.

    Returns:
        A module that maps ID tensors to summed embedding tensors.

    Raises:
        ValueError: If one of the size arguments is not positive.

    Examples:
        >>> module = BertStyleInputEmbedding(30522, 768, 512, 2)
        >>> token_ids = torch.tensor([[101, 2023, 2003, 102]])
        >>> segment_ids = torch.zeros_like(token_ids)
        >>> module(token_ids, segment_ids).shape
        torch.Size([1, 4, 768])
    """

    def __init__(
        self,
        vocab_size: int,
        hidden_size: int,
        max_position_embeddings: int,
        segment_vocab_size: int = 2,
    ) -> None:
        """Initialize layers.

        Args: vocab_size, hidden_size, max_position_embeddings, segment_vocab_size: Positive sizes.
        Returns: None.
        Raises: ValueError for nonpositive sizes.
        Example: BertStyleInputEmbedding(100, 16, 32).
        """
        super().__init__()
        if vocab_size <= 0:
            raise ValueError("vocab_size must be positive")
        if hidden_size <= 0:
            raise ValueError("hidden_size must be positive")
        if max_position_embeddings <= 0:
            raise ValueError("max_position_embeddings must be positive")
        if segment_vocab_size <= 0:
            raise ValueError("segment_vocab_size must be positive")

        self.token_embeddings = nn.Embedding(vocab_size, hidden_size)
        self.segment_embeddings = nn.Embedding(segment_vocab_size, hidden_size)
        self.position_embeddings = nn.Embedding(max_position_embeddings, hidden_size)
        self.layer_norm = nn.LayerNorm(hidden_size)
        self.dropout = nn.Dropout(0.1)

    def forward(self, token_ids: Tensor, segment_ids: Tensor | None = None) -> Tensor:
        """Return summed BERT-style embeddings.

        Args:
            token_ids: Tensor shaped `(batch, seq_len)` containing tokenizer IDs.
            segment_ids: Optional tensor shaped like `token_ids`. If omitted, all tokens use segment 0.

        Returns:
            Tensor shaped `(batch, seq_len, hidden_size)`.

        Raises:
            ValueError: If dimensions, segment shape, or maximum sequence length are invalid.
            IndexError: If token or segment IDs are outside the embedding tables.
            RuntimeError: If tensor dtype or device is incompatible.

        Examples:
            >>> module = BertStyleInputEmbedding(100, 16, 32)
            >>> ids = torch.tensor([[1, 2, 3]])
            >>> module(ids).shape
            torch.Size([1, 3, 16])
        """
        if token_ids.ndim != 2:
            raise ValueError("token_ids must have shape (batch, seq_len)")

        batch_size, seq_len = token_ids.shape
        if seq_len > self.position_embeddings.num_embeddings:
            raise ValueError("sequence exceeds max_position_embeddings")
        if segment_ids is None:
            segment_ids = torch.zeros_like(token_ids)
        if segment_ids.shape != token_ids.shape:
            raise ValueError("segment_ids must have the same shape as token_ids")

        position_ids = torch.arange(seq_len, device=token_ids.device).unsqueeze(0)
        position_ids = position_ids.expand(batch_size, seq_len)

        logger.debug("build embeddings: batch=%d seq_len=%d", batch_size, seq_len)
        # BERTの入力仕様にそろえるため、3種類のID情報を同じhidden_sizeで加算する。
        embeddings = (
            self.token_embeddings(token_ids)
            + self.segment_embeddings(segment_ids)
            + self.position_embeddings(position_ids)
        )
        logger.info("created input embeddings: shape=%s", tuple(embeddings.shape))
        return self.dropout(self.layer_norm(embeddings))
よくある誤解
| 誤解 | 正確な情報・解釈 |
|---|---|
| Embeddingは単語の意味そのものを保存した辞書である | Embeddingは学習で得られるベクトル表現であり、意味は文脈とタスクを通じて現れる |
| token embeddingだけ見ればBERTの理解が分かる | BERTで重要なのはTransformer層を通った後の文脈化表現 |
[CLS] は常に最高のsentence embeddingである |
分類には便利だが、類似度検索では専用に学習されたモデルが有利なことが多い |
| position embeddingは補助的なので不要 | Self-Attentionだけでは語順を直接区別しにくいため、位置情報が必要 |
| BERTはGPTと同じように文章生成が得意 | BERTはEncoder型で、主に理解・分類・抽出に向く |
Embeddingを理解するときは、「IDをベクトルへ変換する入力層」と「Transformerを通った後の文脈化表現」を分けることが大切です。
この2つを混ぜてしまうと、BERTの強みや、検索Embeddingとして使うときの注意点を誤解しやすくなります。
使うときの注意点と限界
BERTは、自然言語理解タスクに大きな影響を与えたモデルです。
一方で、現在のLLMの文脈で見ると、いくつかの限界があります。
| 限界点 | 内容 | 実務での影響 |
|---|---|---|
| 生成が主目的ではない | BERTはEncoder型で、次tokenを逐次生成する設計ではない | ChatGPTのような対話生成にはDecoder型やEncoder-Decoder型が使われやすい |
| 長文処理が重い | Self-Attentionの計算量は系列長に対して大きくなりやすい | 長い文書をそのまま入力しにくい |
[CLS] が万能ではない |
分類には便利だが、検索や類似度では専用学習が必要な場合がある | RAGや文書検索ではSentence-BERT系などを検討する |
| tokenizerとEmbeddingが固定される | 語彙を変えるとEmbedding行列との対応が崩れる | ドメイン追加や多言語対応で再学習・追加学習が必要になる |
| メモリ消費が大きい | Embedding行列やTransformer層がパラメータを持つ | エッジデバイスや組み込み機器では搭載が難しい |
ハードウェア搭載を考えると、Embedding層だけでも無視できないサイズになります。
BERT Baseでは、token embeddingだけで約2,300万パラメータになります。
さらに、推論時には中間activation(層の途中で保持する計算結果)やattention maskも必要です。
スマートフォン、カメラ、車載機器のようなメモリと電力が限られる環境では、モデルサイズ、最大系列長、推論遅延、消費電力を同時に考える必要があります。
関連技術
| 技術 | Embeddingとの関係 |
|---|---|
| Tokenization | 文字列をtoken IDに変換し、Embeddingの入力を作る |
| Positional Encoding | tokenの順序を表す情報を追加する |
| Self-Attention | Embedding同士の関係を計算し、文脈化表現を作る |
| Sentence-BERT | BERTを文類似度・検索向けに調整する |
| Dense Retrieval | 文書や質問をベクトル化して近傍検索する |
Embeddingは単独の技術ではなく、Tokenization、Attention、Transformer、検索システムとつながっています。
特にRAG(検索で外部文書を補う生成方式)では、質問と文書をどのようなEmbedding空間へ写すかが、検索精度に直接影響します。
コメント