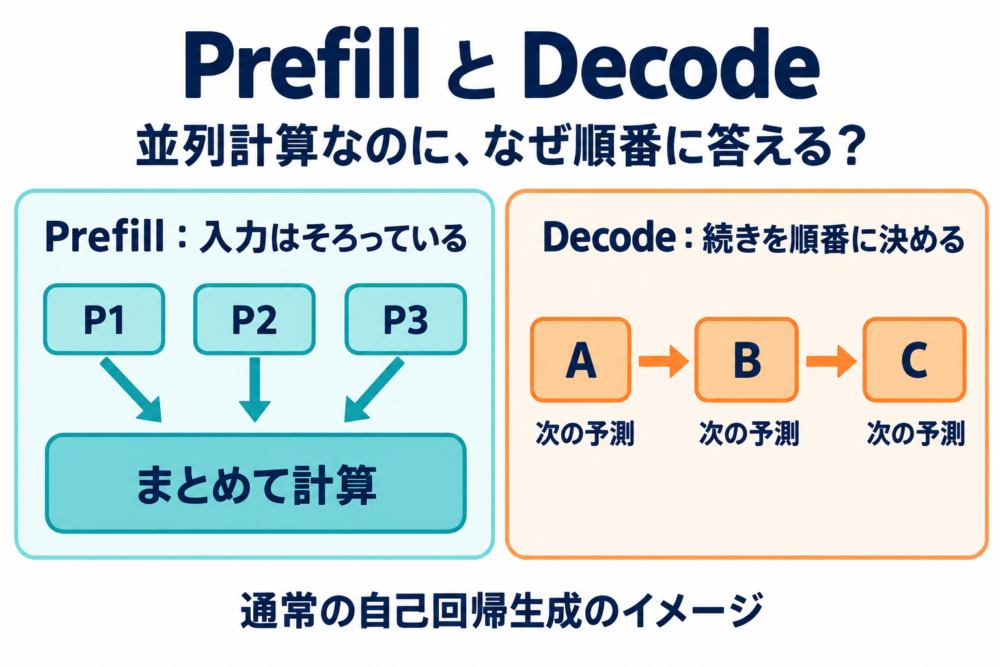
LLMは一度の予測に必要な計算を並列に進められますが、通常の文章生成では「次に選んだ内容」を使って、その次を決めます。 入力文はすでにそろっているためまとめて処理しやすく、まだ決まっていない出力は順番に生成します。この違いが、Prefill(入力を処理する段階)とDecode(続きを生成する段階)の理解につながります。
厳密には、生成の単位は「1文字」ではなくトークンです。この記事では、一般的な自己回帰型のDecoder-only Transformer(それまでの文脈から続きを予測するモデル)を対象に、入力処理・出力生成・画面表示を分けて説明します。
「1文字ずつ見える」と「1文字ずつ計算する」は違う
トークンは、モデルが文章を処理するための単位です。単語全体、単語の一部、記号などが単位になり、1トークンが常に1文字や1単語に対応するわけではありません。どのように分けるかは、モデルが使うトークナイザー(文章をトークンへ変換する仕組み)によって異なります。Hugging Face「Tokenizers」
画面へ少しずつ文章を出す処理には、ストリーミング(途中までできた結果を順次送る方式)も関わります。モデルがトークンを生成すること、その内容をサーバーが送ること、アプリが文字として表示することは別の段階です。Hugging Face TGI「Streaming」
そのため、数文字ずつ表示されても、モデルがその文字数を一度に生成しているとは限りません。通信や表示側でまとめられる場合もあり、画面の動きだけでは内部の生成方法まで特定できません。
並列計算できても、未来の出力はまだ決まっていない
たとえば、モデルが「今日は」に続く内容を生成するとします。ここでの語句は依存関係を説明するための例で、実際のトークン分割を示すものではありません。「晴れ」を選んだ場合と「雨」を選んだ場合では、自然な続きが変わります。通常の自己回帰生成では、ここで選んだトークンを次の入力に加えてから、その続きを予測します。
「次の候補を計算する処理を速くする」ことと、「次の候補が決まる前に、その先まで確定する」ことは異なります。GPU(多数の計算を同時に実行するプロセッサー)が得意なのは、前者に含まれる大量の数値計算です。
入力がそろっていると、位置ごとの処理をまとめられる
Prefillでは、ユーザーが送った入力トークンがそろっています。入力の各位置について必要な計算を、まとめた行列演算として進められます。これに対して、出力の2個目に何を入れるかは、出力の1個目が決まってから考えます。

*通常の自己回帰生成を示す独自概念図です。P1などは仮のトークンで、層間の処理順序や因果マスクは省略して消えるものではありません。*
同じ理由で、通常の次トークン予測の学習では、正解の文章が用意されていることを利用できます。文章を1つずつ新しく作る代わりに、既知の文章の各位置で「次を予測した結果」をまとめて評価できます。
ここで、後ろの正解を前の位置から見てよいわけではありません。因果マスク(後ろの位置を参照させない制約)を使い、各位置が参照できる範囲を制限したまま計算します。Transformerの原論文も、decoderで後続位置を見られないようにする構造を説明しています。Vaswaniら「Attention Is All You Need」
並列になるのは、各層での位置ごとの計算などです。前の層の結果を次の層へ渡す依存関係までなくなるわけではありません。構造や学習方法は、Decoder-only Transformerとは?で詳しく解説しています。
PrefillとDecodeの違い
| 比較する点 | Prefill | Decode |
|---|---|---|
| 主に処理するもの | すでにそろった入力トークン | 直前に選んだ新しいトークン |
| 役割 | 入力の文脈をモデル内部で計算する | それまでの文脈を使い、さらに続きを予測する |
| 通常の処理の進め方 | 入力の複数位置をまとめて計算しやすい | 同じ回答の生成ステップには順番がある |
| 出力との関係 | 最後の位置の予測結果から、最初の出力トークンを選べる | 次の出力トークンを選び、処理を繰り返す |
| 利用者が感じる待ち時間 | 返答が始まるまでの時間に関わる | 返答が始まった後の進み方に関わる |
NVIDIAの解説も、入力がすべて分かっているPrefillと、前の生成結果に依存するDecodeを区別しています。Prefillは単なる文章の分割や読み込みではなく、モデルを使って入力の文脈を計算する処理です。NVIDIA「Mastering LLM Techniques: Inference Optimization」
上の表は基本的な流れです。実際の推論基盤では長い入力を分割して処理したり、別のリクエストの生成と組み合わせたりする場合があります。段階の区別は、すべての入力を必ず一つの巨大な処理として実行する、という意味ではありません。
KVキャッシュは「過去を作り直す作業」を減らす
Decodeで続きを生成するときは、入力文やそれまでの出力を参照します。毎回すべての位置の計算をやり直すと無駄が大きいため、過去の計算結果の一部を保存して再利用します。それがKVキャッシュです。
KはKey、VはValueで、Attention(文脈のどの部分を参照するか計算する仕組み)で使う内部の数値表現です。文章の答えを丸ごと保存する機能とは役割が異なります。Hugging Face「How caching works」
説明用に、入力をP1・P2・P3、出力をA・B・Cという仮のトークンで表すと、流れは次のようになります。
- Prefill: P1・P2・P3を処理し、各層で入力のK/Vを保存します。最後の位置の予測から出力Aを選びます。
- Decodeの1回目: Aをモデルへ入力します。保存済みの文脈を参照し、AのK/Vを計算して追加しながら、次の出力Bを予測します。
- Decodeの2回目: Bを入力し、同じようにBのK/Vを追加して、出力Cを予測します。

*各行はモデルを通した処理と出力選択を簡略化したものです。キャッシュ欄は文章そのものではなく、各層で保存するK/Vをトークン名で表しています。*
ここで、Aを選んだ瞬間にAの全層のK/Vまでできているわけではありません。通常の流れでは、Aを次のモデル入力として処理するときに、そのK/Vが計算されます。
キャッシュを使えば過去のK/Vを作り直す作業は減らせますが、新しいトークンを処理し、文脈を参照する計算は残ります。また、長い文脈では保存するデータ量や読み出す量も問題になります。保存内容とメモリ量は、KV Cacheとは?LLMの生成を高速化する仕組みで整理しています。
「返答が始まるまで」と「始まってから」を分けて見る
同じ「遅い」でも、送信後に長く待つ場合と、返答が始まってからゆっくり進む場合では、見るべき指標が違います。
| 指標 | 測るもの | 分かること・限界 |
|---|---|---|
| TTFT(最初のトークンが届くまでの時間) | リクエスト送信から、最初の内容を受信するまで | 開始待ちの長さ。Prefill以外の待ちも含む |
| ITL(隣り合う出力トークンの時間間隔) | 返答開始後のトークン間の間隔 | 出力の進み方。測定ツールの定義を確認する |
| 全体の応答時間 | 送信から最後の出力を受け取るまで | 最後まで待つ長さ。出力の長さにも左右される |
NVIDIAの測定資料では、TTFTには順番待ちやPrefill、ネットワークの遅延などが含まれます。したがって、「最初の返答まで2秒かかったから、Prefillが2秒だった」とは言えません。NVIDIA NIM「Metrics」
架空の時刻で計算してみる
以下は計算方法を示す例で、特定モデルの測定結果ではありません。4つの出力トークンがそれぞれ次の時刻に届いたとします。
| 出来事 | リクエスト送信からの経過時間 |
|---|---|
| リクエスト送信 | 0.00秒 |
| 出力Aを受信 | 0.50秒 |
| 出力Bを受信 | 0.60秒 |
| 出力Cを受信 | 0.72秒 |
| 出力Dを受信して終了 | 0.81秒 |

*数値は計算方法を示す架空例です。カードの配置は時間の縮尺を表さず、実測結果や性能比較を示していません。*
この場合、TTFTは0.50秒、全体の応答時間は0.81秒です。最初の出力から最後の出力までは、0.81−0.50=0.31秒です。
返答開始後の間隔はA→B、B→C、C→Dの3つなので、平均ITLは0.31÷3≒0.103秒/トークンになります。ここではTTFTを平均に含めていません。NVIDIAの資料も、測定ツールによって定義が異なる点に注意を促しています。
実際の通信で複数トークンをまとめて受信する場合、受信したメッセージの間隔をそのまま1トークンの生成時間として扱うことはできません。また、全利用者の合計処理量が増えたことと、自分の1件の回答が速くなったことも分けて見ます。
並列化や高速化は、何を速くするのか
「並列処理なら速い」という説明を読むときは、何を並べて処理しているかを確認すると混乱しにくくなります。
| 方法 | 速くしたい対象 | トレードオフ・限界 |
|---|---|---|
| 1回の予測の数値計算を並列化する | 行列演算などの計算 | 同じ回答の次ステップへの依存は残る |
| 複数リクエストをまとめる | サーバー全体の処理量 | 1人の待ち時間が同じ割合で短くなるとは限らない |
| KVキャッシュを使う | 過去のK/Vの再計算 | メモリを使い、文脈の参照処理は残る |
| 投機的デコーディングを使う | 複数候補をまとめて検証する処理 | 候補の採用率と検証コストで効果が変わる |
少数のリクエストを扱うDecodeでは、計算能力だけでなく、モデルの重みやキャッシュをメモリから読み出す速さが制約になりやすいと説明されます。これをメモリ帯域が律速になる、と呼びます。ただし、モデル構造・文脈長・同時処理数・実行環境で状況は変わるため、Decodeはいつでも同じ理由で遅いとは決められません。NVIDIA「Inference Optimization」
複数トークンをまとめて進める方法もある
通常の自己回帰生成に対し、投機的デコーディングは、軽いモデルなどが先に作った候補を大きなモデルでまとめて検証します。候補が採用されれば、一度の検証で複数トークン分を進められます。採用されなかった候補をそのまま確定出力にするわけではありません。
これは「未来の出力は必ず1個ずつしか扱えない」という単純な説明への例外です。ただし、候補を確かめる処理が必要で、どの条件でも同じように高速化するわけではありません。Google Research「Looking back at speculative decoding」
候補の採用・棄却や速度への影響は、Speculative Decodingとは?で詳しく説明しています。本記事の基本図は、このような高速化を加える前の、通常の生成ループを示しています。
よくある疑問
長い入力は、返答が始まった後も影響しますか?
はい。入力処理が長くなるだけでなく、Decodeで参照する文脈やキャッシュの量にも影響します。ただし、すでに計算した入力部分を再利用する仕組みやAttentionの方式によって挙動は変わるため、入力文字数だけで速度を予測することはできません。
GPUを増やせば、一つの回答も同じ倍率で速くなりますか?
必ずしもそうなりません。計算の分割方法、GPU間の通信、メモリへのアクセス、生成ステップの依存関係が関わります。比較するときは、同じ入力・出力条件で、開始待ちと生成中の間隔を分けて確かめます。
一括表示にすれば、生成そのものも速くなりますか?
一括表示は、結果を見せるタイミングの変更です。内部では同じ生成処理を行い、全文が完成してから返す構成もあります。表示方法だけから計算速度の改善を判断せず、送信から完了までの時間を確認してください。
コメント