Ollamaで最初の質問や、しばらく使わなかった後の質問だけ遅いときは、モデルの読み込み時間を確認します。 すでに読み込まれた状態でも遅いなら、入力の処理や回答の生成、ほかの処理との競合を調べます。
keep_aliveはモデルをメモリに残す時間を指定する設定です。再読み込みを減らせる場合がありますが、長い文章を読む処理や、回答を生成する計算そのものが必ず速くなるわけではありません。
この記事では、ローカルで動くOllamaの時間を計測し、設定を選ぶ手順を説明します。図は独自の概念図、数値は計算用の例です。特定のPC・GPUで測定したベンチマークではありません。仕様の確認日は2026年9月21日です。
「初回だけ遅い」と「毎回遅い」を分ける
同じ「回答が遅い」でも、待っている処理は異なります。
| 症状 | 最初の確認先 | 改善の方向 |
|---|---|---|
| 起動後の1回目だけ遅い | load_durationと実行前のollama ps |
モデルの事前読み込みを検討 |
| 放置した後だけ遅い | モデルがメモリから外れていないか | 保持時間を利用間隔に合わせる |
| 長い資料や会話で遅くなる | prompt_eval_durationと入力の長さ |
不要な履歴や資料を減らす |
| 文字が出始めた後も遅い | eval_durationと出力トークン数 |
モデル・GPU配置・メモリを確認 |
| 複数人で使うと遅い | 同時実行、別モデルの利用、待ち行列 | 単独実行との比較から始める |
| アプリ画面だけ長く待つ | ストリーミングや画面表示の処理 | サーバー側の時間と分けて測る |
モデルの状態は、ターミナルで次のコマンドから確認できます。
ollama --version
ollama ls
ollama ps
ollama lsは保存されているモデル、ollama psは現在読み込まれているモデルを確認するために使います。ダウンロード済みでも、実行用メモリに読み込まれているとは限りません。 以降は、すでにダウンロード済みのローカルモデルを使います。初回ダウンロードやクラウドモデルへの通信時間は、今回の比較から外します。
コマンドと稼働モデルの確認方法は、Ollama CLI ReferenceとOllama API:List running modelsを参照してください。
回答までに行われる3つの処理
1. モデルを読み込む
モデルの重み(学習によって決まった計算用の数値)は、保存時にはSSDなどのストレージにあります。実行時は、使用する機器に応じてRAM(主記憶)やVRAM(GPU用メモリ)などに配置されます。
実行対象のモデルがOllamaに読み込まれていない状態を、この記事では「未ロード」と呼びます。同じモデルを利用できる状態で保持している場合は「ロード済み」と呼びます。実際の配置方法やデータの移動経路は、GPUやメモリ構成によって異なります。
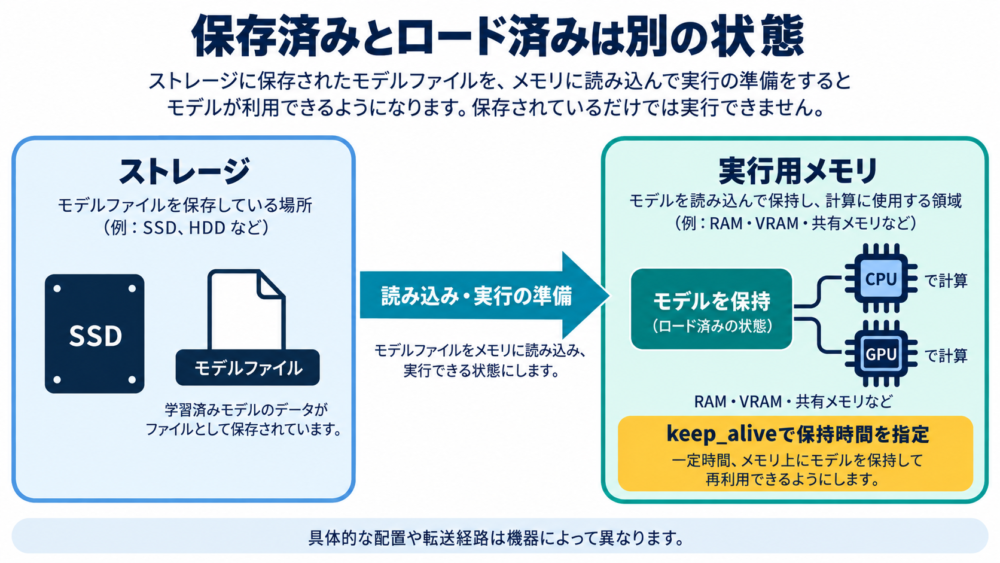
図:保存ファイルと実行時のモデル保持の関係を示す独自概念図。右側はRAM・VRAM・共有メモリなどの役割をまとめた表現で、特定のハードウェアの配線図ではありません。
2. 入力を処理する
質問文、システム指示、会話履歴などをモデルへ入力します。文章はトークン(モデルが扱う文字列の単位)に分かれ、回答を生成するための処理が行われます。この入力処理はprefillとも呼ばれます。
同じ入力の一部を再利用できるキャッシュが効く場合もあるため、2回目が速い理由はモデルの保持だけとは限りません。モデルの重みを残すことと、入力の計算結果を再利用することを分けて考えます。
3. 出力を順に生成する
モデルは回答のトークンを順に生成します。この段階はdecodeとも呼ばれ、長い回答ほど生成する量が増えます。生成速度を比べるときは、完了までの秒数だけでなく、何トークンを出力したかも見ます。
ここまでのほかに、要求の待ち行列、通信、画面へ表示する処理もあります。API(アプリケーション間の通信規約)が返す時間と、ユーザーが操作してから見終えるまでの時間は同じとは限りません。
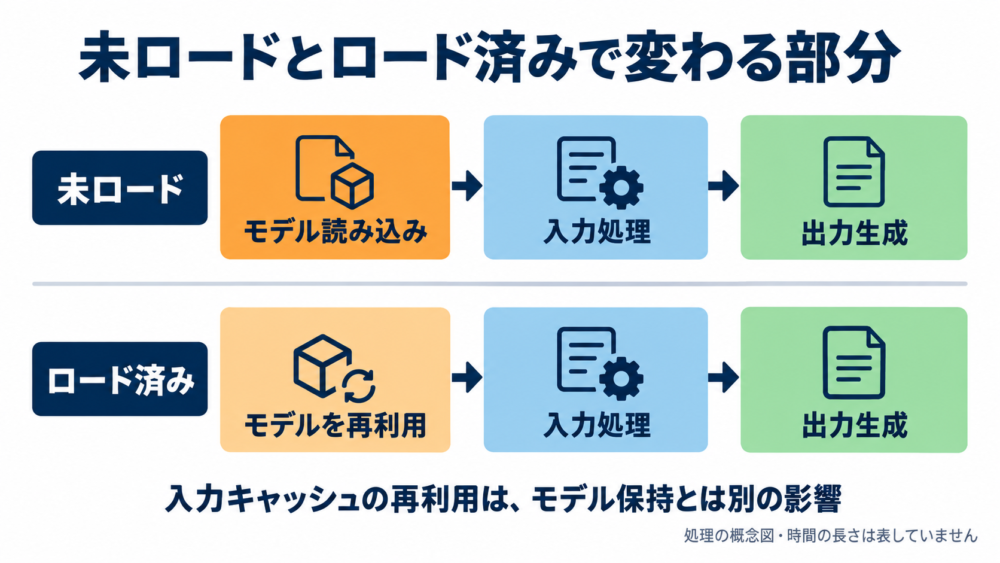
図:モデルの保持で変わる処理を比較する独自概念図。箱の幅は処理時間を表さず、ロード済みでも準備の処理がなくなるとは限りません。
APIで読み込み・入力処理・生成の時間を確認する
Ollamaの生成APIは、処理時間などの情報を返します。時間の単位はナノ秒なので、秒へ直すには1,000,000,000で割ります。
| フィールド | 確認するもの | 読み方の注意 |
|---|---|---|
total_duration |
応答生成に要した全体の時間 | 最初の文字が出るまでの時間ではない |
load_duration |
モデルの読み込み時間 | 未ロード時とロード済みで比較する |
prompt_eval_duration |
キャッシュされていない入力の評価時間 | 入力量とキャッシュの影響を受ける |
eval_duration |
出力トークンの生成時間 | 出力数と合わせて確認する |
prompt_eval_count |
入力トークン数 | 質問文だけでなくテンプレートなども影響する |
prompt_eval_cached_count |
キャッシュから読んだ入力トークン数 | バージョンなどによって返らない場合は未取得とする |
eval_count |
出力トークン数 | 文字数とは異なる |
出典:Ollama API:Usage、Generate a response。
Pythonで内訳を取得する
次のコードをollama_probe.pyとして保存します。Python 3.10以降の標準ライブラリだけを使い、同じPC上のOllamaに送信します。追加パッケージは不要です。Ollamaを起動し、ollama lsで対象のローカルモデル名を確認してから実行してください。
import argparse
import json
import logging
from time import perf_counter
from typing import Any
from urllib.request import Request, urlopen


def probe(model: str, preload: bool = False) -> dict[str, Any]:
    """Ollamaの時間情報を取得する。

    Args: model: 保存済みローカルモデル名。preload: 事前読み込みのみ。
    Returns: 経過時間、APIの処理時間、トークン数。
    Raises: HTTPError、URLError、TimeoutError、JSONDecodeError。
    Example: probe("手元のモデル名")
    """
    payload: dict[str, Any] = {
        "model": model,
        "stream": False,
        "keep_alive": "10m",
        "options": {"num_ctx": 4096, "num_predict": 64},
    }
    if not preload:
        payload["prompt"] = "空が青く見える理由を短く説明してください。"
    # 完了応答にまとめ、時間の内訳を取り出しやすくする。
    request: Request = Request(
        "http://127.0.0.1:11434/api/generate",
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )
    started: float = perf_counter()
    with urlopen(request, timeout=300) as response:
        data: dict[str, Any] = json.load(response)
    result: dict[str, Any] = {"wall_seconds": perf_counter() - started}
    for name in ("total_duration", "load_duration",
                 "prompt_eval_duration", "eval_duration"):
        value: Any = data.get(name)
        result[name + "_seconds"] = None if value is None else value / 1e9
    for name in ("prompt_eval_count", "prompt_eval_cached_count", "eval_count"):
        result[name] = data.get(name)
    count: Any = data.get("eval_count")
    duration: Any = data.get("eval_duration")
    result["tokens_per_second"] = (
        count * 1e9 / duration if count is not None and duration else None
    )
    logging.info("計測完了: preload=%s", preload)
    return result


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO)
    parser: argparse.ArgumentParser = argparse.ArgumentParser()
    parser.add_argument("model")
    parser.add_argument("--preload", action="store_true")
    args: argparse.Namespace = parser.parse_args()
print(json.dumps(probe(args.model, args.preload), ensure_ascii=False, indent=2))MODEL_NAMEを、保存済みローカルモデルの正確な名前に置き換えます。タグが付いている場合はタグも含めます。Windowsではpython、macOSやLinuxでは環境に応じてpython3を使ってください。
python ollama_probe.py "MODEL_NAME"コード中のnum_ctx: 4096は比較条件をそろえるためのコンテキスト長(扱う文脈の上限)の例、num_predict: 64は生成トークン数の上限です。実際の長い会話に4096を一律推奨するものではありません。推論・思考を行うモデルでは短い上限の間に回答本文まで到達しない場合もあります。比較時はモデルと設定を固定し、必要なら上限をそろえて増やします。
モデルが見つからないというエラーなら名前を、接続できないならOllamaの起動状態と接続先を確認します。タイムアウトした場合は、完了した計測値として扱わず、処理状況を確認してください。このコードは模擬応答で送信内容と単位換算を検証しており、実機の推論速度は測定していません。
秒とtoken/sの計算例
仮にeval_durationが2,000,000,000、eval_countが40なら、生成時間は2秒、生成速度は40 ÷ 2 = 20 token/s(1秒あたりのトークン数)です。これは説明用の数値で、性能の目安ではありません。
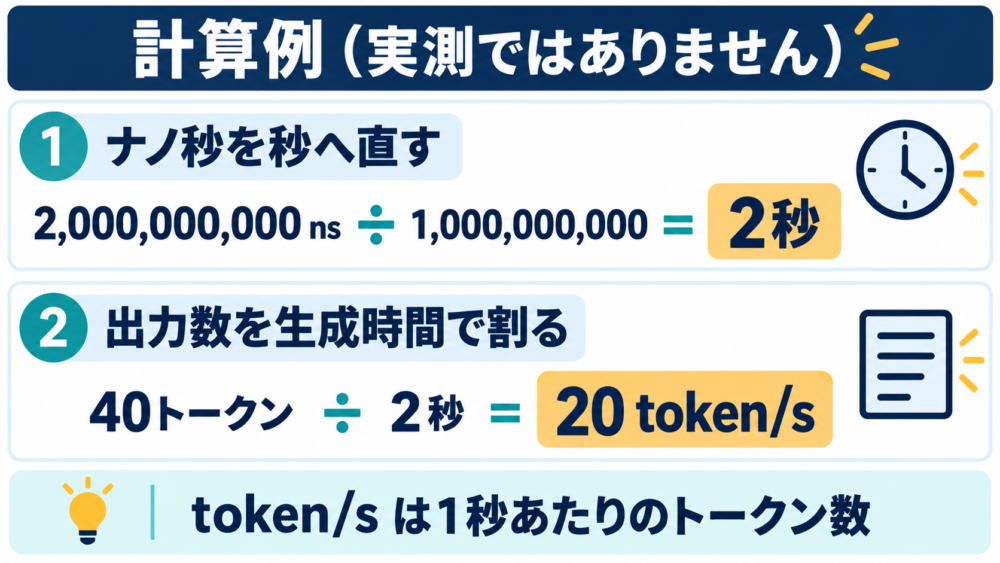
図:ナノ秒から秒への換算と生成速度の計算。数値は説明用に設定したもので、実機の測定結果ではありません。
load_durationが小さくなっても、eval_countが増えれば全体時間は長くなり得ます。また、全体時間と各時間の単純な合計の差を、そのまま待ち行列の時間と決めつけないでください。各値は切り分けの手掛かりとして使います。
未ロード時とロード済みで比較する
ほかのアプリから同じOllamaを使っていない状態で、次の順に確認します。ollama stopは対象モデルを使っている作業が終わってから実行してください。
ollama stop "MODEL_NAME"
ollama ps
python ollama_probe.py "MODEL_NAME"
ollama ps
python ollama_probe.py "MODEL_NAME"1回目の前に対象がollama psから消えていること、1回目の後に対象が表示されることを確認します。コードは10分の保持を指定するので、間を空けずに2回目を実行してください。
比較の中心はload_duration_secondsです。1回目で大きく、2回目で小さくなるなら、モデルの読み込みが初回待ちの一因と考えられます。ロード済みでも準備の時間が完全にゼロになるとは限りません。
同じ質問を使うこの比較では、入力のキャッシュ再利用も起こり得ます。prompt_eval_durationやprompt_eval_cached_countも確認し、全体の短縮をすべて読み込みの改善に帰属させないようにします。また、ollama stopはOSのファイルキャッシュまで空にする操作ではないため、PC起動直後のストレージ状態を完全に再現する実験ではありません。
keep_aliveで保持時間を調整する
同じモデルを短い間隔で使う場合は、メモリに残して再読み込みを減らす方法が候補になります。Ollama公式FAQでは、既定の保持時間は5分とされています。利用環境で設定が上書きされている場合もあるので、実際の状態をollama psで確認します。
| 設定 | 意味 | 向く使い方・負担 |
|---|---|---|
"keep_alive": "10m" |
応答後も10分の保持を指定 | 短い休憩を挟む対話。待機中もメモリを使う |
"keep_alive": 0 |
応答後にアンロードする | 利用後にメモリを空けたい。次回は再読み込みが必要 |
"keep_alive": -1 |
時間による期限を設けず保持する指定 | 継続利用向け。ほかの作業とメモリを取り合う |
OLLAMA_KEEP_ALIVE |
サーバー側の既定値を設定 | リクエスト側のkeep_aliveが優先される |
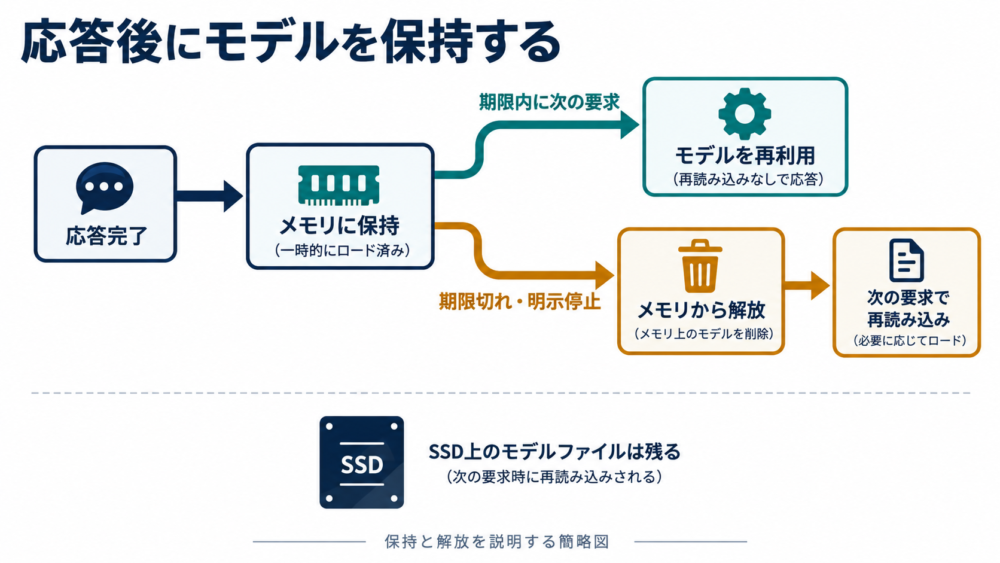
図:モデルの保持・解放を単純化した概念図。実際には別モデルの要求や設定変更なども再読み込みの要因になります。
保持時間は、常駐メモリの絶対的な予約ではありません。サーバーの終了、明示的な停止、別モデルを読み込むためのメモリ調整など、実際の状態が変わる条件も確認します。まずは有限の時間から試し、待ち時間とメモリ使用の両方を見て選ぶと判断しやすくなります。
詳しい仕様はOllama FAQ:モデルの事前読み込みとメモリ保持に記載されています。掲載コードはリクエストごとの設定なので、サーバー全体の既定値を変えずに試せます。
プリロードは待ち時間を前へ移す
プリロード(事前読み込み)は、質問を送る前にモデルを読み込ませることです。掲載コードでは次のように実行できます。
python ollama_probe.py "MODEL_NAME" --preload
ollama ps
python ollama_probe.py "MODEL_NAME"--preloadを付けると、コードはpromptを送らずにモデルの読み込みを要求します。後続の質問も同じモデル・設定で送ります。モデルの準備に必要な仕事がなくなるわけではなく、その仕事を質問より前へ移します。
事前読み込みから実際の質問まで長く空く、別モデルへ切り替える、設定を変える、といった場合は再読み込みが必要になることがあります。質問の直前にモデルが残っているかを確認します。
モデルを保持しても遅いときの確認先
入力が長い場合
入力処理の時間が大きいときは、使っていない履歴や不要な資料を減らして、同じ質問を短い入力で試します。コンテキスト長の設定値と、実際に送っている入力の長さは別です。上限だけを小さくすると必要な文脈が収まらなくなるので、何を入力しているかを先に確認します。
モデルの重み以外に、KVキャッシュ(文脈の計算途中の情報を保持する領域)などもメモリを使います。コンテキスト長を増やすと必要メモリも増えるため、モデルファイルが保存できることだけで、希望する条件の推論が収まるとは判断できません。出典:Ollama:Context length。
回答生成が遅い場合
ollama psのPROCESSORで配置を確認します。ここに出る100% GPUなどの値は、モデルの配置を表すもので、瞬間的なGPU使用率を表す表示とは異なります。
生成速度を調べる場合は、同じモデル・量子化(重みなどを少ないビット数で表す方法)・入力条件を保ち、出力トークン数を合わせて比較します。モデルを小さくする方法もありますが、回答品質や扱える課題とのトレードオフがあります。GPU認識や配置の詳細は、OllamaがGPUを使わないときの対処法|認識・メモリ不足・設定を切り分けるで説明しています。
初回だけの遅さとストレージ
読み込みの時間が大きい場合は、モデルの保存先や、そのドライブがほかの処理で混雑していないかも確認候補です。ただし、load_durationだけでディスクの速度が原因と確定することはできません。OSのキャッシュや実行環境の準備も影響し得ます。
保存場所の移動は、Ollamaのモデル保存先をDドライブへ移す方法|既存モデルの移行と確認手順を参照してください。モデルを保存する場所と、実行中のモデルを保持するメモリは役割が違います。
複数モデルや別PCから利用している場合
最初は1モデル・1要求で測り、その後に同時利用時と比べます。同時に使うモデルや要求が増えると、メモリ不足や待ち行列の影響を受ける場合があります。保持時間を長くするだけでなく、同時利用数も含めて判断します。
別PCから接続しているなら、設定の反映先はOllamaが動いているサーバーです。掲載コードの127.0.0.1は、コードを実行したPC自身を指します。LAN構成を確認するときは、Mac miniのOllamaを別のPCから使う方法|自宅LANで接続・確認する手順を参照してください。
最初の文字が出るまでの時間は別に測る
TTFT(Time To First Token)は、要求から最初のトークンが得られるまでの時間です。今回のコードはstream: falseで完了後の応答を受け取るため、wall_secondsもtotal_durationもTTFTの測定値にはなりません。
最初の表示までを測るなら、ストリーミングを有効にして、最初の空ではない出力を受け取った時点を記録します。思考出力を持つモデルでは、「最初の思考トークン」と「最初の回答本文」のどちらを測るかも定義します。アプリが途中出力をためてから表示している場合は、受信時刻と表示時刻も分けます。
ストリーミングは途中の出力を見せる方法なので、待ち時間の感じ方を変えられますが、読み込みや計算をすべて省く機能ではありません。仕様はOllama API:Streamingを参照してください。
変更前後に残しておく記録
Ollamaのバージョン、モデル名と量子化、入力文、コンテキスト長、出力上限、ollama psの状態、各時間とトークン数をセットで記録します。設定を1つずつ変えると、どの変更が読み込みや生成に効いたか追いやすくなります。
計測が終わり、対象モデルを使う予定がなければ、利用中の作業がないことを確認してollama stop "MODEL_NAME"で解放できます。初回待ちにはモデルの準備、継続的な遅さには入力と生成というように、時間の内訳に合った対処を選んでください。
コメント