Self-RAGは、外部資料を検索する必要があるかを判断し、資料の関連性や生成した回答の裏付けも自己評価する、LLMの学習・生成の枠組みです。 LLMは大規模言語モデルの略です。正式名称はSelf-Reflective Retrieval-Augmented Generation。Asai氏らが提案し、ICLR 2024で発表されました。
例えば、図書館の開館時間を聞かれたとき、案内ページを取得するだけでは十分とは限りません。そのページが対象の図書館について書かれているか、回答に書いた時刻が実際に載っているかを分けて確かめる必要があります。
Self-RAGは、こうした判断を表す特殊なトークン(モデルが扱う記号)を文章とともに出せるよう学習します。「自分の回答を確認して」と頼むだけの方法とは、学習と生成制御まで含む点で異なります。著者公式ページ、Self-RAG原論文
通常のRAGに、どのような課題がある?
RAG(検索拡張生成)は、LLMに外部資料を渡して回答させる方法です。基本的な構成では、質問に近い資料を検索し、その内容と質問をモデルへ渡します。
ところが、検索結果が質問に似ていることと、回答の根拠になることは別です。開館時間を尋ねているのに図書館のイベント案内ばかり取得したり、資料にない時刻を回答へ加えたりする場合があります。
また、「この文章を柔らかい表現に直して」のように、与えられた文章だけで処理できる依頼では、外部検索を加える必要がない場合もあります。
| 比較軸 | 検索してから生成する基本的なRAG | 原論文のSelf-RAG |
|---|---|---|
| 検索のタイミング | 最初に検索するなど、構成側で決める | 生成の途中でも必要性を判断する |
| 資料の扱い | 検索結果を回答の材料にする | 資料の関連性も評価する |
| 回答の評価 | 別途、評価処理を設計できる | 裏付けや有用性の自己評価を生成へ組み込む |
| 導入上の負担 | 既存モデルと検索器を組み合わせやすい | 評価トークンを学習したモデルと生成制御が必要 |
比較対象は入門的なRAGの構成です。現在のRAGシステム全般に検索制御や検証がない、という意味ではありません。基礎はRAGの仕組みで解説しています。
Self-RAGの流れ:検索・生成・自己評価
Self-RAGは、回答を小さな区切りごとに生成します。原論文の実験では一文を区切りとして扱っていますが、手法そのものが文だけに限定されるわけではありません。
検索する場合の概念的な流れは、次のようになります。
- 追加の資料が必要かを判断する。 質問と、それまでに生成した内容を手掛かりにします。
- 検索して、資料ごとの関連性を評価する。 外部の検索器が候補資料を取得します。
- 資料を使って回答の続きを生成する。 複数の資料に対応する候補を処理します。
- 裏付けと有用性を評価し、候補を選ぶ。 生成の確率と自己評価を使って続きを選択します。
検索が不要なら、その分岐では外部資料を新たに取得せず生成し、回答の有用性を評価します。長い回答では、次の区切りに進んだときに検索が必要になる場合もあります。著者公式ページ:Retrieve・Generate・Critique
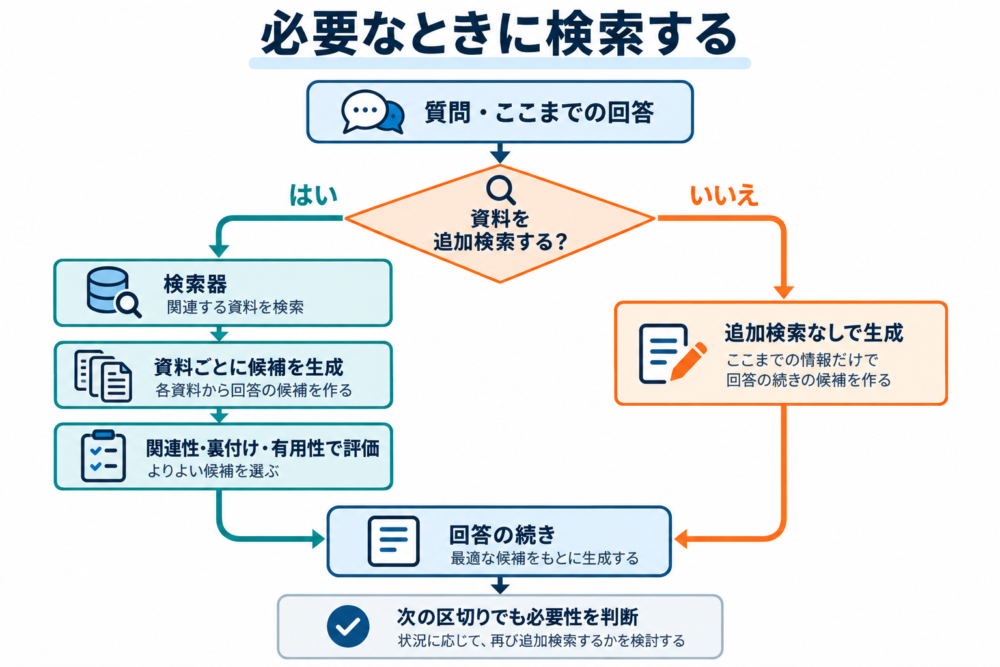
*原論文の概念を基にした独自図です。追加検索しない分岐を含む簡略図です。関連性は候補生成前にも評価され、図では候補選択に用いる評価をまとめています。*
「自己評価に失敗したら必ず何度も検索し直す」という固定の手順ではありません。検索の判断と、資料ごとに作った回答候補の評価・選択を組み合わせる仕組みです。
四つの自己評価を、図書館の例で考える
原論文では、reflection tokens(検索や品質の判断を表す特殊な記号)を四種類に分けています。次の表は役割を日本語で整理したものです。
| 種類 | 判断すること | 出力の意味 |
|---|---|---|
| Retrieve | 外部資料を検索するか | 検索する・しない・取得済み資料の利用を続ける |
| ISREL | 資料が質問に関連するか | 関連あり・関連なし |
| ISSUP | 回答中の検証すべき主張を資料が裏付けるか | 全体を支持・一部を支持・支持なし |
| ISUSE | 回答が依頼への応答として役立つか | 1〜5の段階評価 |
ISUSEは、資料そのものの正確さを採点するものではありません。質問に対する回答の有用性を、資料による裏付けとは分けて評価します。Self-RAG会議版・Table 1
一つの質問で、検索から回答候補の選択まで追う
以下は実在の施設案内ではなく、仕組みを説明するための架空例です。実際のモデルの出力や採点結果ではありません。
質問:青葉図書館は日曜日、何時まで開いていますか?
この例では、開館時刻を外部資料で確認するために検索すると判断した場合を考えます。検索器から次の2件が返ったとします。
| 取得した資料 | 内容 | 質問との関係 |
|---|---|---|
| 開館案内 | 日曜日は10時〜17時、月曜日は休館 | 閉館時刻を直接確認できる |
| イベント案内 | 土曜日に読み聞かせ会を開催 | 同じ図書館の資料でも、日曜の閉館時刻への直接の答えがない |
資料を受け取ったモデルは、まずISRELで質問との関連性を評価し、資料に応じた回答候補を生成します。ここでは開館案内から作った候補を使い、裏付けと有用性の判断対象を比べます。
| 説明用の回答候補 | 資料による裏付けを見ると | 質問への有用性を見ると |
|---|---|---|
| 日曜日は17時までです | 案内の時刻と一致する | 尋ねられた閉館時刻に答えている |
| 日曜日は18時までです | 案内の時刻と食い違う | 閉館時刻の形で答えていても、根拠がない |
| 月曜日は休館です | 案内に書かれている | 日曜日の閉館時刻への回答になっていない |
ISRELは資料と質問の関係、ISSUPは資料と回答の対応を見ます。 さらにISUSEで、回答が依頼に役立つかを評価します。同じ開館案内を使っていても、回答候補の内容によって評価すべき点が変わります。
原論文では、生成確率と自己評価トークンの確率を使って候補を比較します。上の表は判断対象の説明なので、17時という回答が実際のモデルで必ず選ばれることや、特定の採点値を示しているわけではありません。
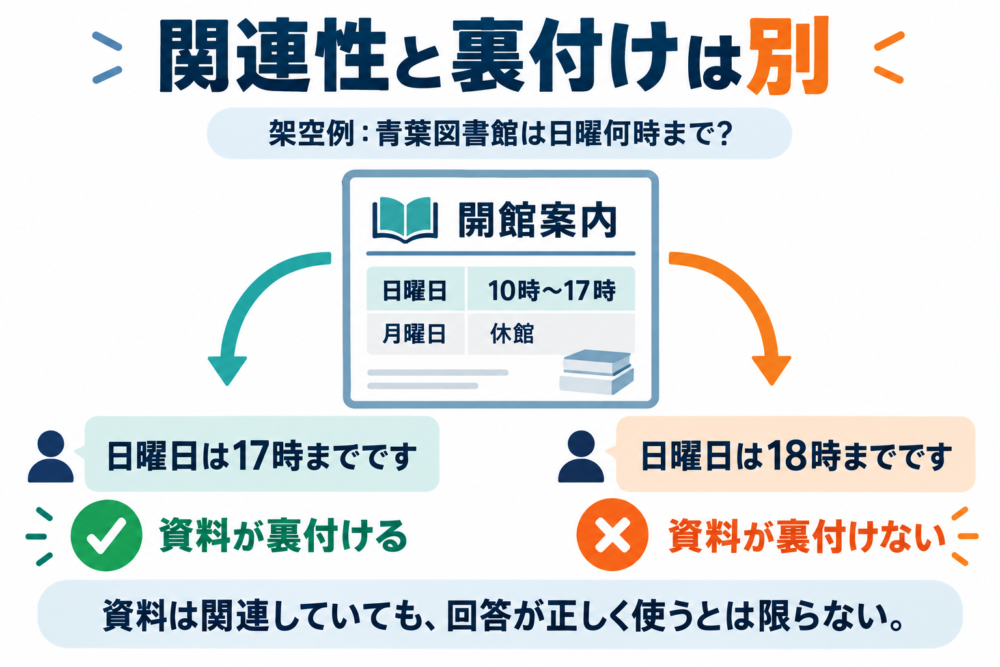
*原論文の概念を基にした独自図です。施設と回答は説明用の架空例です。*
自己評価は、どうやって学習する?
「自己評価」という名前から、回答時に別のAIが毎回採点していると想像するかもしれません。原論文では、教材を作る段階と、その教材から学習したモデルを使う段階を分けます。
まずCritic(評価用モデル)を学習し、資料や回答に評価トークンを付けるために使います。次に、その記号と検索資料を含む教材でGenerator(回答を生成するモデル)を学習します。Generatorは文章と評価記号の両方を、次のトークンを予測する学習によって出せるようになります。
利用時には、学習済みのGenerator自身が評価トークンを生成します。そのため、別のCriticを毎回呼び出すことを必須としません。外部資料を取得する検索器の役割は残ります。Self-RAG公式リポジトリ:Training
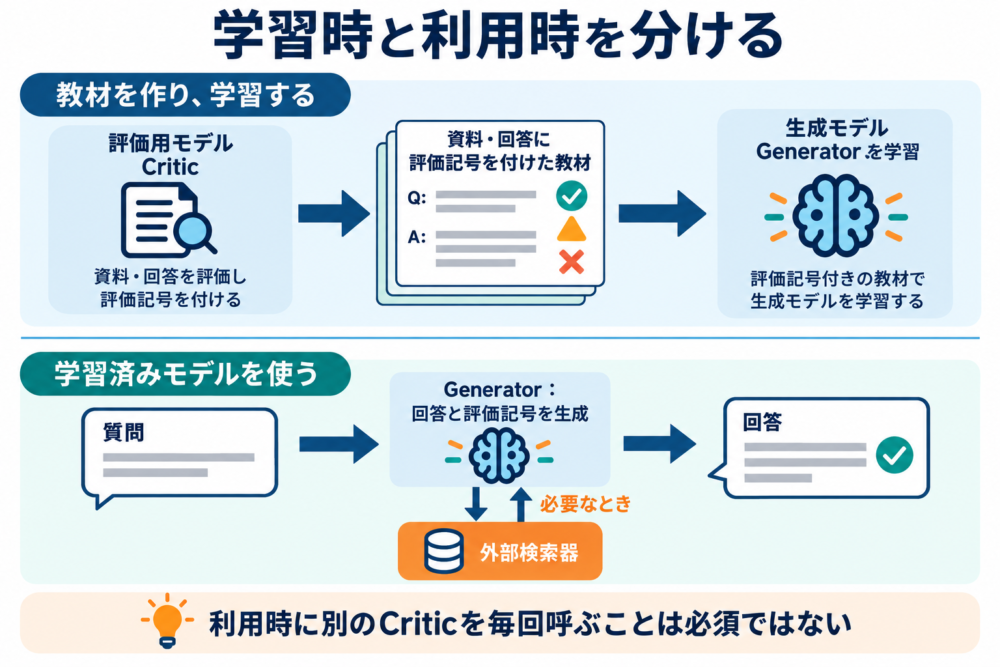
*原論文の概念を基に、教材作成・学習と利用時の役割を分けた独自図です。*
利用するときに用意するもの
学習済みのSelf-RAGモデルを利用する場合、Criticの学習からやり直すことは前提ではありません。公式リポジトリには公開モデルの利用例と、学習・評価の手順が別々に示されています。
| 構成要素 | 利用時の役割 | 確認すること |
|---|---|---|
| Self-RAGを学習したGenerator | 文章と検索・評価の記号を生成する | 特殊トークンを扱えるモデルと推論環境か |
| 資料群と検索器 | 質問や生成途中の内容に応じて資料を取得する | 必要な情報が資料にあり、検索で見つかるか |
| 生成を制御する処理 | 検索判断や候補比較を出力へ反映する | 記号や確率を読んで、設定どおりに分岐・選択できるか |
公式の評価用データには取得済みの資料を含むものもあります。その場合は保存された資料を読み込めますが、独自資料を検索する仕組みまで自動的に用意されるわけではありません。公式リポジトリ:Quick start・Retriever Setup・Inference
プロンプトで自己評価させる実装とは何が違う?
自己評価を組み込む方法には、汎用モデルへ評価ラベルの出力を指示する構成もあります。例えばIBMのSelf-RAGチュートリアルは、プロンプト内で関連性・裏付け・有用性のラベルを指定しています。
| 比較軸 | 原論文のSelf-RAG | プロンプトで評価を組み込む構成 |
|---|---|---|
| 評価を出す仕組み | 特殊トークンを追加し、文章とともに生成するよう学習 | 評価基準や出力形式を指示文で指定 |
| 候補を選ぶ方法 | 生成確率と評価トークンの確率などを利用 | 出力された判定を読み、アプリケーション側で分岐を設計 |
| 検討する負担 | 対応モデルと生成制御を扱う必要がある | 既存モデルで組めるが、判定の安定性や追加呼び出しのコストを評価する |
自己評価という目的が共通していても、学習方法と候補選択は異なります。どちらを採る場合も、対象資料での正確さ・応答時間・費用を測って判断します。本記事ではモデルの実行や、この二方式の性能比較は行っていません。
検索頻度や、重視する評価を調整できる
Self-RAGは、学習済みモデルの振る舞いを、利用時の設定でも調整します。
| 調整対象 | 変えたいこと | 注意点 |
|---|---|---|
| 検索判断のしきい値 | どれくらい検索を行うか | 検索を減らしすぎると、必要な根拠を取り逃す可能性がある |
| 自己評価の重み | 裏付けや有用性を候補選択でどれだけ重視するか | 自己評価自体が誤る可能性は残る |
| 残す回答候補の数 | 複数の続きをどれだけ比較するか | 候補を増やすと生成・評価の計算も増える |
公式の説明では、検索トークンの確率による制御と、区切りごとに候補を比較する生成方法が示されています。したがって、「検索しないことがあるから、常に通常のRAGより高速」という結論にはなりません。著者公式ページ:Inference
原論文では、どのような結果が出た?
ICLR 2024会議版のTable 2では、複数の質問応答・事実検証・長文生成の課題を評価しています。以下は、そのうち7B(約70億パラメータ)規模の二つのモデルを比較した抜粋です。
| 評価データと指標 | 検索ありLlama2-FT 7B | Self-RAG 7B |
|---|---|---|
| PopQA:質問応答の正解率 | 48.7 | 54.9 |
| PubHealth:事実検証の正解率 | 64.3 | 72.4 |
数値は正解率の百分率です。差はそれぞれ6.2ポイント、8.1ポイントになります。比較対象のLlama2-FTは、同じ指示・応答ペアを使い、検索や評価トークンを含めずに学習したモデルで、回答時に検索を追加した構成です。検索資料や評価条件によって結果は変わるため、導入先で同じ改善幅が得られるとは限りません。
この表は原論文の条件での結果です。本記事による再測定ではなく、現在のモデルとの性能比較でもありません。また、学習方法と生成制御を含む比較なので、改善幅を単一のトークンや検索回数だけの効果とはみなせません。Self-RAG会議版・Table 2、5.1節
Self-RAGでも、資料と評価の誤りは残る
Self-RAGの自己評価はモデルの予測です。資料が古い、検索で必要なページが見つからない、資料に書かれた内容自体が誤っているといった問題を、自動的に解決できるわけではありません。
先ほどの図書館の例でも、古い案内を使って「17時まで」と正しく読み取れたとして、現在も17時閉館かどうかは別に確認する必要があります。「資料に合っている」と「現実に正しい」を区別する理由です。
実際の用途で導入を検討するなら、私は次の点を確認します。
- 検索に使う資料の更新日と、正本となる情報源
- 根拠がない質問や、資料同士が矛盾する質問への応答
- 回答の正しさと、引用先が主張を支持するかを分けた評価
- 検索回数、生成候補数、応答時間の測定
これは運用時の確認観点であり、原論文の再現実験を実施した結果ではありません。
よくある疑問
Self-RAGは必ずWeb検索する?
外部の検索器と資料群を利用する枠組みであり、毎回Web全体を検索するという意味ではありません。対象資料と検索器の構成によって、探す範囲は変わります。検索自体を省く場合もあります。
GraphRAGとは何が違う?
このブログで扱ったGraphRAG論文は、文書から関係を抽出してグループごとの要約を用意し、資料全体を問う質問に答える設計が主題です。Self-RAGは、生成中の検索判断や資料・回答の自己評価を学習へ組み込むことに焦点があります。比較するなら、検索の前に何を用意するかと、回答中に何を判断するかを分けると理解しやすくなります。GraphRAGの解説
引用が付けば、回答を信用してよい?
引用先が存在しても、主張がそこに書かれているとは限りません。Self-RAGはその裏付けを評価しますが、自己評価の誤りもあり得るため、重要な回答では引用元の内容まで確認します。
参考資料
本記事の施設名・資料・回答例は説明用の創作です。図は概念を独自に再構成し、原論文の図版やコードは転載していません。


コメント