
GRPOは、同じ問題に対して生成した複数の回答を採点し、そのグループ内での相対評価を使ってLLMを学習させる手法です。 正式名称はGroup Relative Policy Optimizationで、DeepSeekMath論文で導入されました。
例えば、ある数学の問題に四つの回答を生成し、二つが正解、二つが不正解だったとします。GRPOでは、それぞれの点数がグループの平均より高いか低いかを、回答の生成方法を更新する手掛かりにします。
重要なのは、比較する単位が「同じ問題への回答群」であることです。難易度の違う問題への回答を、単にまとめて順位付けする方法ではありません。
本記事はDeepSeekMath論文v3(Zhihong Shaoほか)を中心に、計算例、PPO・DPOとの違い、結果と限界を解説します。主に回答全体へ一つの点数を与える方式を扱います。論文には途中の推論ステップを採点する方式もありますが、両者の計算を混ぜないようにします。
GRPOの流れは「生成・採点・比較・更新」
LLM(文章を生成する大規模言語モデル)は、次にどのトークン(文章を処理する単位)を出すかの確率を持っています。強化学習では、生成結果に与えた報酬を使って、その出し方を調整します。
GRPOの基本的な流れは次の四段階です。
- 同じ問題に複数の回答を生成する。 一つの問題と、その回答群を組にします。
- 各回答を採点する。 点数を報酬と呼びます。何を良い回答とするかは採点方法で決まります。
- グループの平均と比較する。 平均よりどれほど良いかを、学習の手掛かりへ変換します。
- モデルを更新する。 高く評価された回答の生成を後押しする方向へ、更新幅の制御も含めて学習します。
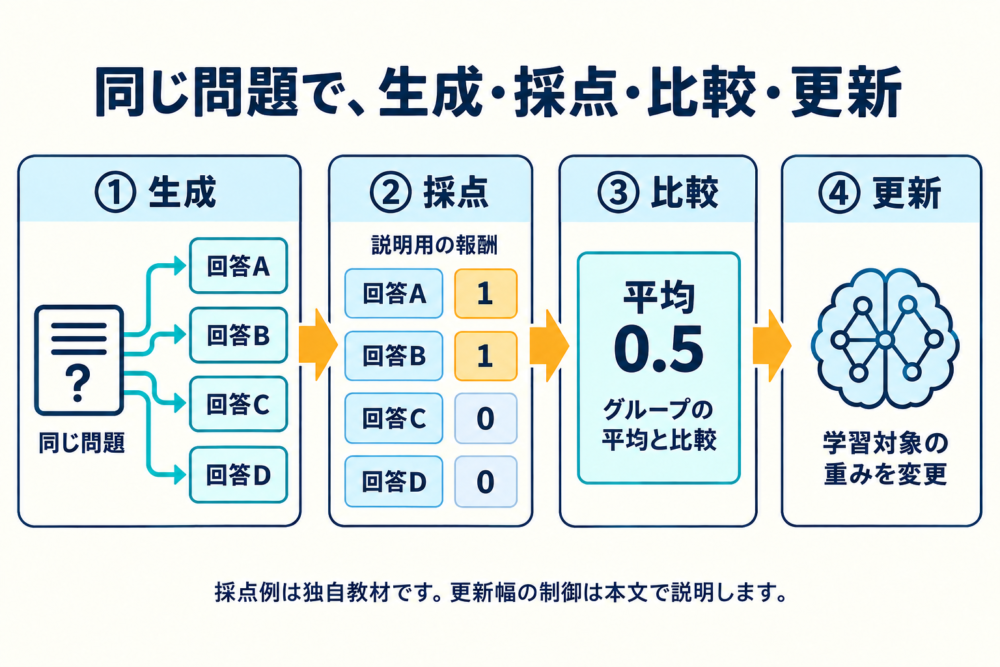
*原論文の概念を基にした独自図です。採点は説明用の1・1・0・0であり、更新制約は本文で補足しています。*
ここでモデルを更新するとは、学習対象の重みを変更することです。複数の候補から最良の回答を一つ選んで表示するだけの処理とは異なり、その後の回答の生成にも影響します。
四つの回答で、相対評価を計算してみる
計算を追いやすくするため、独自の例として、正解を1点、不正解を0点で採点します。これは説明用の単純な採点ルールであり、DeepSeekMathの実験で用いた報酬モデルを再現したものではありません。
| 同じ問題への回答 | 判定 | 報酬 |
|---|---|---|
| 回答A | 正解 | 1 |
| 回答B | 正解 | 1 |
| 回答C | 不正解 | 0 |
| 回答D | 不正解 | 0 |
平均との差を、ばらつきの大きさで割る
原論文の回答全体を採点する方式では、グループの平均を引き、標準偏差(点数のばらつきを表す値)で割ります。こうして得たアドバンテージ(平均に対してどれほど有利かを表す値)を使います。
\(r_i\)は回答\(i\)の報酬、\(\mu\)は同じグループの平均、\(\sigma\)は標準偏差です。以下の教材では、標準偏差を求める際に回答数の4で割る母標準偏差を使います。実装によっては異なる定義を使うため、ライブラリの出力値とそのまま一致するとは限りません。
まず平均は、\((1+1+0+0)/4=0.5\)です。平均との差は、\(0.5, 0.5, -0.5, -0.5\)になります。
差を二乗すると四つとも\(0.25\)なので、その平均である分散も\(0.25\)です。標準偏差は\(\sqrt{0.25}=0.5\)になります。
したがって、正解側は\((1-0.5)/0.5=+1\)、不正解側は\((0-0.5)/0.5=-1\)です。
| 回答 | 報酬 | 平均との差 | アドバンテージ |
|---|---|---|---|
| A・B | 1 | +0.5 | +1 |
| C・D | 0 | −0.5 | −1 |
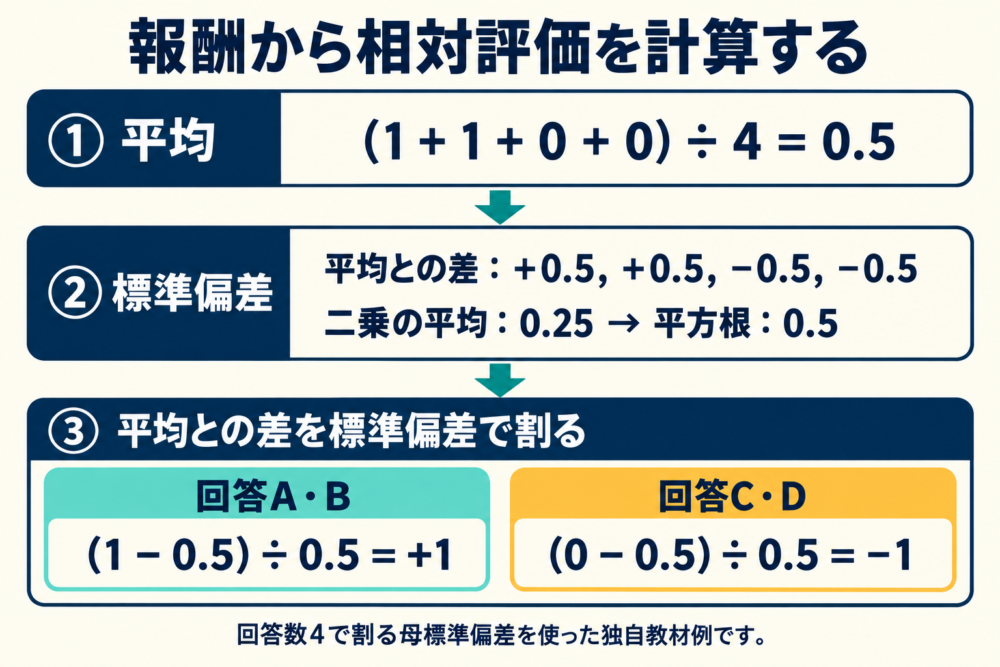
*回答数4で割る母標準偏差を用いた独自の計算例です。原論文の性能測定値ではありません。*
正の値は、その報酬に基づく更新で回答の生成を後押しする方向、負の値は抑える方向を示します。ただし、実際の更新は後述の制約や共有する重みの影響も受けるため、「この回答の確率が必ず一定量増える」という意味ではありません。
原論文のこの方式では、回答全体から得た同じアドバンテージを、その回答の各トークンに使います。最終結果への評価から学ぶため、途中のどの推論が良かったかを個別に採点したことにはなりません。DeepSeekMath・4.1.2節
全回答が同じ点数ならどうなる?
報酬が\(1,1,1,1\)なら、平均との差はすべて0で、標準偏差も0です。\(0,0,0,0\)でも同様です。この場合、上の式をそのまま計算すると0で割ることになるため、実装では分母に小さな値を加えるなどの処理が必要です。
平均との差がないグループからは、この比較による優劣の学習信号は得られません。ただし、別の項による更新まで必ず止まるという意味ではありません。
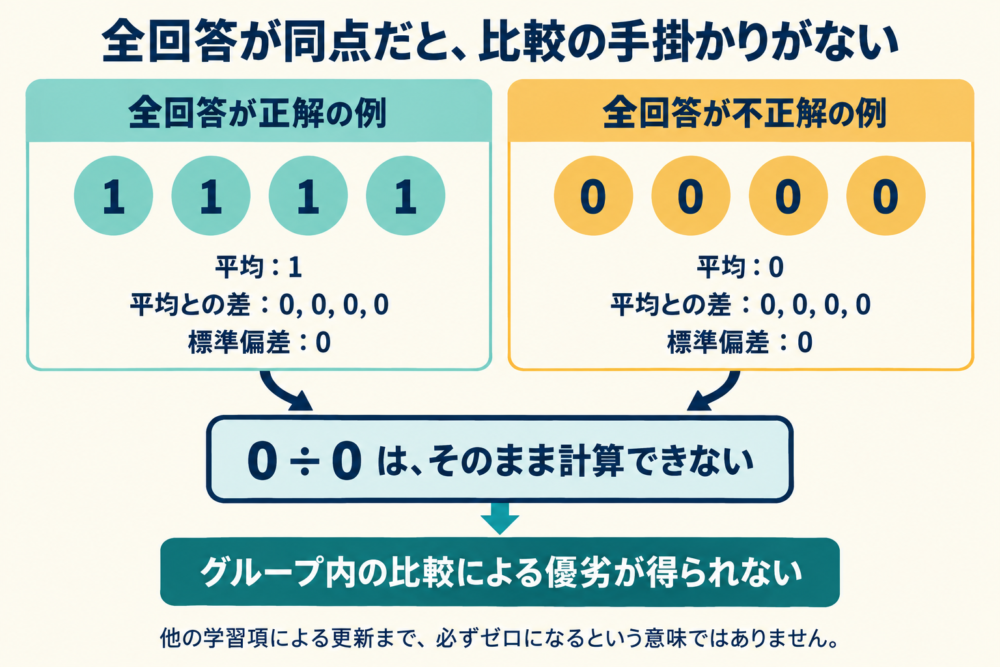
*同点では比較による優劣が得られないことを示す独自図です。実装上のゼロ除算対策と、別の学習項は区別します。*
全問正解はモデルにとって問題が簡単な可能性があり、全問不正解は難しすぎる可能性があります。いずれも点数だけでは原因を確定できないため、回答と採点処理を合わせて確認します。TRL(言語モデルの追加学習用ライブラリ)にも、報酬の標準偏差が0のグループを監視する指標があります。Hugging Face:GRPO Trainer
省けるのは価値モデル。採点の仕組みは必要
GRPOの特徴は、典型的なPPOによるLLM学習で用いる価値モデルを省けることです。PPO(更新が急激になりすぎないようにする強化学習手法)では、生成途中から期待できる報酬などを価値モデルで推定し、実際の報酬と比べて学習の手掛かりを作ります。
GRPOは、その基準を同じ問題への回答群から推定します。別の価値モデルを学習・保持する負担を減らせる一方で、比較用の複数回答を生成する処理は必要です。
ここでは、価値モデルと報酬モデルを分けて理解することが大切です。
| 役割 | 何をするか | GRPOではどうなるか |
|---|---|---|
| 方策モデル | 問題から回答を生成する | 学習対象として使う |
| 報酬モデル・報酬関数 | 生成した回答を採点する | 採点の仕組みとして必要 |
| 価値モデル | 途中の状態から期待報酬などを推定する | 原論文のGRPOでは使わず、回答群の比較へ置き換える |
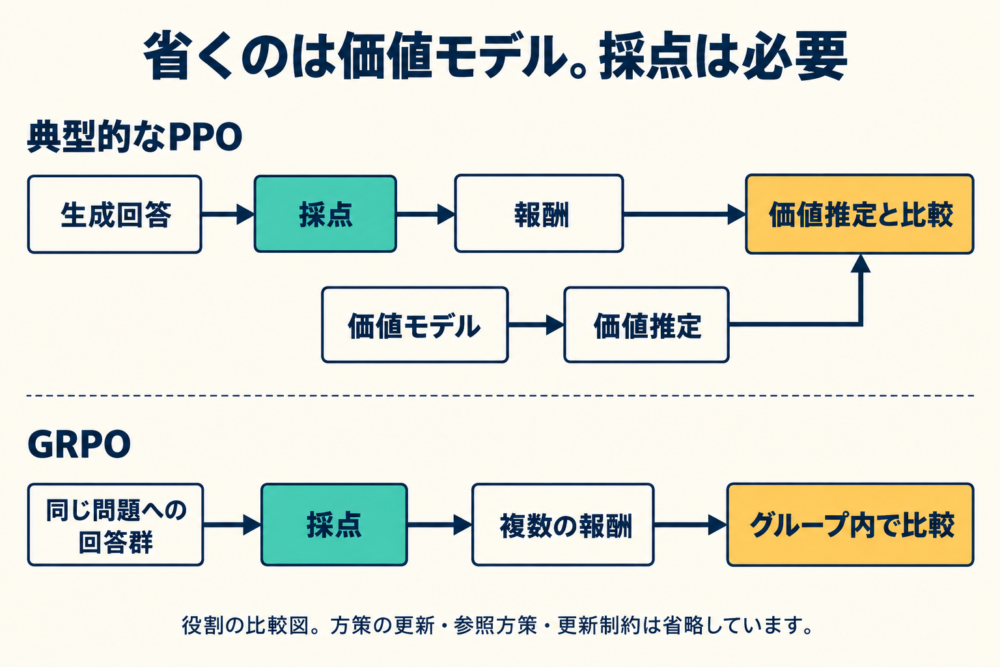
*原論文の役割を再構成した独自図です。方策の更新、参照方策、更新制約などは省略しています。*
DeepSeekMathの原論文は報酬モデルを使っています。一方、検証可能な課題では正誤判定のルールなどを報酬関数として用いる構成もあります。「GRPOだから報酬モデルが必ず不要」ではなく、何を採点に使うかは課題と設計によって変わります。DeepSeekMath・GRPOの説明、TRLの報酬関数
平均以上の回答を、無制限に強めるわけではない
良い点数の回答を強め続けるだけでは、更新が急激になったり、採点方法の偏りに引っ張られたりする可能性があります。原論文のGRPOには、更新を制御する仕組みも含まれます。
| 仕組み | 比較するもの | 役割 |
|---|---|---|
| クリッピング | 現在の方策と、回答生成時の古い方策の確率比 | 大きな変化を学習目的上で抑制する |
| KLダイバージェンス(確率分布の隔たりの指標)による制約 | 現在の方策と参照方策 | 基準となる分布から離れすぎることを抑える |
回答生成時の古い方策と、KLの基準にする参照方策は、役割が違います。また、クリッピングはモデルの確率を直接切り詰める操作ではなく、更新の目的関数に組み込まれた制御です。DeepSeekMath・4.1.1節
PPO・DPOとの違い
DPO(好ましい回答と好ましくない回答の組から直接学習する手法)も、LLMを望ましい回答へ調整する方法です。ただし、基本形で使うデータと学習の進め方がGRPOとは異なります。
| 比較軸 | PPOによる典型的なLLM学習 | GRPO | DPOの基本形 |
|---|---|---|---|
| 主な材料 | 生成回答の報酬と価値推定 | 同一問題への回答群の報酬 | 好ましい・好ましくない回答のペア |
| 評価の基準 | 価値モデルによる推定 | グループ内の相対評価 | ペア内の選好 |
| 価値モデル | 利用する | 不要 | 不要 |
| 学習中の回答生成 | 通常は必要 | 複数回答を生成する | 固定の選好データで学習できる |
| 主な負担・注意点 | 価値推定の学習とメモリ | 生成量、採点品質、同点グループ | 選好データの品質と偏り |
この表は、どれが常に最良かを示すものではありません。用意できるデータ、採点方法、生成に使える計算資源によって判断が変わります。基礎はRLHFの仕組みとDPOの解説も参照してください。
DeepSeekMath論文の結果をどう読むか
原論文では、DeepSeekMath-Instruct 7Bを基に強化学習したDeepSeekMath-RL 7Bを評価しています。7Bは約70億のパラメータ規模を表します。途中の推論を文章で生成する評価条件では、次の結果が報告されています。
| 数学問題の評価データ | Instruct 7B | RL 7B | 差 |
|---|---|---|---|
| GSM8K | 82.9% | 88.2% | +5.3ポイント |
| MATH | 46.8% | 51.7% | +4.9ポイント |
出典はDeepSeekMath・Table 5と4.2節です。これは原論文のモデル・データ・採点・評価条件での結果であり、本記事による再測定ではありません。
また、このモデルには事前学習と教師ありの追加学習も行われています。数学性能のすべてをGRPO単独の効果と考えたり、別のモデルへ同じ改善幅を当てはめたりはできません。論文には複数回答の多数決による別の評価もありますが、上の数値とは分けて読む必要があります。公式モデル・評価情報
現在の実装を使うときに確認したいこと
「GRPO Trainer」という名前でも、原論文の式や設定をそのまま使うとは限りません。2026年9月14日に確認したTRLの公式文書では、KL項の係数は既定で0、損失関数の種類は既定でdapoとされています。報酬の標準偏差による調整にも選択肢があります。TRL:GRPO Trainer
再現や比較をするなら、ライブラリの版とともに、少なくとも次を記録すると違いを追いやすくなります。
- 一つの問題から生成する回答数と、回答の最大長
- 報酬の定義と、複数の報酬を合わせる方法
- 標準偏差の計算方法、正規化の範囲、同点時の処理
- 損失関数の種類、クリッピング、KL項の有無
- 学習用と評価用の問題の分け方
報酬が形式だけを見ていれば、内容が誤っていても高得点になることがあります。本文の長さ、正解率、報酬を別々に確認し、採点ルールを満たすことと本来の目的を達成することが一致しているかを調べます。これは原論文の性能値とは別に、運用時に必要な評価の視点です。
よくある疑問
GRPOを使うと、回答時にも毎回複数回答が必要?
学習時に複数回答を生成することと、学習後の利用時に何回答を出すかは別です。GRPOで学習したモデルを、一回の回答生成で利用することもできます。
グループ内で一番なら正しい回答?
相対評価で分かるのは、その採点基準で平均より良いかどうかです。全回答の品質が低ければ、平均より高い回答でも望ましい水準に届かない場合があります。正しさは報酬の設計と独立した評価でも確認します。
必ず省メモリ・高速になる?
価値モデルを省く点では負担を減らせますが、複数回答の生成と採点には計算が必要です。総メモリや所要時間は、モデルの大きさ、回答数、回答長、実装によって変わります。
GRPOを読むときは、「同じ問題で比較する」「採点と価値推定を分ける」「相対評価だけでなく更新制約もある」の三点を押さえると、式と処理の対応を追いやすくなります。
参考資料
- Zhihong Shaoほか:DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models v3
- DeepSeek-Math:公式リポジトリ
- Hugging Face TRL:GRPO Trainer
本記事の四回答の計算は独自の教材例です。原論文の図版・コードは転載せず、モデル学習や性能測定は行っていません。


コメント