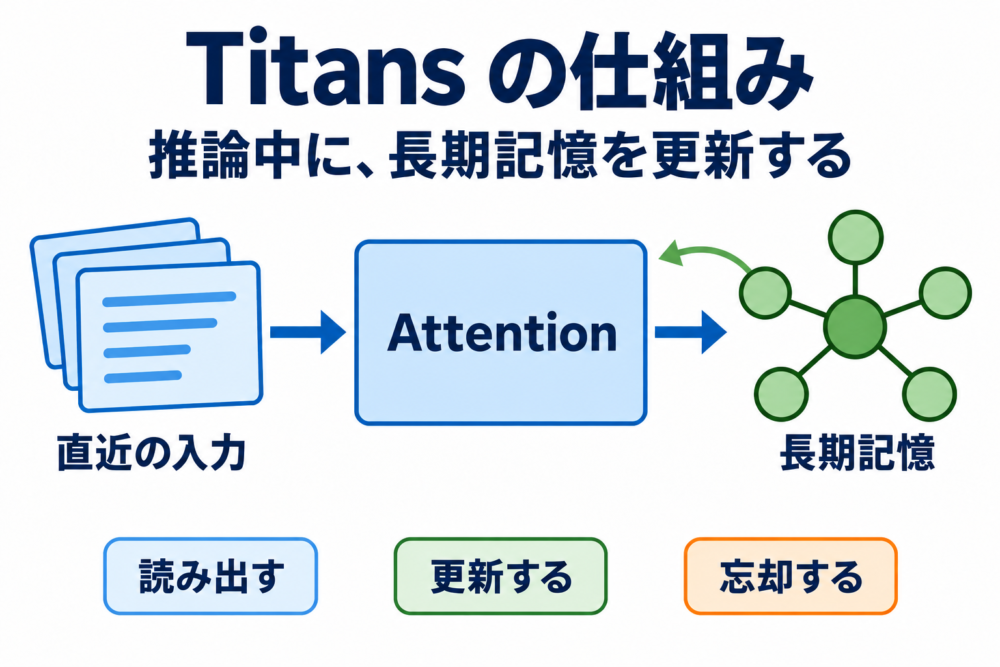
長い会話の冒頭で伝えた条件を、AIが後半でも使えるようにしたい。そのために文章を毎回すべて読み直すと、処理する履歴が大きくなります。
Titansは、直近の情報を扱うAttentionと、推論中に重みを更新する長期記憶を組み合わせるモデル設計です。 推論とは、モデルを使って入力に対する出力を計算する処理です。Titansはその処理の途中で過去の情報を記憶用ニューラルネットワークへ取り込み、必要なときにそこから情報を読み出します。
本稿は、Google ResearchのAli Behrouz、Peilin Zhong、Vahab Mirrokniによる「Titans: Learning to Memorize at Test Time」を、初学者向けに解説します。対象は2024年12月31日投稿の原論文v1です。数値例と用途例は理解のために作ったもので、製品の動作確認や独自の性能測定ではありません。
Titansの3種類の「記憶」を分ける
直近を見るAttentionと、過去を取り込む長期記憶
Attention(入力のどこを参照するかを決める処理)は、参照範囲内のトークン(文章を処理する単位)同士の関係を計算します。Titansでは、限られた範囲を詳しく見る役割を短期記憶として捉えています。
これに対して長期記憶は、過去の情報をニューラルネットワークの重み(入力を出力へ変換するための数値)に取り込みます。論文ではMLP(複数の全結合層などからなるネットワーク)を記憶用モデルとして使います。
ここでいう長期記憶は、古い文章をそのまま保存する文書ファイルではありません。入力の関係を重みに反映するため、限られた容量の中で何を残すかが問題になります。
Persistent Memoryは、推論中に固定する学習済みの情報
3つ目がPersistent Memoryです。日本語では「永続記憶」と訳せますが、アプリを終了しても会話履歴が残るという意味に取ると混乱します。
論文では、入力に依存しない学習可能なベクトル(数値の列)を用意し、タスクに関する知識を担わせます。これらは学習段階で獲得し、推論中には固定します。
| 記憶の種類 | 役割 | 推論中に変わるもの |
|---|---|---|
| 短期記憶:Attention | 直近の入力や、参照対象の関係を計算する | 入力から計算される表現や参照の重み |
| 長期記憶:Neural Memory | 過去の情報を取り込み、問い合わせに応じて読み出す | 記憶用ネットワークの重み・更新状態 |
| Persistent Memory | 入力に依存しないタスク関連の情報を与える | 学習済みベクトル自体は推論中固定 |
「推論中に学ぶ」の中心は、長期記憶用ネットワークの更新です。 モデル全体のすべての重みを、その場で再学習するという意味ではありません。
モデルの学習段階では、入力から記憶用の表現を作る変換なども学習します。そのうえで、個別の入力系列を処理するときに記憶を更新します。論文が区別する「外側の学習」と「内側の記憶更新」は、この2つの役割に対応します。
出典:Titans原論文 §3–4、Google Researchの公式解説。
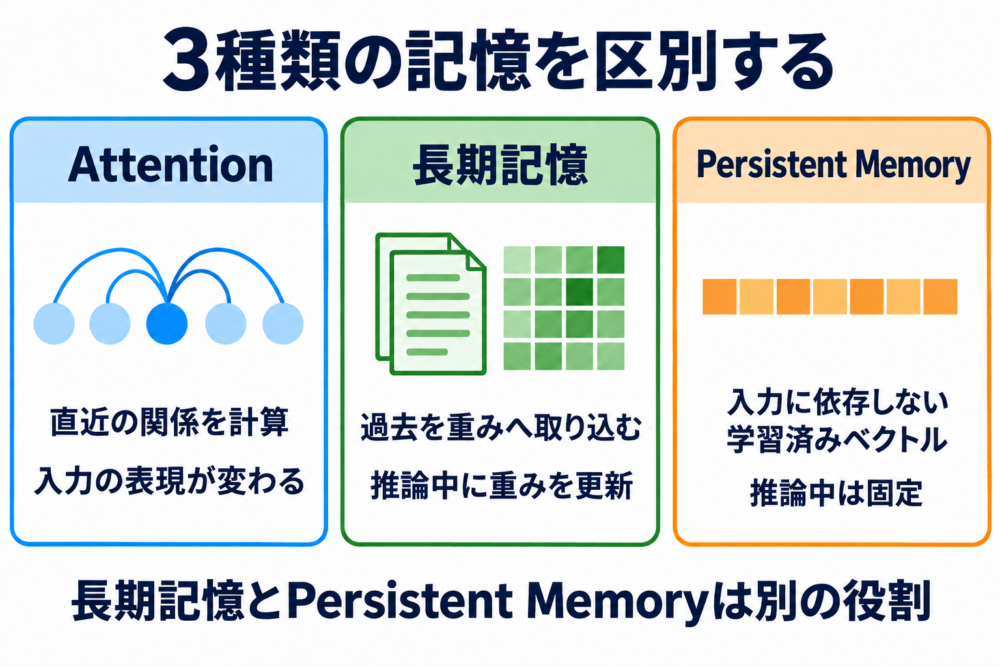
図:仕組みを説明する独自の概念図。
長期記憶への書き込みは「キーから値を出せるようにする」学習
書き込むとき:記憶の出力と目標を比べる
たとえば「会議Aの開催場所は第3会議室」という情報を後で使いたいとします。人間なら「会議A」を手掛かりに「第3会議室」を思い出します。これを、手掛かりから対応する情報を取り出す連想記憶として考えます。
Titansでは、入力の表現からキーkと値vを作ります。キーは照合や読み出しの手掛かり、値は取り出せるようにしたい情報です。実際は「会議A」「第3会議室」という文字列をそのまま辞書へ登録するのではなく、学習した変換で数値のベクトルを作ります。
現在の記憶ネットワークをMとすると、M(k)が記憶の出力です。この出力をvへ近づけるように、記憶の重みを更新します。論文の目的を表す損失関数(出力と目標のずれを数値化する式)は、次の形です。
各成分の差を2乗し、足し合わせています。出力が目標に近ければ損失は小さく、ずれていれば大きくなります。
読み出すとき:問い合わせを入力して出力を使う
読み出しでは、現在の入力からクエリq(何を取り出したいかを表す問い合わせ)を作り、記憶ネットワークへ入力します。
rは、後の処理に渡す記憶の読み出し結果です。読み出しの操作自体では重みを更新しません。 書き込みでは誤差に基づいて重みを変え、読み出しではその重みを使って出力を計算する、という違いがあります。
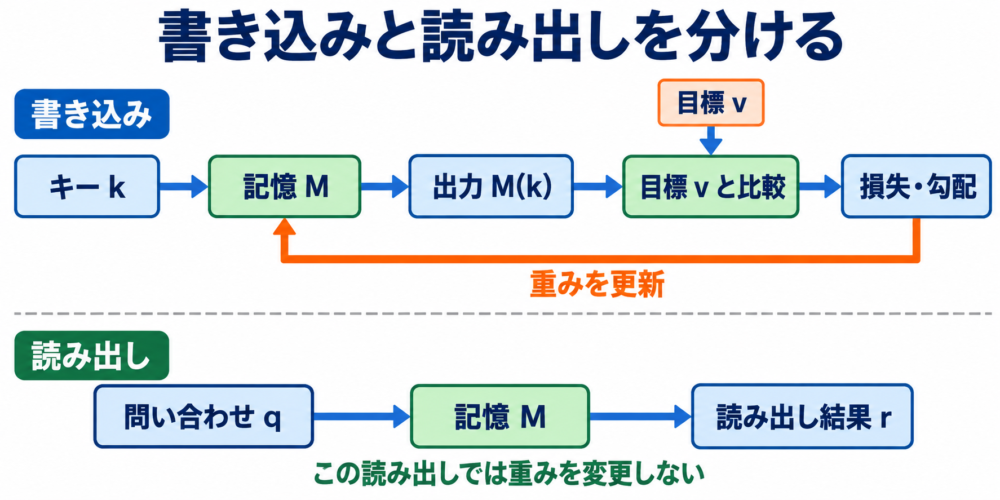
図:仕組みを説明する独自の概念図。
「驚き」は更新の手掛かり:小さな計算で確かめる
論文のSurprise(驚き)は、記憶の更新を説明するための言葉です。中心になるのは、連想記憶の損失から計算する勾配(重みを少し変えたとき、損失がどちらへどれだけ変わるか)です。
勾配は、人が感じる重要度や、ニュースとしての珍しさを直接測る数値ではありません。また、損失の大きさそのものと勾配は別です。入力やネットワークの状態も、勾配の方向と大きさに影響します。
重みが1個だけの記憶を考える
説明のため、記憶の計算をM(k)=wkとします。wだけを更新し、キーk=1から値v=3を出せるようにしたい場合を考えます。
| 項目 | 説明用の値 |
|---|---|
| 現在の重みw | 1 |
| キーk | 1 |
| 目標の値v | 3 |
| 現在の出力wk | 1 |
| 損失(wk−v)² | (1−3)²=4 |
この場合、wについての勾配は2(wk−v)kなので、2×(1−3)×1=−4です。
学習率(1回の更新をどれくらい進めるか)を説明用に0.1とすると、勾配を引く更新は次のようになります。
更新後の出力は1.4、損失は(1.4−3)²=2.56です。この1回の更新では目標の3に近づきました。ただし、一般に大きすぎる更新では損失が増える場合もあるため、この例から学習率の最適値を判断することはできません。
ここでは次節のモメンタムと忘却を省いています。実際のTitansは多くの重みを持ち、入力に応じた係数を使います。この計算は、記憶を書き換える意味を理解するための仮定例です。
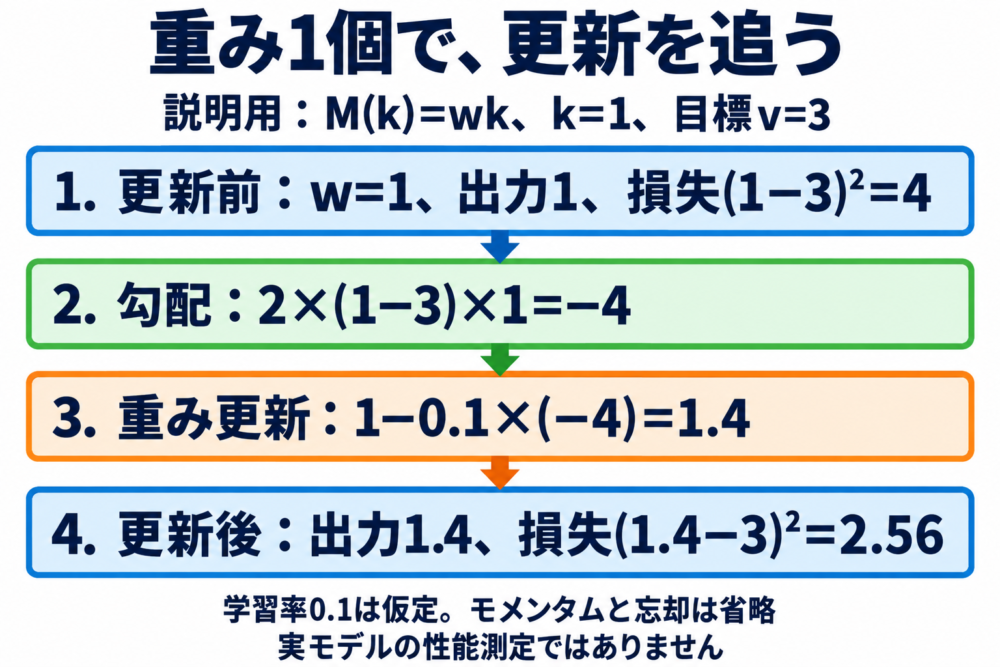
図:説明用の仮定例。実モデルの設定や性能測定ではない。
モメンタムと忘却で、更新を時間方向につなぐ
モメンタムは、直前までの更新を引き継ぐ
「会議の場所が変わりました」に続いて、変更後の場所や理由が説明される場面を考えます。最初の情報だけに強く反応し、続く関連情報を取り込めなければ、記憶が不十分になります。
論文は、現在の入力から計算した勾配に加え、直前までの更新を引き継ぐモメンタム(更新方向を持ち越す仕組み)を使います。更新状態をSと書くと、考え方は次の式で表せます。
ηは過去の更新をどれくらい引き継ぐか、θは今回の勾配をどれくらい反映するかを調整します。添字tは処理の時点です。Sは方向を持つ数値の集まりであり、「重要度が何点」という正のスコアではありません。
忘却は、古い重みの寄与を弱める
記憶の容量には限りがあります。古い情報をすべて同じ強さで保持し続けると、新しい情報の取り込みや読み出しに影響します。
そこで、過去の記憶の重みを弱める重み減衰を組み合わせます。記憶のパラメータをMと略記すると、更新は次の形です。
αが0に近ければ過去の重みを強く残し、1に近ければ過去の重みの寄与を弱くします。その後にSを加えるため、α=1にしても最終的な記憶が必ずゼロになるわけではありません。
| 係数 | 主に調整するもの | 強く反映させるときの注意 |
|---|---|---|
| θ | 今回の勾配による更新 | 入力の誤りやノイズも更新へ影響し得る |
| η | 過去の更新方向の引き継ぎ | 文脈が変わった後にも影響が残り得る |
| α | 過去の重みの減衰 | 必要な過去情報も弱まる可能性がある |
これらは入力に依存する係数です。利用者が毎回手動で決める保存設定とは異なります。また、重みの減衰は、指定した文書1件を確実に削除するデータベース操作ではありません。個別情報の完全な削除や保持期限を管理したい場合は、システムとして別に設計する必要があります。
出典:Titans原論文 §3.1、式13–14。会議の例と運用上の注意は、仕組みを踏まえた説明です。
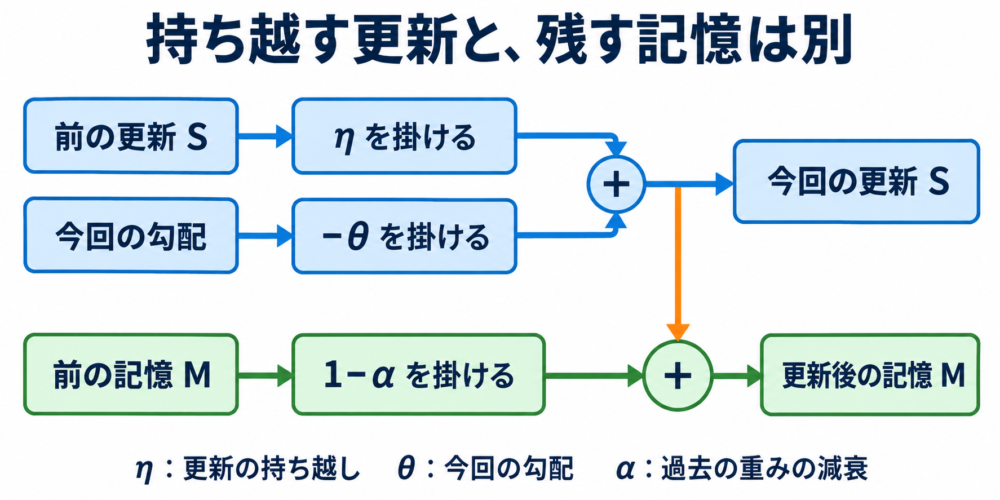
図:仕組みを説明する独自の概念図。
MAC:読み出した記憶をAttentionの入力に加える
ここまでの記憶を、実際のモデルの処理へつなぎます。論文が提案する構成の1つがMAC(Memory as a Context)です。
MACは長い入力をセグメント(一定範囲のまとまり)に分けます。現在のセグメントを処理するときの概略は、次の順序です。
- 現在の入力から問い合わせを作り、前の時点までの記憶から関連する情報を読み出す。
- Persistent Memory、読み出した情報、現在の入力を連結してAttentionへ渡す。
- Attentionの出力を使って、長期記憶を更新する。
- 更新後の記憶からの読み出しとAttentionの出力を組み合わせ、次の処理へ進む。
この配置ならAttentionは、現在の情報と読み出した過去の情報を一緒に扱えます。記憶から取り出した情報を常に同じ強さで使うのではなく、現在の文脈との関係を計算できます。
論文のMACには最後のゲート結合などもあります。ゲートとは、複数の出力をどのように通すか、組み合わせるかを調整する計算です。以下の図では時系列を優先し、残差接続や正規化などの細部を省略しています。
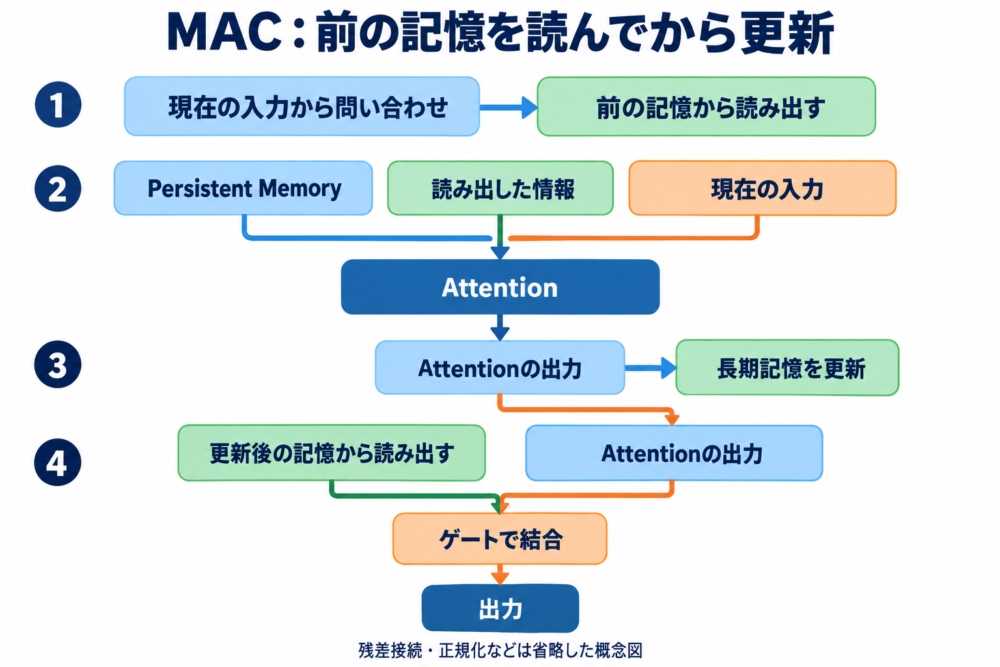
図:仕組みを説明する独自の概念図。
MAGとMALは、記憶をつなぐ場所が異なる
| 構成 | 記憶とAttentionのつなぎ方 | 理解するポイント・トレードオフ |
|---|---|---|
| MAC:Memory as a Context | 記憶の読み出し結果をAttentionの入力へ加える | Attentionが過去情報と現在情報の関係を扱える一方、入力の組み立てと更新順序が増える |
| MAG:Memory as a Gate | 記憶側とAttention側を別の経路にしてゲートで結合 | 2つの出力を並行した経路で使える一方、結合の設計が必要 |
| MAL:Memory as a Layer | 記憶の層を通してからAttentionへ渡す | 直列に接続できる一方、後段が前段で作られた表現に依存する |
MAGやMALでは、SWA(Sliding Window Attention:直近の一定範囲を参照するAttention)を使います。構成名だけで速度や品質の順位が決まるわけではなく、論文も複数の設定で比較しています。
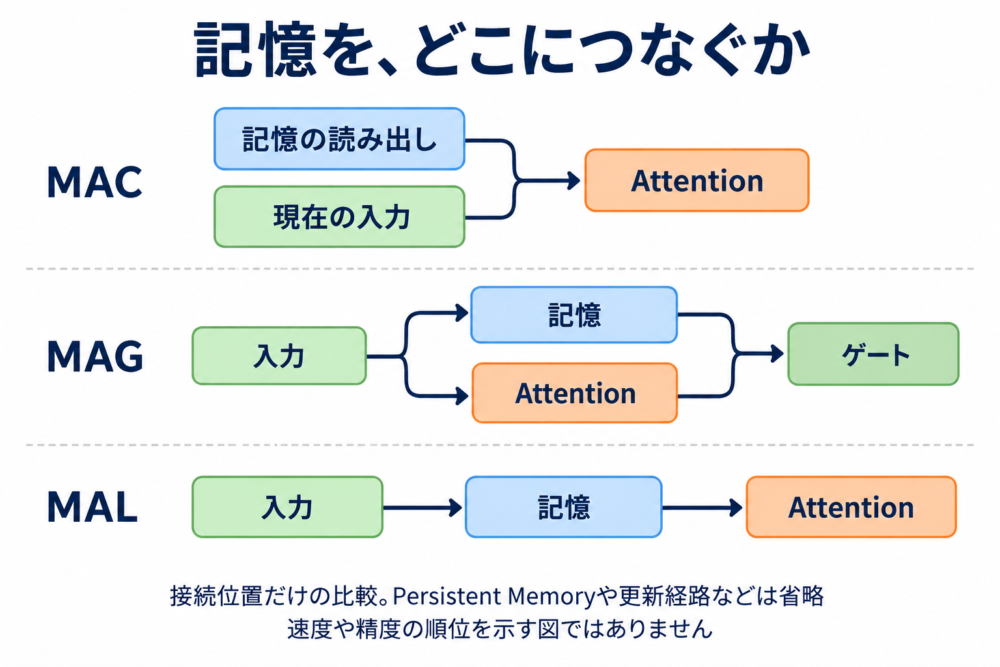
図:仕組みを説明する独自の概念図。
KV Cache・MLA・RAGとは、何を記憶しているかが違う
MLAの記事では、各トークンに対応する小さな表現を保存する仕組みを説明しています。Titansの長期記憶は、履歴の情報を記憶用ネットワークの重みに取り込む点が異なります。
| 仕組み | 主に保存・保持するもの | 利点 | 制約 |
|---|---|---|---|
| 通常のKV Cache | 各トークンのK/Vという計算済みの表現 | 過去のK/Vを作り直さずに参照できる | 保持するトークンが増えるほど容量が増える |
| MLAのキャッシュ | 各トークンのK/V共通の潜在表現など | 1トークンあたりの保存量を抑えられる | トークンに対応する履歴自体は増える |
| Titansの長期記憶 | 更新可能なネットワークの重みと更新状態 | 過去の情報を限られた構造へ取り込める | 圧縮・干渉・忘却があり、原文の完全な復元は保証しない |
| RAG | 外部文書と検索用の索引など | 検索した原文を根拠として提示しやすい | 検索漏れ、文書の鮮度、取得範囲の管理が必要 |
RAG(Retrieval-Augmented Generation)は、外部情報を検索して生成に利用する方法です。根拠となる文書を引用したい場合、記憶ネットワークが出した数値表現だけでは、原文の所在まで保証できません。この点では、検索元を保持できる設計が役立ちます。
詳しくはKV Cacheとは?LLMの生成を高速化する仕組みと、RAGとは?LLMに外部知識を使わせる仕組みも参照してください。RAGの一次資料はRetrieval-Augmented Generation for Knowledge-Intensive NLP Tasksです。
これらは完全に排他的な選択肢ではありません。ただし、組み合わせにはモデルとシステムの設計が必要であり、通常のLLMへ設定を1つ追加すればTitansになるわけではありません。
「ニューラルな記憶」とGPUのメモリを分けて考える
Titansの記憶は、モデルが情報を保持する仕組みの名前です。一方、VRAMやHBM、SRAMは、その計算に必要な数値を置く物理的なメモリです。
GPUで実行する場合、記憶ネットワークの重みや更新状態も、ほかの重み・一時データとともにメモリへ置きます。演算時には必要な部分をGPU内部の高速な領域へ読み出し、計算した結果で記憶の状態を更新します。CPUは処理の実行やデータの準備を制御します。
HBM(高帯域の大容量メモリ)とSRAM(チップ内などで使う小さく高速なメモリ)の関係は、AIのデータ経路とメモリ階層の解説で扱っています。
読み出しだけなら、記憶ネットワークを使う順方向の計算です。書き込みには、損失、勾配、更新状態の計算も加わります。長い履歴を保存するコストが減る可能性と、記憶を更新するコストの両方を見る必要があります。
原論文は、入力をチャンク(計算のまとまり)へ分け、行列積などを活用して更新を並列化する方法も示しています。式を1トークンずつ説明できることと、実装が必ず1トークンずつ直列に動くことは同じではありません。Titans原論文 §3.2
記憶用ネットワークの構造を固定できても、モデル全体の使用メモリが常に一定になるとは限りません。Attentionの参照範囲、同時に処理する系列、計算用の一時領域、実装による配置も含めて評価します。
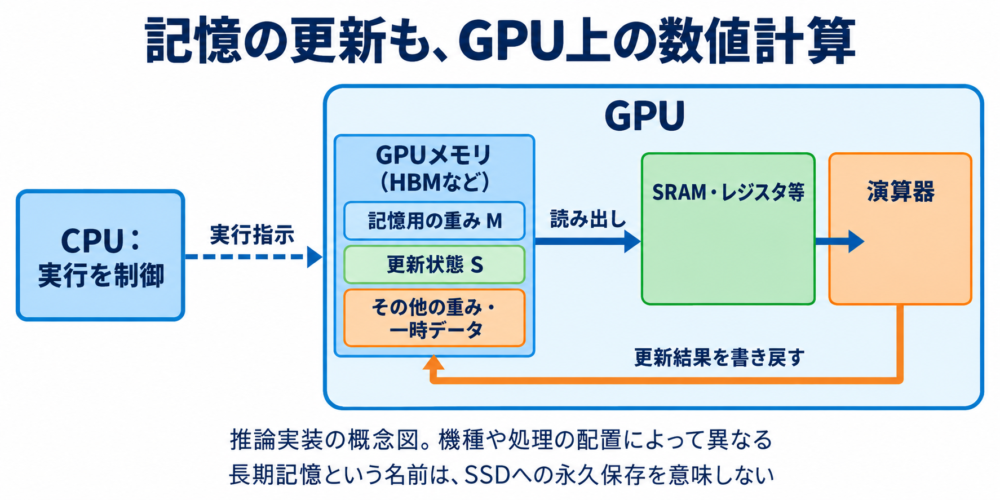
図:仕組みを説明する独自の概念図。
論文の結果から何が言えるか
原論文は、言語モデリング、常識推論、長い入力から必要な情報を探す評価、時系列予測、DNAの系列モデリングなどを扱っています。長い系列を扱う能力と、記憶モジュールの構成の効果を検証した研究です。
v1の言語モデル実験では、1.7億、3.4億、4億、7.6億パラメータの規模を扱っています。最初の3規模は150億トークン、7.6億のモデルは300億トークンで学習したと説明されています。モデル規模や学習量をそろえた比較と、用途が異なるモデル同士の比較は分けて読む必要があります。Titans原論文 §5.1
この結果だけから、現在の商用LLMよりあらゆるタスクで優れている、会話を無制限に正確に覚えられる、という結論には進めません。特定の製品にこの構造が採用されているかも、論文とは別に確認する事項です。
仕組みを踏まえた想定用途
次の表は、論文の製品実績ではなく、構造から考えた用途の整理です。
| 想定する処理 | 記憶を更新する設計が役立ちそうな理由 | 別に確認すべきこと |
|---|---|---|
| 長い技術文書の理解 | 直近の節と、前に登場した定義・条件を組み合わせられる可能性 | 定義や例外を正確に取り出せるか |
| 継続して届くログや時系列の処理 | 新しい傾向を取り込み、古い状態の影響を調整できる可能性 | ノイズや一時的な異常で記憶が偏らないか |
| 長い作業手順の追跡 | 前段の状態を、後段の判断へ渡す設計を検討できる | 手順や状態を正確に追えるか |
| 原文引用が必要な文書回答 | 記憶だけでなく検索との役割分担を検討できる | 引用元、更新日、削除や訂正を管理できるか |
実用化を検討する場合は、「覚える量」だけでなく、必要な情報を取り出せるか、誤った入力から回復できるか、系列ごとの記憶をどう分離・初期化するかも評価します。長期記憶という名前は、セッションをまたいだ永続保存やユーザー間の共有を自動的に意味しません。
Titansを読むための要点
Titansでは、記憶を単に追加保存するのではなく、専用ネットワークの重みを更新して入力の関係を取り込みます。読み出し、書き込み、更新の持ち越し、忘却を分けると、「推論中に学ぶ」という表現を具体的な計算として追えます。
論文をさらに読む際は、§3.1で記憶の更新、§4でAttentionとの接続、§5で評価条件を確認すると、仕組みと結果を結び付けやすくなります。
参考資料
- Ali Behrouz, Peilin Zhong, Vahab Mirrokni:Titans: Learning to Memorize at Test Time(原論文v1)
- Google Research:Titans論文紹介
- Google Research:Titans + MIRAS: Helping AI have long-term memory
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
図は仕組みを説明する独自の概念図です。数値例と用途例は説明のための仮定であり、実測結果ではありません。資料確認日:2026年9月20日。
コメント