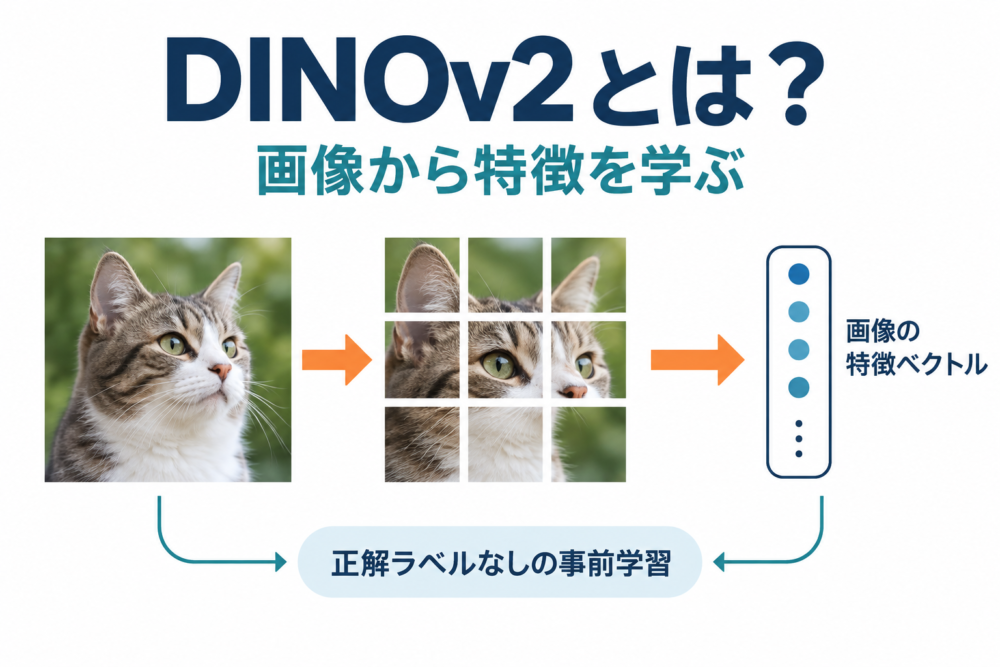
DINOv2は、画像を分類や検索に使える特徴量(画像の性質を数値の並びで表したもの)へ変換するモデルです。事前学習では「この画像は猫」といった人手の正解ラベルを使わず、同じ画像の異なる見え方から共通する情報を学びます。ただし、特徴量を「猫」「犬」などの答えに結び付ける処理は別に必要であり、用途によってはそこでラベル付きデータを使います。
本記事は、Metaなどの研究者による原論文「DINOv2: Learning Robust Visual Features without Supervision」v2を基に、学習の仕組みと、使う際にどこまでをモデルが担当するのかを解説します。図は理解のための独自の概念図で、モデルを実行して得た出力ではありません。
DINOv2が返すのは、画像を比べたり判別したりするための特徴
たとえば、手元に猫の写真がたくさんあり、似た写真を探したいとします。画像をそのまま画素の値で比べると、撮影位置や明るさが変わっただけで大きな違いになりかねません。被写体の形や部分の関係を捉えた特徴量に変換できれば、検索や分類の材料として使いやすくなります。
DINOv2は、この特徴を取り出すバックボーン(画像処理の基礎となる特徴抽出モデル)として使えます。入力画像から数値表現を取り出す段階と、それを使って答えを決める段階を分けるのがポイントです。
| 取り出す特徴 | 何を表すか | 利用例 | そのままでは決まらないこと |
|---|---|---|---|
| 画像全体の特徴 | 1枚の画像をまとめた数値表現 | 類似画像検索、画像分類 | 「猫」などのクラス名 |
| パッチごとの特徴 | 画像を区切った領域ごとの数値表現 | 領域の対応付け、セグメンテーション、深度推定 | 各画素の意味ラベルや距離 |

*原論文を基にした独自の概念図です。色や棒の値は説明用で、実際の特徴量や意味ラベルを示しません。*
パッチは画像を小さな区画に分けたものです。セグメンテーションは画像を意味のある領域に分ける処理、深度推定は画像から奥行きを推定する処理を指します。DINOv2が使うViT(Vision Transformer、画像の区画間の関係を学ぶモデル)では、区画ごとの情報を相互に参照して処理します。そのため、パッチの特徴も、その区画の色だけを記録したものではありません。
ViTに画像を入力する方法から確認したい場合は、ViTとは?画像をパッチとして読むTransformerも参照してください。
正解ラベルがないのに「教師」がいる理由
DINOv2は、自己教師あり学習(データ自体から学習の手がかりを作る方法)を使います。学習中には教師モデルと生徒モデルが登場しますが、この教師は人が画像へ書き込んだ正解ラベルを意味しません。
同じ猫の写真から、広めに切り出した画像と、拡大したり色合いを変えたりした画像を用意する場面を考えてみます。見える範囲や色が変わっても、元になった画像は同じです。この関係を利用し、生徒側の予測を教師側の予測へ近づけるように学びます。
ここで近づけるのは、単純に画像の画素を一致させた値ではなく、特徴を学習用の処理へ通した出力分布です。教師が「猫」という文字列を答え、生徒がそれを暗記する仕組みとは異なります。原論文4節
教師は生徒の過去の状態からゆっくり更新する
生徒は予測のずれを基にパラメーター(モデル内部の学習する数値)を更新します。一方、教師は生徒のパラメーターの指数移動平均(最近の値を重視しながら過去の値も残す平均)で更新します。教師に別の正解付き画像集を渡して、先に猫の名前を教える必要はありません。

*原論文4節を基にした独自図です。二つの棒グラフは学習用の出力分布を表し、猫・犬などのクラス確率ではありません。写真と切り出しも説明用の生成画像です。*
たとえば、説明用に教師のある値を10、生徒の値を12、過去の教師を残す割合を0.9とすると、更新後の教師は次の値です。
これは平均の意味を示す計算例で、DINOv2の実際の重みや学習設定ではありません。生徒の値へ一度に置き換えず、少しずつ反映する関係を表しています。
ただし、二つのモデルの予測を近づけるだけでは、何を入れても同じ出力を返す状態に陥るおそれがあります。DINOv2では出力の偏りを調整する処理や、特徴が狭い範囲へ集中しすぎないための処理も組み合わせています。教師と生徒という役割だけで学習方法の全体が決まるわけではありません。原論文4節
画像全体と、隠したパッチの両方から学ぶ
DINOv2の学習は、大きく二つの単位に分けて読むと理解しやすくなります。
| 学習の単位 | 生徒へ渡すもの | 近づける対象 | 学びたい関係 |
|---|---|---|---|
| 画像全体 | 同じ画像から作った異なる見え方 | 教師の画像全体の出力分布 | 見える範囲などが変わっても共通する情報 |
| パッチ | 一部をマスクして隠した画像 | 隠した位置に対応する教師の出力分布 | 周囲の情報も使った部分の表現 |
画像全体の学習はDINO、パッチの学習はiBOTという先行研究の考え方を組み合わせています。パッチ側では生徒の入力の一部を隠す一方、教師にはその位置が見える入力を渡します。生徒は隠れた位置について、教師が返した表現を学習の目標にします。原論文4節

*原論文4節を基にした独自図です。区画の数とマスク位置は説明用で、モデルの実出力ではありません。*
ここでの目標は教師の表現なので、隠した画素を写真として描き直すこととは区別できます。最終的に欲しいのは、画像を分類したり、画像同士の部分を対応付けたりする際に役立つ特徴です。
また、パッチの特徴を色で表示して似た部分が同じ色に見えても、その色が自動的に「猫の耳」「背景」という名前を持つわけではありません。特徴の可視化と、意味ラベルを出すセグメンテーションは、結果の読み方を分ける必要があります。
初代DINOから何が変わったのか
DINOv2は、教師と生徒という一つの着想だけでなく、学習データの選び方と大規模な学習を安定して進める工夫を合わせた研究です。
| 比較軸 | 初代DINOの基本的な考え方 | DINOv2で重視した点 | 利点と負担 |
|---|---|---|---|
| 学習対象 | 同じ画像の異なる見え方から画像全体の表現を学ぶ | 画像全体とパッチの学習を組み合わせる | 部分の表現も扱える一方、学習する処理が増える |
| データ | 画像から学習の手がかりを作る | 大きな画像集合を選別し、重複や偏りを減らす | 多様な情報を取り込める一方、収集・選別にも計算が必要 |
| 学習の規模 | 教師・生徒を用いる自己蒸留が基礎 | 大規模化に合わせて安定性とメモリー効率を改善する | 大きなモデルを学習しやすくなるが、学習自体の負担は大きい |
原論文では、選別した約1億4,200万枚の画像からなるLVD-142Mを使います。単に画像を大量に集めるだけでなく、似すぎた画像を除いたり、整理済みの画像に近い画像を探したりする処理を挟んでいます。ラベルなしで学ぶことと、データの準備が不要であることは別です。原論文3〜5節
利用者が学習済みモデルを使う場合、この規模の事前学習を最初からやり直す必要はありません。ただし、撮影対象や画像の種類が変わっても期待どおりに働くかは、自分のデータで確認します。
分類・検索・深度推定には何を追加するのか
DINOv2の特徴を使う方法は、目的によって変わります。「学習済みの特徴をそのまま使える」という説明は、主にバックボーンを再学習しなくても利用できるという意味で読むと、役割を整理しやすくなります。
| 目的 | 特徴を取り出した後の処理 | 準備・確認するもの |
|---|---|---|
| 似た画像を探す | 特徴同士の近さを計算して検索する | 画像集合、距離の計算方法、期待する検索結果 |
| 猫・犬などに分類する | 特徴からクラスを決める分類器を使う | 対象クラス、分類器の学習用ラベル、評価用データ |
| 画像を意味ごとの領域に分ける | パッチ特徴を使うタスク用の処理を追加する | 対応する学習済みヘッド、または領域ラベル付きデータ |
| 深度を推定する | 特徴から深度を予測する処理を追加する | 対応する学習済みヘッド、出力の意味と評価条件 |
ヘッドは、特徴量を最終的な答えへ変換する処理部分です。DINOv2公式リポジトリには、バックボーンに加えて分類・セグメンテーション・深度推定用のヘッドや利用例が用意されています。モデル本体が画像を読めることと、自分の用途に合う答えが得られることを分けて確認できます。
「凍結した特徴で高精度」は、何も学習していないという意味ではない
凍結とは、事前学習済みのバックボーンを更新しないことです。その出力の上に載せる分類器だけを、正解ラベル付きデータで学習することがあります。

*凍結特徴を使った分類の独自概念図です。猫・犬は分類先の候補で、二つを同時に正解として出力する意味ではありません。*
原論文のTable 5では、ImageNet-1k(1,000クラスの画像分類データセット)に対して、次の結果を報告しています。
| モデルと入力解像度 | 特徴を凍結し、線形分類器を学習 | バックボーンも含めて追加学習 |
|---|---|---|
| ViT-g/14、224×224 | 86.5% | 88.5% |
| ViT-g/14、448×448 | 86.7% | 88.9% |
数値は、最も高いスコアのクラスが正解だった割合であるTop-1 accuracyです。同じ入力解像度の行で見ると、追加学習による差は2.0ポイントと2.2ポイントです。これは原論文の評価条件での結果であり、手元の猫写真や製品画像で同じ精度になることを意味しません。原論文7.1節・Table 5
この結果から読み取りたいのは、「ラベルが一切なくても86.5%」ということではなく、汎用的な特徴を学んだバックボーンを固定しても、別途学習する分類器へ利用できるという点です。
よくある疑問
DINOv2は画像生成AIですか?
DINOv2の基本的な役割は、入力画像の特徴を取り出すことです。文章から新しい写真を描くモデルとは目的が異なります。特徴を別のシステムの材料に使う場合も、画像生成などの処理はそのシステム側が担当します。
正解ラベルはまったく必要ないのですか?
原論文の特徴抽出モデルの事前学習では、人手のクラスラベルを学習目標に使いません。ただし、目的に合わせた分類器などの学習や性能評価ではラベルを使う場合があります。自分でラベルを用意せず公開済みヘッドを使う場合も、そのヘッドが何を学んだものかを確認します。
DINOv2を使えば、写真の各部分の名前も分かりますか?
パッチ特徴だけで、各部分に意味のある名前が付くとは限りません。猫の耳と背景を別の色で表示できたとしても、その表示は特徴の違いを可視化したものかもしれません。必要なのが特徴の比較なのか、意味ラベルの出力なのかを先に決めると、追加する処理を選びやすくなります。
商用利用はできますか?
2026年9月14日に確認した公式リポジトリでは、元のDINOv2のコードとモデル重みはApache License 2.0で提供されています。同じリポジトリには別の条件を持つ派生モデルも掲載されているため、使うモデルと対応するライセンスを確認してください。本記事では重みやコードを再配布せず、原論文の図も転載していません。DINOv2公式リポジトリ・License

コメント