ROC曲線は、分類モデルの判定しきい値を変えたときに、陽性を拾える割合と、陰性を誤って拾う割合がどう変わるかを示すグラフです。AUCはその曲線の下の面積で、陽性を陰性より高いスコアに並べられるかを要約します。ただし、実際の誤検知件数や採用するしきい値は、AUCと分けて確認する必要があります。
この記事では機械学習の二値分類を対象に、6件の架空データからROC曲線とAUCを計算します。その後、PR曲線(適合率と再現率の関係を示すグラフ)との違いを、1万件を判定する例で確かめます。
ROC曲線は、しきい値を動かしたときの評価を表す
分類モデルは、対象が陽性らしいほど高くなるスコアを出します。ここでいう陽性は「検知したい側」で、たとえば迷惑メール判定なら迷惑メールを指します。スコアがある値以上なら陽性と判定する、その境界がしきい値です。
ROC(Receiver Operating Characteristic、受信者動作特性)曲線は、横軸に偽陽性率、縦軸に真陽性率を取ります。
| 指標 | 計算 | 分母にする集団 |
|---|---|---|
| 真陽性率 TPR | TP ÷ (TP + FN) | 実際に陽性の全件 |
| 偽陽性率 FPR | FP ÷ (FP + TN) | 実際に陰性の全件 |
TPは正しく拾った陽性、FNは見逃した陽性、FPは誤って拾った陰性、TNは正しく除外した陰性です。TPRは再現率と同じで、感度とも呼ばれます。FPRは「1 − 特異度」に相当します。
FPRの分母は「陽性と予測した件数」ではありません。 予測陽性の中でどれだけ正解したかを見る適合率とは、母集団が違います。4つの件数や適合率の計算を確認したい場合は、適合率・再現率・F1スコアの解説を参照してください。
同じスコアのまましきい値を下げると、陽性と判定される対象が増えます。実際の陽性を拾えばTPRが上がり、実際の陰性を拾えばFPRが上がります。ROC曲線では、この変化を点として並べます。基本的な軸と読み方はGoogleの「分類: ROC と AUC」でも説明されています。
6件のスコアからROC曲線を描く
次の6件を考えます。説明用に作った数値で、モデルを実際に学習した結果ではありません。陽性が3件、陰性が3件あり、スコアの高い順に並んでいます。
| 対象 | 実際のクラス | スコア |
|---|---|---|
| A | 陽性 | 0.95 |
| B | 陰性 | 0.85 |
| C | 陽性 | 0.75 |
| D | 陽性 | 0.65 |
| E | 陰性 | 0.45 |
| F | 陰性 | 0.15 |
「スコアがしきい値以上なら陽性」という規則で、しきい値を高い方から下げます。TPRの分母もFPRの分母も、この例では3です。
| しきい値 | 陽性と判定する対象 | TP | FP | TPR(縦軸) | FPR(横軸) |
|---|---|---|---|---|---|
| 0.95より大きい | なし | 0 | 0 | 0 | 0 |
| 0.95 | A | 1 | 0 | 1/3 | 0 |
| 0.85 | A、B | 1 | 1 | 1/3 | 1/3 |
| 0.75 | A、B、C | 2 | 1 | 2/3 | 1/3 |
| 0.65 | A、B、C、D | 3 | 1 | 1 | 1/3 |
| 0.45 | A〜E | 3 | 2 | 1 | 2/3 |
| 0.15 | 全件 | 3 | 3 | 1 | 1 |
たとえば、しきい値0.75では陽性3件中2件を拾い、陰性3件中1件を誤って拾っています。したがって、点の位置は (FPR, TPR) = (1/3, 2/3) です。
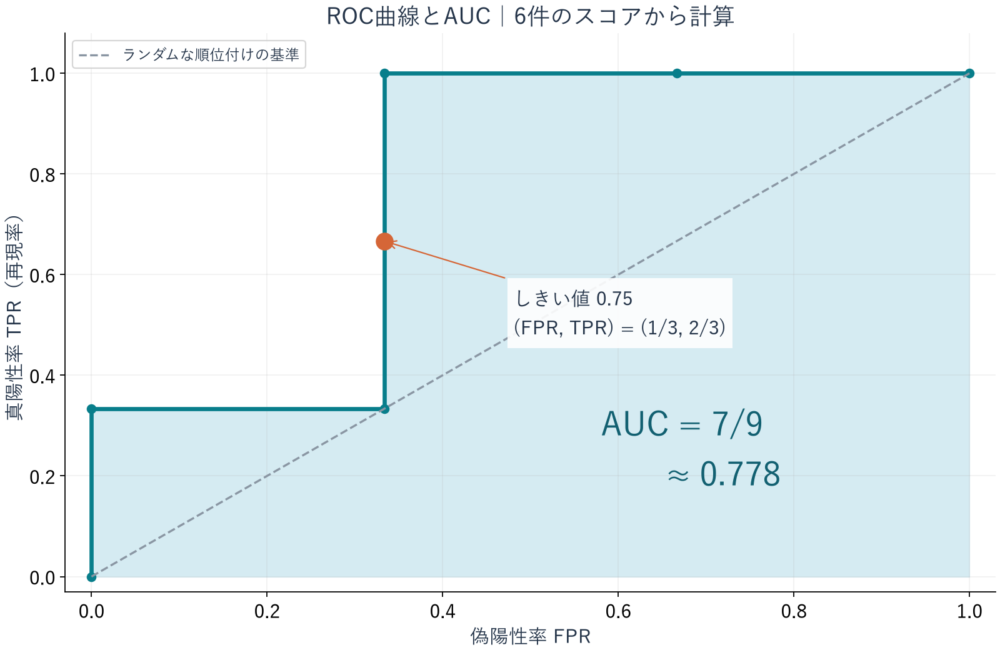
図1:本文の6件から筆者作成。点は各しきい値での計算結果、塗りつぶしはROC-AUCを表します。
しきい値0.85から0.75へ移すと、陽性Cが加わるのでグラフは上へ進みます。0.95から0.85へ移すと、陰性Bが加わるため右へ進みます。同点スコアのない今回の例では、この動きを繰り返した階段状の折れ線になります。同点がある場合は、そのスコアの対象が一度に加わります。
左上の (0, 1) は、陰性を誤検知せず、すべての陽性を拾える位置です。あるFPRで比べるならTPRが高い方が、あるTPRで比べるならFPRが低い方が望ましい、と読みます。曲線同士が交差すると、どの範囲で使うかによって優劣が変わることがあります。
AUCを面積と順位の両方で計算する
曲線の下の面積を足す
AUC(Area Under the Curve、曲線下面積)は、ここではROC曲線と横軸の間の面積を指します。PR曲線の面積との混同を避けたいときは、ROC-AUCと書きます。
今回のROC曲線では、横幅のある部分を2つにまとめられます。
| FPRの区間 | 横幅 | 曲線の高さTPR | 面積 |
|---|---|---|---|
| 0〜1/3 | 1/3 | 1/3 | 1/9 |
| 1/3〜1 | 2/3 | 1 | 2/3 |
縦に上がるだけの線は横幅が0なので面積に寄与しません。合計は 1/9 + 2/3 = 7/9 ≒ 0.778 です。
ROC-AUCは0〜1の値を取ります。1なら、対象データではすべての陽性を陰性より上位に並べています。ランダムな順位付けの基準は0.5ですが、有限件数で試した結果が必ずぴったり0.5になるわけではありません。また、AUCが0.5という要約値だけでは、曲線の各部分まで対角線と一致するとは限りません。
陽性と陰性の9組を比べる
同じAUCを、陽性と陰性を1件ずつ選んだときの順位でも確認できます。
| 陽性の対象 | 比べる陰性スコア | 陽性の方が高い組数 |
|---|---|---|
| A:0.95 | 0.85、0.45、0.15 | 3 |
| C:0.75 | 0.85、0.45、0.15 | 2 |
| D:0.65 | 0.85、0.45、0.15 | 2 |
3 × 3 = 9組のうち7組で陽性が上位なので、こちらも 7/9 です。同点があれば、その組は0.5組分として数えます。この解釈と同点の扱いは奥村晴彦氏の「ROC曲線」でも確認できます。
全スコアの大小関係を保つ変換をしても、AUCは変わりません。たとえば今回のスコアをすべて10倍しても順位は同じです。スコア0.8の対象が実際に80%の確率で陽性になるか、という確率の正確さは、AUCだけでは確かめられません。
ROC曲線とPR曲線は、見たい割合が違う
PR曲線では、横軸に再現率、縦軸に適合率を取ります。しきい値ごとに、陽性をどれだけ拾えたかと、拾った中に正解がどれだけ含まれるかを見る曲線です。
| 比較軸 | ROC曲線 | PR曲線 |
|---|---|---|
| 横軸 | FPR:陰性のうち誤って拾った割合 | Recall:陽性のうち拾えた割合 |
| 縦軸 | TPR:陽性のうち拾えた割合 | Precision:拾った中の陽性の割合 |
| 直接読みたいこと | 検出率に対し、陰性をどれだけ巻き込むか | 検出率に対し、確認対象に正解がどれだけ含まれるか |
| 注意点 | FPRが低くても、陰性が多ければ誤検知件数が増える | 陽性の割合が変わると値も変わり、異なる集団を単純比較しにくい |
6件の例のしきい値0.75では、再現率は2/3、適合率も2/(2+1)=2/3です。しきい値0.65に下げると、再現率1、適合率3/4になります。この例のように、PR曲線の適合率はしきい値を下げても単調に低下するとは限りません。scikit-learnのprecision_recall_curveには、各値の定義と端点の規約が記載されています。
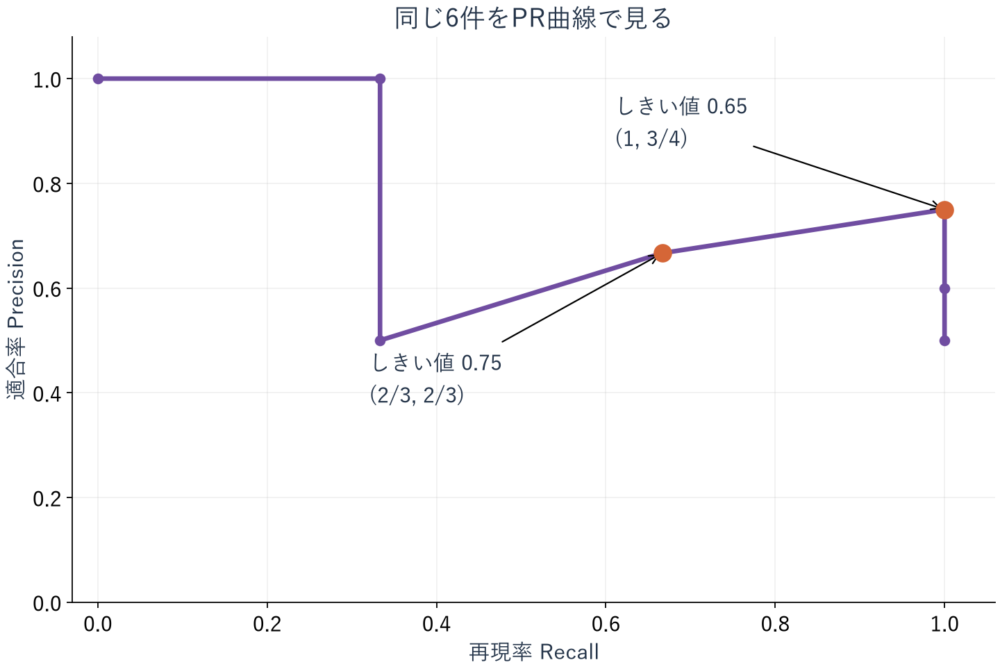
図2:同じ6件から筆者作成。点を直線で結んだ表示です。左端の(0, 1)はscikit-learnの描画用の端点で、全件陰性時の適合率を実測した値ではありません。
同じFPRでも、誤検知の負担は変わる
別の計算例として、1万件を判定し、TPRが80%、FPRが5%になる場面を考えます。陽性と陰性それぞれの中での性能は同じまま、陽性の割合だけが変わると仮定します。
| 条件 | 陽性率50% | 陽性率1% |
|---|---|---|
| 実際の陽性 | 5,000件 | 100件 |
| 実際の陰性 | 5,000件 | 9,900件 |
| TP:陽性件数 × 80% | 4,000件 | 80件 |
| FP:陰性件数 × 5% | 250件 | 495件 |
| 適合率:TP ÷ (TP + FP) | 約94.1% | 約13.9% |
ROC上は同じ (0.05, 0.8) でも、陽性率1%では、検知した575件のうち495件が誤検知です。「FPRが5%だから、検知結果の95%は正しい」とは読めません。
この差は、陽性率をpとすると次の式からも計算できます。
適合率 = (TPR × p) ÷ {TPR × p + FPR × (1 − p)}
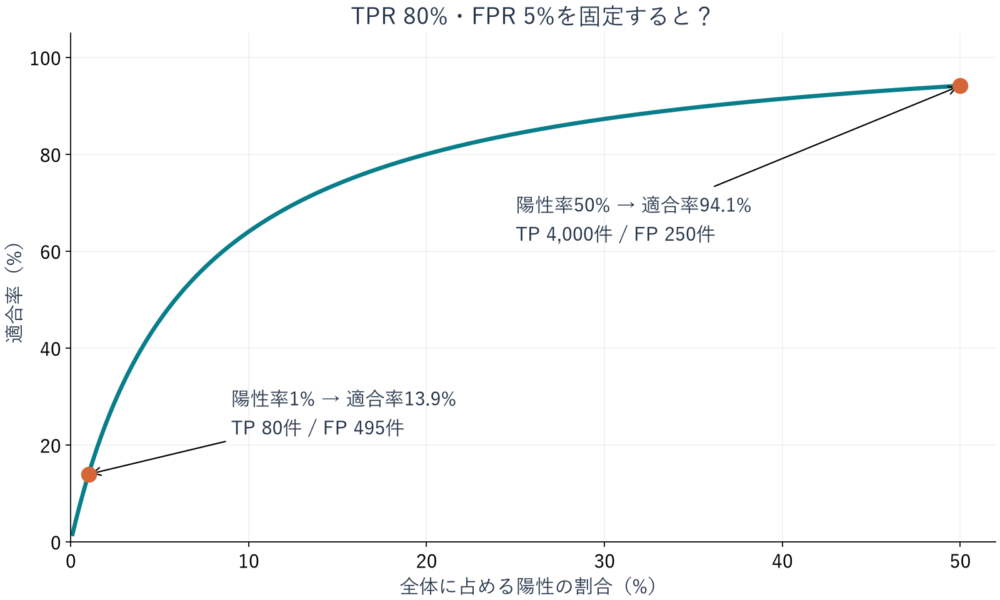
図3:上式から筆者作成。件数の注記は1万件を判定する仮定です。実モデルの性能測定ではありません。
これは条件を固定した算術例です。本番のデータが変わってもTPRとFPRが保たれる、という実験結果ではありません。少数の陽性を探し、その後に人が確認する用途では、ROCに加え、PR曲線・実際の件数・確認に使える時間を合わせて見ます。
PRの面積とAPは、計算方法を確認する
PR曲線を一つの値で表すときには、AP(Average Precision、平均適合率)も使われます。scikit-learnのAPは、再現率が増えた幅を重みにして適合率を足した値です。点を直線で結び、台形の面積を足す方法とは異なります。
今回の例では、APは (1/3) × 1 + (1/3) × (2/3) + (1/3) × (3/4) = 29/36 ≒ 0.806。後述のscikit-learnのPR座標を台形積分すると約0.764になります。「PR-AUC」とだけ記録せず、APか台形面積かを併記すると比較条件をそろえられます。average_precision_scoreの仕様も、この違いを明示しています。
Pythonで同じ計算を確認する
Pythonの機械学習ライブラリscikit-learnで、先ほどの6件を再計算できます。以下はPython 3.12.13、scikit-learn 1.9.1で実行して確認した例です。y_trueが実際のクラス、y_scoreが陽性側のスコアです。この例ではクラス1を陽性とします。
from sklearn.metrics import (
    auc,
    average_precision_score,
    precision_recall_curve,
    roc_auc_score,
    roc_curve,
)

y_true: list[int] = [1, 0, 1, 1, 0, 0]
y_score: list[float] = [0.95, 0.85, 0.75, 0.65, 0.45, 0.15]

# 表の全しきい値と照合するため、中間点を省略しない。
fpr, tpr, thresholds = roc_curve(y_true, y_score, drop_intermediate=False)
for threshold, x, y in zip(thresholds, fpr, tpr):
    print(f"threshold={threshold:.2f}, FPR={x:.3f}, TPR={y:.3f}")

precision, recall, _ = precision_recall_curve(y_true, y_score)
print(f"ROC-AUC: {roc_auc_score(y_true, y_score):.3f}")
print(f"AP: {average_precision_score(y_true, y_score):.3f}")
print(f"PR trapezoidal AUC: {auc(recall, precision):.3f}")
threshold=inf, FPR=0.000, TPR=0.000
threshold=0.95, FPR=0.000, TPR=0.333
threshold=0.85, FPR=0.333, TPR=0.333
threshold=0.75, FPR=0.333, TPR=0.667
threshold=0.65, FPR=0.333, TPR=1.000
threshold=0.45, FPR=0.667, TPR=1.000
threshold=0.15, FPR=1.000, TPR=1.000
ROC-AUC: 0.778
AP: 0.806
PR trapezoidal AUC: 0.764先頭のinfは、全件を陰性とする (0, 0) を表すしきい値です。この規約はscikit-learn 1.3以降のroc_curveの仕様に記載されています。
実モデルでは、predict()の0/1判定を渡すと、スコアの順位情報を失います。roc_auc_scoreには、陽性側の予測確率や判定前の連続スコアを渡します。predict_proba()を使う場合は、classes_で列とクラスの対応も確認してください。スコアは必ずしも0〜1の確率である必要はありません。
AUCで比較した後、運用するしきい値を選ぶ
AUCはしきい値全体を要約するため、実際に使う領域の違いを隠すことがあります。たとえば「誤検知は1,000件に1件まで」という制約があるなら、FPRが0.001付近でどれだけ陽性を拾えるかが判断材料になります。
| 用途の制約 | 確認するもの | 引き受けるトレードオフ |
|---|---|---|
| 誤報への対応件数を抑えたい | FPの件数、適合率、低FPR領域のTPR | 見逃しが増える可能性 |
| 見逃しを抑えたい | 再現率、FNの件数、そのときのFP | 確認対象が増える可能性 |
| モデルの順位付け能力を比べたい | 同じ評価データでのROC-AUCと曲線 | 運用しきい値は別途選ぶ必要 |
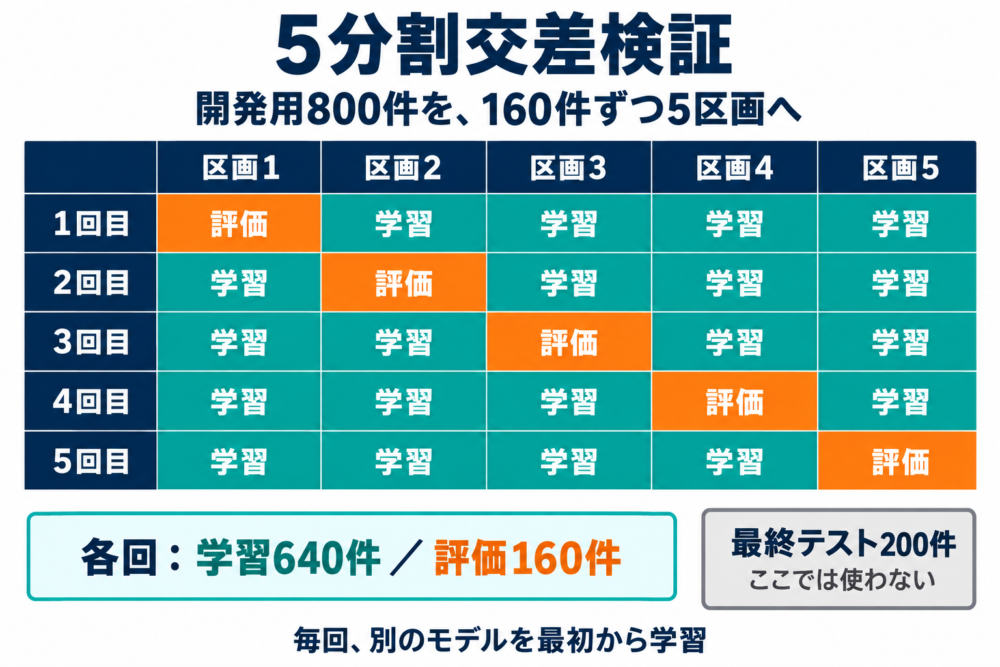
しきい値は検証用データで決め、最後に未使用のテストデータで評価します。最終テストの結果を見ながらしきい値を何度も選ぶと、そのテストに合わせ込んだ評価になってしまいます。scikit-learnのしきい値調整ガイドも、学習としきい値調整のデータを分ける必要性を説明しています。
分割方法やモデル選択の流れは、交差検証の仕組みと結果の読み方で説明しています。評価結果を記録するときは、ROC-AUCとともに、陽性の定義、評価データの陽性率、選んだしきい値、そのときのTP・FP・FNを残すと、運用上の判断につなげられます。
コメント