不均衡データとは、分類したいクラスの件数に大きな偏りがあるデータです。対策を選ぶときは、無処置のモデルを基準に、クラス重みやサンプリングを同じ検証データで比較すると、効果を判断しやすくなります。件数を1対1にそろえること自体を目標にせず、拾える陽性と誤検知の両方を確認します。
この記事では数値特徴量を使う二値分類を中心に、各手法が何を変えるのか、どこに適用するのかを整理します。後半では、同じ合成データを使って5条件を比較した結果と、Pythonの再現コードを示します。
不均衡データでは「95%正解」でも目的を果たせない
1,000件のうち正常が950件、検知したい異常が50件なら、すべてを正常と答えるだけで正解率(Accuracy)は95%になります。しかし、異常を拾えた割合である再現率(Recall)は0%です。
多い側を多数派クラス、少ない側を少数派クラスと呼びます。この例では異常を陽性、正常を陰性としますが、陽性が必ず少数派になるわけではありません。何を検知したいのかを先に決めます。
少数派の例が少ないと、学習に必要な特徴のばらつきも十分に観測できないことがあります。Googleの不均衡データ解説でも、クラスの頻度と学習時に得られる例の不足を扱っています。
見るべきなのは偏りの比率だけではありません。陽性が1%でも100万件あれば1万件、全体が100件なら1件です。同じ比率でも、検証できる量やデータを増やす必要性は変わります。適合率(検知した中の正解率)・再現率・混同行列の読み方は、適合率・再現率・F1スコアの記事にまとめています。
対策は「学習の何を変えるか」で選ぶ
| 条件・手法 | 変更するもの | 試す理由 | 注意点・トレードオフ |
|---|---|---|---|
| 無処置 | クラス比率も重みも変えない | 比較の基準を得る | 既定のしきい値では少数派を拾いにくい場合がある |
| クラス重み | クラスごとの学習時の損失への重み | 元の行を増減せず、少数派の影響を強めたい | 対応する学習器が必要。誤検知や確率の解釈も確認する |
| ランダムオーバーサンプリング | 少数派の行を復元抽出して増やす | 合成値を作らずに比較したい | 行数と計算量が増える。独立した新情報は増えない |
| ランダムアンダーサンプリング | 多数派の行を減らす | 多数派が多く、学習負担も減らしたい | 多数派の特徴や境界付近の情報を捨てる可能性がある |
| SMOTE | 少数派の近傍から合成点を作る | 数値特徴の距離や補間に意味がある | 外れ値や不自然な補間点が問題になりうる |
サンプリングは、学習に使うデータの選び直しです。オーバーは増やす側、アンダーは減らす側を指します。ここでのランダムオーバーサンプリングは単純複製で、ノイズを加える方式は扱いません。
最初は無処置とクラス重みを比べると、変更箇所を少なくできます。数値特徴の補間に意味があるならSMOTE、複製で十分か確認したいなら単純オーバーサンプリングを加えます。これは比較を始める順序の提案であり、クラス重みが常に優れるという意味ではありません。
単純複製や合成の違いはimbalanced-learnのOver-sampling、多数派を減らす方法はUnder-samplingで確認できます。
クラス重みとSMOTEを数値で見る
クラス重みは、行を増やさず損失への影響を変える
scikit-learnのclass_weight="balanced"は、各クラスの件数に反比例する重みを計算します。サンプルごとの追加重みを使わない場合、計算式は次のとおりです。
クラス重み = 全件数 ÷(クラス数 × そのクラスの件数)
陰性950件・陽性50件の例に代入すると、次の値になります。
| クラス | 1件あたりの重み | 件数 × 重み |
|---|---|---|
| 陰性 | 1,000 ÷ (2 × 950) ≒ 0.526 | 500 |
| 陽性 | 1,000 ÷ (2 × 50) = 10 | 500 |
各クラスの重みの合計は同じになります。ただし、各行の予測の外れ方によって損失は異なるため、損失の合計まで等しくなるわけではありません。重みを変えても、観測していない少数派の特徴は増えません。compute_class_weightの仕様が、この計算式の根拠です。
SMOTEは、近い少数派の点の間を補間する
SMOTE(Synthetic Minority Over-sampling Technique)は、少数派の点と、その近くにある同じクラスの点を使い、間の特徴量を合成する方法です。
たとえば2つの数値特徴を持つ点A=(1, 2)、近傍の点B=(3, 4)があるとします。AからBへ25%進んだ点なら、計算は次のようになります。
新しい点 = A + 0.25 × (B − A) = (1, 2) + 0.25 × (2, 2) = (1.5, 2.5)
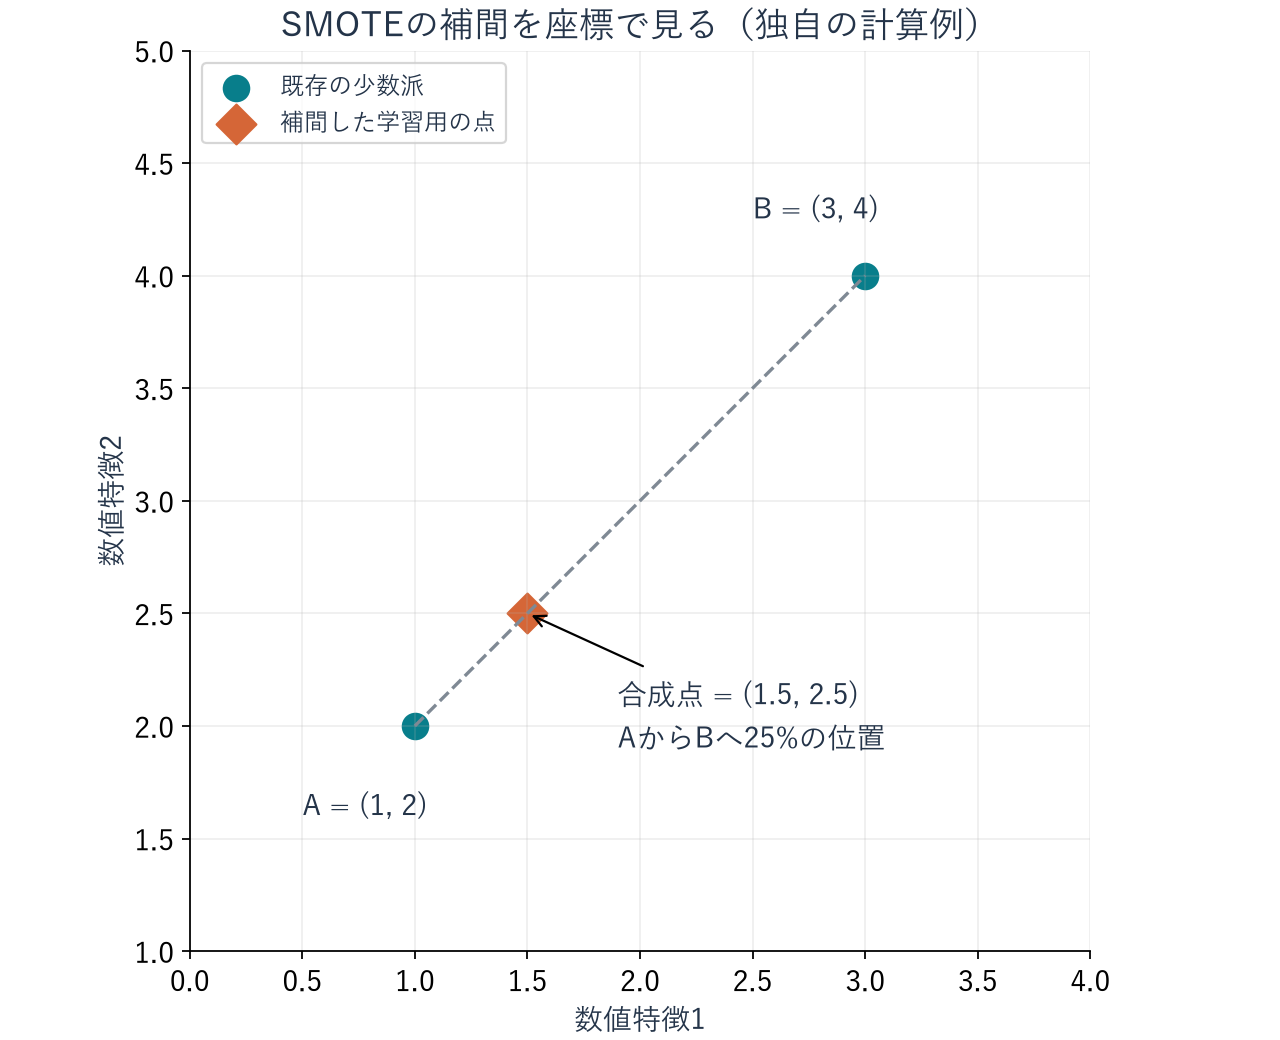
図1:補間式に独自の座標を代入して筆者作成。実データの分布や実装の出力そのものを示す図ではありません。
元の行を複製する方法と違い、元データにない座標ができます。ただし、これは新たに観測した事実ではなく、既存の少数派から合成した学習用データです。
標準のSMOTEは、特徴量間の距離や補間に意味があることが前提になります。金額と回数のように尺度が大きく違えば、距離の計算が特定の特徴に偏りやすくなるため、今回の実装では学習側で標準化してからSMOTEを適用します。
カテゴリを単に0、1、2と符号化した列では、1.5という値を作っても意味がありません。数値とカテゴリの混在ならSMOTENCなど別の扱いを検討します。また、離れた集団や外れ値の間を補間すると、不適切な点を作る場合があります。補間式とこうした制約は公式のOver-sampling解説に記載されています。
サンプリングは学習用の部分だけに適用する
データを増やしてから訓練・検証に分ける順序は避けます。 複製した同じ行や、検証対象の情報を使った合成点が訓練側に入ると、未知のデータに対する性能を測れなくなるためです。さらに、検証側まで1対1にすると、実際のクラス比率と異なる条件で適合率などを測ることになります。
交差検証(データの分割を入れ替えて評価する方法)でも、各分割の学習部分だけにサンプリングを適用します。
| 処理 | 学習部分 | 検証部分 |
|---|---|---|
| 標準化の平均・標準偏差 | この部分で計算する | 学習側の値を使って変換する |
| 再サンプリング | 必要な条件で実施する | 実施しない |
| 分類器 | 学習する | 予測して評価する |
imbalanced-learnのPipeline(前処理・サンプリング・学習を連結する仕組み)を交差検証に渡すと、この順序を管理できます。使うのはimblearn.pipeline.Pipelineです。通常のscikit-learnのPipelineに、そのままSMOTEを途中の変換器として入れる方法とは異なります。
公式のCommon pitfallsは、分割前の再サンプリングによるデータリーク(評価側の情報が学習に混入すること)と評価分布の変化を区別しています。Pipelineの仕様では、サンプリングを学習時に行い、予測時には検証行を増減させません。
なお、Pipelineだけでは時系列の順序や同一人物の重複を解決できません。データにそのような関係がある場合は、データリークと分割方法の解説に沿って、分割設計も見直します。
同じ合成データで5条件を比較した結果
ここからは、説明用に生成した数値データで筆者が実行した結果です。実際の不正検知・故障検知の性能を示すものではありません。
条件は3,000件、数値特徴10個、陽性率5%。最終評価用に600件を先に分け、残り2,400件で層化4分割(クラス比率を保つ分割)の交差検証を行いました。最終評価用の600件は、この比較では使用していません。
分類器はロジスティック回帰に統一し、正則化の設定C=1、判定しきい値0.5を固定しました。再サンプリング条件では、学習部分のクラス比率を1対1にしています。これは変更の効果を見るための設定で、推奨比率という意味ではありません。
| 条件 | AP | 適合率 | 再現率 |
|---|---|---|---|
| 無処置 | 0.513 | 0.955 | 0.258 |
| クラス重み | 0.485 | 0.130 | 0.650 |
| ランダムオーバーサンプリング | 0.476 | 0.133 | 0.658 |
| ランダムアンダーサンプリング | 0.462 | 0.134 | 0.667 |
| SMOTE | 0.473 | 0.131 | 0.650 |
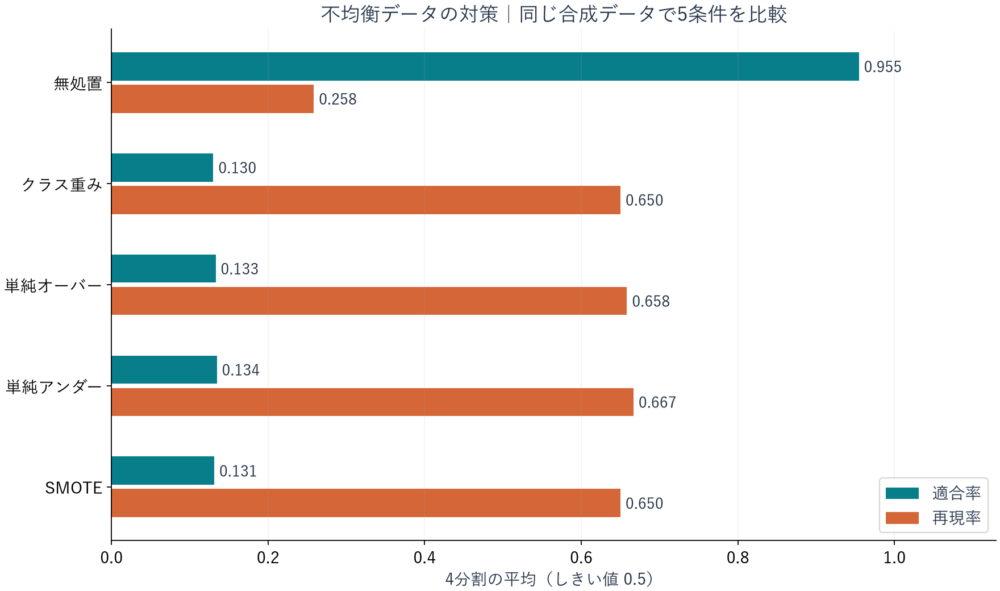
図2:筆者の合成データ実験。しきい値0.5・同じ4分割での平均です。実業務での性能や手法の優劣を保証する結果ではありません。
値は各検証分割で計算した指標の単純平均です。AP(Average Precision、平均適合率)は予測スコアの順位に基づく評価で、適合率・再現率はしきい値0.5での評価です。指標の役割はROC曲線・PR曲線とAPの解説も参照してください。
この条件では、各対策で再現率は上がりましたが、適合率は下がりました。少数派を拾う数とともに、誤検知も増えています。一方、APは無処置が最も高く、再現率の上昇だけで順位付け能力まで改善したとは言えません。
この表は、手法の普遍的な順位表ではありません。 データを生成する乱数、分割、分類器、正則化、サンプリング比率を変えれば結果は変わりえます。特に、同じ0.5を使っても重みや学習比率が変われば予測スコアの分布も変わるため、最適化後の運用性能を公平に比べ切った結果ではありません。
1回の学習に使う件数も確認しました。各分割の元の学習部分は陰性1,710件・陽性90件、検証部分は陰性570件・陽性30件です。
| 条件 | 学習に渡る陰性 / 陽性 | 検証の陰性 / 陽性 |
|---|---|---|
| 無処置・クラス重み | 1,710 / 90 | 570 / 30 |
| 単純オーバー・SMOTE | 1,710 / 1,710 | 570 / 30 |
| 単純アンダー | 90 / 90 | 570 / 30 |
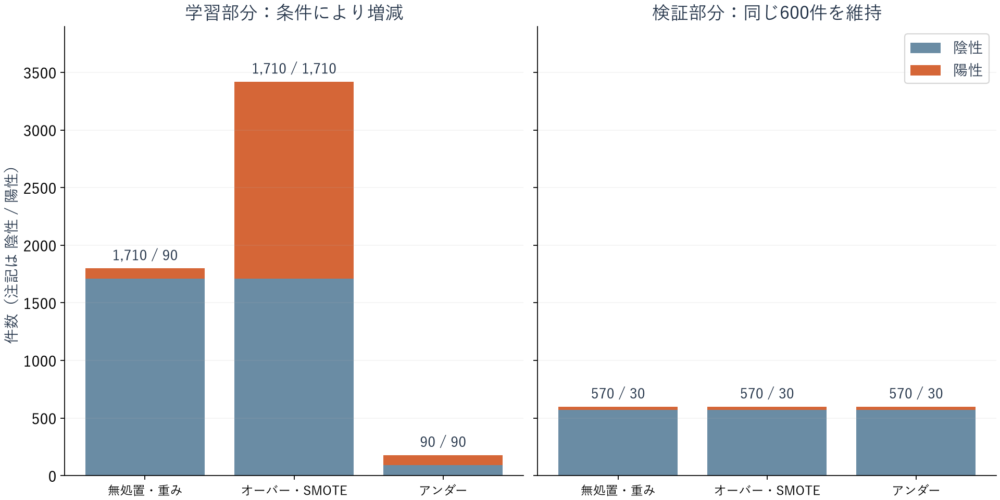
図3:実験で確認した各foldの件数。左右の縦軸をそろえて表示しています。
全条件で同じ検証行を使い、再サンプリング後も検証側の件数・内容が変わらないことを確認しています。単純アンダーでは学習件数を大幅に減らせる一方、多数派の多くを捨てていることも読み取れます。
Pythonで5条件の比較を再現する
実行環境はPython 3.12.13、NumPy 2.5.4、scikit-learn 1.7.2、imbalanced-learn 0.14.0です。既存プロジェクトと分けた仮想環境で、必要なライブラリをインストールしてください。
python -m pip install numpy==2.5.4 scikit-learn==1.7.2 imbalanced-learn==0.14.0次のコードは、上の表と同じ合成データ・分割・モデル設定で平均値を計算します。
from typing import Any
import numpy as np
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_validate, train_test_split
from sklearn.preprocessing import StandardScaler
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import RandomOverSampler, SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(
    n_samples=3000, n_features=10, n_informative=5, n_redundant=2,
    n_clusters_per_class=2, weights=[0.95, 0.05], flip_y=0,
    class_sep=1.0, random_state=42,
)
# 最終テストを比較中に使わないため、先に取り分ける。
dev, test = train_test_split(
    np.arange(len(y)), test_size=0.2, stratify=y, random_state=42
)
cv = list(StratifiedKFold(n_splits=4, shuffle=True, random_state=42)
          .split(X[dev], y[dev]))
methods: list[tuple[str, Any, str | None]] = [
    ("baseline", "passthrough", None),
    ("class_weight", "passthrough", "balanced"),
    ("random_over", RandomOverSampler(random_state=42), None),
    ("random_under", RandomUnderSampler(random_state=42), None),
    ("smote", SMOTE(random_state=42, k_neighbors=5), None),
]
for name, sampler, weight in methods:
    # Pipelineを渡すことで、各foldの学習部分だけを再サンプリングする。
    model = Pipeline([
        ("scale", StandardScaler()),
        ("sample", sampler),
        ("model", LogisticRegression(
            class_weight=weight, C=1.0, max_iter=2000, solver="lbfgs"
        )),
    ])
    result = cross_validate(
        model, X[dev], y[dev], cv=cv, n_jobs=1,
        scoring=["average_precision", "precision", "recall"],
        error_score="raise",
    )
    print(name, *(f"{result['test_' + metric].mean():.3f}"
                  for metric in ["average_precision", "precision", "recall"]))
baseline 0.513 0.955 0.258
class_weight 0.485 0.130 0.650
random_over 0.476 0.133 0.658
random_under 0.462 0.134 0.667
smote 0.473 0.131 0.650SMOTEの既定の近傍数は5です。この設定では、自分以外の近傍5件を使うため、各foldの学習部分に対象クラスが少なくとも6件必要です。各foldで少数派の件数を確認し、必要なら近傍数を下げますが、それだけでデータ不足が解決するわけではありません。SMOTEの引数の仕様も確認してください。
今回のコードは、サンプリングとモデルを比べる段階までです。重み・比率・しきい値を選び直す場合は検証側で行い、設定を確定した後に最終テストを使います。評価データの役割は、交差検証とモデル選択の解説に整理しています。
改善しないときに確認すること
| 観測した問題 | 次に確認すること |
|---|---|
| 再現率は上がったが誤報が多い | 実際の陽性率、誤検知件数、確認できる件数、検証側でのしきい値 |
| APも改善しない | 特徴量、ラベルの品質、分類器、重みやサンプリング比率 |
| foldごとの差が大きい | 少数派の絶対件数、分割の偏り、時系列・人物などの単位 |
| SMOTEで不自然な点ができる | 尺度、カテゴリ、外れ値、近傍の意味、補間できない特徴 |
| 予測確率をそのまま意思決定に使いたい | 実運用に近い分布で、確率と実際の頻度が対応するか |
クラス重みとサンプリングを同時に使うと、少数派への扱いを複数箇所で変えることになります。最初は一つずつ変更し、何によって結果が動いたかを確認すると比較しやすくなります。追加の実装例として、TensorFlowの不均衡データ分類チュートリアルも、重みとオーバーサンプリングを別条件で評価しています。
手法を選ぶ判断材料は、クラス数がそろったかどうかではなく、元の分布での見逃し・誤検知・運用負担が許容できるかです。無処置を残した比較表に、検証方法としきい値を併記しておくと、次に何を変えるべきか判断しやすくなります。
コメント