適合率は「見つけたもののうち、何割が本当の対象だったか」、再現率は「本当の対象のうち、何割を見つけられたか」を表します。同じ「正しく見つけた件数」を使いますが、割る相手が違います。F1スコアは、この2つを調和平均(小さい側の値の影響を受けやすい平均)でまとめた指標です。
どれを重視するかは、誤って対象と判定することと、本当の対象を見逃すことの、どちらが困るかで変わります。F1が最も高い条件が、業務上の損失を最も小さくするとは限りません。
この記事では、問い合わせ1,000件を「要確認/通常」に分ける架空例を使います。定義はGoogleの分類評価指標の教材とscikit-learnのPrecision-Recall解説を参照し、数値は独自に設定・計算しています。
「正例」を決めて、混同行列に並べる
二値分類(2つの種類に分ける予測)では、注目する側を正例(陽性)と呼びます。ここでは「要確認」を正例、「通常」を負例(陰性)にします。正例は「望ましい結果」という意味ではなく、検出対象として指定した側です。
実際には要確認が100件、通常が900件あるとします。ある判定基準で80件を要確認として拾い、そのうち60件が本当に要確認だった場合、結果は次の表になります。これが混同行列(実際の分類と予測の組み合わせを数える表)です。
| 実際の分類\予測 | 要確認と予測 | 通常と予測 | 合計 |
|---|---|---|---|
| 要確認 | TP:60件 | FN:40件 | 100件 |
| 通常 | FP:20件 | TN:880件 | 900件 |
| 合計 | 80件 | 920件 | 1,000件 |
略号は、次のように件数と一緒に覚えると追いやすくなります。
- TP(真陽性)60件:要確認を正しく拾った。
- FP(偽陽性)20件:通常なのに要確認とした。誤検知に当たる。
- FN(偽陰性)40件:要確認なのに通常とした。見逃しに当たる。
- TN(真陰性)880件:通常を正しく通常とした。
図やライブラリによって行と列の向きは違うため、左上のセルだけを見てTPだと決めないでください。表の「実際」「予測」と、どちらを正例にしたかを確認します。
同じ60件でも、分母が変わると答えが変わる
適合率:拾った80件のうち、60件が正しかった
適合率(Precision)の分母は、要確認と予測した全件です。
この例の適合率は75%です。担当者へ回した80件のうち60件が本当の対象で、残る20件は不要な確認でした。適合率は、拾った集合の中で対象がどれくらい含まれるかを見ています。75%の残り25%は「拾った80件のうち誤検知だった割合」であり、実際の通常900件を分母にする偽陽性率とは違います。
再現率:実際の100件のうち、60件を拾えた
再現率(Recall)の分母は、実際に要確認だった全件です。
再現率は60%です。本当は確認したかった100件のうち、40件を見逃しています。「再現率」という言葉から実験の再現性を連想しやすいものの、分類評価では対象をどれだけ回収できたかという意味です。
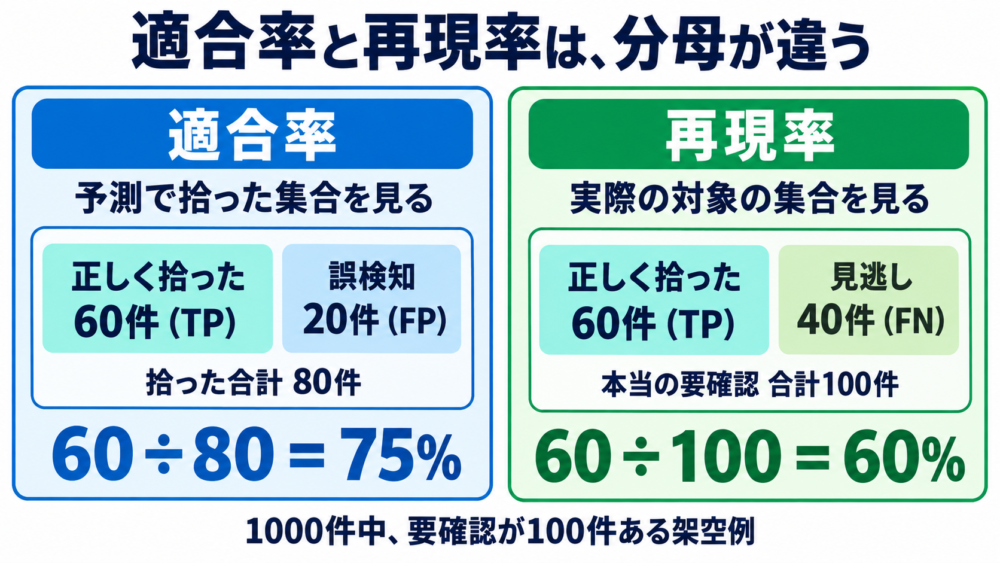
同じ1000件の架空例。分子はどちらも正しく拾った60件ですが、分母に含める集合が異なります。
正解率:要確認も通常も合わせて、何件当たったか
正解率(Accuracy)は、正しく予測できたTPとTNを合計し、全件で割ります。
94%という正解率と、60%という再現率は両立します。多くを占める通常の問い合わせが当たっていれば、要確認の見逃しがあっても全体の正解率は高くなるからです。
このデータなら、全件を通常と答えるだけでも900件が当たり、正解率は90%です。その場合は要確認を1件も拾えません。正解率が間違った指標なのではなく、正解率だけでは、どちらの種類をどれだけ間違えたかが分からない点に注意します。
F1スコア:適合率と再現率を1つにまとめる
F1は、適合率をP、再現率をRとすると次の式です。この例では両方が正の値なので、そのまま代入できます。
単純な算術平均なら0.675ですが、調和平均では約0.667になります。片方だけが高い状態を、単純平均ほど高く評価しないためです。二値分類のF1は、件数からも計算できます。
この式にはTNが入りません。通常の問い合わせを正しく処理した件数や、誤検知と見逃しの金銭的な損失を、F1が直接表しているわけではありません。定義と二値・多クラスの集計の扱いはscikit-learnのf1_scoreで確認できます。
| 指標 | この例の値 | 答えている疑問 |
|---|---|---|
| 正解率 | 94% | 全体では何割当たったか |
| 適合率 | 75% | 拾った要確認のうち何割が本物か |
| 再現率 | 60% | 本当の要確認を何割拾えたか |
| F1 | 約0.667 | 適合率と再現率をまとめるとどうか |
しきい値を変えると、何が増えて何が減るか
モデルが各問い合わせにスコアを付け、一定の値以上なら要確認と判定する場合、その境界をしきい値と呼びます。ここでは説明用にスコアを4種類へ分け、1,000件を次のように配置しました。実モデルの出力や校正済みの確率ではありません。
| 架空のスコア | 実際に要確認 | 実際は通常 |
|---|---|---|
| 0.9 | 30件 | 2件 |
| 0.6 | 30件 | 18件 |
| 0.3 | 30件 | 70件 |
| 0.1 | 10件 | 810件 |
同じスコアに対して、しきい値以上を要確認とします。先ほどのTP=60、FP=20は、しきい値0.5の場合です。
| しきい値 | TP | FP(誤検知) | FN(見逃し) | TN | 適合率 | 再現率 | F1 |
|---|---|---|---|---|---|---|---|
| 0.8 | 30 | 2 | 70 | 898 | 93.75% | 30% | 0.455 |
| 0.5 | 60 | 20 | 40 | 880 | 75% | 60% | 0.667 |
| 0.2 | 90 | 90 | 10 | 810 | 50% | 90% | 0.643 |
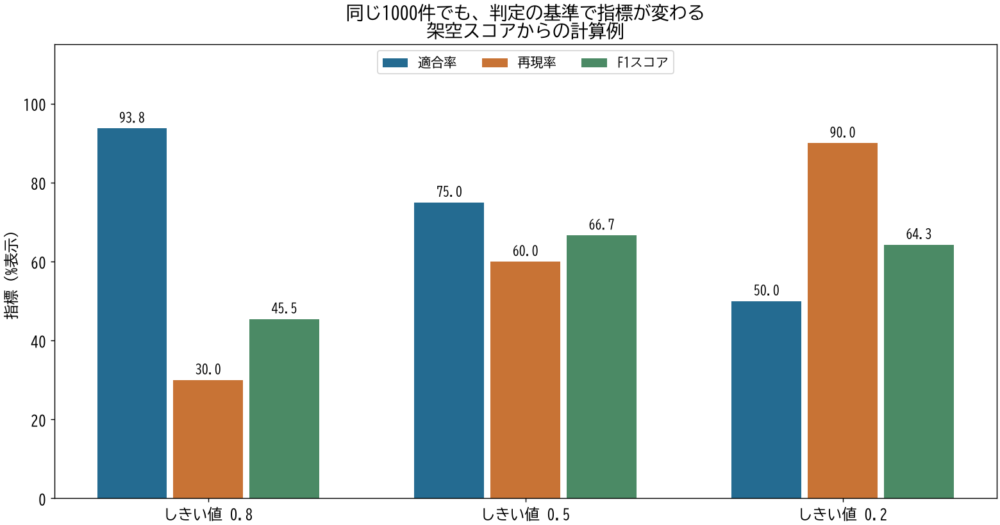
同じ架空スコアを異なるしきい値で判定した計算例。比較しやすいよう、F1も100倍した%表示にしています。
この例でしきい値を0.5から0.2へ下げると、見逃しは40件から10件へ減ります。一方、誤検知は20件から90件へ増え、確認に回す合計件数も80件から180件になります。再現率だけでなく、担当者が処理できる件数も判断材料です。
固定したデータとスコアでしきい値を下げれば、拾う集合は広がるため、再現率は下がりません。ただし、適合率が必ず下がるとは限りません。新たに加わる集合に本当の対象がどれくらい含まれるかで変わります。モデル自体を改善して両方が上がる場合もあるため、「適合率と再現率は絶対に同時改善できない」とは考えないでください。
スコアを出すことと、そのスコアから行動を決めることを分ける考え方は、scikit-learnのしきい値調整ガイドでも説明されています。0.5は、この計算例の比較点であって、どの業務でも最適なしきい値ではありません。
F1が一番高い条件を選べばよいのか
先ほどの3条件では、F1はしきい値0.5が最大です。しかし、見逃しの損失が大きい業務なら、別の条件がよい場合があります。
仮に、不要な確認1件の損失を1、見逃し1件の損失を10と置きます。この仮の損失は「FP×1+FN×10」で求められます。金額や実業務の実測値ではなく、判断の違いを見るための単位です。
| しきい値 | 仮の損失の計算 | 合計 |
|---|---|---|
| 0.8 | 2×1+70×10 | 702 |
| 0.5 | 20×1+40×10 | 420 |
| 0.2 | 90×1+10×10 | 190 |
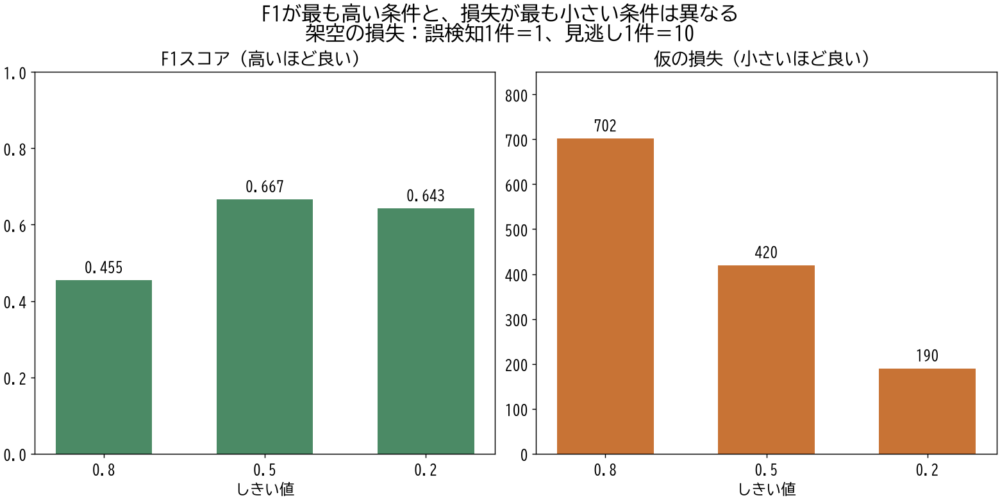
比較した3条件での結果。損失の単位は仮定であり、実務の金額や確認作業全体の費用ではありません。
この仮定では、比較した3条件のうち、F1最大は0.5、損失最小は0.2です。F1の順位と業務上の判断が違うのは、F1に損失の設定を入れていないためです。誤検知と見逃しの損失の比を変えれば、選ぶ条件も変わり得ます。
実際には、正しく拾った問い合わせにも確認作業は発生します。この簡単な損失式には、その作業費用や1日あたりの処理上限を含めていません。運用では、誤りの損失に加えて、確認件数や待ち時間も評価します。
| 重視すること | 主に確認する指標 | 一緒に確認する条件 |
|---|---|---|
| 拾った対象の無駄打ちを減らす | 適合率 | 再現率が必要水準を割らないか、誤検知の実件数は許容できるか |
| 本当の対象の見逃しを減らす | 再現率 | 適合率、追加の確認件数、担当者の処理能力 |
| 同じ評価条件で2指標をまとめて比較する | F1 | 適合率と再現率の内訳、正例の割合、業務上の損失 |
| 全体でどれだけ当たるかを把握する | 正解率 | 多数派だけを答える基準との比較、少数側の見逃し |
「適合率80%以上を保ちながら、再現率を高める」のように制約を先に決める方法もあります。何点以上なら合格かは、業務要件と評価条件をそろえて決めます。
比較する前に確認したい4つのこと
1つ目は、何を正例にしたかです。 要確認を正例にした数値と、通常を正例にした数値は、そのまま比較できません。多クラス分類のmacro平均・micro平均なども集計方法が違います。まず二値のどちらを対象にした指標かを確認してください。
2つ目は、分母が0になっていないかです。 全件を通常と予測すると、TP+FPは0なので適合率は数学的に未定義です。この例では実際の要確認が100件あるため再現率は0、件数式から計算したF1も0になります。実際の正例も予測正例もない場合は、F1の件数式も0で割る形です。ライブラリが返す0や警告は計算上の取り決めなので、設定と該当件数を併記します。scikit-learnではzero_divisionでその扱いを指定します。
3つ目は、同じデータ条件かです。 本当の要確認の割合や問い合わせの種類が違えば、指標も変わり得ます。例えば10件中9件と1,000件中900件は同じ90%でも、少数のデータでは1件の増減が割合を大きく変えます。期間別の割合だけを並べず、混同行列の件数も残します。運用中の変化を追う方法はデータドリフトの検知と対応で整理しています。
4つ目は、しきい値を選ぶデータと、最終評価を分けたかです。 同じテスト結果を何度も見て条件を選ぶと、そのデータに都合のよい値を採用してしまいます。調整は検証用データで行い、最後は選択に使っていないデータで確認します。前処理や情報の混入はデータリークの原因と防止策、学習データへの適合と未知データでの性能の違いは過学習の見分け方を参照してください。
手元のモデルを確認するときは、適合率・再現率・F1の3つだけを報告する前に、正例の定義、TP・FP・FN・TN、判定しきい値を一緒に書き出してみてください。同じ数値でも、何件を見逃し、何件を確認へ回すのかが分かると、次に変えるべき条件を判断しやすくなります。
コメント