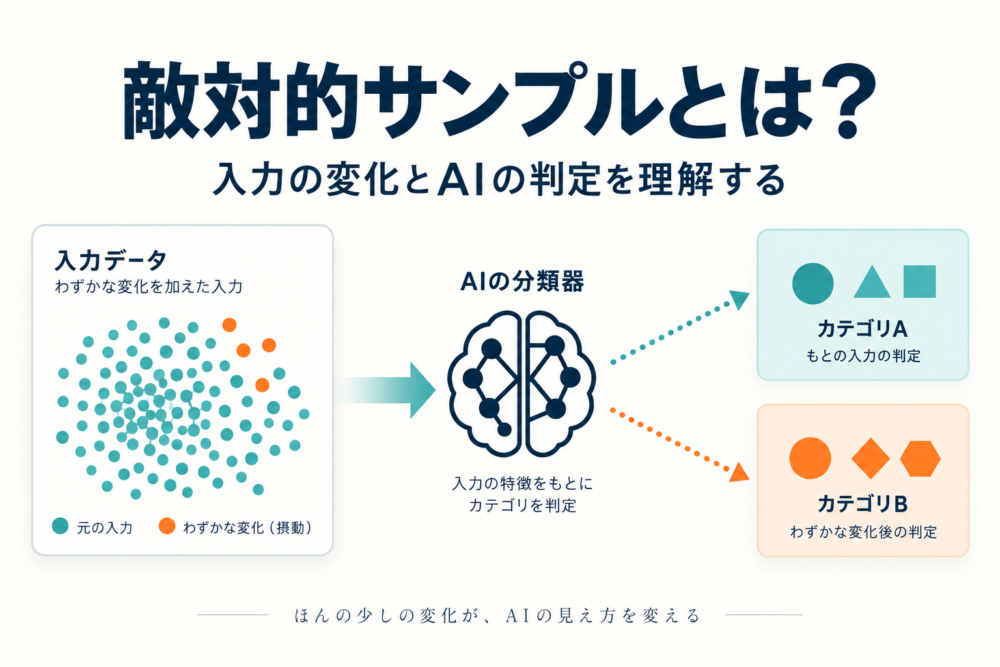
敵対的サンプルとは、AIモデルに誤った出力をさせる目的で、意図的に作られた入力データです。画像分類では、元の画像に小さな変更を加えると、人には同じ対象に見えてもモデルの分類が変わる例が知られています。
要点は、ノイズの量だけでなく、モデルの判定を変えやすい方向へ入力を動かすことです。防御の効果を読むときも、「何%防げたか」と一緒に、変更できる範囲、対象モデル、試験方法を確認する必要があります。
この記事では、2つの数値で分類する架空のモデルを使い、普通のノイズとの違い、学習データ汚染との関係、対策と評価の注意点を説明します。
敵対的サンプルと普通のノイズは、作られる目的が違う
画像の明るさの揺れやセンサーの雑音など、意図しない入力の変動でもAIは誤分類することがあります。敵対的サンプルでは、そのモデルを誤らせることを狙って入力を選んだり、改変したりします。入力に加える変更は、摂動(せつどう)と呼ばれます。
TensorFlowの公式チュートリアルでは、モデルを固定したまま入力画像に対する計算を行い、誤分類を狙う例を示しています。モデルの弱点を調べるテストにも使えるため、「敵対的」という名前だけで作成者の悪意を意味するわけではありません。
小さな画素の変更は代表例ですが、数値上の変更が小さいことと、人が違いに気づかないことは同じではありません。入力の種類、変更方法、表示条件を分けて確認します。また、分類結果が変わっただけで攻撃と断定せず、入力や処理の変更も調べます。
| 入力の変化 | 確認する目的 | 結果から分かる範囲 |
|---|---|---|
| 偶発的なノイズ・入力の揺れ | 通常の利用条件で性能を保てるか | 試した種類・強さの揺れへの耐性 |
| 敵対的サンプル | 誤りを狙った入力変更に耐えられるか | 設定した変更範囲と試験方法での耐性 |
| データドリフト | 以前と入力の分布が変わったか | 集団としての値や割合の変化 |
データドリフトは時間経過や利用者構成の変化でも生じます。データドリフトの記事で扱った分布監視は、個々の入力が意図的に細工されたかどうかを判定するものとは役割が異なります。
学習データの汚染とは、変更が入る段階を分ける
モデルを学習させる段階と、学習済みモデルへ入力して結果を得る推論の段階を分けると、対策の対象が見えます。NISTの敵対的機械学習に関する分類も、回避攻撃や汚染攻撃を区別しています。
| 問題 | 主に変更するもの・段階 | 本記事での捉え方 |
|---|---|---|
| 敵対的サンプルを使う回避攻撃 | 学習済みモデルへ渡す入力 | モデルを変えずに推論結果を誤らせる |
| データポイズニング(学習データ汚染) | 学習データや正解ラベル | 学習されるモデルへ影響を与える |
| プロンプトインジェクション | LLM(大規模言語モデル)が読む文章などに混入した指示 | 指示として扱うべきでない内容が動作へ影響する |
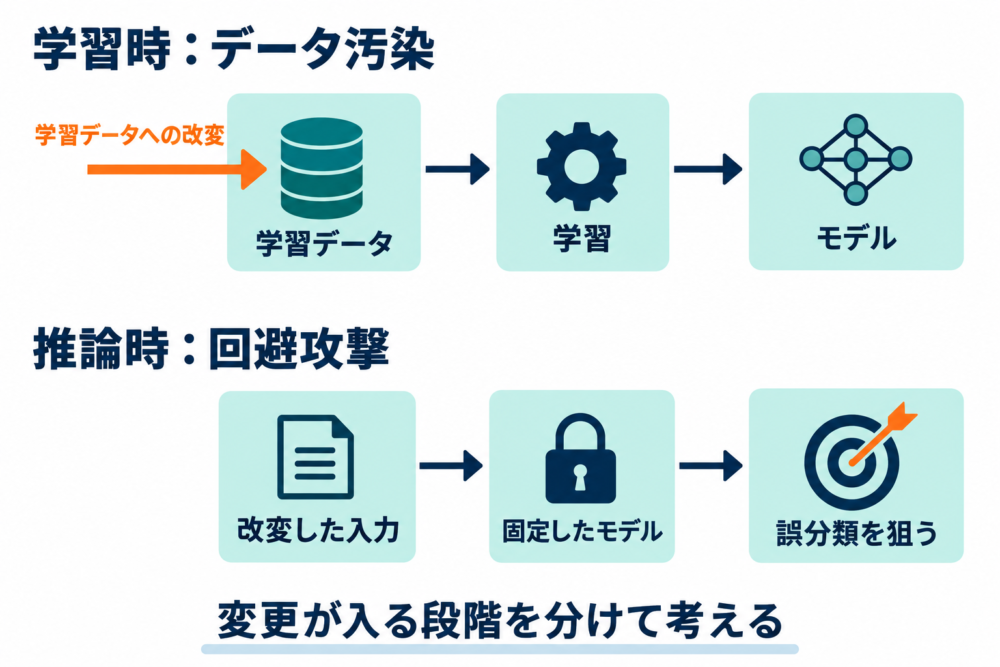
本文の説明を整理した独自の模式図です。
これは説明のための切り分けで、相互に排他的な分類ではありません。例えば、学習時に仕込まれた特定の模様が推論時に働く場合は、両方の段階を調べる必要があります。
本記事は分類モデルの入力改変を中心に扱います。自然言語の指示混入については、プロンプトインジェクションの記事で、直接型・間接型と権限の制御を説明しています。
同じ変更量でも、動かす方向で判定は変わる
ここからの数値は説明用の架空例です。実際の画像、学習済みAI、攻撃成功率を測定したものではありません。
入力を2つの数値u・vで表し、次の規則でAかBに分類するモデルを考えます。
スコア = u + v − 1
スコアが0未満ならA、0以上ならBとします。u + v = 1となる直線が、モデルの判定の分かれ目である決定境界です。ここでのスコアは確率ではありません。
元の入力を(u, v) = (0.45, 0.45)とすると、スコアは0.45 + 0.45 − 1 = −0.10で、モデルはAと判定します。この例に登場する入力点は、変更後も本来の正解がAのままだと仮定します。
| 入力 | uの変更 | vの変更 | 変更後の値 | スコア | モデルの判定 |
|---|---|---|---|---|---|
| 元の入力 | 0 | 0 | (0.45, 0.45) | −0.10 | A:正解 |
| 境界を越える方向 | +0.08 | +0.08 | (0.53, 0.53) | +0.06 | B:誤分類 |
| 別の方向 | +0.08 | −0.08 | (0.53, 0.37) | −0.10 | A:正解 |
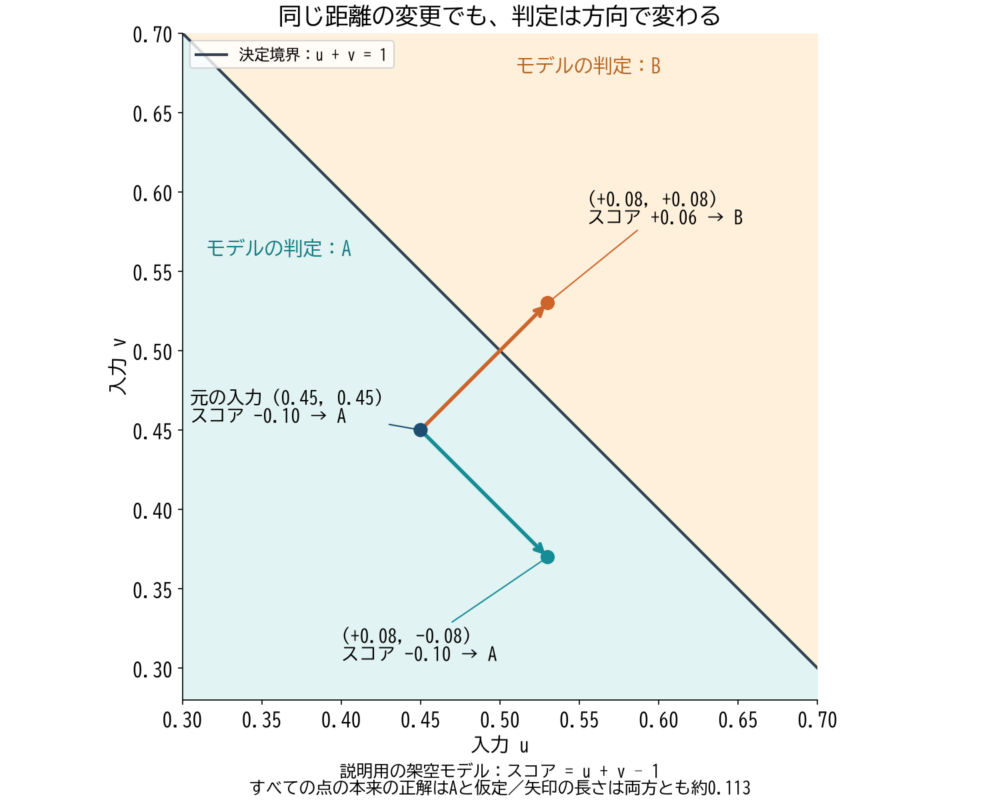
説明用の架空例です。実モデルの測定結果ではありません。
二つの変更は、どちらも各成分の変化の絶対値が0.08です。平面上を動いた距離も、ともに約0.113となります。それでも、両方を増やした場合はスコアが0.16増え、境界を越えます。片方を増やして片方を減らした場合は、スコアへの影響が相殺されます。
後者は「ランダムノイズなら安全」という証拠ではありません。方向の違いだけを比べるために選んだ一例であり、偶発的なノイズでも境界を越える場合はあります。
モデルの境界と、本来の正解は別に考える
もし入力の変更によって、本来の正解もAからBへ変わっていたなら、モデルがBを出すことは誤分類とは限りません。画像の意味が変わっていないか、業務上の正しいラベルを保っているかを確かめる必要があります。
この架空例では、その条件を「登場する点の正解はA」と先に置きました。実際の画像では、2次元の距離だけからその条件を判断できません。
Goodfellowらの原論文は、高次元で小さな変更の影響が積み重なる線形的な性質に注目しています。この説明では、複雑に曲がった境界や過学習だけを原因としません。本記事の直線の例も、境界が単純でも判定が変わり得ることを示しています。
FGSMでは、モデルを固定して入力側を変える
FGSM(Fast Gradient Sign Method)は、損失(正解とモデル出力のずれを数値化したもの)が増える方向を手掛かりに、入力へ変更を加える代表的な方法です。ここでは、正解以外ならどの分類でもよい、という目的を考えます。
前処理とは、画像のサイズや数値の尺度などをモデルへ渡す前に整える処理です。モデルを学習するときは、通常、損失を減らすようにモデルの重みを更新します。一方、FGSMによる入力の作成では重みを固定し、入力のどの成分を増減すると損失が増えるかという勾配を使います。この違いは、TensorFlowのFGSMの説明でも確認できます。
「一定量の雑音を加える」だけでなく、モデルの計算と結び付けて方向を選ぶ点が要点です。ただし、FGSMを一度試した結果だけで、すべての変更に対する耐性は分かりません。
変更範囲と、利用できる情報を明記する
どんな相手と条件を想定するかを、脅威モデルと呼びます。Carliniらの評価に関する論文は、目的・知識・能力を明確にすることを評価の前提にしています。
| 条件 | 記録する例 | 条件が違うと比較しにくい理由 |
|---|---|---|
| 狙う結果 | 誤分類ならどれでもよい/特定のラベルにしたい | 成功と数える出力が違う |
| 利用できる情報 | 内部の重みや構造/外部から得るラベルやスコア | 入力を選ぶ際に使える手掛かりが違う |
| 変更できる範囲 | 各成分の最大変化、変更できる領域 | 探すことのできる入力が違う |
| 入力の尺度 | 0〜255の画素値/0〜1へ変換した値 | 同じ数字でも実際の変更量が違う |
| 処理全体 | サイズ変更、数値の尺度調整、検知器を含むモデルの版 | 配備したシステムと試験対象がずれる |
内部情報を利用できる前提はホワイトボックス、内部情報を利用できず外部の応答などを使う前提はブラックボックスと呼ばれます。ブラックボックスでも、返るのがラベルだけなのか、数値スコアもあるのか、何回問い合わせられるのかを分けます。
変更量を表すε(イプシロン)も、数値だけでは十分ではありません。例えば、0〜1の尺度でε = 0.01なら、0〜255の尺度では2.55に相当します。これは連続値としての尺度の換算です。整数画素へ戻す際の丸めは別に考え、人が気づかない変更量の基準とは扱いません。
対策は、何に対する耐性を上げるかで比較する
頑健性(がんけんせい)とは、入力に変化があっても期待する動作を保つ性質です。敵対的サンプルへの対策では、想定した入力変更に対する頑健性を評価します。
敵対的学習は、正しいラベルを保って学習し直す
敵対的学習では、誤分類を誘う入力も学習に使い、その入力に対して正しい答えを返すようモデルを調整します。攻撃が狙った誤ったラベルを、正解として教えるわけではありません。
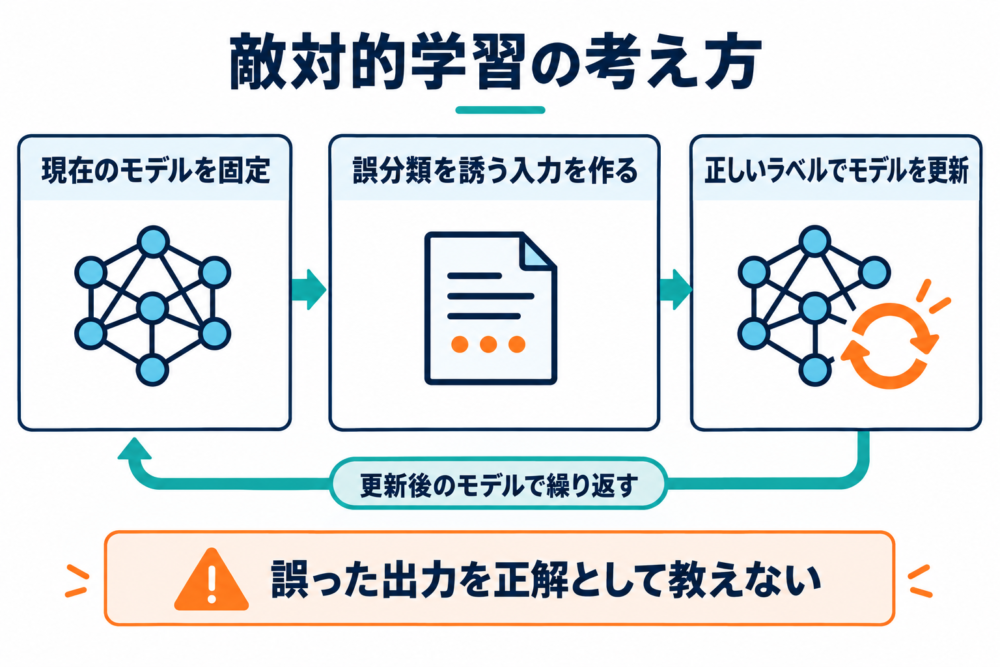
本文の説明を整理した独自の模式図です。
先ほどの架空例なら、(0.53, 0.53)の正解はAという設定を保ち、Aを返すよう学習に使う考え方です。ここでは学習自体は実行しておらず、更新後の境界や改善率は示していません。
Madryらの研究は、許した変更の範囲で不利な入力を考え、それに備えてモデルを学習する問題として頑健性を扱っています。どの範囲を想定したかが、対策の意味を決めます。
| 対策 | 狙う効果 | トレードオフ・確認事項 |
|---|---|---|
| 敵対的学習 | 想定した入力変更でも正解するよう調整 | 学習負荷が増える。通常入力の精度と、別条件での耐性を確認する |
| 前処理・検知器 | 入力を整える、疑わしい入力を識別する | 通常入力への影響や誤検知がある。処理全体を含めた試験が必要 |
| 保証付きの頑健性評価 | 定義した変更範囲で判定が変わらないことを保証 | 保証対象のモデル・距離の定義・範囲を越えた主張はできない |
| 人の確認・自動処理の制限 | 誤判定が後続処理へ与える影響を減らす | モデル自体の耐性とは別。確認負荷や処理時間がかかる |
NISTの整理では、敵対的学習の計算負荷と通常データの精度との兼ね合いも挙げられています。最後の行は、誤りが起きた場合の影響を抑えるための本記事の運用上の提案です。
攻撃を見つけられないことと、保証は違う
前処理を入れて、ある方法で誤分類を起こせなくなっても、弱点がなくなったとは限りません。Athalyeらの研究は、勾配を使った探索が難しくなることで、実際より安全に見える防御の問題を示しました。
これに対して、Cohenらのランダム化平滑化の研究は、ガウス雑音を利用して作る分類器について、L2ノルム(各成分の変化を二乗して足し、平方根を取った距離)で定めた範囲の頑健性を保証します。保証には対象と条件があり、任意の入力変更に対して安全という意味にはなりません。
評価結果は、条件と分母をそろえて読む
例えば「耐性80%」と書かれていても、何件を分母にしたかで意味が変わります。次も説明のために設定した架空の集計で、実モデルを試験した結果ではありません。
100件の通常入力のうち、90件を正しく分類したとします。その90件に対して、同じ変更上限と方法で誤分類を誘う試験を行い、18件で誤分類が見つかり、72件では正解を保ったとします。元から誤分類だった10件は、正解を保った件数には含めません。
| 指標 | 計算 | この例での意味 |
|---|---|---|
| 通常入力の正解率 | 90 ÷ 100 = 90% | 改変前の性能 |
| 元から正解だった入力に対する攻撃成功率 | 18 ÷ 90 = 20% | 指定の試験で、新たに誤分類となった割合 |
| 元から正解だった入力での正解維持率 | 72 ÷ 90 = 80% | 試験対象90件の中で正解を保った割合 |
| 全100件に対して正解を保てた割合 | 72 ÷ 100 = 72% | 元からの誤りも除外せず、全体を分母にした割合 |
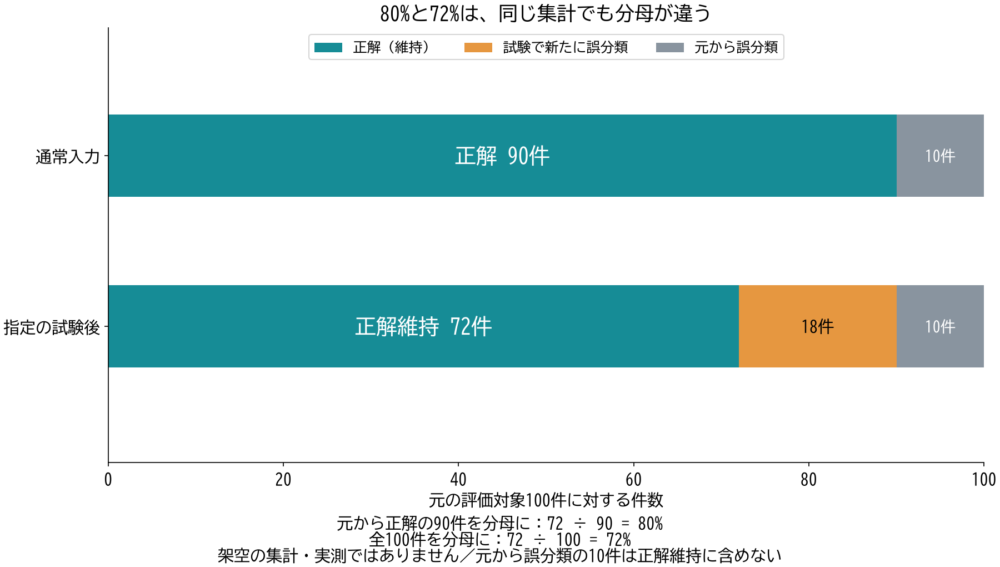
説明用の架空例です。実モデルの測定結果ではありません。
80%と72%は同じ集計から出ます。分母が違う数字を、別のモデルの性能差と読み違えないことが大切です。また、この試験で正解を保った72件に、別の許された変更なら誤分類を起こす入力があるかもしれません。
評価資料を読む際は、本記事では次の順に確認することを勧めます。
- 通常入力での性能と、評価対象の件数を確認する。
- 入力の変更上限・尺度・正解を保つ条件を確認する。
- モデルと前処理の版、利用できる内部情報、試験方法を確認する。
- 防御の仕組みを踏まえて試験したか、条件を変えた結果もあるかを見る。
- 割合の分母と、保証された範囲・試しただけの範囲を分ける。
「この条件で誤分類を見つけられなかった」と「この範囲には誤分類がないと保証できた」を区別すれば、対策の名前や一つの割合だけで判断せずに済みます。敵対的サンプルの評価は、入力・モデル・試験条件を一組の記録として読むのが出発点です。
コメント