AI・テクノロジー

AI技術・仕組み

MoEとは?複数の専門家を使うLLM構造

MoE(Mixture of Experts)とは何かを、Dense LLMとの違い、RouterのTop-k選択、総parameterとactive parameter、負荷分散、expert capacity、All-to-All通信、Python例まで図解します。
AI技術・仕組み

AI Agentとは?ReActでLLMが考えて行動する仕組み

AI Agentとは何かを、ReActのThought・Action・Observation、Function Callingや固定workflowとの違い、状態管理、停止条件、権限、人間承認、Python実装、評価まで図解します。
AI技術・仕組み

Function Callingとは?Tool Useの仕組み・実装・安全設計を解説

Function Callingとは何かを、LLMとアプリの実行loop、Toolformer、JSON Schema、認可、承認、冪等性、並列処理、MCPとの違い、段階別評価まで図解します。
AI技術・仕組み

RAGのChunkingとは?文書分割・Hybrid Search・Rerankerを解説

RAGのChunkingを、固定長・overlap・意味単位・parent-child・Late Chunkingまで比較。Hybrid Search、RRF、Cross EncoderによるRerank、段階別評価の考え方を図解します。
AI技術・仕組み

Embedding検索とは?Dense Retrievalの仕組みをDPR論文から解説

Embedding検索とDense Retrievalの仕組みをDPR論文から解説。Dual Encoder、positive・negative学習、内積とcosine similarity、exact検索とANN、Recall@k、検索漏れの診断まで整理します。
AI技術・仕組み

RAGとは?LLMに外部知識を使わせる仕組み

RAGとは何かを、文書のindexing、検索、context構築、LLM生成の流れから図解。Fine-tuningとの違い、vector検索、権限・鮮度、精度評価、よくある失敗と改善方法まで解説します。
AI技術・仕組み

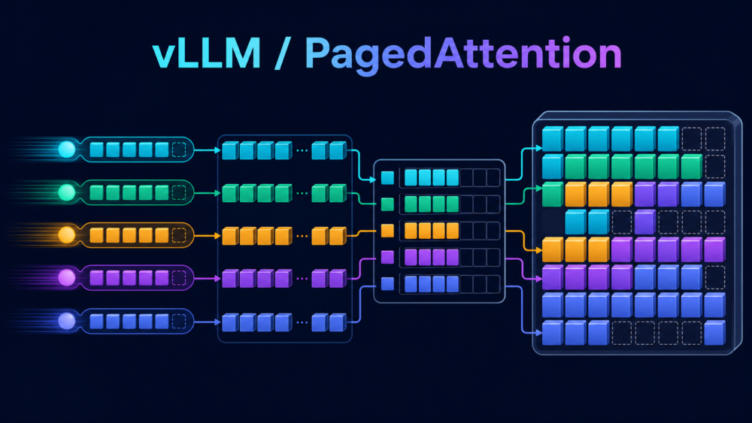
vLLMとは?仕組み・使い方とPagedAttentionを図解

vLLMとは何かを、用途とOllamaとの使い分けから解説。PagedAttentionの仕組み、KV Cacheの容量計算、連続バッチ処理・APCの違い、APIの起動手順と性能の測り方を図と表で整理します。
AI技術・仕組み

Speculative Decodingとは?LLM生成を速くする方法

Speculative Decodingの仕組みを図解。draft modelの候補生成、target modelの一括検証、samplingの受理・棄却、高速化条件と実測方法を解説します。
AI技術・仕組み

GQA/MQAとは?KV Cacheを減らすAttention改良

GQAとMQAの仕組みを図解。MHAとのhead構成の違い、KV Cache容量の計算、group数とgroup size、品質・速度のtrade-off、実装確認を解説します。
AI技術・仕組み

FlashAttentionとは?Attentionを高速化する技術

FlashAttentionの仕組みを図解。N×N中間行列、HBMとSRAM、online softmax、メモリ削減、KV Cacheとの違い、PyTorchでの確認方法を解説します。
スポンサーリンク