Kas

AI研究・論文解説

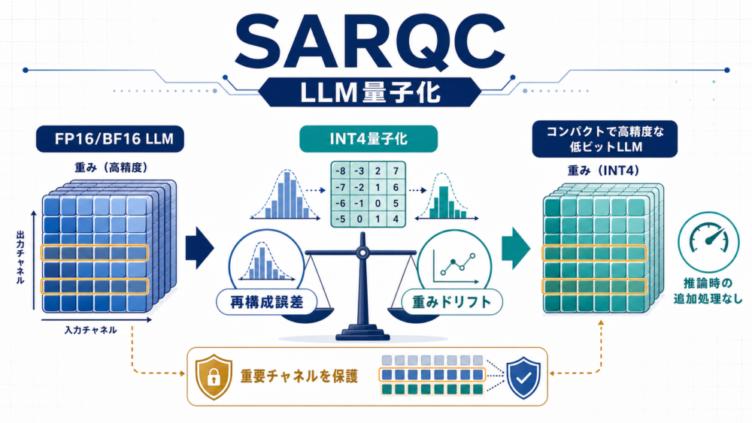
SARQCとは?LLM量子化の精度劣化を抑える仕組みとAWQ・GPTQとの違い

SARQCはLLM量子化の校正時に重みドリフトを抑える手法です。RQCとの違い、AWQ・GPTQへの組み込み方、2bit・4bitの実験条件、理論の保証範囲と導入前の確認点を原論文v2から解説します。
AI研究・論文解説
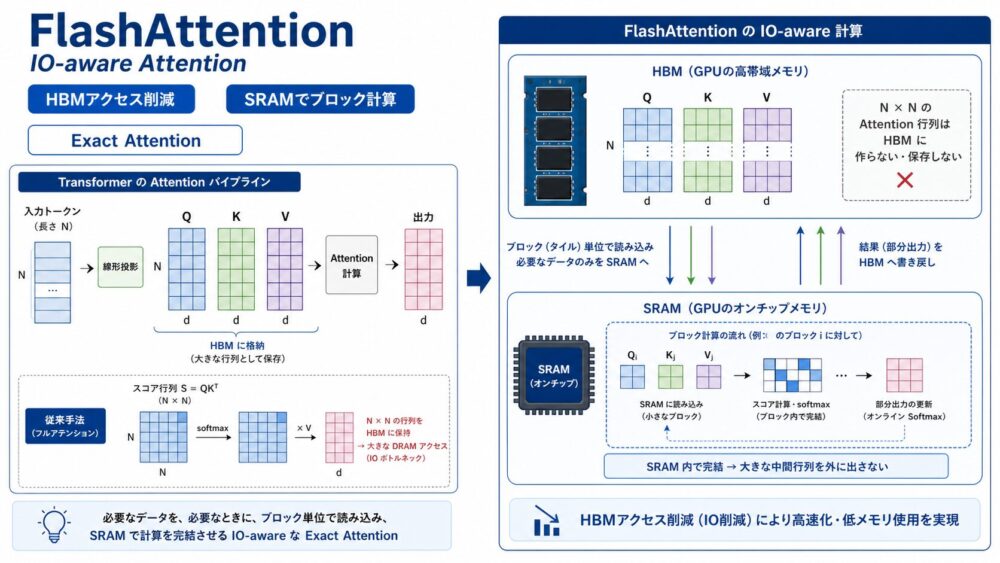
FlashAttentionとは?AttentionをIO-awareに高速化する仕組み

FlashAttentionとは、Self-Attentionを近似せず、GPUのHBMとSRAM間のIOを減らして高速・省メモリ化する手法です。tiling、online softmax、recomputation、Block-sparse FlashAttention、実験結果を論文ベースで解説します。
AI研究・論文解説

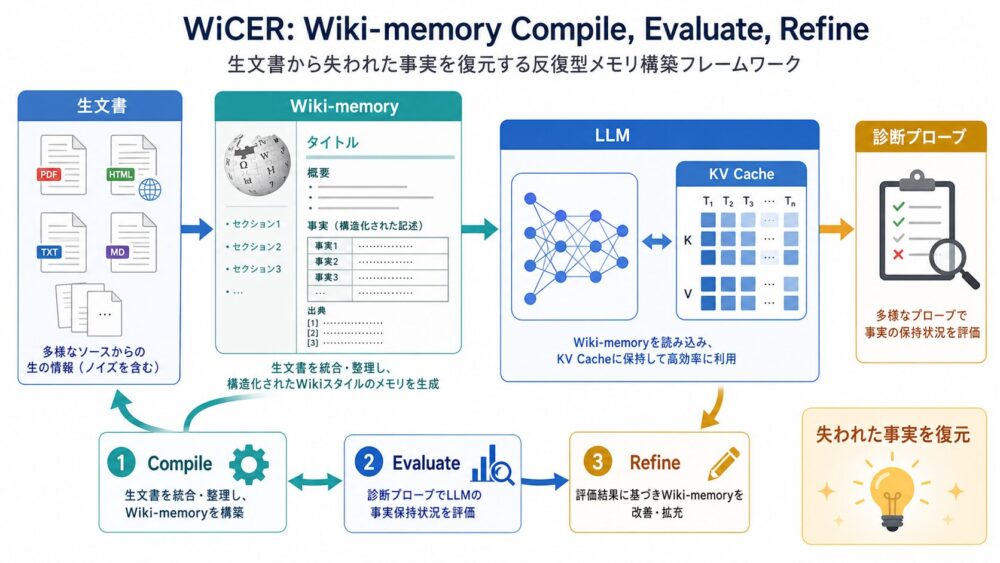
WiCERとは?LLMの長文知識をWiki-memoryとして圧縮・改善する仕組み

WiCERとは、LLM向けに長文知識をWiki-memoryへ圧縮し、診断プローブで欠落事実を見つけて反復改善する手法です。RAG、full-context KV cache、compilation gapとの違いを論文ベースで解説します。
AI研究・論文解説

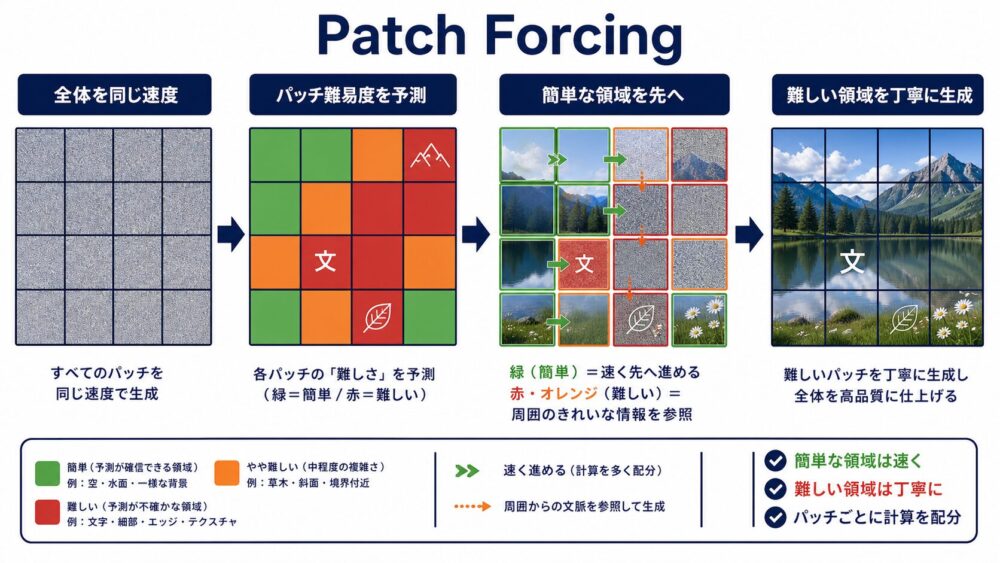
Patch Forcingとは?画像生成をパッチごとの難しさで適応的に進める仕組み

Patch Forcingとは、画像をパッチごとの難しさに応じて異なる速度で生成する適応サンプリング手法です。LTG sampler、difficulty head、dual-loop、look-aheadの仕組みを、Flow Matchingの数式とImageNet・Text-to-Imageの実験結果から解説します。
AI研究・論文解説

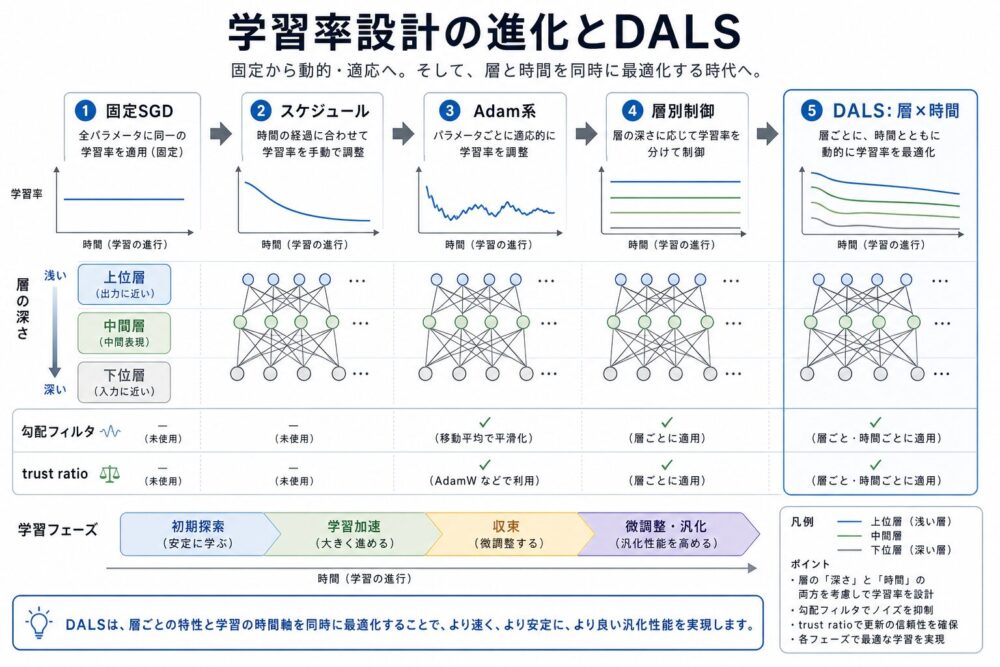
学習率とは?DALS論文で見る最適化手法の進化と使い分け

学習率とは何か、SGD、cosine decay、AdamW、RAdam、LARS、Grokfast、DALSの違いを論文ベースで解説します。DALSが提案する層と学習フェーズに応じた最適化、scratch学習とfine-tuningでの使い分け、実験結果の読み方を整理します。
AI技術・仕組み

Decoder-only Transformerとは?GPT系LLMの学習と生成を図解

Decoder-only Transformerの構造をGPT-2論文から解説。元のTransformer decoderとの違い、causal mask、次token損失、学習・prefill・decode、KV Cacheまで図と具体例で理解できます。
AI技術・仕組み

RoPEとは?LLMが位置情報を回転で扱う仕組みを図解

RoPEとは、LLMのQueryとKeyを位置に応じて回転する位置表現です。2次元の具体計算、相対位置差が内積へ残る理由、PyTorch実装、標準RoPEと長文向けスケーリングの違いを図解します。
AI技術・仕組み

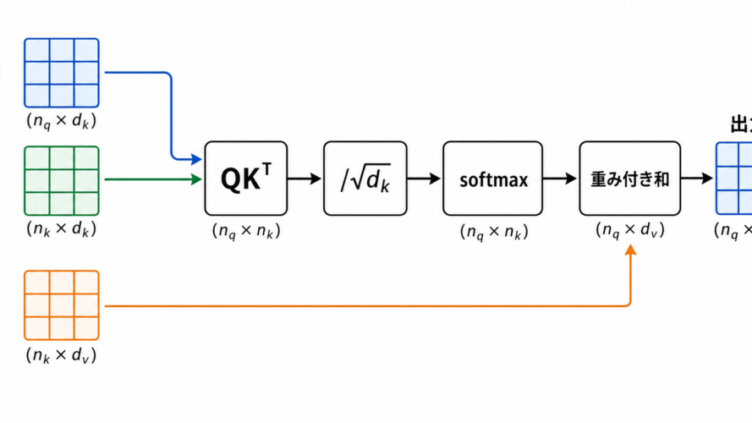
Self-Attentionとは?Q・K・Vの役割と計算を数値例で図解

Self-Attention(自己注意機構)の意味とQ・K・Vの役割を解説。1トークンの出力を数値例で追い、行列演算で並列化できる理由や学習と生成の違いを図とPyTorchで確認します。
AI研究・論文解説

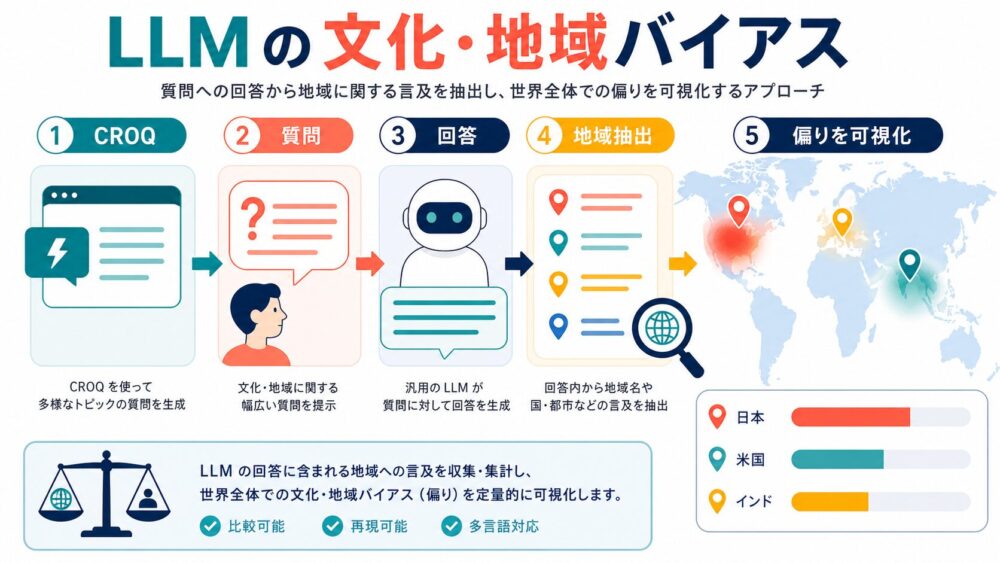
【論文解説】LLMはなぜ日本文化に寄りがちなのか?CROQで見る文化・地域バイアス

LLMが文化に関する曖昧な質問へ答えるとき、どの国や地域を暗黙に選びやすいのかを調べた論文を解説します。CROQデータセット、LLM-as-a-judgeによる地域抽出、入力言語の影響、SFT後に強まる文化・地域バイアスを初心者にも分かりやすく整理します。
AI技術・仕組み

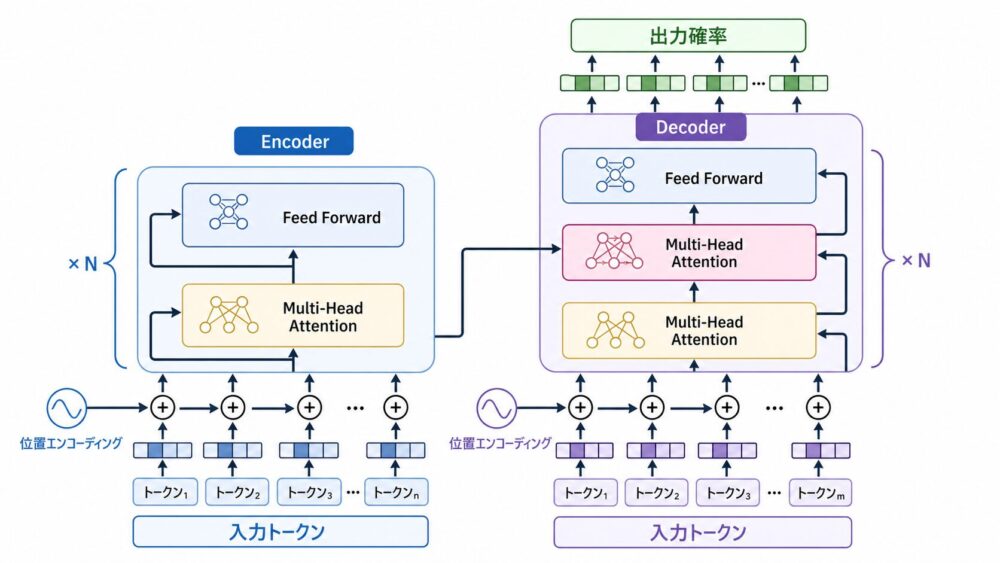
【LLM解説シリーズ】Transformerとは?Attention Is All You Need論文からLLMの基本構造を理解する

Transformerは、Attentionを中心に系列を処理するLLMの基礎アーキテクチャです。Attention Is All You Need論文をもとに、Self-Attention、Multi-Head Attention、Positional Encoding、EncoderとDecoderの違いを初心者にも分かりやすく解説します。
スポンサーリンク