RTX Sparkは、NVIDIAのCPUとGPU、大容量のユニファイドメモリを組み合わせ、Windows PC上でAIを動かすためのプラットフォームです。IFA 2026では搭載PCや関連ソフトの展開が示され、NVIDIAは2026年10月の投入予定を案内しました。この記事では発表内容を整理し、CPU・GPU・メモリがどう連携して文章生成やAIエージェントを動かすのかを図解します。
情報は2026年9月19日時点です。図は理解のために作成した概念図で、実機の写真、実際のチップ配置、測定結果ではありません。
IFA 2026では何が発表されたのか
RTX Spark自体は、2026年5月末から6月初めのNVIDIAとMicrosoftの発表で紹介されています。9月のIFA(ベルリンで開催される家電・技術の展示会)は、搭載PCやローカルAIの利用環境が具体化した機会として捉えると経緯が分かります。
NVIDIAのIFA発表では、搭載Windows PCの10月投入予定に加え、ローカルモデルの導入支援や、複数PCへ処理を振り分けるソフトウェアが紹介されました。一方、メーカーが個別に発表した機種の発売日・地域・価格は、それぞれの案内で確認する必要があります。
出典:Microsoftの初回発表、NVIDIAのIFA 2026発表
AcerとLenovoが示した搭載PC
| 発表されたPC | 形状・特徴 | 発表上の最大メモリ | 用途を考える際の違い | 発売情報 |
|---|---|---|---|---|
| AcerのRTX Spark搭載デザイン | 小型デスクトップ | 128GB | 据え置きの作業環境に組み込みやすい。画面や入力機器は別に用意する形 | デザイン展示。発売情報は後日発表 |
| Lenovo Yoga Pro 9n | 15型ノート | 128GB | 画面とキーボードを持ち運べる。携帯時の性能や電池持ちは実機での確認が必要 | 価格・発売情報は後日発表 |
| Lenovo Yoga 9n 2-in-1 | 16型の変形可能なノート | 64GB | ペン入力などの使い方に対応。最大メモリはPro 9nと異なる | 価格・発売情報は後日発表 |
用途欄は形状から考えた使い方です。地域ごとの構成、国内価格、実際の連続稼働時間を確認した比較ではありません。全機種に128GBが載る、あるいは表の全機種が10月に日本で発売される、と読み替えないようにしてください。
RTX SparkとDGX Sparkは、どこが違う?
名前が似ていますが、RTX Spark搭載PCとDGX Sparkは別の製品です。CPUやGPUの世代名だけで同じ性能・仕様と判断せず、OSと用途、販売される構成を確認します。
| 比較軸 | RTX Spark搭載PC | DGX Spark |
|---|---|---|
| 位置付け | AI、制作、ゲームなどに使うWindows PC | AIの開発・推論などに使う小型システム |
| OS(基本ソフト) | Windows 11 | NVIDIA DGX OS |
| 形状 | ノートと小型デスクトップ | デスクトップ |
| メモリ | 機種・構成によって異なり、最大128GB | 128GBのユニファイドメモリ |
| 検討時の軸 | 普段使うアプリとの両立、携帯性、機種別仕様 | 利用するAI開発環境や運用方法との適合 |
DGX Sparkで公表されたメモリ帯域や検証結果を、RTX Sparkの値として流用することもできません。この記事で扱うのは、Windows PC側のRTX Sparkです。
出典:RTX Spark公式仕様、DGX Spark公式仕様
CPU・GPU・メモリは、それぞれ何をするのか
RTX SparkはGrace CPUとBlackwell RTX GPUを組み合わせています。CPUはArmアーキテクチャ(命令体系などを定めるCPUの設計仕様)を採用し、CPUとGPUをつなぐ技術としてNVLink-C2Cが使われます。
ここでは接続の細部より、処理を進める部品と、処理するデータを置く部品を分けて考えましょう。
| 部品・領域 | 担当すること | 文書を要約する場合の例 |
|---|---|---|
| CPU(中央処理装置) | アプリの制御、条件分岐、処理の準備 | ファイルを開き、文章を取り出し、GPUへ計算を依頼する |
| GPU(多数の演算を並列に進めるプロセッサ) | 大量の数値に対する計算 | AIモデルの行列計算を行う |
| DRAM(大容量の作業用メモリ) | 実行中のデータを保持 | モデルの重み、入力、中間結果を置く |
| SSD(電源を切っても内容を保持する記憶装置) | ファイルを保存 | モデルファイルや元の文書を保存する |
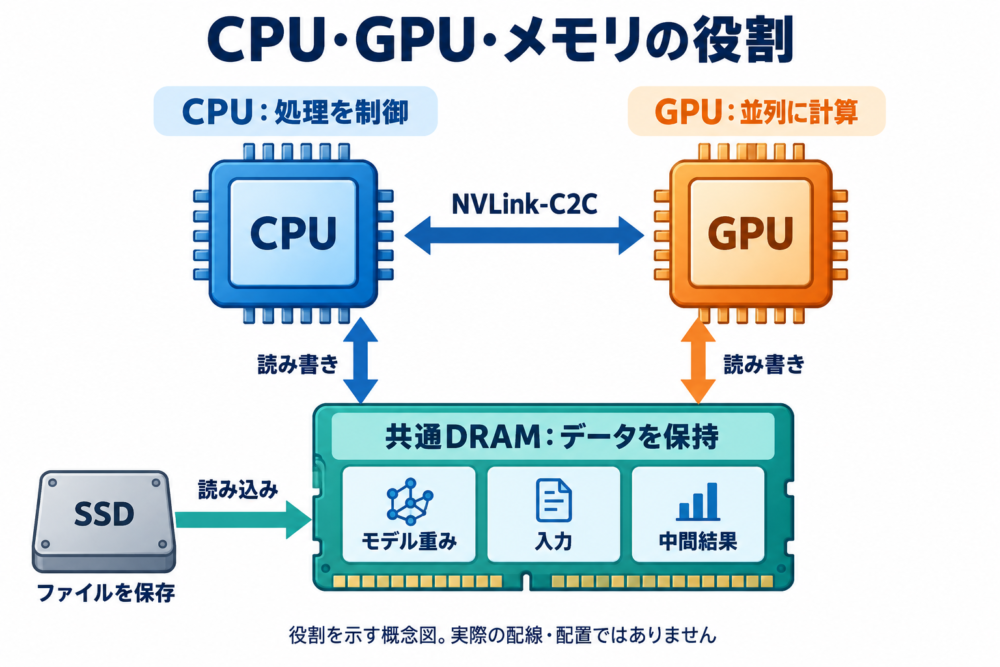
図の線は役割上の関係を示しています。メモリコントローラの配置や、個々のアクセスが通る物理配線を再現したものではありません。
GPU内部のTensor Core(行列の積和演算をまとめて処理する専用演算器)も、対応するAIの計算を担います。GPUの並列計算は、たとえば「多数の数値の組に同じ掛け算や足し算を適用する」処理で力を発揮します。アプリ全体にはファイル操作や条件判断もあるため、CPUとGPUが役割を分担します。CPUを丸ごとGPUに置き換える構成と考えると、この連携を見落とします。
公式の最大仕様はCPUが20コア、GPUが6,144コアですが、CPUコアとGPUコアは機能も数え方も異なり、個数だけで速度を比較できません。
出典:NVIDIAとMicrosoftのRTX Spark発表、CUDA Programming Model
ユニファイドメモリで変わる、データの置き場所
ユニファイドメモリは、この製品の説明ではCPUとGPUが共通のメモリを利用する構成を指します。RTX SparkのメモリにはLPDDR5X(低消費電力向けのDRAM規格)が使われ、構成によって最大128GBが用意されます。
別々のメモリにコピーする場合と、同じ領域を使う場合
一般的な独立GPU搭載PCでは、CPUが使うシステムメモリとGPU専用のVRAM(GPU側のメモリ)が分かれています。CPU側で準備した配列をGPUで計算するときは、必要に応じてGPU側へコピーします。
たとえばCPUで画像を読み込み、GPUでノイズを除去する処理を考えます。別々のメモリを使う構成では、読み込んだ画像をGPU側へ渡す工程が生じます。共有構成では、アプリや実行環境が対応すれば、同じ物理メモリ上のデータを使い、別領域へのコピーや二重保持を減らせます。
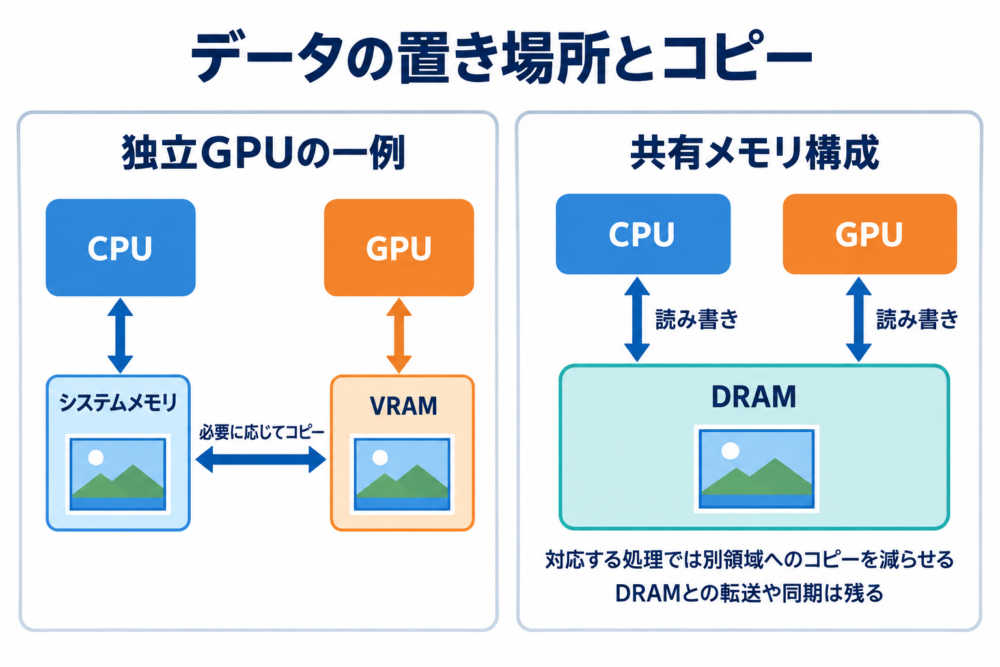
共有構成でも、GPUはDRAMから必要なデータを読み込みます。CPUの書き込みが終わるのを待つ同期や、CPUとGPUが同時にメモリへアクセスする際の競合も考慮します。減らせるコピーと、計算に必要な読み書きは分けて理解する必要があります。
なお、128GBはシステム全体で使う容量です。OSや他のアプリも使用するため、128GBの全量をAIモデル専用に確保できるわけではありません。
「Unified Memory」と「Shared Memory」を区別する
GPUの資料には似た名前が登場しますが、何を共有するかが違います。
| 用語 | 何を意味するか | 混同しやすい点 |
|---|---|---|
| 製品仕様のユニファイドメモリ | CPUとGPUが利用する共通の物理メモリ | 主にPC全体の構成の話 |
| CUDA Unified Memory | CPUとGPUから扱えるメモリを提供するプログラミング上の仕組み | ハードウェアによってはデータ移動が発生する |
| GPUのShared Memory | GPU内部でスレッド群がデータを共有する小さな作業領域 | PCの128GBメモリとは場所も用途も異なる |
CUDA(NVIDIAのGPU計算環境)で同じアドレスを扱えることと、物理的に同じDRAMを共有していることは、別の観点です。ソフトウェアの機能名だけで「コピーが一切ない」と判断しないようにしましょう。
出典:RTX Spark公式仕様、CUDA Unified Memory入門
GPU内部のSRAMは、大容量メモリとどう違う?
DRAMに十分な容量があっても、演算のたびに遠くのメモリから同じデータを読み直すと、転送の待ち時間や消費電力が増えます。そのためGPU内部には、使うデータの一部を演算器の近くに保持する仕組みがあります。
その代表が、SRAM(主にチップ内部の高速な小容量メモリに使う記憶回路)で構成されるキャッシュや作業領域です。DRAMは比較的大きな容量を確保するのに向き、SRAMは面積当たりの容量で不利な分、近距離で繰り返しアクセスする用途に使われます。
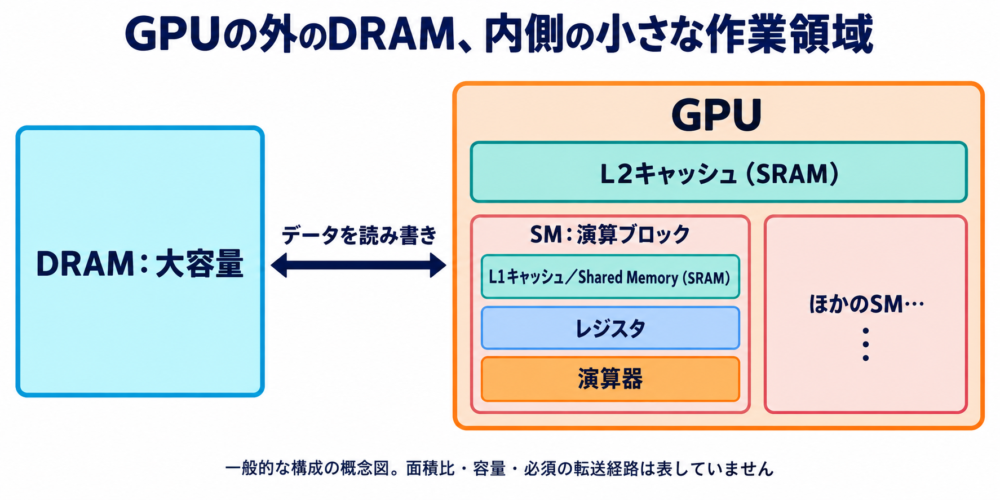
図は一般的なGPUの概念を整理したものです。各段を必ず直列に通る配線図ではなく、RTX Sparkの内部容量や面積比も表していません。
| 領域 | 使い方 | 管理の考え方 |
|---|---|---|
| L2キャッシュ | 複数の演算ブロックから利用するデータを保持 | 主にハードウェアが再利用を助ける |
| L1キャッシュ | 演算ブロックの近くで最近使ったデータなどを保持 | 主にハードウェアが管理する |
| Shared Memory | 協力するスレッド群でデータを共有 | プログラムが利用方法を決める |
| レジスタ | 演算中の値や一時結果を保持 | 各スレッドの実行に密接に結び付く |
SM(Streaming Multiprocessor)はGPU内の演算ブロックです。SMには演算器やレジスタがあり、L1キャッシュとShared Memoryは物理資源を共有する構成が使われます。これらの容量や構成はGPUの世代によって変わります。
行列計算では、大きな行列の一部を小さな塊に分けて近くに置き、何度も計算に使います。この小さな塊をタイルと呼びます。一度読み込んだタイルを複数の演算に再利用すれば、同じ数値を外部メモリから読み直す回数を減らせます。
出典:CUDAのGPUハードウェアモデル、CUDAカーネルのメモリ利用
文書を要約するとき、データはどう動くのか
LLM(大規模言語モデル)で、PCに保存した文書を要約する場面を考えます。以下はGPUでモデルの計算を行う一般的な例であり、特定アプリの実装をそのまま示したものではありません。
1. モデルを読み込み、入力を準備する
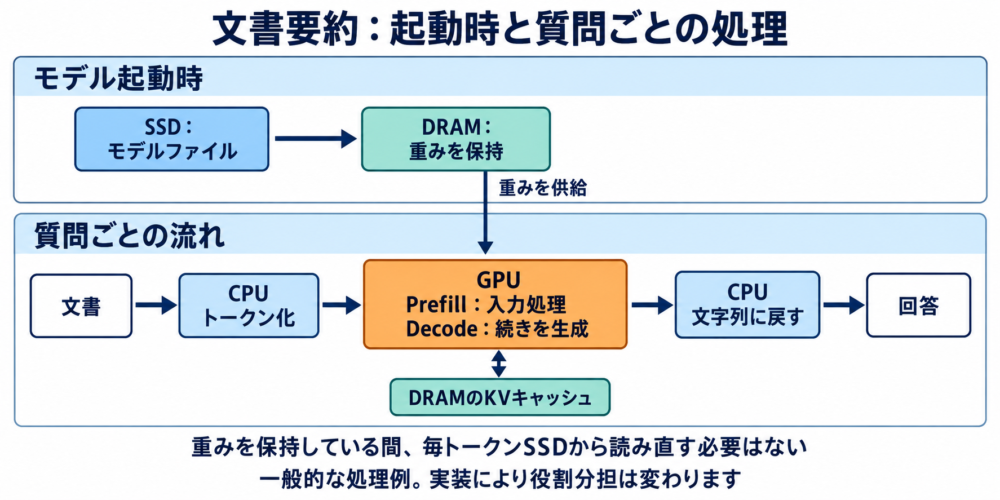
モデルファイルには、学習で決まった重み(計算に用いる多数の数値)が保存されています。モデルを起動すると、その重みをSSDからメモリへ読み込みます。メモリに保持できている間は、回答の1文字ごとにモデル全体をSSDから読み直す必要はありません。
CPU側では文書を読み、文章をトークン(モデルが扱う文字列の単位)へ分割し、数値の列に変換します。ここでは日本語の1文字と1トークンが必ず一致するわけではありません。
2. GPUが入力を処理し、続きを生成する
入力全体の情報を処理する段階をPrefill、続きを順に生成する段階をDecodeと呼びます。GPUはDRAMに置かれた重みや入力を読み、内部のキャッシュなども利用しながら計算します。
Decodeでは、生成済みの情報を利用して次のトークンを決めます。このときKVキャッシュ(過去のトークンに関する計算結果の保存領域)を持つことで、同じ計算のやり直しを減らします。文脈が長くなれば、この保存領域もメモリを使います。詳しくはKV Cacheとは?LLMの生成を高速化する仕組みで解説しています。
文章として表示する段階では、得られたトークン列を文字列に戻します。GPUの演算、CPU側の処理、画面表示が連携して、ユーザーが読む回答になります。
入力処理と逐次生成の違いは、LLMは並列計算できるのに、なぜ1文字ずつ答える?PrefillとDecodeの違いで解説しています。
AIエージェントでは、推論とツール実行を繰り返す
AIエージェントは、目標に向けてモデルが処理を判断し、ファイル検索などのツールを使い、その結果を見て次の処理を決める仕組みです。
「文書を要約する」に加えて「必要な文書を探す」「結果をファイルへ保存する」といった作業を行う場合、モデルの推論だけでは完結しません。アプリやOSがツールを実行し、その結果をモデルへ返します。
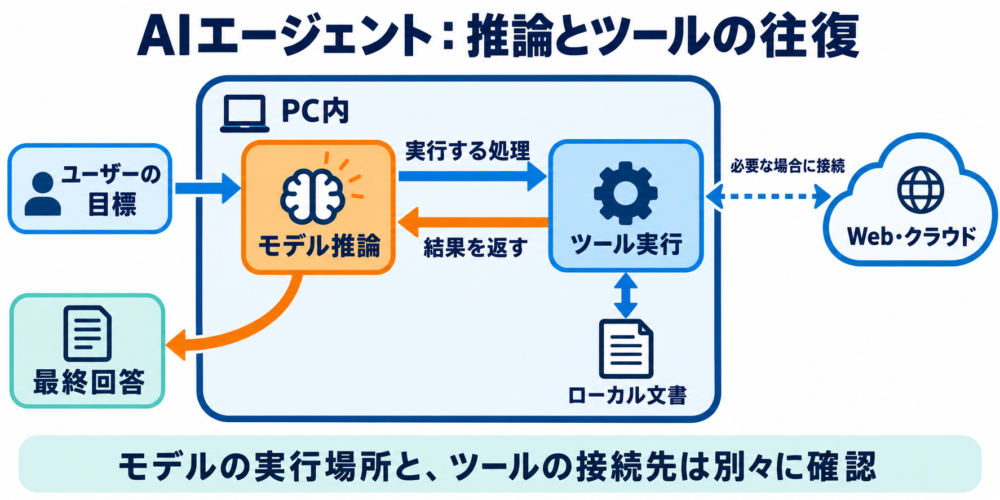
ローカルAIとは、推論を手元のPCなどで実行することです。エージェントがWebを検索したり、クラウドのモデルや外部サービスを使ったりすれば、その処理ではネットワーク通信が発生します。文書をPC内で扱いたい場合は、モデルの実行場所とツールの接続先を両方確認します。
IFAでは導入を助けるアプリ側の対応も紹介されました。対応状況はソフトごとに異なるため、PCを購入すれば紹介された機能がすべて同じ条件で使える、と考えないことが大切です。
また、NVIDIA PAIR(Personal AI Router)は、独立した推論リクエストをネットワーク内のPCへ振り分ける仕組みです。複数PCのメモリが自動的に一つの大きなメモリへまとまる機能とは用途が異なります。
「最大1PFLOP」「最大128GB」をどう読むか
計算性能と、回答が出る速さを分ける
RTX Sparkの最大1PFLOPは、FP4(4ビットの浮動小数点形式)によるAI性能の公称値です。FLOPSは1秒当たりの浮動小数点演算数を示し、Pは10の15乗を表します。
数値形式が違えば、1回の演算で扱う情報や必要な回路も変わります。そのため、FP4の値をFP32(32ビット形式)の値と条件なしに比較したり、そのまま文章生成の速度に換算したりすることはできません。
| 見る指標 | 分かること | この指標だけでは分からないこと |
|---|---|---|
| 演算性能 | 特定条件での計算量の目安 | アプリ全体の応答時間 |
| メモリ容量 | データをどれだけ保持できるか | そのデータを読む速度 |
| メモリ帯域 | 単位時間に転送できるデータ量 | 計算や同期を含む最終的な速度 |
| 実アプリの測定 | そのモデル・設定での待ち時間や処理量 | 別のモデルや条件でも同じ結果になるか |
たとえば単一の会話を少量ずつ生成する場合、演算器の最大能力よりも、重みをメモリから供給する速さが制約になることがあります。逆に多数の入力をまとめて処理する場合は、演算能力を活用しやすくなる場合があります。評価ではモデル、入力長、同時処理数、電力設定をそろえる必要があります。
IFAの発表にある「最大1.9倍」のllama.cpp高速化は、GeForce RTX 5090での説明です。RTX Sparkの実測結果として紹介しないよう、対象機種まで確認します。
出典:RTX Spark公式仕様、NVIDIAの推論高速化発表
モデルが入る容量には、重み以外も含める
説明用に、300億個の重みを1個4ビットで保持すると仮定します。重み本体だけなら、300億×4÷8=150億バイト、十進表記で約15GBです。
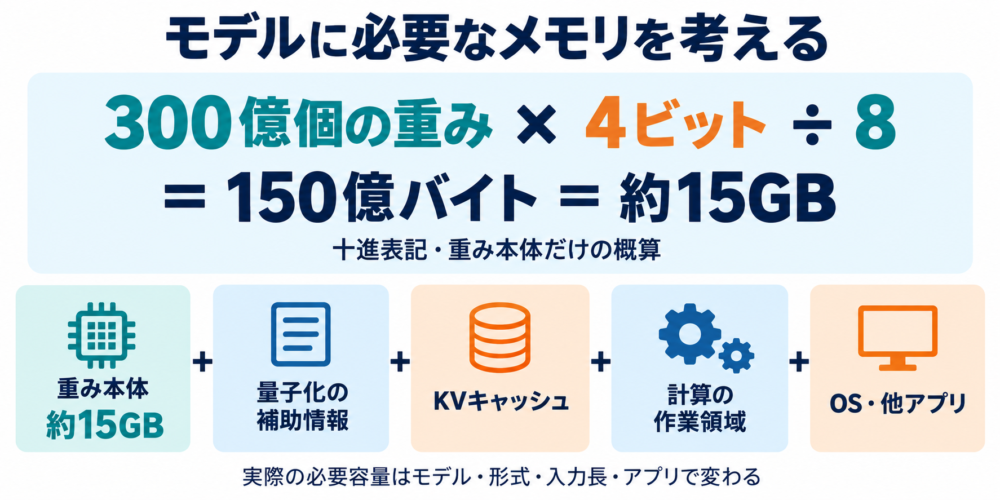
これは特定モデルの必要容量ではありません。実際には量子化(少ないビット数で値を表す処理)に伴う補助情報、一部の高精度な値、KVキャッシュ、計算の作業領域なども必要です。さらにPCではOSや他のアプリも動いています。
モデルファイルが小さくなったことと、十分な速度・品質で使えることは別々に確認します。量子化方式、対応する計算処理、入力する文書の長さによって、容量・速度・回答品質の関係が変わります。ビット数を減らす仕組みは、量子化とは?LLMを軽くする省メモリ技術で補足しています。
どのような使い方で注目できるか
用途を考える際は、最大仕様から結論を出すより、動かしたい処理を具体化すると判断しやすくなります。
| 想定用途 | 期待する使い方 | 確認する条件・代償 |
|---|---|---|
| 手元の文書の要約・検索補助 | ローカルのモデルで内容を処理する | 日本語の精度、長文時の容量、文書読み取り機能、外部送信の有無 |
| コード作成の補助 | PC上でモデルを動かし、編集や確認を支援する | モデル品質、開発環境への対応、ファイル変更の権限 |
| 画像編集・制作 | 対応アプリがGPUを使って処理する | 個別機能のローカル対応、必要な契約、処理時間 |
| 常時動く補助エージェント | ツールを使う反復処理を手元で実行する | 消費電力、他の作業との競合、実行範囲の設定 |
| モデルの開発・試作 | CUDA環境と大容量メモリを利用する | Arm版Windowsに対応するパッケージ、ドライバ、必要なライブラリ |
これらは利用を検討するための例であり、実機での動作を保証する一覧ではありません。特に開発用途では、CUDA対応という説明に加えて、自分が使うフレームワークや拡張機能が対象OS・CPU構成に対応しているかを確認します。
RTX Sparkを理解する入口は、「CPUが処理を進め、GPUが計算し、メモリからデータを供給する」という関係です。今後の購入判断では、この仕組みに加えて、国内向け構成、アプリの対応状況、同じ条件で測った実機の応答時間を確認していくと、公称値を用途に結び付けられます。
コメント