過学習とは、AIのモデルが学習に使ったデータへ合わせすぎて、まだ見ていないデータへの予測がうまくいかなくなることです。英語ではoverfitting、日本語では「過剰適合」とも呼ばれます。
学習データで正解が増えても、その外側で同じように当たるとは限りません。対策を選ぶには、学習用と検証用の成績を分け、グラフの横軸と評価条件を確認することから始めます。
この記事では、架空データの計算例で過学習と学習不足の違いを見たうえで、学習曲線の読み方、正則化・早期終了・データ追加の使い分けを整理します。
過学習では、手元のデータへの当てはまりと予測力がずれる
モデルに求めるのは、学習済みの例だけでなく、新しい例にも対応する力です。この性質を汎化(学習に使っていないデータへも対応できること)といいます。Googleの過学習教材でも、学習データへの適合と新しいデータでの予測を区別しています。
限られたデータには、本来知りたい規則に加えて、偶然の揺らぎや測定の誤差が含まれます。モデルがそれらまで追いかけると、学習用の成績はよくても、新しいデータへの予測が不安定になることがあります。
同じ11点を、3種類のモデルで学習させる
説明用に、入力を二乗すると出力になる「y = x²」という架空の規則を考えます。−1から1までの11点に小さな揺らぎを加えて学習用データにし、同じ範囲の別の20点を検証用にします。違いを見やすくするため、この検証用データには揺らぎを加えていません。
同じ学習用データへ、一定の値しか返さない0次モデル、二次曲線を使う2次モデル、細かく曲がれる9次モデルを、最小二乗法(予測と正解の差の二乗和を小さくする方法)で当てはめました。
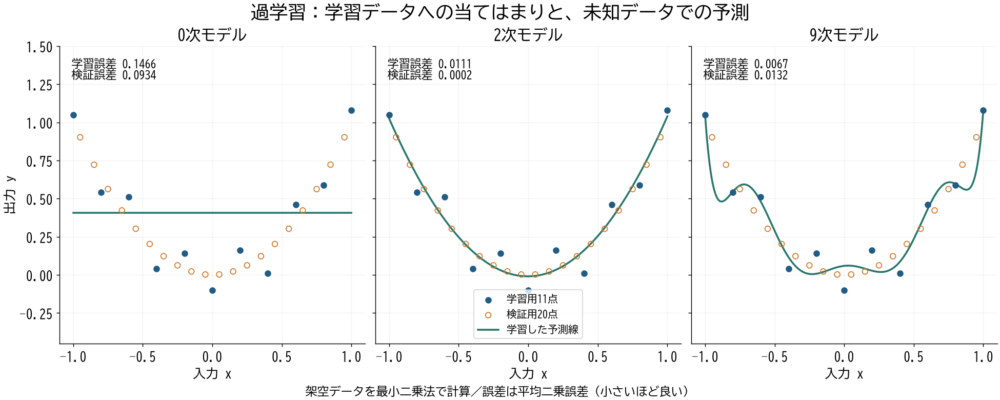
架空データを使った筆者の計算例。青は学習用、橙の白抜き点は検証用、緑はモデルの予測です。検証用にはノイズを加えていません。
| モデル | 学習用の平均二乗誤差 | 検証用の平均二乗誤差 | この例での読み方 |
|---|---|---|---|
| 0次:一定の値を返す | 0.1466 | 0.0934 | 曲がった規則を表せず、学習不足 |
| 2次:二次曲線を使う | 0.0111 | 0.0002 | 元の規則をよく捉えている |
| 9次:細かく曲がれる | 0.0067 | 0.0132 | 学習用にはより合うが、検証用では悪化 |
平均二乗誤差は、各点の「予測−正解」を二乗して平均した値で、小さいほど予測がよく合っています。9次モデルは2次モデルより学習誤差を減らしましたが、未知の点への予測は悪くなりました。
これは筆者が架空データで計算した例であり、実業務の性能を示すものではありません。学習用には揺らぎがあり検証用にはないため、2次モデルの検証誤差は学習誤差より小さくなっています。誤差の大小関係だけでなく、何を比べているかも読む必要があります。
学習不足との違い
学習不足では、モデルが単純すぎる、学習が十分に進んでいないなどの理由で、学習データの規則も捉えられていません。過学習では、学習データにはよく合っていても、その適合が未知データへの改善につながりません。
この例で2次モデルが有利なのは、元の規則を二次関数として作ったからです。実際のデータでは正しい規則が見えないので、モデルの複雑さを変えて検証します。大きいモデルが必ず過学習するわけでも、小さいモデルが常によいわけでもありません。TensorFlowの公式教材も、モデルの容量を小さくしすぎると適合が難しくなる点を説明しています。
見分ける前に、学習・検証・テストの役割を分ける
モデル選びに使ったデータだけで成績を報告すると、何度も試した中で偶然よかった設定を選んでいる可能性があります。用途を分けて、最終評価のデータを調整に使い込まないようにします。
| データ | 使う場面 | 注意すること |
|---|---|---|
| 学習用 | モデルの重みなどを学ぶ | この成績だけで予測力を判断しない |
| 検証用 | モデルの大きさや停止時点を選ぶ | 選び続けると、このデータにも都合よく調整される |
| テスト用 | 調整が終わったモデルを評価する | 結果を見て調整へ戻ると、独立した最終評価ではなくなる |
データが少ない場合は、分割を変えて評価する交差検証も選択肢です。ただし、交差検証は性能を見積もったり設定を選んだりする方法なので、実行しただけでモデルの過学習が解消するわけではありません。scikit-learnの交差検証ガイドでは、通常の分割に加え、同じ人やグループをまたがせない分割、時系列の順序を保つ分割も扱っています。
たとえば将来の売上を予測したいなら、過去から未来を予測する条件で評価します。同じ顧客の類似データが学習用と検証用に入る場合は、顧客単位で分ける必要がないか確認します。分割比率を決める前に、「どんな新しいデータへの性能を知りたいか」を決めるのが先です。
学習曲線は、横軸によって読み方が変わる
学習用と検証用の成績を並べたグラフでも、横軸が違えば確認できることが変わります。縦軸も、損失や誤差なら小さいほどよく、正解率なら大きいほどよいという違いがあります。
| 横軸 | 主に確かめたいこと | 次の判断につながる例 |
|---|---|---|
| 学習回数・エポック | 学習を続けると検証性能も改善するか | 早期終了を検討する |
| 学習データの件数 | データを増やすと性能が改善するか | データ追加の効果を見積もる |
| モデルの複雑さ・設定値 | どの設定が検証用でよいか | 容量や正則化の強さを選ぶ |
エポックは、学習データを一巡する回数です。scikit-learnの学習曲線の解説では、件数を変えた曲線と、設定値を変えた検証曲線を区別しています。グラフ名だけで「もっと長く学習すべき」と判断せず、横軸を確かめてください。
学習回数を増やして、検証用だけ悪くなる場合
次の数値は、動きを説明するために設定した模式例です。実際の学習ログではありません。
| エポック | 学習用の損失 | 検証用の損失 |
|---|---|---|
| 1 | 0.90 | 0.94 |
| 3 | 0.47 | 0.55 |
| 5 | 0.26 | 0.46 |
| 8 | 0.13 | 0.63 |
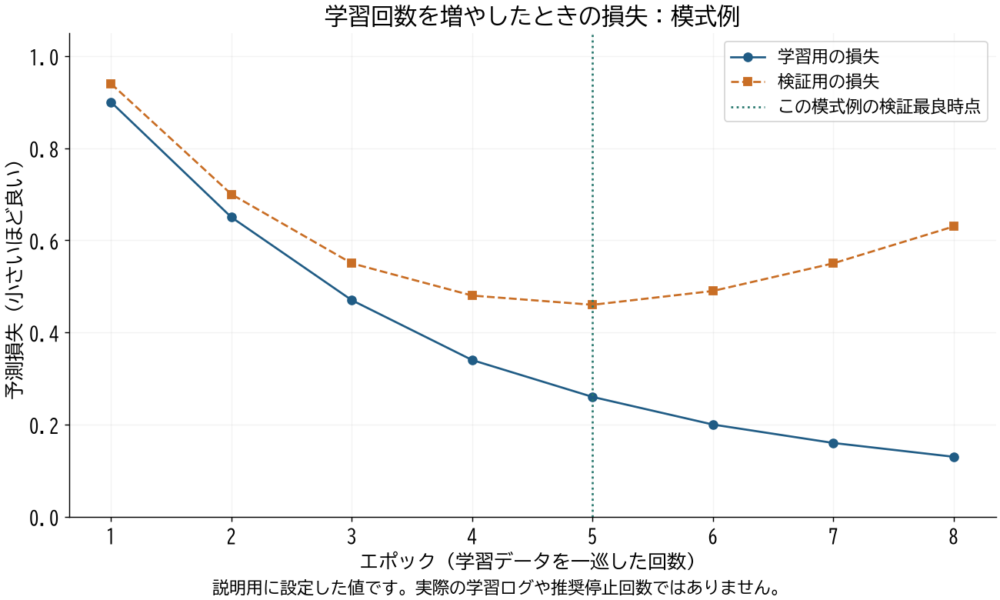
説明用の模式曲線であり、実際の学習ログではありません。5エポックは推奨する停止回数ではありません。
この例では、5エポックを過ぎても学習用の損失は下がりますが、検証用では悪くなっています。そこで、検証用の改善が止まったら学習を終える早期終了を検討できます。実際の値は上下するため、1回の悪化だけで停止せず、改善を待つ回数などを設定します。
また、「停止したときのモデル」と「検証用で最もよかった時点のモデル」は同じとは限りません。KerasのEarlyStoppingでは、最良時点の重みへ戻すrestore_best_weightsは既定で無効です。利用する仕組みで、監視指標、待機回数、最良モデルの保存・復元を確認してください。表の5回は説明用であり、推奨する停止回数ではありません。
データの件数を増やして、差が縮まる場合
データ追加を判断するには、モデルと評価条件をそろえて、学習に使う件数を変えます。学習回数を増やす実験とは別の比較です。
筆者の計算では、同じ「y = x²」に標準偏差0.12のノイズを加え、9次モデルを固定しました。入力は−1から1の一様乱数とし、独立な平均0の正規ノイズを加えました。学習用は20・40・80・160・320件、検証用は独立に作った2,000件で固定しています。学習側の乱数seed(乱数列を再現するための値)を0〜29に変えて30回計算し、各回では320件の先頭から必要件数を使いました。この実験では検証用にもノイズがあるため、先ほどの3モデル比較の数値とは直接比べません。
20件の場合、検証誤差の平均は約19.61、中央値は約0.072でした。30回のうち最大の検証誤差は約460.23で、予測線が大きく振れた一部の結果が平均を押し上げています。80件では平均約0.0177、320件では約0.0148になりました。
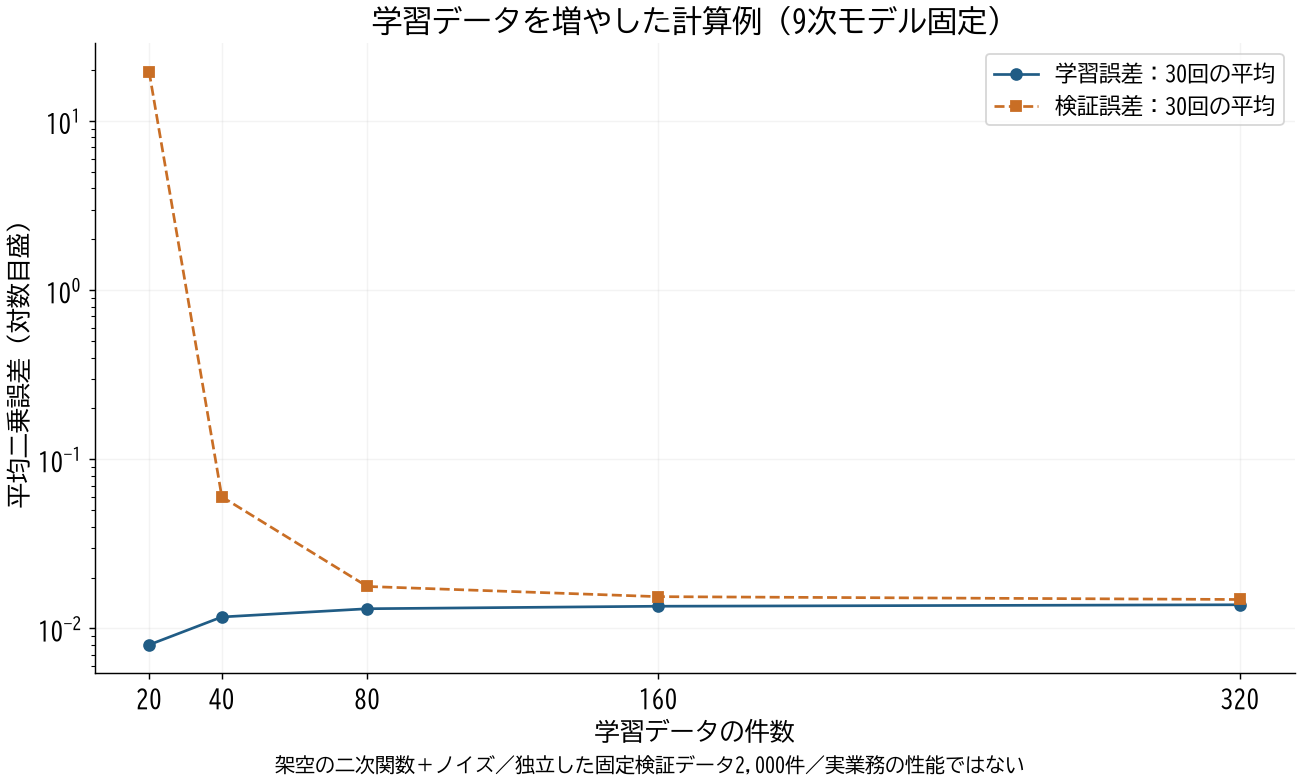
独自の架空データによる計算。30回の平均で、縦軸は対数目盛です。少数データの平均は一部の大きな誤差の影響を受けています。
この条件ではデータ追加で検証誤差が小さくなりましたが、「何件あれば十分か」は問題によって異なります。平均だけでなく、分割や学習データを変えたときのばらつきも確認してください。学習用・検証用とも悪いままなら、件数を増やす以外に、モデルや入力情報の見直しが必要な可能性があります。
原因の見当を付けてから、対策を選ぶ
同じ「検証用で当たらない」状態でも、対策の方向は一つではありません。以下は比較条件を点検した後に試すための整理です。
| 観察した状態 | 試す対策 | 狙い | 注意点・代償 |
|---|---|---|---|
| 学習用には細かく合うが、検証用で悪い | モデルを小さくする・木の深さを制限する | 偶然の揺らぎを追いにくくする | 単純にしすぎると必要な規則も捉えにくい |
| 重みを大きく調整して学習用へ合わせている | 正則化を加える・強さを調整する | 過度な適合を抑える | 強すぎると学習不足に寄る |
| 学習を続けるほど検証損失が悪化する | 早期終了と最良モデルの保存 | 悪化する前のモデルを選ぶ | 監視値の揺れと復元設定を確認する |
| 件数を増やすと検証誤差が下がる | 利用場面を代表するデータを追加する | 学習例に依存しすぎる状態を緩和する | 重複を増やすだけでは情報が増えにくい |
| 画像などで、意味を保つ変換が使える | データ拡張 | 入力の変化を学習に含める | 正解の意味を変える加工は避ける |
| ニューラルネットワークで一部の特徴に依存する | ドロップアウト | 学習時に一部の出力をランダムに無効化する | 強すぎると学習が進みにくい。評価時と条件が異なる |
正則化は、モデルを学習データへ合わせることに加えて、重みの大きさなどにも制約を与える考え方です。たとえばL2正則化では、予測損失に重みの二乗和に応じた罰則を加えます。強さを増やせばよいとは限らず、検証用の成績を見ながら調整します。GoogleのL2正則化の解説
データ拡張も、ただ加工の種類を増やせばよいわけではありません。画像を少し移動しても分類ラベルが変わらない課題なら使えますが、向きが正解を左右する課題では回転や反転が誤った教師情報になることがあります。実際に予測したい変化か、正解を保てるかを確認します。
複数の対策を同時に変えると、どれが効いたか分かりにくくなります。比較基準となるモデルとデータ分割を記録し、変更する条件を絞って検証する方が、次の判断につながります。
誤差に差があるとき、過学習以外も確認する
損失の中身と、測る条件をそろえる
学習中にドロップアウトやデータ拡張を使い、検証時には使わない場合、学習用の方が難しい条件で測られていることがあります。そのため、検証損失が学習損失より低いという理由だけで、不具合とは判断できません。
正則化を含む合計損失と、予測の誤差だけを表す指標も区別します。正則化の強さを変えた実験で合計損失だけを比べると、予測性能と罰則の変化が混ざります。損失の差に共通の合格ラインを置くのではなく、業務に必要な誤差や正解率も併せて見ます。TensorFlowの教材では、その混同を避けるため、正則化項を含まない指標も監視しています。
必要なら同じモデルを同じ評価モードにして、学習用と検証用を測り直します。縦軸の名前だけでなく、正則化項の有無や、いつ集計された値なのかを確認してください。
データの変化や、評価への情報混入を分ける
運用を始めてから入力の傾向が変わった場合は、学習時の過学習とは別に、データドリフト(データ分布の変化)を調べる必要があります。
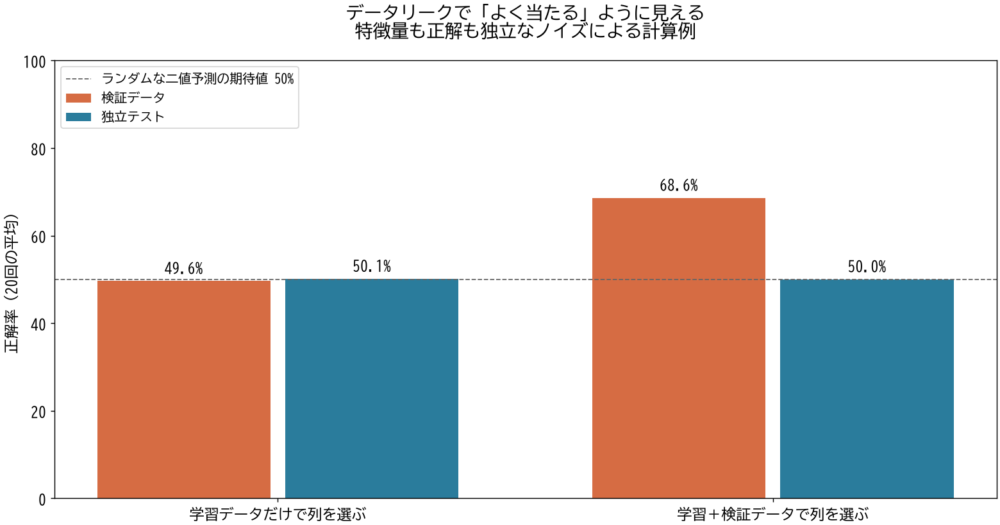
反対に、検証用では不自然によい成績が出て、本番で大きく落ちる場合は、データリークも点検します。これは、予測時には使えない情報が学習やモデル選びへ混ざり、評価が過大になる問題です。たとえば、前処理の平均値を学習用と検証用の全体から求めていないか確認します。scikit-learnのデータリーク解説
こうした問題は過学習と併存することもあるため、どれか一つの名前を付けることより、比較を成立させる条件をそろえることが先です。
手元のモデルでは、何から確認するか
- どんな未知データを予測したいかを決め、学習・検証・テストの分割を確認する。
- 学習用と検証用で、同じ意味の指標を比較しているか確かめる。
- 横軸が学習回数か件数かを確認し、どこから改善が止まるかを見る。
- モデルの大きさ、正則化、停止時点、データ量を条件ごとに比較する。
- 調整に使っていないテスト用データで、選んだモデルを評価する。
学習用の成績を上げることを目的にせず、予測したいデータで改善しているかを確かめる。この順序を守ると、過学習の対策を名前だけで選ばずに済みます。LLMの追加学習に当てはめる場合は、Fine-tuningの設計と評価も参照してください。
コメント