交差検証(cross-validation、CV)は、学習用と評価用のデータを入れ替えながらモデルを作り直し、未知のデータへの性能を見積もる方法です。代表的なk分割交差検証では、データをk個の区画に分け、評価役を交代させてk回のスコアを集めます。平均スコアはモデルや設定を比較する材料になりますが、その比較で選んだ設定の最終成績は、選択に使わなかったデータで確かめます。
ここでは、説明用の1000件を使って、5分割の手順、平均とばらつき、最後に使うモデルまでを追います。数値は仕組みを説明するための架空例で、実際に学習したモデルの測定結果ではありません。
交差検証は、学習に使わない区画を交代させて評価する
学習したデータで高い正解率が出ても、新しいデータに同じように答えられるとは限りません。そこで、学習に使わなかったデータで性能を測ります。
ホールドアウト検証では、学習側と評価側を一度分け、その分割で評価します。k分割交差検証では、評価に回す区画を替えながら学習と評価を繰り返します。fold(フォールド)は、この分割された区画を指す言葉です。
| 比較する点 | ホールドアウト検証 | k分割交差検証 |
|---|---|---|
| 評価の仕方 | 固定した評価用データで測る | 各foldを順番に評価用へ回す |
| 1候補あたりの学習回数 | 1回 | k回 |
| 得られるスコア | その分割での1個 | k個のスコアとその集計 |
| 利点 | 計算が少なく、結果を確認しやすい | 複数の学習・評価の組で成績を見られる |
| 注意点 | 分割の選び方に結果が左右される | 計算が増え、分割の前提や集計の解釈が必要 |
この回数は、前処理を含む学習手順と設定を1つに固定し、最終モデルの再学習を除いたものです。交差検証は性能を評価する手順なので、実行するだけで過学習が解消するわけではありません。過学習そのものの対処は過学習の見分け方と対策で整理しています。
1000件から5分割交差検証を行う流れ
モデル選択を行う例として、1000件のうち200件を最初に最終テスト用へ分け、残り800件を開発用にします。ここでの8対2は説明のための比率で、常に推奨される割合ではありません。
最終テスト200件は、候補を選ぶ間は使いません。 開発用800件だけを160件ずつの5区画に分けます。以下は各行を独立した標本として扱える場合の基本例です。時間の順序や同一人物の繰り返し観測がある場合は、後述する分割条件を先に決めます。
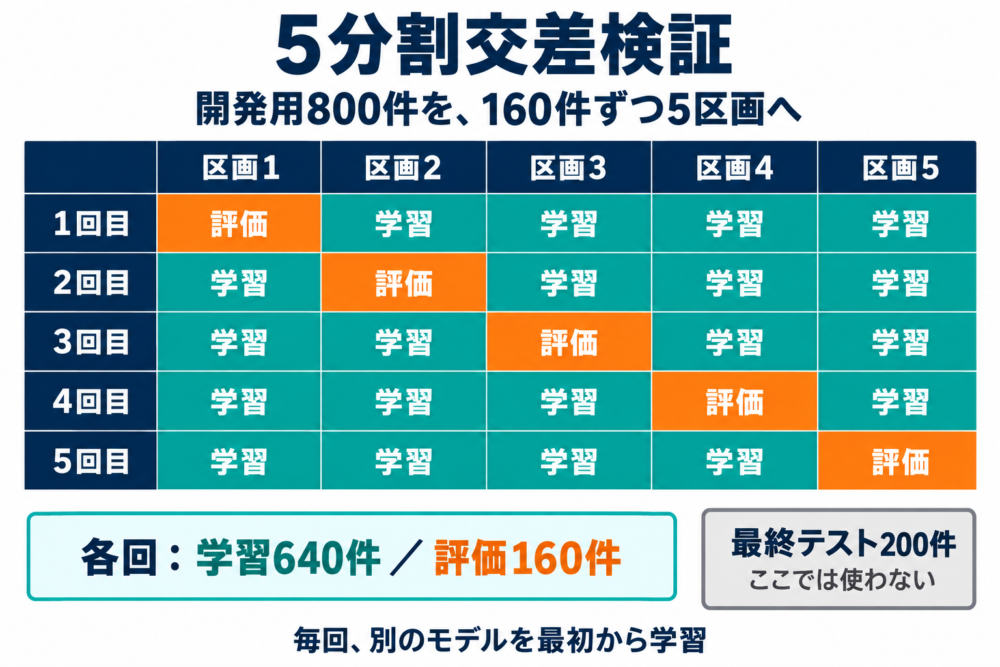
5分割の模式図。橙色の評価役を交代させ、毎回640件で新しく学習します。
- 1つの区画160件を評価用にし、残り640件で学習する。
- 学習したモデルで、評価用160件の正解率を計算する。
- 評価用の区画を替え、別のモデルを最初から学習する。
- 5区画すべてを評価役にしたら、5つのスコアを集計する。
各回で前回の学習結果を引き継がないのは、その回の評価データを、前の回で学んだ状態にしないためです。標準化など、データから値を求める前処理も、その回の学習側640件だけで学びます。
この基本的な5分割では、開発用の各データは評価に1回、学習に4回使われます。同じ回の学習側と評価側は重ならず、別の回どうしの学習データは重なります。scikit-learnの交差検証ガイドでも、k−1区画で学習して残り1区画で評価する手順と、前処理を学習側で学ぶ必要性が説明されています。
平均80%と標準偏差3.16ポイントをどう読むか
同じ5区画で、設定Aと設定Bを比べたとします。各回の評価件数は160件で統一します。
| 評価した区画 | 設定Aの正解数 | Aの正解率 | 設定Bの正解数 | Bの正解率 |
|---|---|---|---|---|
| 1 | 120 / 160 | 75% | 128 / 160 | 80% |
| 2 | 128 / 160 | 80% | 136 / 160 | 85% |
| 3 | 136 / 160 | 85% | 144 / 160 | 90% |
| 4 | 128 / 160 | 80% | 128 / 160 | 80% |
| 5 | 128 / 160 | 80% | 136 / 160 | 85% |
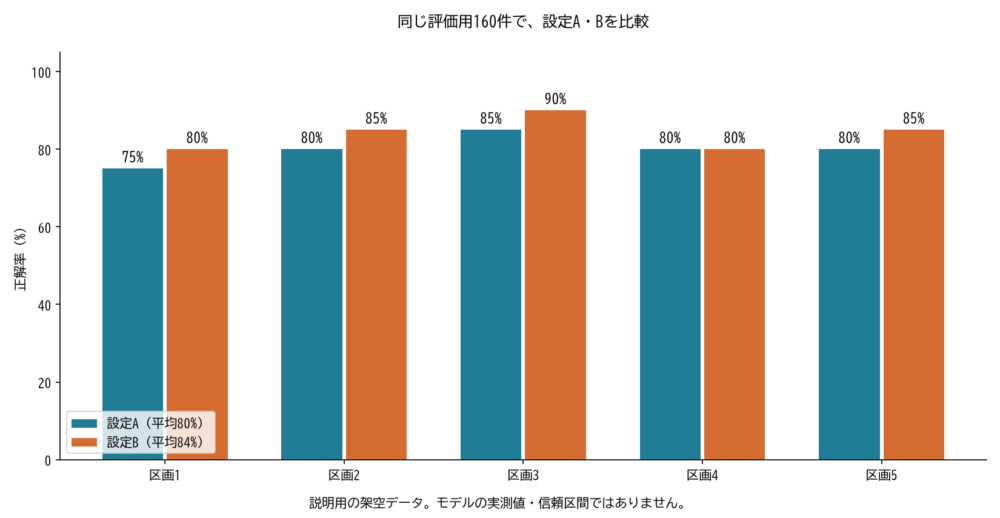
架空の計算例を図示。各区画では同じ160件でAとBを比べています。
平均は5回のスコアの要約
設定Aの平均正解率は、次のように求まります。
この例では各区画の評価件数が等しいので、正解数の合計640件を開発用800件で割っても80%になります。ただし、この640件は5つの異なるモデルの予測を集めた数です。1つのモデルが800件を予測した成績と取り違えないようにします。
区画ごとの件数が異なる場合、スコアの単純平均と件数で重みを付けた平均は一致しないことがあります。また、F1のような指標では、各回のF1の平均と、予測を全件まとめて計算したF1は別の値になり得ます。集計方法も成績の条件として残します。
標準偏差は、観測した5回の散らばり
ここでは、5個のスコアのばらつきを表す標準偏差を、分母5で計算します。標本から分散を推定するときに使う分母4の計算とは区別し、計算方法も併記します。
平均からのずれは、−5、0、+5、0、0パーセントポイントです。その二乗の平均は10なので、標準偏差は約3.16パーセントポイントになります。
| 集計 | 設定A | 設定B |
|---|---|---|
| 平均正解率 | 80% | 84% |
| 標準偏差(分母5) | 約3.16ポイント | 約3.74ポイント |
| 最小〜最大 | 75〜85% | 80〜90% |
平均だけを見るとBが4ポイント高く、5回のうち4回でAを上回り、1回は同じでした。平均正解率を選択基準として事前に決めていたなら、この比較ではBを選びます。一方、Bの標準偏差が少し大きいことだけで、Aの方が優れたモデルだとは判断できません。
この標準偏差は、将来の正解率が入る範囲や95%信頼区間を表すものではありません。各回の学習データが重なり、スコアどうしを独立した5回の実験とは扱えないためです。標準偏差をそのまま誤差棒にして、モデル間の差の有意性を結論づけることも避けます。
BengioとGrandvaletの論文は、交差検証の分散推定で、データの重なりによる誤差の相関を無視する危険を論じています。本記事では統計的な有意差の判定に踏み込まず、平均・各回の値・分割条件をセットで読むところまでとします。
モデルを選んだら、再学習して最終テストで測る
設定Bを選んだ後は、その設定で開発用800件を使い、最終モデルを新しく学習します。そのモデルを、取っておいた200件で評価します。
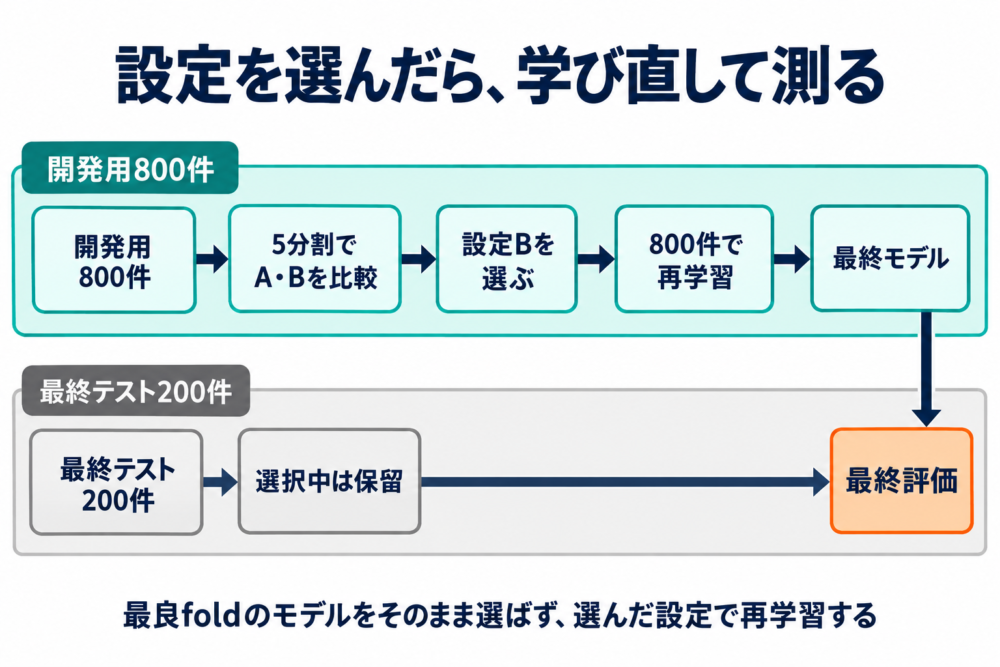
選んだ設定で再学習する流れの模式図。200件は選択と再学習に使いません。
交差検証の中で90%を出した3回目のモデルを、そのまま「一番よいモデル」として選ぶ流れではありません。各回は評価データが異なるため、最高値にはその区画との相性も含まれます。設定を選ぶための比較が済んだら、利用できる開発用データ全体で学び直します。
scikit-learnのGridSearchCVでは、refit=Trueを使うと、探索で選ばれた設定で、渡したデータ全体に再学習します。ここで渡すのは開発用800件であり、最終テスト200件は含めません。best_score_は選ばれた候補の交差検証の平均値で、最終テストの成績とは区別します。
なぜ別の200件が必要なのでしょうか。AとBの比較に使ったスコアには、設定を選んだ影響が含まれるためです。候補をたくさん試して最大値を選ぶと、そのデータにたまたま合った候補を拾う可能性もあります。選択済みの平均84%を、そのまま独立した最終評価として報告しないようにします。
最終テストを見て設定を変えた場合、その200件も選択へ関与したデータになります。最終テストの結果に応じて何度も調整を続けるなら、評価の設計から見直します。評価後に全1000件で学習し直す場合も、それは別のモデルです。以前の200件での成績を、新しいモデルを独立に測った値として扱うことはできません。
二重交差検証は選択の手順ごと評価する
最終評価も複数の分割で行いたい場合には、二重交差検証(nested CV)という方法があります。外側の学習データの中だけで、もう一度交差検証して設定を選びます。
外側5分割・内側5分割なら、外側の1回は次の順序です。
- 外側の評価用データを取り分ける。
- 外側の学習用データだけを内側で5分割し、候補を比べる。
- 選んだ設定で、外側の学習用データ全体に再学習する。
- 外側の評価用データで1回測る。
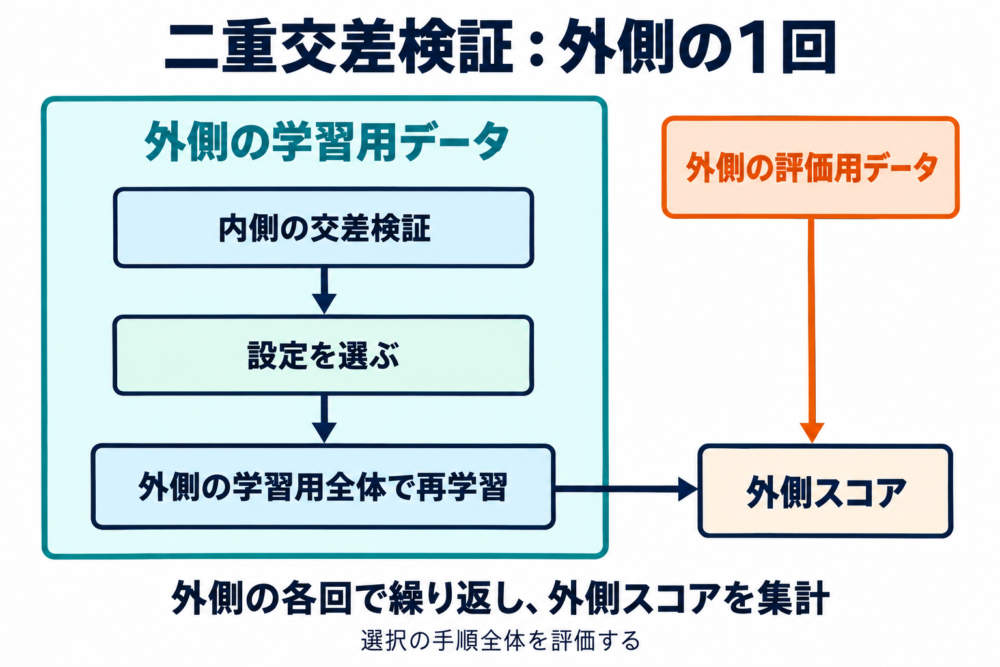
二重交差検証の外側1回を示す模式図。外側の評価データは、内側の候補選択に入れません。
これを外側の5回で繰り返し、外側スコアを集計します。外側ごとに選ばれる設定が違っても構いません。測っているのは、固定した1設定だけでなく「内側で設定を選び、学習する手順」の性能だからです。scikit-learnの二重交差検証の解説は、この内側の選択と外側の評価の役割を区別しています。
| 評価設計 | 候補を選ぶ場所 | 報告用の評価 | 負担・注意点 |
|---|---|---|---|
| 開発用CV+最終テスト | 開発用データ内 | 最初に保留したテスト | 役割を説明しやすい。保留分のデータ確保が必要 |
| 二重交差検証 | 各外側学習分割の内側 | 外側の評価スコア | 選択手順を複数分割で測れる。学習回数が多い |
二重交差検証の外側スコアを見て、候補や特徴量を繰り返し変更すれば、外側も選択に使ったことになります。評価対象の手順を先に決めておく必要があります。
二重交差検証を終えて本番用の1モデルを作るときは、採用した選択手順を開発用データ全体で実行し、選んだ設定で再学習します。外側スコアは、その手順を評価した記録として残します。先ほどの200件を保留する方式とは別の評価設計であり、両方を必ず実行するという意味ではありません。
分割数kは、学習量・評価件数・計算負担で決める
開発用800件を等分する場合、kを変えると1回で学習する件数と評価する件数が変わります。候補はA・Bの2つ、比較後に選んだ設定で1回再学習する条件で比べます。
| 方法 | 1回の学習件数 | 1回の評価件数 | 2候補の比較+最終再学習 |
|---|---|---|---|
| ホールドアウト(640対160) | 640 | 160 | 2+1=3回 |
| 5分割 | 640 | 160 | 2×5+1=11回 |
| 10分割 | 720 | 80 | 2×10+1=21回 |
kを増やすと各回で多くのデータを学習に使える一方、評価側は小さくなり、学習回数も増えます。kが大きいほどスコアが必ず安定する、という関係ではありません。少数クラスの件数やデータのまとまりによっては、評価用の区画を小さくし過ぎると指標を計算しにくくなります。
5分割や10分割はよく使われる候補ですが、データ量だけで自動的に決まるものではありません。分割が本番の予測対象に合っているか、各区画で必要な評価件数を確保できるか、候補数を含めた計算が実行可能かを確認します。
二重交差検証で外側5・内側5・候補2つなら、外側の各回に内側10回と再学習1回が必要で、評価部分だけで5×(2×5+1)=55回です。その後に開発用全体で同じ探索と再学習を行うなら、さらに11回を加えます。この回数は前処理を含む候補ごとの学習単位を数えたものです。実行時間は学習件数、並列実行、前処理の再利用などでも変わるため、回数の比をそのまま時間の比とは扱いません。
実行前に固定しておく評価条件
分割数を決める前に、どの未知データへの予測を評価したいのかを決めます。同じ人の記録が複数ある場合や未来を予測する場合、行を無作為に混ぜた通常の分割では、その目的を再現できないことがあります。時間・グループ・前処理の切り分けはデータリークの確認方法で詳しく扱っています。
今回の計算は正解率で行いましたが、見逃しを減らす目的なら再現率などを評価軸にする必要があります。どの指標を採用するかは適合率・再現率・F1スコアの使い分けも参照してください。
実験の記録には、使用データの版、分割方法とk、乱数設定、候補と選択基準、各foldの件数・スコア、集計方法、最終評価へ使ったデータを残します。「平均84%」にこれらの条件を添えることで、後から別のモデルや再実行結果と比較できるようになります。
コメント