機械学習のデータリークは、評価用データの情報や、本来の予測時点では使えない情報が学習・予測の仕組みに入り込み、性能評価を信用できなくする問題です。「データリーケージ」とも呼ばれます。ここで扱うのは、個人情報が外部へ流出する情報漏えいとは別の意味です。
防止のために確かめたいのは、評価側の情報で学習の手順を決めていないか、そして各入力を予測時点で実際に使えるかの2点です。前処理をどこで学習したか、どの行を評価へ回したか、入力値がいつ届いたかまで確認します。
スコアが高いことだけではリークと断定できません。逆に、目立った上昇がなくても情報の混入は起こり得るため、スコア差のしきい値だけで安全とは判断できません。まず計算例で「高く見える評価」を確認し、そのあと手元のデータで点検する場所を整理します。
定義と前処理の基本は、scikit-learnのCommon pitfallsを参照しています。
無関係なデータでも、検証結果がよく見える
説明のため、入力となる特徴量(予測に使う値)も、正解ラベルも、互いに無関係な乱数で作りました。本来、新しいデータの二択を安定して当てる手がかりはありません。
800列の候補から「正解と相関が強かった10列」を選び、同じ方法でモデルを学習します。比較するのは、列を選ぶときに見せるデータだけです。
| 手順 | 列の選択に使う範囲 | モデルの学習に使う範囲 |
|---|---|---|
| 評価を分離する | 学習用200件だけ | 学習用200件だけ |
| 検証情報を混ぜる | 学習用200件+検証用100件 | 学習用200件だけ |
さらに、どちらの列選びにも使わない独立テスト100件を残します。乱数を変えた20回の平均正解率は次のとおりでした。
| 手順 | 検証正解率 | 独立テスト正解率 |
|---|---|---|
| 学習用だけで列を選択 | 49.65% | 50.15% |
| 学習用+検証用で列を選択 | 68.65% | 50.05% |
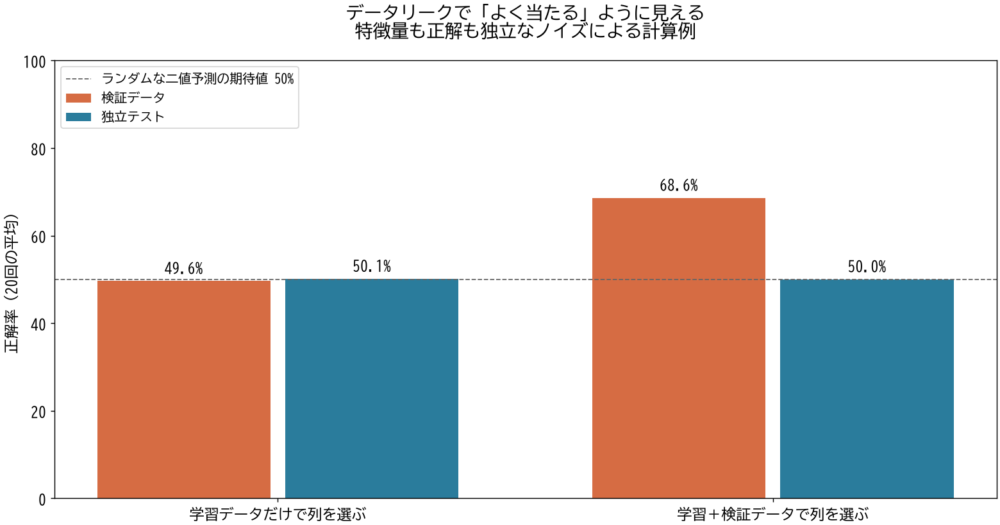
筆者作成の架空データによる20回の平均。独立テストは列の選択にもモデルの学習にも使っていません。
検証情報を見て列を選ぶと、その検証データに偶然合った列が残ります。モデルの係数を学習する際に検証データを渡していなくても、列の選択を通じて検証側の正解が入っているのが原因です。独立テストへ移ったとき、その見かけの良さは続きません。
これは筆者が作った架空データでの計算例です。各入力は独立な標準正規乱数、正解は等確率の−1と1とし、400件を先頭から200・100・100件に分けました。列は正解との相関係数の絶対値で選び、切片を含む線形モデルを係数の二乗への罰則付き最小二乗法で学習しています。罰則の強さは1、切片は罰則の対象外、予測値0を二択の境界としました。
乱数seed(乱数列を再現するための値)は0〜19をすべて使い、結果を見て設定を調整していません。ここでの差は特徴量選択による混入を示すもので、実業務でのリークの大きさや、対策による改善率を表すものではありません。
前処理も「学習する処理」に含める
列の選択に限らず、欠損値を埋める平均や、標準化に使う平均・分散もデータから決める値です。こうした値を求めるfit(データから変換ルールを学ぶ処理)の範囲に、評価データを入れないようにします。
小さな例として、学習用の値が2と4、評価用の値が100だったとします。平均を引いて中心化するだけでも、全件を使ったかどうかで学習用の値が変わります。
| 平均を求める範囲 | 計算した平均 | 学習用の2を変換すると |
|---|---|---|
| 学習用だけ | (2+4) ÷ 2 = 3 | 2 − 3 = −1 |
| 評価用も含む | (2+4+100) ÷ 3 ≒ 35.33 | 2 − 35.33 ≒ −33.33 |
後者では、評価用の100が学習データの表現に影響しています。この算術例は混入経路を示しており、必ず正解率が上がることを示すものではありません。
一般的な未知データへの予測を評価するなら、先にデータを分け、学習側だけで変換ルールを決めます。評価側には、そのルールを適用するtransformを使います。評価側でも別にfitすると変換の基準が変わるため、それも避けます。
交差検証(分割を入れ替えて評価する方法)では、この分離を各回の学習・評価の組ごとに守ります。最初に全体を標準化してから交差検証へ渡すと、各回の評価側を既に見た状態になります。
「過去のデータ」でも、予測時点に届いていたとは限らない
月曜9時に、その日の午後の売上を予測する場面を考えます。日付が月曜以前でも、すべての値を使えるとは限りません。
| 入力候補 | 情報の状態 | 月曜9時に使えるか |
|---|---|---|
| 日曜の売上集計 | 月曜8時に確定・到着済み | 使える |
| 月曜8時の注文記録 | 連携が遅れて10時に到着 | 使えない |
| 月曜の最終売上 | 閉店後に確定 | 使えない |
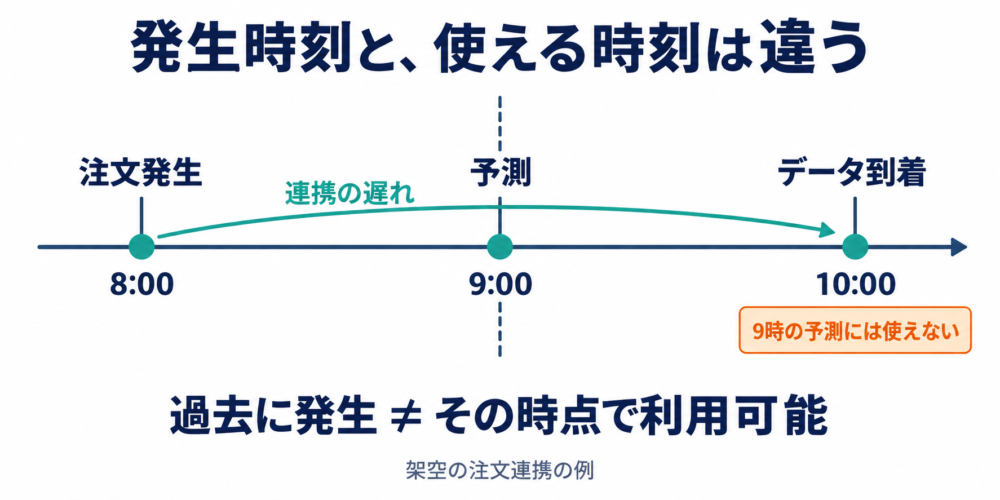
架空の注文連携を示した概念図。過去に起きたことと、その時点で利用できたことを区別します。
この例で必要なのは、出来事が起きた時刻と、その値を予測システムが利用できた時刻の区別です。あとから作ったデータベースには、遅れて到着した注文や修正済みの売上が載っています。その最新版を過去の予測行へ結合すると、当時は知らなかった情報を渡してしまいます。
FeastのPoint-in-time joinsでも、過去時点の特徴量を再現する考え方と、出来事の時刻だけでは後日の補正値が混ざり得る点が説明されています。実際のデータでは「利用可能時刻」が何を表す列かを確認し、当時の状態を再現できる履歴を残します。
予測先までの長さも関係します。月曜に火曜から日曜までをまとめて予測するなら、日曜の予測に土曜の実績を使うことはできません。単に1日分ずらした列でも、月曜時点では未来です。一方、毎朝予測を更新し、その時点までの実績を受け取る運用なら使える範囲は変わります。評価も、実際に何回情報を更新する運用なのかに合わせます。
分割方法は「何を未知として測るか」で選ぶ
同じ顧客の購入履歴、同じ機械のセンサーログ、同じ元画像から作った画像などは、行が違っても関連があります。新しい顧客や元画像への性能を知りたいのに、同じ由来の行が学習と評価をまたぐと、その目的に合わない評価になり得ます。
代表的な分割方法を、測りたい状況と一緒に比較します。
| 方法 | 向いている評価の目的 | 注意点・代償 |
|---|---|---|
| ランダム分割 | 行どうしをおおむね独立とみなせ、同様の条件の新しい標本を予測する | 時間や人物の依存を自動では除けない |
| グループ分割 | 未知の顧客・機械・元画像などへの予測 | グループ数が少ないと評価が不安定になりやすい。将来への予測をそのまま保証しない |
| 時系列分割 | 過去で学習し、それより後を予測する | 学習量や時期が分割ごとに異なる。未来の特徴量や近似重複は別途点検が必要 |
グループ分割を行うGroupKFoldは、同じグループを各回の学習側と評価側へまたがせません。考え方はscikit-learnのグループ付きデータの交差検証で確認できます。
ただし、既存顧客の来月の行動を予測するサービスでは、同じ顧客の過去を学習に使うこと自体が不適切とは限りません。「新規顧客を予測する」のか「既存顧客の将来を予測する」のかを先に決めます。将来の新規顧客を測るなら、時間とグループの両方を守る分割が必要です。
時系列用のTimeSeriesSplitには、学習区間の末尾から一定数の標本を除くgapがあります。単位は日数ではなく標本数です。日次の1行と、時刻が不規則なログの1行を同じようには扱えません。ラベルが確定するまでの期間や情報の到着遅延を調べ、必要な間隔を判断します。仕様上、分割間で同じ期間の評価を比較するには標本の等間隔性も前提になります。詳細はTimeSeriesSplitの公式説明を参照してください。
Pipelineで防げること、別に点検すること
Pipeline(前処理とモデルをひとまとまりにする仕組み)を交差検証へ渡すと、前処理も各回の学習側で学ぶ構成にできます。欠損補完、標準化、特徴量選択を、モデルと一緒に分割の内側へ入れるのが基本です。
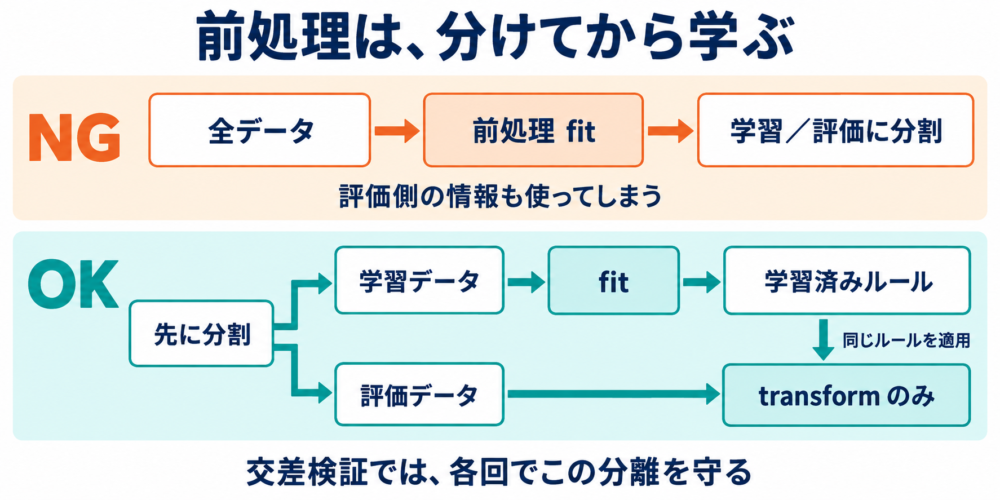
交差検証では、この分離を各回で行います。未来の値が入った列や重複の混在は、別に点検が必要です。
これはscikit-learnのPipelineが担う役割です。ただし、使ったというだけでは、以下の問題は解消しません。
| 点検するもの | Pipelineだけで解決しない理由 | 修正する場所 |
|---|---|---|
| 全体で選択済みの列を渡している | 外側で入った検証情報を取り消せない | 列の選択処理を分割の内側へ移す |
| 予測後に確定する値が入力にある | 列の業務上の意味を判断しない | 入力の定義と時点を直す |
| 同じ元画像の別加工版が混在 | 元データの由来を自動で識別しない | 加工前の由来で分割する |
| テスト結果を見て調整し続ける | 人間による設定選択も結果に適合する | 検証と最終評価の運用を分ける |
処理の部品をまとめることと、評価設計が目的に合っていることは別々に確認します。将来の値が入った列を正しく標準化しても、その列のリークは残ります。
リークが見つかったら、評価をどこからやり直すか
リークの疑いがあるときは、スコアを下げることを目標にせず、評価が何を測っているかを回復させます。次の順なら、修正する場所を追いやすくなります。
- 予測の条件を書く。 誰の、何を、いつの情報で、どれだけ先まで予測するのかを1文にします。
- 入力の由来を確認する。 各列の作成処理、集計範囲、確定・到着時刻、重複の元になるIDを調べます。
- 学習する処理の範囲を追う。 前処理や特徴量選択に、評価用の行や正解が入っていないか確認します。
- 分割と学習をやり直す。 リーク列を消すだけで済ませず、影響した前処理やモデルを作り直します。
- 選択に使っていないデータで最終確認する。 結果を見て設定変更に使ったテストは、もう独立な最終評価とは扱えません。新しい未使用データや将来期間のデータを確保し、修正前後の条件も記録します。
修正後に性能が下がっても、それだけでモデルが悪化したとは判断できません。以前の評価が使えない情報に支えられていた可能性があるため、目標とする業務の条件で使えるかを改めて判断します。
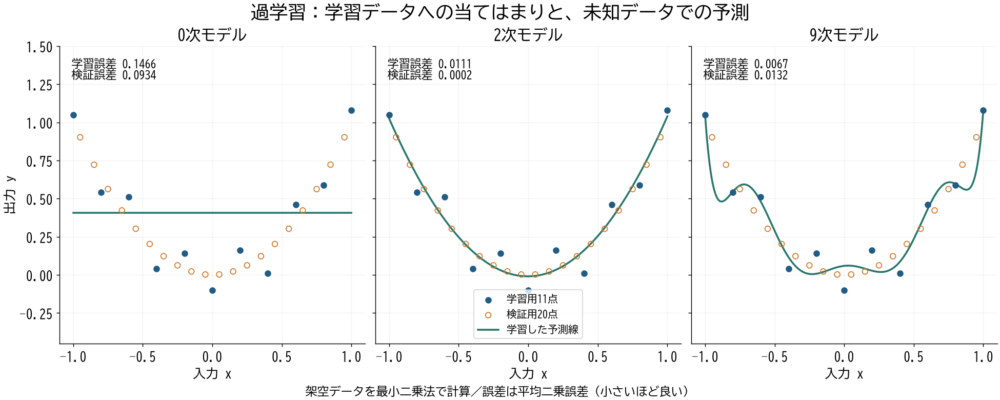
また、性能低下のすべてがリークで説明できるわけではありません。学習データへの適合が強すぎる問題は過学習の原因と対策、運用中にデータの傾向が変わる問題はデータドリフトの検知と対応で整理しています。LLMの追加学習でデータを用意する場合は、ファインチューニングのデータ設計も参照してください。
手元で最初に確認するなら、最も効いている特徴量の「作られた時点」と、最初のfitへ渡している「行の範囲」から始めてください。この2か所を追うと、入力の問題と評価手順の問題を分けて調べられます。
コメント