「演算性能が高いPC」と「大きなAIモデルを載せられるPC」は、別の条件で決まります。実際の待ち時間を考えるには、演算性能とメモリ容量に加え、データを運ぶ帯域幅やソフトウェアの処理も見る必要があります。AIのスペックは、一つの数字で順位を付ける前に、何を測った値かを分けて読むことが出発点です。
RTX Sparkの公式ページには、FP4で最大1 PetaflopのAI演算性能と、最大128GBのユニファイドメモリが掲載されています。本記事では、この二つの数値を入口に、FLOPS・容量・帯域幅・遅延の読み方を整理します。NVIDIA:RTX Spark
確認日は2026年9月19日です。図と計算例は一般原理の説明用であり、RTX Sparkの実測結果や性能予測ではありません。製品発表の全体像は、RTX Spark搭載PCとは?IFA 2026発表とローカルAIの仕組みを図解で紹介しています。
仕様表の四つの数字は、それぞれ違う問いに答える
| 指標 | 単位の例 | 答える問い | その数字だけでは分からないこと |
|---|---|---|---|
| 演算性能 | TFLOPS、PFLOPS | 条件が合う演算を毎秒どれだけ処理できるか | アプリ全体の待ち時間、生成速度 |
| メモリ容量 | GB、GiB | 同時にどれだけのデータを置けるか | 置いたデータを読む速さ |
| メモリ帯域幅 | GB/s | 特定の区間で毎秒どれだけデータを運べるか | 最初のデータが届くまでの遅延、他区間の速度 |
| 遅延 | ms、秒 | 一つの要求や処理が完了するまでどれだけ待つか | 多数の要求をまとめた総処理量 |
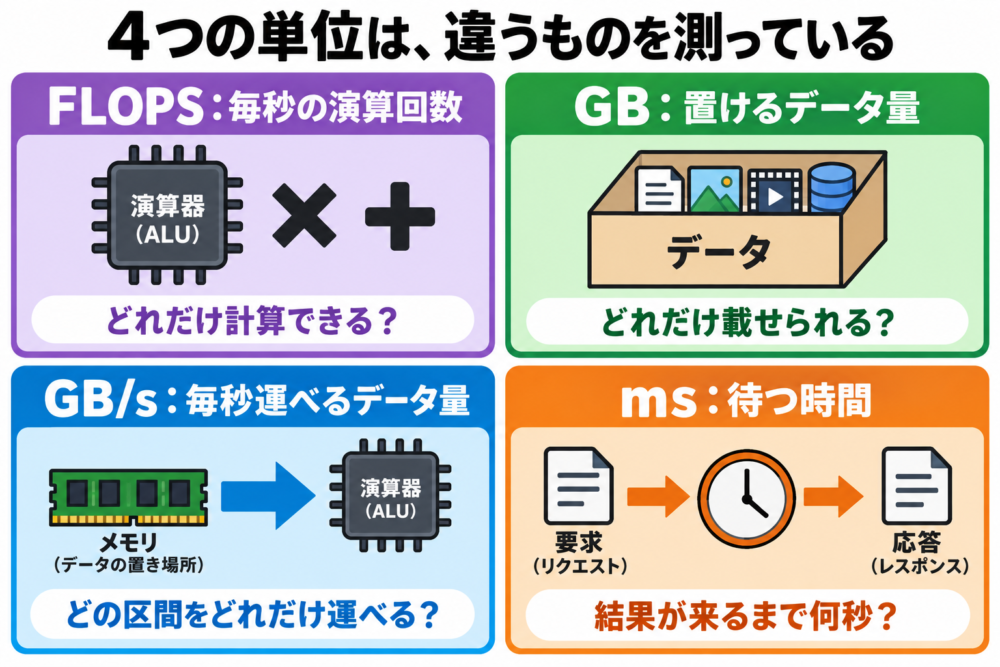
図:演算回数・置ける量・毎秒運べる量・待つ時間を別々に示す図。ALUは算術・論理演算器の略です。演算器のアイコンは概念を示し、FLOPSは浮動小数点演算の回数を数えます。
帯域幅は、まとまった量を運ぶ能力です。遅延は、要求を出してから応答が来るまでの時間です。同じ容量のメモリでも帯域幅は異なり、帯域幅が高くても小さな要求の待ち時間が同じ割合で短くなるとは限りません。
仕様の最大値は装置側の能力を示します。アプリがその能力をどこまで使えるかは、並列処理の量、データ配置、実装に依存します。Google Cloud:AIアクセラレータのパフォーマンスとベンチマーク
1 PFLOPSを読む前に、FP4という条件を見る
FLOPは演算量、FLOPSは毎秒の演算量
FLOPは浮動小数点演算の回数、FLOPSは毎秒の浮動小数点演算回数を表します。T(テラ)は10の12乗、P(ペタ)は10の15乗なので、1 PFLOPSは1,000 TFLOPSに相当します。
製品ページでは性能の表記に「1 Petaflop」が使われていますが、本記事では毎秒の性能値をFLOPSと表記します。数値を比べる際は、積和演算(掛け算して足す処理)の数え方も揃える必要があります。一般に乗算と加算は合わせて2演算と数えます。
TOPSは毎秒10の12乗回の演算を示す表記ですが、浮動小数点だけを意味する言葉ではありません。INT8(8bit整数)など何の演算を数えた値かを確認します。「100 TOPS」と「100 TFLOPS」は、演算の種類が不明なまま同じ性能として扱えません。
ビット数が少ないと、何が変わるか
FP4は、基本の値を4bitの浮動小数点形式で表現する方法です。FP16やFP32より少ないビット数で値を扱える一方、表現できる値の細かさや範囲に制約があります。実際の量子化形式では、値のまとまりごとのスケール(数値の大きさを調整する係数)なども使います。
したがって、4bitの重みを保存したモデルを使うことと、演算全体がFP4で動くことは同じではありません。対応する演算器やカーネル(GPUで並列処理を実行する関数)が必要で、別の精度で処理する部分もあります。NVIDIA:Introducing NVFP4
| 比較する条件 | 揃える理由 | 確認する記載 |
|---|---|---|
| FP4・FP16・FP32などの形式 | 一回の演算が扱う情報と対応経路が違う | 入力精度、累積精度 |
| 通常の演算器・Tensor Core | Tensor Coreは行列演算などをまとめて処理する演算器 | どの演算経路の性能か |
| Dense・Sparse | ゼロを省略する前提が演算量の扱いを変える | 疎性あり/なし |
| 最大値・実測値 | 最大能力とアプリが得た性能を分ける | 理論値、測定モデル、電力条件 |
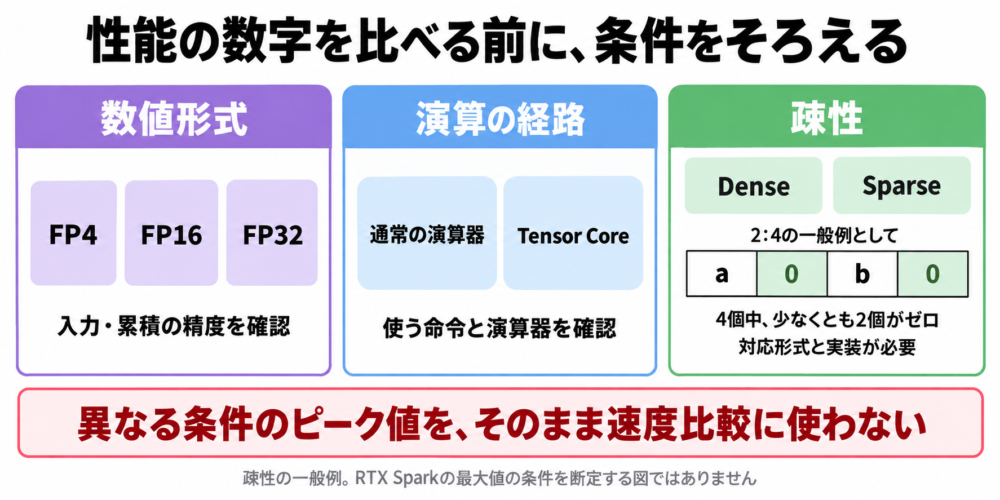
図:数値形式・演算経路・疎性の三条件を揃えて性能値を比較する図。
Sparseは疎性(値の多くがゼロになる性質)を利用する処理、Denseはその省略を前提としない処理です。NVIDIAの2:4構造化疎性は、4個の値のうち少なくとも2個がゼロという条件で演算を省く例です。対応する行列演算の理論スループット向上を、そのままアプリ全体の速度向上へ置き換えることはできません。NVIDIA:Structured Sparsity
今回確認したRTX Sparkの製品ページでは、FP4の最大値は読める一方、疎性を含む細かな条件までは確認できませんでした。DGX Sparkなど別製品の条件やメモリ帯域を補って、RTX Sparkの速度を計算することは避けます。
128GBは「載せられる量」の手掛かりになる
モデルのパラメーター(学習で決まる数値)の数をN、重み1個の保存ビット数をbとすると、重み本体の容量は、おおよそ「N×b÷8バイト」で計算できます。
例えば、32Bモデルを一律4bitで保存するという仮定を置きます。ここでモデル名のBはbillion(10億)なので、32Bは320億個です。
320億個×4bit÷8=160億バイト=16GB
この16GBは重みの数値本体だけの計算です。量子化のスケールや管理情報、異なる精度で保存する部分、配置時の余白は含みません。GBは10億バイト、GiBは2の30乗バイトであり、16GBは約14.9GiBです。単位を混ぜると必要容量の見積もりがずれます。
さらに、実行時には次の領域が必要になります。
| 使い道 | 何を置くか | 容量が変わる要因 |
|---|---|---|
| 重み | モデルのパラメーター | モデル規模、量子化形式 |
| KV Cache | 以前のトークンについて計算したKey・Value | モデル構造、文脈長、同時処理数、保存精度 |
| 作業領域 | 中間結果や演算用バッファー | 実装、入力形状、演算方式 |
| OS・他アプリ | システムや並行して動く処理 | 起動中のアプリ、予約領域 |
説明用に「重み16GB、KV Cache 6GB、作業領域4GB、OSなど8GB」と仮定すると、合計は34GBです。32GBの共有メモリでは、重み本体が16GBでも、この配分を同時には収められません。6・4・8GBは計算のための仮定で、特定モデルの測定値ではありません。
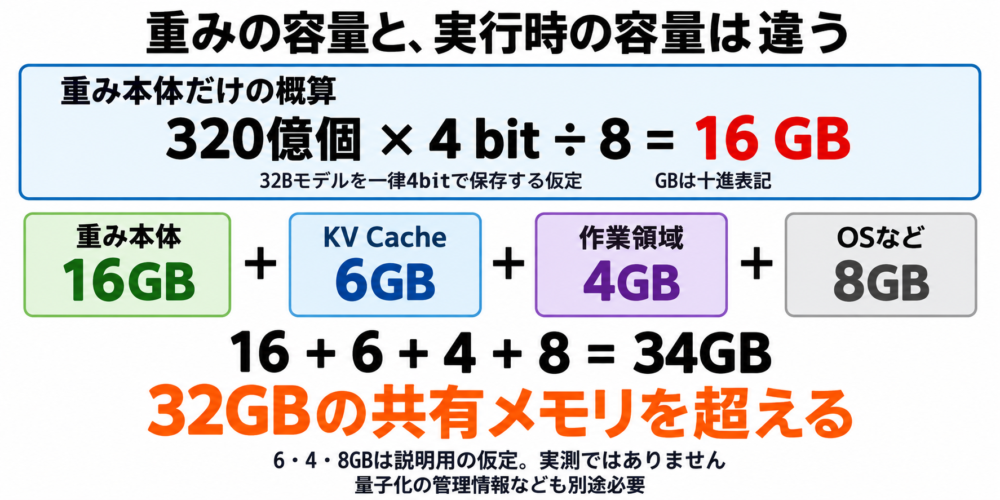
図:32Bの4bit重み本体16GBに作業領域などを足すと34GBになる仮定計算。
実際には領域の再利用やオフロード(別の記憶領域へデータを逃がすこと)もあり、単純な加算と異なる実装があります。容量不足を転送で補うと待ち時間が増える場合があるため、「動く」と「必要な速度で動く」を別に確かめます。NVIDIA:LLM推論の最適化
共有メモリの範囲はユニファイドメモリとは?CPU・GPUの共有とデータ転送を図解、保存形式の違いは量子化とは?LLMを軽くする省メモリ技術で詳しく説明しています。
帯域幅は「どこから、どこへ」の数値かを確認する
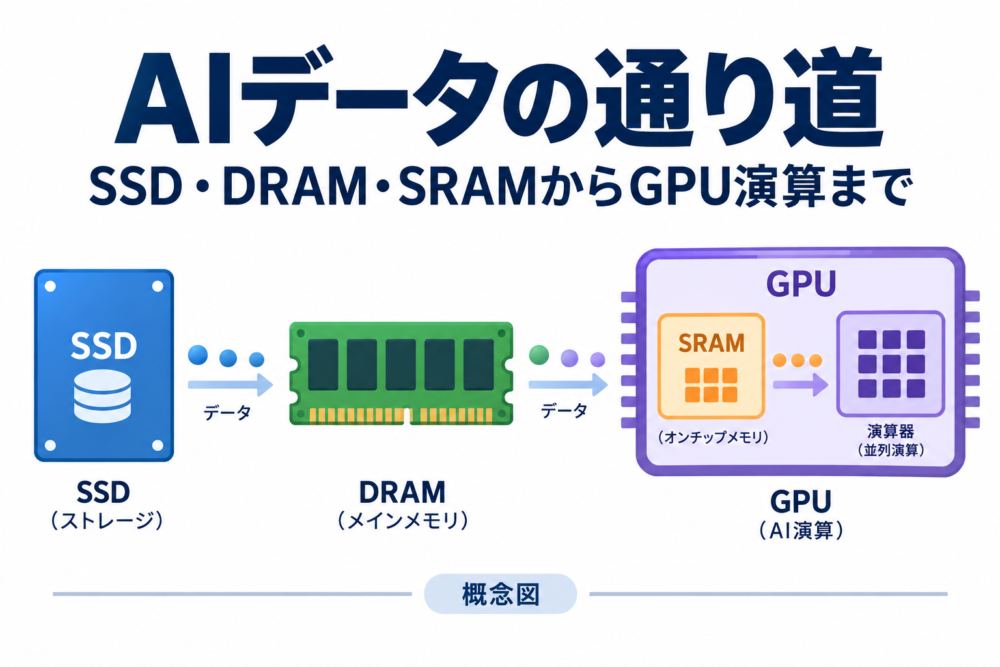
AIのデータは、SSD、CPU側メモリ、GPUが利用するDRAM(大容量の記憶領域に使うメモリ)、GPU内部の記憶領域を移動します。GPU内のキャッシュなどにはSRAM(演算器の近くで素早く読み書きする小さな記憶領域に使うメモリ)が使われます。
SSDからモデルを読み込む区間、CPU・GPU間でコピーする区間、DRAMからGPU内部へ値を供給する区間では、帯域幅が違います。仕様表にGB/sと書かれていても、別の区間の値を代入すれば、異なる処理の時間を計算してしまいます。
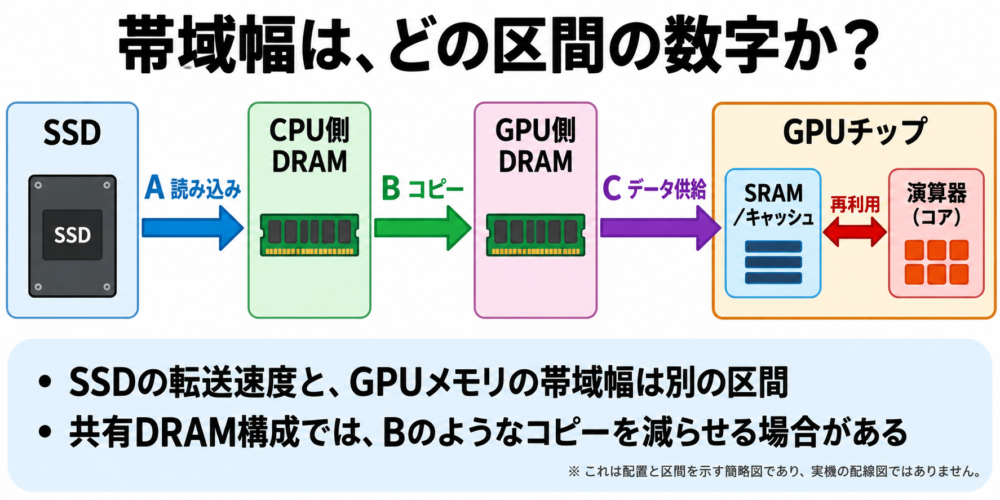
図:SSD読み込み・CPUとGPU間・DRAMとGPU内部で帯域の区間が異なる概念図。
CPU・GPUでDRAMを共有する構成なら、CPU側から別のGPU側DRAMへコピーする区間を減らせる場合があります。それでもDRAMからGPU内部への読み出しは残ります。また、キャッシュで再利用できれば、その区間を通るデータ量自体を減らせます。経路の詳細は、AIのデータはどこを通る?SSD・DRAM・SRAMからGPU演算までを参照してください。
8GBを200GB/sで運ぶと、何秒か
ある一つの区間で8GBを運び、200GB/sを維持できると仮定します。
転送時間=データ量÷帯域幅=8GB÷200GB/s=0.04秒=40ms
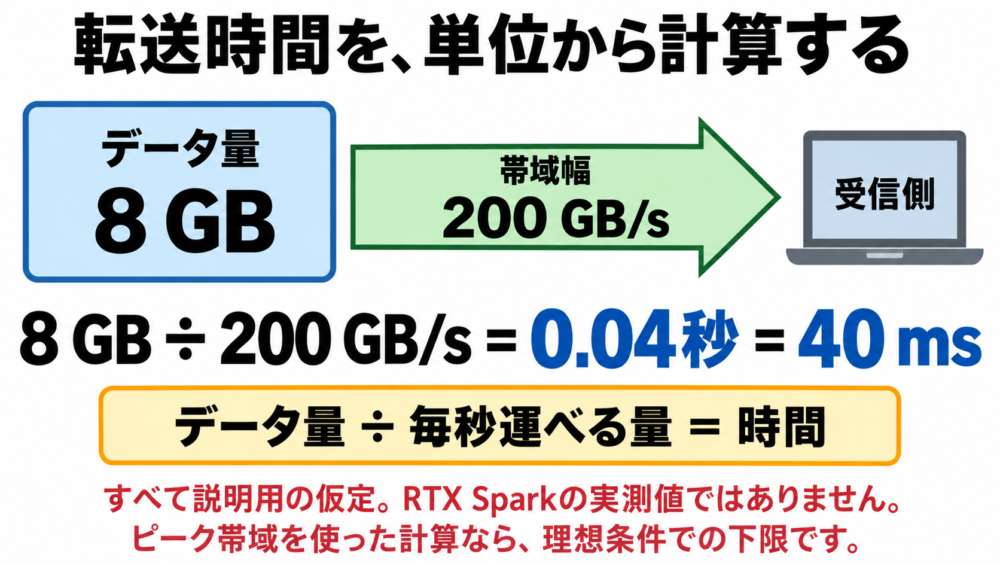
図:仮定の8GBを200GB/sで運ぶ時間を40msまで計算する図。
これはRTX Sparkの帯域を使った計算ではありません。一定の帯域を維持できる説明用の条件です。仕様上のピーク帯域を代入した場合は、少なくともこれだけかかるという理想的な下限の目安になります。
実際には要求の立ち上がり、読み書きの混在、アクセスの並び方、他の処理との競合などが影響します。小さな要求では、運ぶ量より要求ごとの遅延が目立つこともあります。Google Cloud:AIアクセラレータのパフォーマンスとベンチマーク
演算性能を2倍にしても、待ち時間が半分にならない例
ここからも仮定の計算です。ある処理に必要な演算量を2TFLOP、対応する演算性能を100TFLOPSとします。演算量と性能は、同じ精度と数え方を使います。
演算時間の下限=2TFLOP÷100TFLOPS=0.02秒=20ms
同じ処理が先ほどの8GBをDRAMとの間で移動させるなら、転送側の下限は40msです。演算と転送を理想的に重ねられるモデルでも、全体は長い方の40msより短くできません。
| 仮定する変更 | 演算側の下限 | 転送側の下限 | 理想モデルで長い方 |
|---|---|---|---|
| 元の条件 | 20ms | 40ms | 40ms |
| 演算性能だけ200TFLOPSへ | 10ms | 40ms | 40ms |
| 帯域幅だけ400GB/sへ | 20ms | 20ms | 20ms |
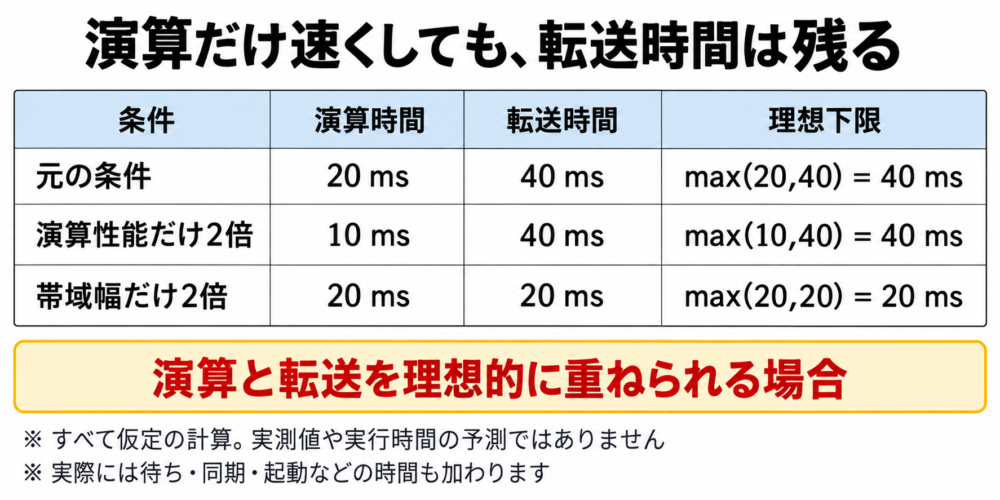
図:演算20ms・転送40msに対し、演算だけ10msへ短縮しても下限40msが残る説明図。
表の最後の列は実行時間の予測ではありません。重ね合わせが十分にできなければ時間は増え、起動や同期などの追加処理もあります。演算性能だけを上げても転送側の制約が残る、という考え方を示しています。
演算能力が主な制約になる状態を演算律速、メモリ帯域が主な制約になる状態を帯域律速と呼びます。処理が小さく並列性が足りない場合は、どちらのピークにも達しないまま遅延が支配することもあります。NVIDIA:GPU Performance Background
中級者向け:1バイトから何回計算できるか
演算量÷転送バイト数を演算強度と呼びます。先ほどの仮定では、2兆FLOP÷80億バイト=250 FLOP/byteです。一方、装置側の演算性能÷帯域幅は、100TFLOPS÷200GB/s=500 FLOP/byteです。
処理の演算強度250が装置側の比500を下回るので、十分な並列性がある単純モデルでは、演算器を使い切る前にデータ供給側が制約になります。近くのSRAMなどで再利用してDRAM転送量を減らせれば、演算強度を高められます。ここでも、転送量と帯域幅は同じメモリ階層の区間に揃えて計算します。
LLMでは「最初の返答」と「続きの生成」を分けて測る
LLM(大規模言語モデル)の処理は、入力をまとめて処理するPrefillと、続きのトークン(文章をモデルが扱う単位)を順に生成するDecodeに分けて考えられます。
Prefillは入力の複数トークンをまとめて処理でき、演算能力を使いやすい傾向があります。少数の要求を扱うDecodeでは、生成を進めるたびに重みやKV Cacheを参照するため、メモリ側の制約が目立ちやすくなります。入力長、モデル、バッチ数(まとめて処理する数)、実装によって傾向は変わります。
複数の要求をまとめれば重みの読み出しを複数の計算に使える一方、待ち行列や作業量が増え、一人の待ち時間に影響する場合があります。「全員で多く生成できる」と「一人にすぐ返せる」は、別々に測る必要があります。NVIDIA:LLM推論の最適化
| 観測する指標 | 意味 | 向いている確認 |
|---|---|---|
| TTFT | 要求送信から最初のトークンが届くまで | 最初の反応をどれだけ待つか |
| ITL | 続けて届くトークン間の時間 | 生成がどれだけ滑らかに進むか |
| 要求全体の遅延 | 送信から最後の出力が完了するまで | 一つの仕事の完了をどれだけ待つか |
| 出力トークンの総スループット | 観測区間で全要求が生成したトークン数÷時間 | 複数要求をどれだけさばけるか |
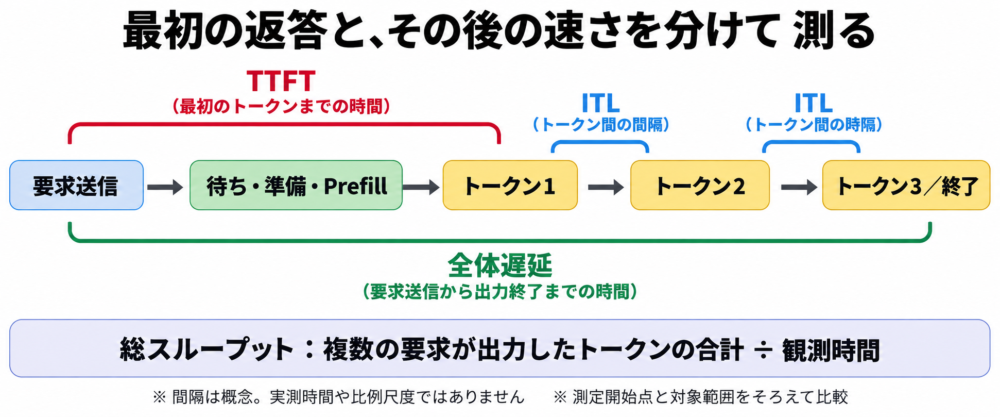
図:送信から最初のトークンまでのTTFTと後続トークン間のITLを示す概念時系列。
TTFTには、計測位置によって通信や待ち行列、入力準備なども含まれます。ITLの平均値と長く待った区間では印象も変わるため、平均に加え、p95(測定値の95%がその値以下になる境界)なども確認すると待ち時間のばらつきを捉えられます。
tokens/sという単位だけでは、一人の生成速度か、全要求を足した速度か、ロード時間を含むかが分かりません。トークンの区切り方が違うモデル同士では、同じトークン数でも同じ文章量とは限らない点にも注意します。NVIDIA:LLM Inference Benchmarking
処理段階そのものは、PrefillとDecodeの解説で詳しく扱っています。
用途に合わせて、比較する条件を決める
| やりたいこと | 優先して見るもの | 一緒に確認する制約 |
|---|---|---|
| 大きなモデルをローカルで動かす | 実行時に使える容量 | 重み以外の領域、品質、対応実装 |
| 長い文書を入力して早く返答を得る | 同じ入力長でのTTFT | 文脈長、キャッシュ利用、初回か2回目か |
| 一人で快適に対話する | TTFTとITL | 出力長、モデル、量子化、電力設定 |
| 複数の依頼をまとめて処理する | 総スループット | 同時処理数、待ち時間、必要メモリ |
| 長時間連続して使う | 継続時の速度と消費電力 | 冷却、電力制限、給電条件 |
比較結果を読むときは、モデル名と版、量子化形式、入力・出力長、同時処理数、使用ソフトと版、電力条件、計測に含む区間を揃えます。初回のロードを含む結果と、モデルを読み込み済みの結果を混ぜないことも必要です。
RTX Sparkの「最大1 PFLOPS」「最大128GB」は、対応する演算能力とデータを載せる余地を知る入口です。購入や構成の判断へ進む段階では、自分が使うモデルと処理条件に合った実測を確認すると、スペックの大きさと実際の使いやすさを結び付けられます。
コメント