データドリフトとは、AIモデルへ入力するデータの分布が、基準とするデータから変化することです。例えば、需要予測に使う製品の割合や気温の範囲が変わると、モデル自体を更新していなくても予測誤差が増える場合があります。
ただし、分布が変わったという警報だけでは、予測性能が低下したとは判断できません。逆に、入力の分布が同じでも、入力と正解の関係が変われば予測は外れます。検知をきっかけに、データ品質、変化した対象、実際の予測性能を順に確かめます。
この記事では、製品A・Bの需要予測という架空例で違いを計算し、監視する項目と検知後の対応を整理します。
データドリフトと概念ドリフトは、変わる対象が違う
AIが予測に使う入力項目を特徴量と呼びます。需要予測なら、製品の種類や曜日などが特徴量、実際の需要が正解に当たります。分布とは、それぞれの値がどのくらいの割合で現れるかという傾向です。
本記事では、入力特徴量の分布の変化をデータドリフト、入力と正解の関係の変化を概念ドリフト(コンセプトドリフト)と呼びます。Evidentlyの解説も、この二つを分けています。両方が同時に起きる場合もあります。
| 確認する変化 | 何が変わるか | 需要予測での例 |
|---|---|---|
| データドリフト | 入力の値や構成比 | 製品A中心だった予測対象が、製品B中心になる |
| 概念ドリフト | 同じ入力に対する正解の傾向 | 製品Bという入力は同じでも、実際の需要が増える |
| 予測ドリフト | モデルが出す予測値の分布 | 予測数量の大きな値が以前より多くなる |
| データ品質の異常 | 欠損・型・単位・収集処理など | 個数の列に箱数が入る、特定の製品だけ記録されない |
データドリフトのうち、入力の分布だけが変わり、入力と正解の関係は保たれる状況を共変量シフトと呼びます。入力が変わったことだけを見て、正解との関係も保たれていると決めつけないようにします。
「いつの、何と比べた変化か」を明記する
資料や製品によって、ドリフトという語の範囲は異なります。Google CloudのModel monitoring overviewでは、学習データと本番データの違いをskew、本番の異なる期間の違いをdriftとして整理しています。
名前だけでなく、学習時との比較なのか、先月と今月の比較なのかを明記すると、調べたい問題がはっきりします。本記事の数値例は、運用中の基準期間と比較期間を比べます。
製品の割合が変わるだけで、全体の誤差は増える
ここからの数値は、仕組みを説明するために設定した架空例です。実在する工場やAIの測定結果ではありません。
モデルの入力は製品A・Bの種類だけとし、1件を「ある製品の、ある1日の需要予測」とします。説明を単純にするため、モデルはどちらの製品にも100個と予測し、正解はAなら102個、Bなら110個で一定とします。モデルは二つの期間で変更しません。
| 製品 | モデルの予測 | 実際の需要 | 1件の絶対誤差 | 基準期間の件数 | 比較期間の件数 |
|---|---|---|---|---|---|
| A | 100個 | 102個 | 2個 | 80件 | 20件 |
| B | 100個 | 110個 | 10個 | 20件 | 80件 |
| 合計 | — | — | — | 100件 | 100件 |
絶対誤差は、予測と正解の差を正の大きさで表したものです。これを全件で平均したMAE(平均絶対誤差)で評価します。scikit-learnの公式資料でも、正解と予測を比較する回帰の評価指標として説明されています。
基準期間のMAE = (80 × 2 + 20 × 10) ÷ 100 = 3.6個
比較期間のMAE = (20 × 2 + 80 × 10) ÷ 100 = 8.4個
製品別の誤差は2個と10個のままです。それでも、誤差が大きいBの割合が20%から80%へ増えたことで、全体のMAEは3.6個から8.4個へ増えました。この例では、入力の構成比だけを変え、製品と正解の関係は固定しています。
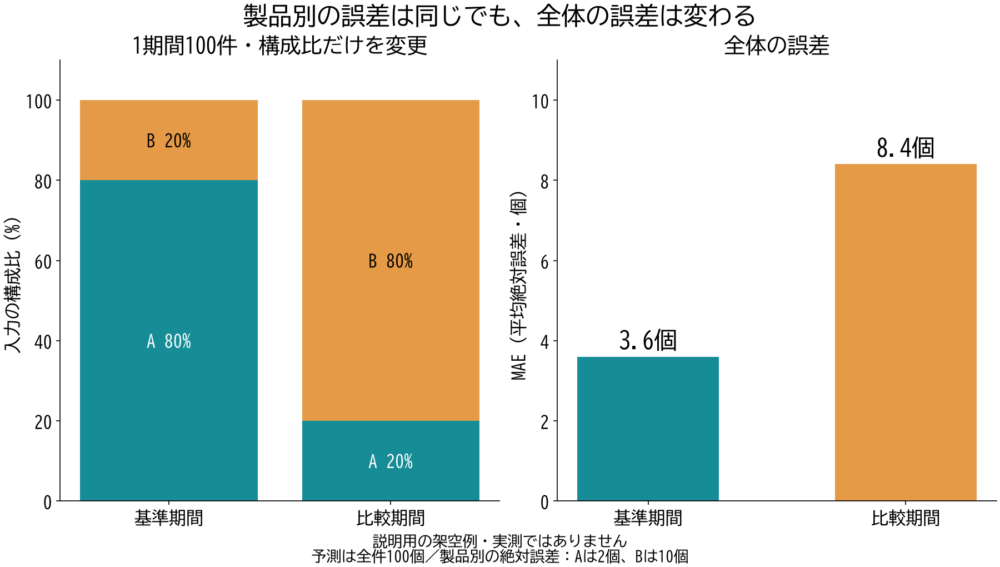
説明用に設定した架空例です。実測データではありません。
分布の変化量だけで、性能への影響は決まらない
仮に、AもBも1件あたりの絶対誤差が2個のモデルだったら、同じ構成比の変化でも全体のMAEは2個のままです。入力の変化が同じでも、そのモデルが各製品でどの程度外れるかによって結果は違います。
全体の指標だけでなく、製品別・店舗別などの内訳も残すと、どの対象の増減が結果に関わったかを確認できます。これは、拠点ごとのデータの偏りを扱う連合学習の記事にもつながる考え方です。拠点間の違いと、同じ拠点の時間的な変化は分けて記録します。
入力が同じでも、正解との関係が変われば外れる
別の変化を、先ほどの基準期間から考えます。今回は製品の件数をA80件・B20件に固定し、Bの正解だけを110個から130個に変えます。入力に使う製品の種類と、モデルの予測100個は変えません。
| 確認項目 | 基準期間 | この比較期間 |
|---|---|---|
| 入力の構成比 | A80%・B20% | A80%・B20% |
| モデルの予測 | 全件100個 | 全件100個 |
| Aの正解 | 102個 | 102個 |
| Bの正解 | 110個 | 130個 |
| 全体のMAE | 3.6個 | 7.6個 |
比較期間のMAE = (80 × 2 + 20 × 30) ÷ 100 = 7.6個
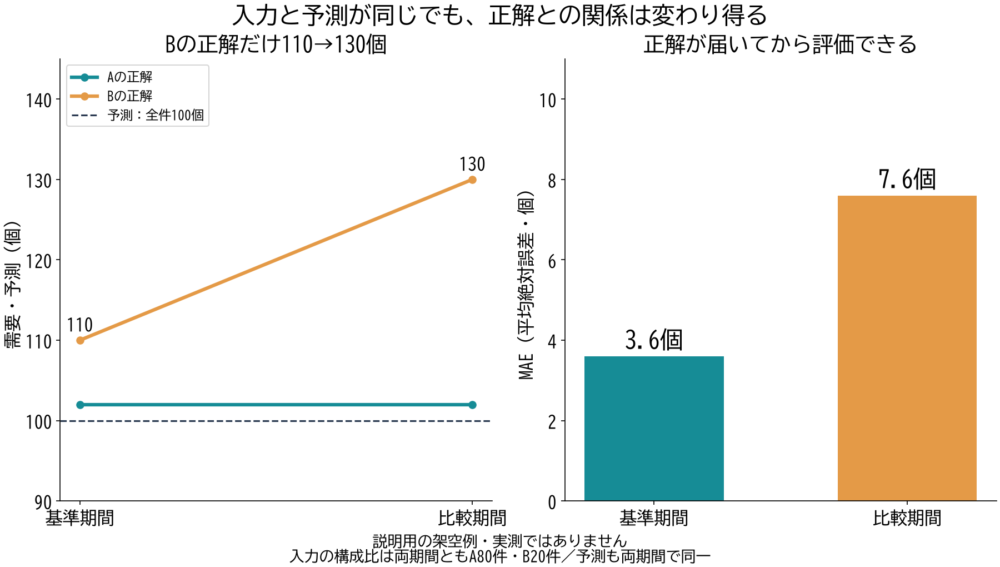
説明用に設定した架空例です。実測データではありません。
この例では、入力分布も予測値の分布も同じです。それらだけを比較しても、Bの需要が変わったことは分かりません。正解が得られて初めて、入力と正解の関係の変化を確かめられます。
実際には、入力に含めていない事情が変わっている可能性もあります。「監視している入力に変化がない」ことを、「予測に関わる状況が何も変わっていない」と広げないようにします。
監視する項目を、品質・分布・性能に分ける
監視は、一つのドリフト指標にまとめるより、答えたい問いに合わせて分けると調べやすくなります。
| 監視対象 | 答えたい問い | 確認する例 | それだけでは分からないこと |
|---|---|---|---|
| データ品質 | 正しい形式と意味で届いているか | 欠損率、型、単位、値の範囲、記録件数 | 正常な値の構成比が変わった影響 |
| 入力・予測の分布 | 以前と違う値や割合になったか | 製品構成比、ヒストグラム、分布の比較指標 | 予測が実際に当たったか |
| 予測性能 | 正解に対してどれくらい外れたか | MAE、正解率、再現率など | 低下を引き起こした原因 |
TensorFlow Data Validationの公式資料も、データの形式・条件への適合を調べる機能と、データセット間の統計量を比較する機能を分けています。
欠損の扱いも確認が必要です。例えば、Evidentlyのドリフト検知では、欠損値などを除いて分布を比較するため、欠損率の増加を別に検査するよう説明しています。値が届かなくなったのに、残った値の分布だけを見て安心するのを避けるためです。
先に基準期間と対象をそろえる
基準を学習データにするか、過去の本番データにするかで、確認できる問題が変わります。
| 基準の選び方 | 向く問い | トレードオフ |
|---|---|---|
| 学習データ | 学習時に見た範囲と本番が違うか | 学習用の抽出や偏りを考慮する必要がある |
| 固定した過去の本番期間 | 導入後、元の運用からどれだけ変わったか | 季節や対象業務の変更で基準が古くなる |
| 直近の本番期間 | 最近、急な変化があったか | 徐々に積み重なる変化を見落とす可能性がある |
本記事では、期間だけでなく曜日構成、対象製品、前処理の版もそろえて記録することを勧めます。例えば、平日だけの基準と休日中心の比較期間では、想定どおりの差でも警報になり得ます。業務上の変化として記録したうえで、同じ条件同士でも比べると解釈しやすくなります。
KS検定やPSIは、用途と前提を確認して選ぶ
| 方法 | 比較するもの・役割 | 確認したい条件 |
|---|---|---|
| 件数・カテゴリ構成比 | A・Bの割合、新しいカテゴリの出現 | 分母、カテゴリのまとめ方、欠損の扱い |
| KS検定(コルモゴロフ–スミルノフ検定) | 数値の2標本が同じ連続分布から来たと考えられるか | 標本の独立性、データ型、件数 |
| PSI(Population Stability Index) | 区間・カテゴリごとの構成比のずれを要約 | 区間の切り方、ゼロ件の扱い、採用実装 |
| MAEなどの性能指標 | 予測と正解の差 | 正解の確定時点、集計単位、対象別の内訳 |
SciPyのKS検定の説明は、独立な2標本の連続分布を前提としています。時系列の連続した観測やカテゴリ値へ、前提を確認せずそのまま適用しないようにします。PSIは分布差の指標であり、KS検定のp値と同じ意味ではありません。p値は、同じ分布という仮定の下で、観測した以上に極端な差が得られる確率です。
検知手法には、値が大きいと警報にする距離指標と、値が小さいと統計的な差の証拠とみなすp値などがあります。Evidentlyの公式説明でも、列の種類や件数に応じて手法を選ぶ構成になっています。異なる指標の数字を同じしきい値で比較せず、その値が何を表すかを確認します。
しきい値は、過去の正常な変動と問題が起きた期間を比べ、見逃しと不要な警報の両方を評価して決めます。小さな差でも大量のデータでは検出されやすくなるため、統計的な差に加えて、変化の大きさと業務への影響を見る必要があります。
また、列ごとの分布が変わらなくても、列同士の関係が変わる場合があります。単独の列に対する検査だけで、あらゆる変化を検出したとは扱いません。
正解が遅れて届く場合は、予測時の記録と結び付ける
翌日の需要を予測した時点では、その日の実際の需要はまだ分かりません。この間は入力・予測の分布やデータ品質を先に確認し、正解が確定した後で予測性能を追って評価します。
AWSのモデル品質監視の説明でも、保存した予測と実際の正解ラベルを突合して品質を測ります。ここでは、その考え方を製品に依存しない記録項目として整理します。
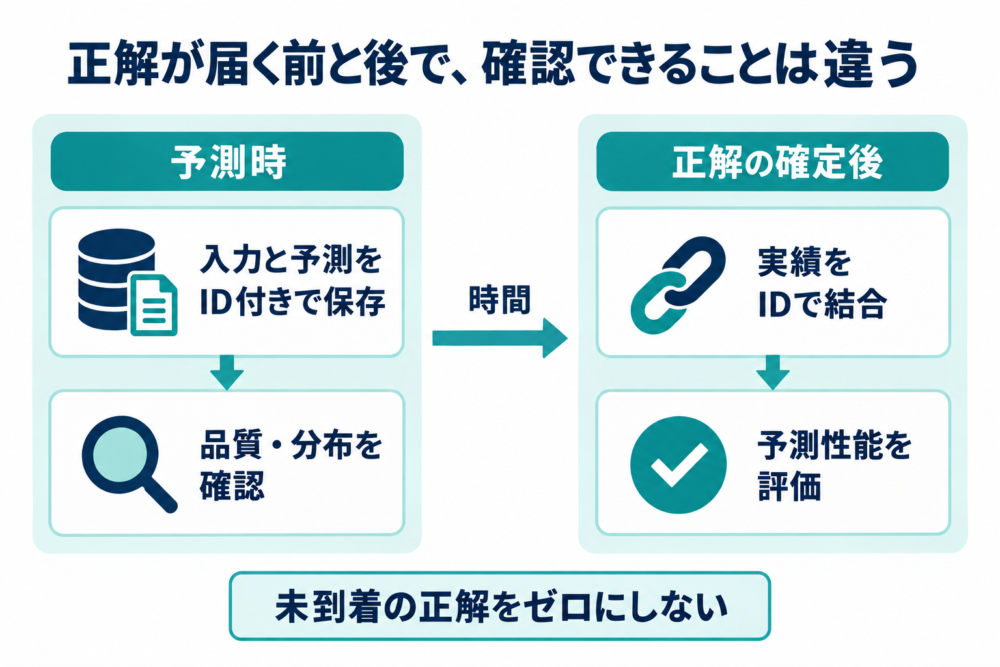
本文の確認手順を整理した模式図です。
| 予測時に残す項目 | 正解が届いた後に使う目的 |
|---|---|
| 予測を識別するIDと対象日時 | 正しい需要実績へ結び付ける |
| 入力値、製品・店舗などの分類 | 変化した対象や誤差の内訳を調べる |
| モデルと前処理の版 | 入力変化とシステム変更を混同しない |
| 予測値と、必要なら意思決定の結果 | 誤差と実際の運用影響を比べる |
| 正解の確定時点・未確定状態 | 未到着の値をゼロや正常と扱わない |
正解が届いている一部の対象だけで測った性能を、まだ正解のない全対象へ広げないことも必要です。評価対象になった件数と、未確定の件数を一緒に残します。
検知後は、再学習の前に原因と影響範囲を調べる
例えば、製品Bの記録だけが抜けてAの割合が増えたなら、直す対象は収集処理です。その欠落を含むデータで再学習すると、問題のある状態をモデルへ取り込むおそれがあります。Evidentlyの対応ガイドも、データ品質の確認を最初に置いています。
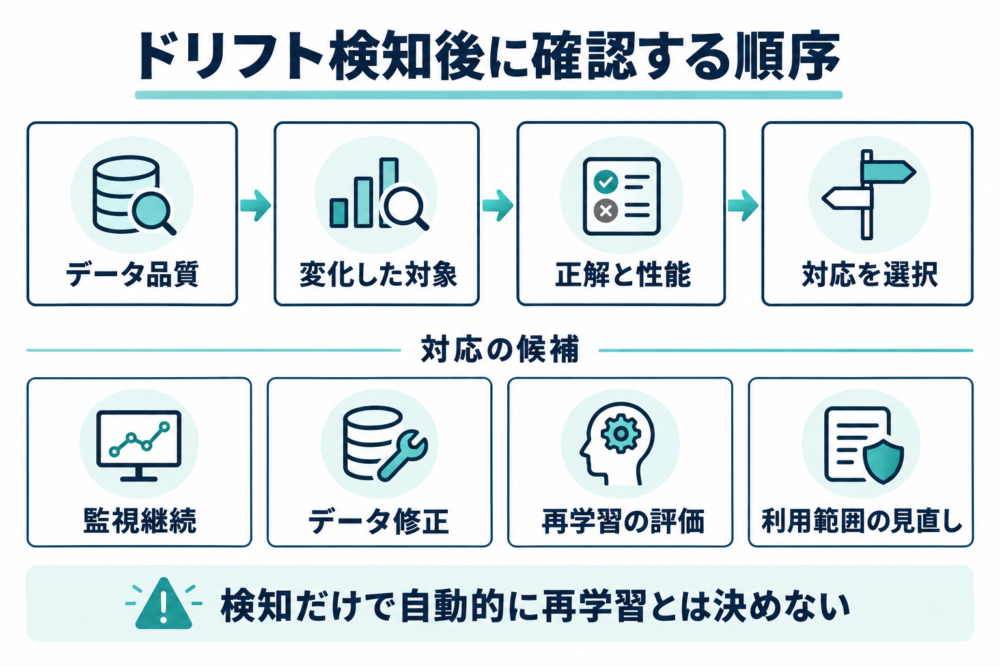
本文の確認手順を整理した模式図です。
本記事では、状況ごとの対応を次のように整理します。
| 確認できた状況 | 次に調べること・対応候補 |
|---|---|
| 分布の変化とデータ品質異常がある | 収集・単位・前処理を修正し、再集計する |
| 分布は変わったが性能は許容範囲 | 変化の理由と対象を記録し、監視を継続する |
| 分布の変化に加えて性能も低下した | 対象別の誤差を確認し、再学習や利用範囲の見直しを評価する |
| 分布の警報はないが性能が低下した | 正解との関係、未監視の入力、モデル・前処理の変更などを調べる |
| 正解がなく性能は未確認 | 未確認のまま記録し、業務リスクに応じて人の確認や利用制限を検討する |
入力の寄与を調べる説明手法も補助にはなります。ただし、説明の変化だけで原因が証明されたとはいえません。説明可能AIの記事で扱ったように、モデルの説明と、現実の因果関係・予測性能は分けて確認します。
再学習を選ぶ場合は、更新用データとは別の評価データで旧モデルと新モデルを比べます。全体だけでなく影響を受けた製品や店舗も確認し、切り替え後に戻せるモデルと設定を残します。どのデータで、どの範囲の誤差が許容できたかを記録すると、次の変化が起きたときにも判断を引き継げます。
コメント