合成データとは、現実の観測や記録から直接集める代わりに、ルール・統計モデル・シミュレーション・生成AIなどで人工的に作るデータです。AIの学習例を補ったり、実データを使いにくい環境でソフトウェアを試したりする用途があります。ただし、作れた件数だけでは有用性を判断できず、現実との一致、目的に対する性能、プライバシーをそれぞれ確認する必要があります。
この記事では、表・画像・テキストの違いを整理し、架空の検品画像と小さな表を使って、何を生成し、何を実データで確かめるかを説明します。掲載図は生成AIを用いて本記事用に作成した概念図です。
合成データとは
英語ではSynthetic Dataと呼びます。たとえば、仮想空間に置いた部品を照明やカメラの角度を変えて描画した画像、統計的な傾向を基に作った架空の注文レコード、言語モデルが生成した質問と回答の組などが該当します。
NVIDIAは、シミュレーションや生成AIを使った画像・動画・テキストなどの生成を合成データ生成として説明しています。用途は画像だけに限られません。NVIDIA「Synthetic Data Generation」
人工的に作る場合も、実データと無関係とは限りません。実データから傾向を学習して生成する方法もあれば、設計したルールや仮想環境から生成する方法もあります。元になる情報や設定に偏りがあれば、その影響が生成結果へ残る可能性があります。
また、全項目を生成する方法と、一部の項目だけを生成値へ置き換える方法があります。AWSの解説でも完全合成と部分合成を区別しています。「合成データを使っている」と聞いたら、どの項目を、何を基に生成したのかまで確認すると、用途と制約が見えてきます。AWS「合成データとは」
実データ・加工したデータとの違い
合成データと混同しやすいのが、実データを変換して使う方法です。呼び方が重なる場合もありますが、ここでは元の記録との関係で整理します。
| 方法 | 元の記録との関係 | 使いやすい場面 | 確認すること |
|---|---|---|---|
| 実データの収集 | 実際の出来事を観測・記録する | 現場の状態を把握する、最終評価に使う | 収集範囲の偏り、誤記、利用条件 |
| データ拡張 | 既存の例を回転・切り抜きなどで変換する | 画像の向きなど、変化へ対応させる | 変換後も正解が変わらないか |
| マスク・置換などの加工 | 元の行や項目を残しながら変える | 不要な識別情報を隠して扱う | 残った情報や組み合わせから識別されないか |
| 合成データの生成 | ルールや学習した傾向などから例を作る | 不足条件の補完、テスト用データの作成 | 必要な関係や条件を再現できているか |
これは用途を考えるための整理です。たとえば生成モデルで画像の一部を変える方法は、データ拡張とも合成とも呼べます。名前だけで区別するより、何を変え、どの性質を残したいかを明確にします。
実データは現実に起きた記録ですが、それだけで正確・代表的とは限りません。反対に、合成データは狙った条件を作りやすい一方、その条件が現場を適切に表しているかの検証が必要です。
表・画像・テキストでは作り方と用途が違う
合成データの生成方法は、対象の形式と目的に合わせて選びます。次の表は代表的な組み合わせであり、一つの形式に一つの方法しか使えないわけではありません。
| 形式 | 作り方の例 | 用途の例 | 生成後に確かめること |
|---|---|---|---|
| 表形式 | 統計モデル、ルール、生成モデルで行を作る | 注文データの機能テスト、予測モデルの学習補助 | 値の範囲、列どうしの関係、存在しない組み合わせ |
| 画像・動画 | 3Dシミュレーションや画像生成モデルで作る | 部品検品、物体認識の学習例を補う | 反射・影・傷の見え方、正解ラベルとの一致 |
| テキスト | 言語モデルで質問・回答・分類例を作る | 問い合わせ分類、指示に応じるモデルの学習 | 事実性、指示と回答の対応、重複、文体や話題の偏り |
表形式では、「入力欄や画面が動くか」を試すデータと、「実際の傾向を学ぶ」データで必要な品質が違います。形式と値の範囲が正しければ足りるテストもありますが、需要予測の学習に使うなら、季節や商品と数量の関係なども重要になります。
画像を仮想環境から作る場合は、物体の位置などの設定から、ラベル(正解として付ける情報)を同時に作れる構成があります。ただし、生成した画像すべてに正しいラベルが自動で付くわけではありません。何が写っているかと、ラベルの対象が一致しているかを確認します。
テキストでも、AIが生成した回答をそのまま正解とは扱いません。WangらのSelf-Instructは、指示・入力・回答を生成した後、不適切な例や類似した例を除外して学習へ使う流れを提案しています。指示データの設計や品質管理の詳細は、指示チューニングの記事で説明しています。
具体例:検品画像で増やす条件、現場で確かめる条件
ここでは、金属部品の傷を見つけるAIを考えます。以下は仕組みを説明するための架空例で、実際の工場やモデルを検証した結果ではありません。
正常品の写真は集めやすくても、珍しい位置や形の傷は十分に集まらないかもしれません。そこで、仮想の部品に傷を設定し、撮影条件を変えて画像を生成する案が考えられます。NVIDIAも、検品用の合成画像では角度・位置・照明などを変えて学習データを作る例を挙げています。NVIDIA「Synthetic Data Generation」
| 合成側で変える条件 | 増やしたい学習例 | 現場の実データで確かめること |
|---|---|---|
| 傷の位置・向き・大きさ | 見慣れない場所の傷 | 実際の微細な傷や加工跡を見分けられるか |
| 光の方向・明るさ | 明暗が異なる画像 | 金属の反射で傷が隠れる場合に対応できるか |
| カメラと部品の角度 | 斜めから見た部品 | 実機のレンズや取り付け位置の影響がないか |
| 背景や表面の状態 | 撮影条件が異なる画像 | 汚れ・ぶれ・正常な模様を傷と誤認しないか |
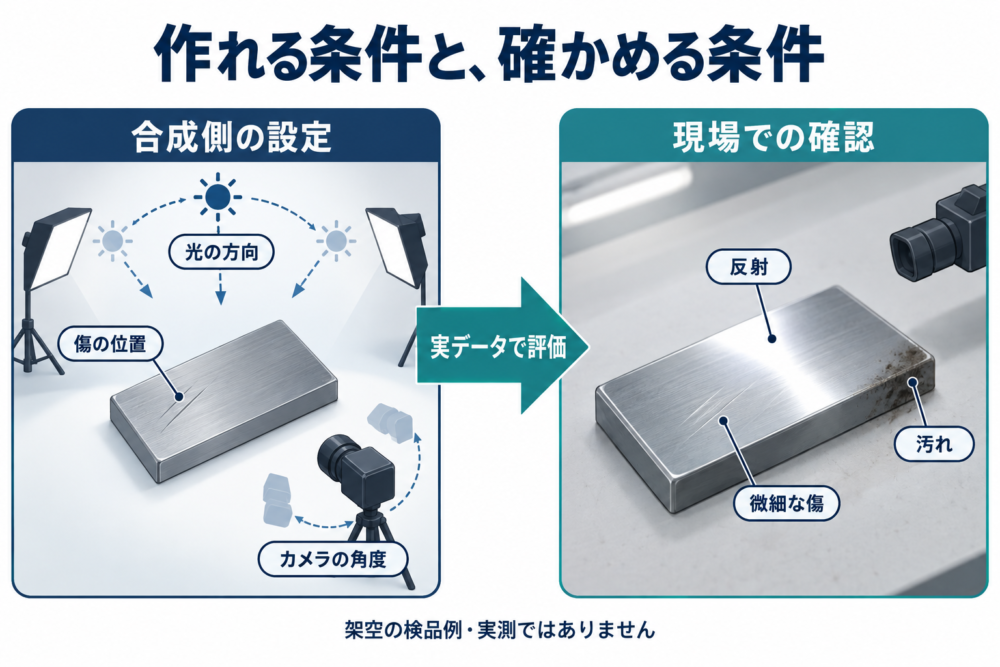
*架空の検品例を基に独自作成。実際の部品写真やモデルの性能検証ではありません。*
合成側の設定が豊富でも、現実の条件を含んでいるとは限りません。たとえば、すべての傷が濃い線でくっきり見えるように生成されていれば、反射で目立たなくなる実際の傷への対応は別途確認が必要です。
また、「傷あり」の合成画像だけが暗く、正常品がすべて明るい構成では、傷以外の明るさが判定の手掛かりになり得ます。正常品と傷ありの両方に複数の照明条件を含め、現場の画像でも誤検出と見逃しを分けて評価する、という設計が考えられます。これは本記事での設計提案です。
品質は見た目・統計・用途を分けて確認する
画像が自然に見えたり、表の平均値が近かったりしても、それだけでは目的の学習に役立つと判断できません。確認する対象を分けると、不足が見つけやすくなります。
| 確認する観点 | 問い | 例 |
|---|---|---|
| 形式と内容の整合性 | データとして成立しているか | 数量が負になっていないか、回答が質問に対応するか |
| 分布と関係性 | 必要な傾向を残しているか | 値の出現頻度、数量と金額の関係 |
| 用途に対する性能 | 本来の課題で役立つか | 実物の検品画像で傷を検出できるか |
| プライバシー | 元データの情報を不適切に残していないか | 元の記録への過度な類似、情報推測のリスク |
平均値が同じでも、関係は逆になる
次は数量と金額の関係を説明するために筆者が作成した架空の4行です。「元の傾向を表す例」と「関係を崩した例」を並べています。実データでも、生成ツールの出力でもありません。
| 数量 | 元の傾向を表す金額 | 関係を崩した金額 |
|---|---|---|
| 1 | 100 | 400 |
| 2 | 200 | 300 |
| 3 | 300 | 200 |
| 4 | 400 | 100 |
数量の平均は(1+2+3+4)÷4=2.5です。金額の平均はどちらも(100+200+300+400)÷4=250で、金額として登場する値も同じです。
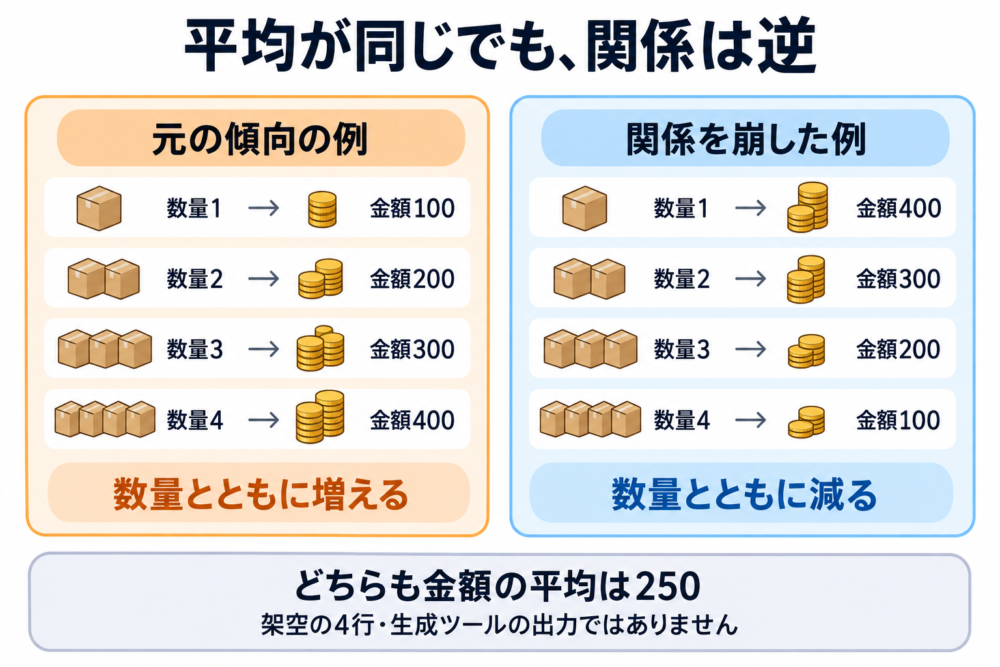
*本文の架空4行を図示。実データや生成ツールの出力ではありません。*
それでも、左の金額は数量が増えるほど高くなり、右は数量が増えるほど低くなります。各列を別々に確認するだけでは、列どうしの関係が変わったことを見落とします。
表形式データの評価ツールであるSDMetricsも、各列の分布を扱うColumn Shapesと、列の組み合わせを扱うColumn Pair Trendsを区別しています。この例は、その違いを小さな表で説明したものです。SDMetrics公式リポジトリ
ただし、二つの列の関係が似ていても、用途に必要なすべての性質が一致したとは限りません。学習に使うなら、次に実際の課題で性能を確認します。
AI学習では、未使用の実データで比較する
合成データを加える効果を調べるときは、比較の基準を用意します。まず実データだけで学習した構成を作り、合成データを追加した構成と、同じ実データの評価集合で比べる方法が考えられます。
その際、最終評価用の実データは、合成データを作る前に分けておきます。 評価用の記録を生成器の学習や生成指示へ入れると、生成物を経由して評価用の情報が学習側へ流れ込むためです。
これはデータ漏洩(評価用の情報が学習や設定選びへ混ざること)を防ぐ考え方です。scikit-learnの公式ガイドも、分割を先に行い、評価用データでモデルの選択や学習をしないよう説明しています。scikit-learn「Common pitfalls」
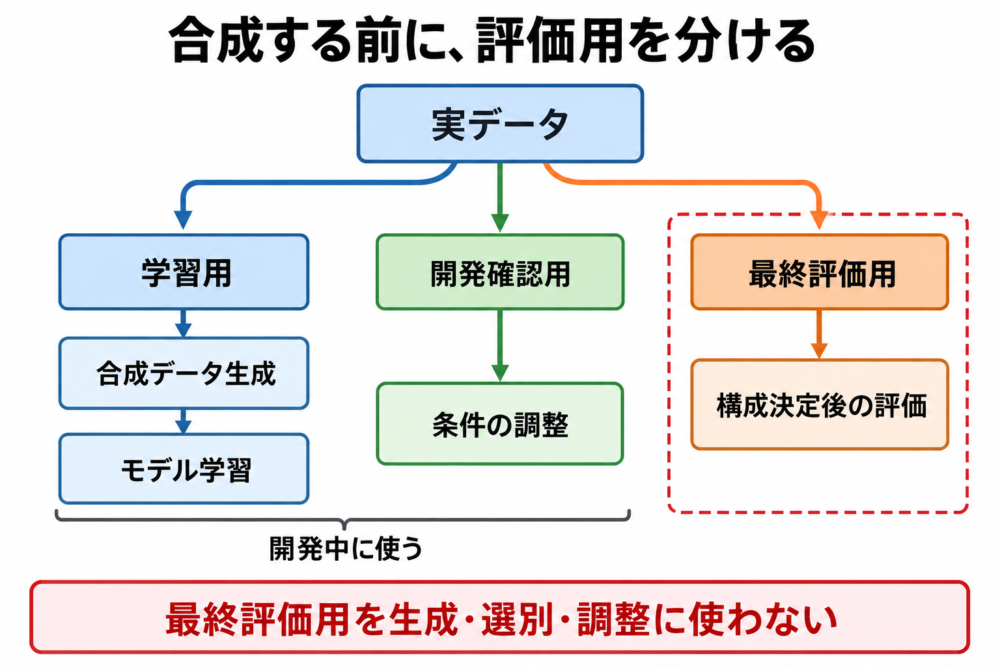
*データ漏洩防止の原則を基に、役割の分離を独自に整理。最終評価は構成を決めてから行います。*
本記事では、次のように役割を分ける進め方を提案します。
- 実データを学習用・開発確認用・最終評価用に分ける。 同じ部品の連続画像など、似た記録が双方へ混ざらない分割単位を選びます。
- 学習用の情報から合成データを作る。 生成条件、元データの範囲、除外した例を記録します。
- 実データのみの構成と、合成データを加えた構成を比較する。 比較に使う開発確認用データを共通にし、モデルや学習回数などの条件をそろえます。データ追加で計算量も変わる場合は、その差も記録します。
- 開発確認用の結果で、混ぜ方や生成条件を調整する。 全体の成績だけでなく、傷の種類や照明条件などの内訳も確認します。
- 構成を決めた後、隔離した最終評価用データで確認する。 その結果を繰り返し見て調整すると、最終評価用としての独立性は失われます。
合成データを何割混ぜればよいかは、目的やデータによって異なります。増やすほどよいとは決めず、比較した条件と結果を残します。評価に必要な実データがない場合は、合成環境での結果を実環境の性能として扱わず、まず検証可能な範囲を明確にします。
合成データでもプライバシーの確認は必要
個人の実データをそのまま配らずに済む点は、合成データを検討する理由の一つです。ただし、人工的に生成したという事実だけで、元データの情報が守られるとは限りません。
NISTは、多くの合成データ生成手法が差分プライバシーを満たさず、同じ数学的な保護保証を持たないことを説明しています。差分プライバシーは、個人のデータが含まれるかどうかによる出力の変化を一定範囲に抑える考え方です。採用する場合も、設定や実装を含めて保証の内容を確認します。NIST「Differentially Private Synthetic Data」
元の行をコピーしていないかの確認は一つの観点ですが、一致する行がないだけで安全と結論付けることもできません。利用目的、生成に使う情報、外部へ渡す範囲に応じて評価します。
特に外部の生成サービスへ元データを入力する場合は、生成後のデータだけでなく、生成前の送信が許されるかも確認します。元データ、生成モデル、利用する素材の条件を整理し、「合成したから利用条件もなくなる」とは考えないようにします。
導入前に決める5つのこと
目的を一つに絞ると、必要な品質と作業範囲を決めやすくなります。以下は導入計画に残す項目の例です。
| 決めること | 記録する内容 |
|---|---|
| 何が不足しているか | 全体の件数か、特定の条件か、利用できる環境か |
| 何に使うか | 画面の動作テスト、AI学習の補助、分析など |
| 何を再現するか | 形式、値の範囲、項目間の関係、撮影条件など |
| 何で評価するか | 未使用の実データ、確認する指標、許容できない失敗 |
| 何を保存・共有するか | 元データの範囲、生成条件、版、利用条件、共有先 |
たとえば「画像を増やす」から一歩進めて、「暗い環境での正常品と傷ありの例が不足している」と記録できれば、生成すべき条件と確認すべき実画像が対応します。効果が見えない場合も、データ数を増やす前に、どの条件が再現できていないかを見直せます。
よくある疑問
合成データは生成AIでしか作れない?
ルール、統計モデル、シミュレーションからも作れます。使い慣れた生成AIがあるかより、作りたいデータの性質と評価方法に合うかで選びます。
大量に作ればデータ不足は解決する?
件数が増えても、元の少数例と似たパターンばかりなら、不足している条件は埋まりません。生成した件数と、現実について新しく観測できた情報は分けて考えます。
実データをすべて置き換えられる?
ソフトウェアの動作確認など、目的によって合成データが使いやすい場面はあります。一方、現場で使うAIの性能を知りたいなら、現実の条件を代表するデータでの確認が必要です。生成したテキストの回答を確かめる方法は、ハルシネーションと回答の確認方法も参照してください。
参考資料
確認日:2026年10月8日。検品の条件、4行の表、評価の進め方は筆者による説明例・提案であり、製品の性能を測定した結果ではありません。
コメント