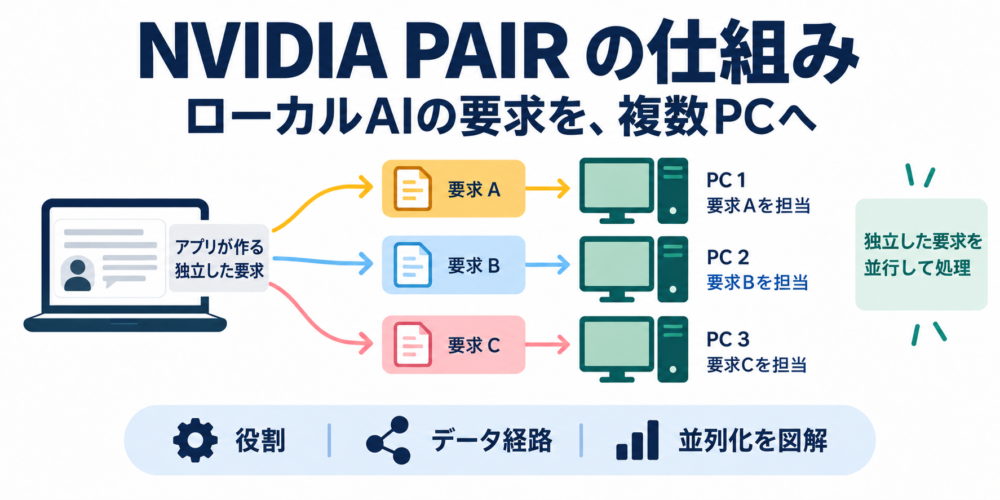
NVIDIA PAIRは、同じローカルネットワーク上のPCへ、AIの推論リクエストを振り分けるソフトウェアです。独立した仕事が複数あるときに、別のPCの処理能力を使い、1台に集中する待ちを減らすことを狙います。分散の単位は「1件の要求」であり、複数PCのメモリを合算して一つの巨大なGPUとして使う方式とは異なります。
IFA 2026では、RTX Spark搭載PCとともに、ローカルAIを動かすためのソフトウェア更新やPAIRが紹介されました。本記事はPAIRの仕組みを、アプリ、通信、メモリ、並列処理の順に図解します。NVIDIA:IFA 2026でのローカルAI発表
確認日は2026年9月19日です。PAIRはベータ版で、本記事は公式資料に基づく技術解説です。実機の導入検証や速度測定は行っていません。発表の全体像は、RTX Spark搭載PCとは?IFA 2026発表とローカルAIの仕組みを図解で扱っています。
PAIRは「どのPCで計算するか」を担当する
AIに「3本の資料を調べて比較して」と頼む場面を考えます。アプリが資料ごとに別の要求を作れば、各資料の処理は同時に進められる可能性があります。そのとき、要求を適したPCへ届けるのがPAIRです。
Personal AI RouterのRouterは、行き先を決める役割を表します。インターネット接続用の箱型ルーターを買い替える話ではなく、PC上で動くソフトウェアの話です。
| 担当 | 何を決める・実行するか | 例 |
|---|---|---|
| アプリ・AIエージェント | 仕事を分け、要求を作り、結果をまとめる | 資料ごとの要約と最終比較 |
| PAIR | 各要求を処理するPCを選び、要求と応答を中継する | 要約AをPC A、要約BをPC Bへ送る |
| 推論エンジン | モデルを読み込み、生成処理を実行する | Ollama、LM Studio |
| CPU・GPU | ソフトウェアの指示に従って処理する | 入力準備、行列演算、結果の取り出し |
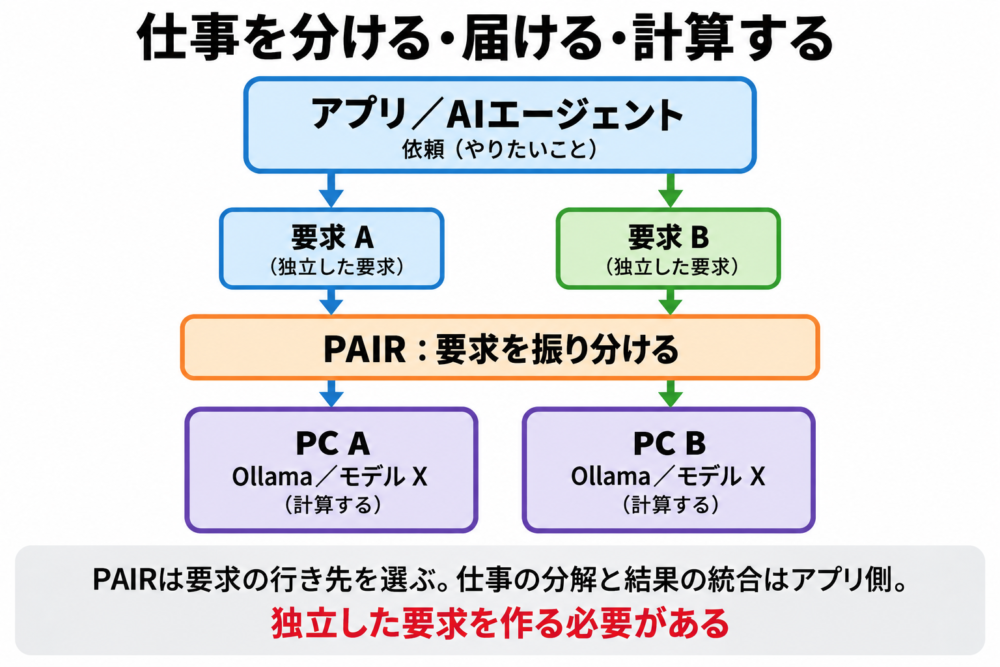
図:エージェントが要求を作りPAIRが振り分け推論エンジンが実行する役割分担。
推論とは、学習済みモデルに入力を渡して結果を求める処理です。エージェントは、目的に応じてモデルや道具を繰り返し利用するアプリを指します。PAIR自体が依頼文を読んで仕事を分解するわけではないため、並列化できる要求を作る側の設計も必要になります。NVIDIA:PAIR技術ブログ
1件の要求は、手元の入口から選ばれたPCへ届く
PAIRでは、参加する1台のマシンをノード、ペアリングしたノードの集まりをクラスターと呼びます。各ノードが同様の役割を持ち、必ず1台の中央管理PCへ集める構成ではありません。
アプリの接続先になるエンドポイント(要求の送り先URL)は、アプリが動くPC上にあります。その後ろのプロキシ(要求を受けて中継する処理)が、同じPCか、別の参加PCを選びます。
例えば、PC AのアプリからPC Bへ送られる要求は、概念的に次の経路を通ります。
- PC Aのアプリが、同じPCのPAIRへモデル名と入力を送る。
- PAIRが処理先を選び、PC BのPAIRへ要求を転送する。
- PC Bの推論エンジンがモデルを実行する。
- 応答がPAIRを経由してPC Aのアプリへ戻る。
アプリが使う入口と、実際に計算するPCを分けることで、アプリ側が要求のたびに接続先を選ぶ手間を減らします。OllamaとLM Studioではエンジンに対応した入口を使うので、異なるエンジンを無条件に同じものとして扱う仕組みではありません。NVIDIA:PAIR Overview
ネットワーク転送とGPU内の読み出しを分ける
PC Bへ要求が届いた後も、データはそのPC内を移動します。一般的なGPU推論では、CPU(汎用の処理を担当するプロセッサー)が入力準備や実行の制御を行い、GPU(多数の演算を並列に処理するプロセッサー)が行列演算などを進めます。
モデルの重み(学習で決まった数値)は、実行前にSSDなどから読み込まれます。実行中にはDRAM(大容量の記憶領域に使うメモリ)からデータを供給し、GPU内のSRAM(高速な小容量の記憶領域に使うメモリ)によるキャッシュなどで再利用します。実際の配置はハードウェアと推論エンジンによって変わります。NVIDIA:GPU Performance Background
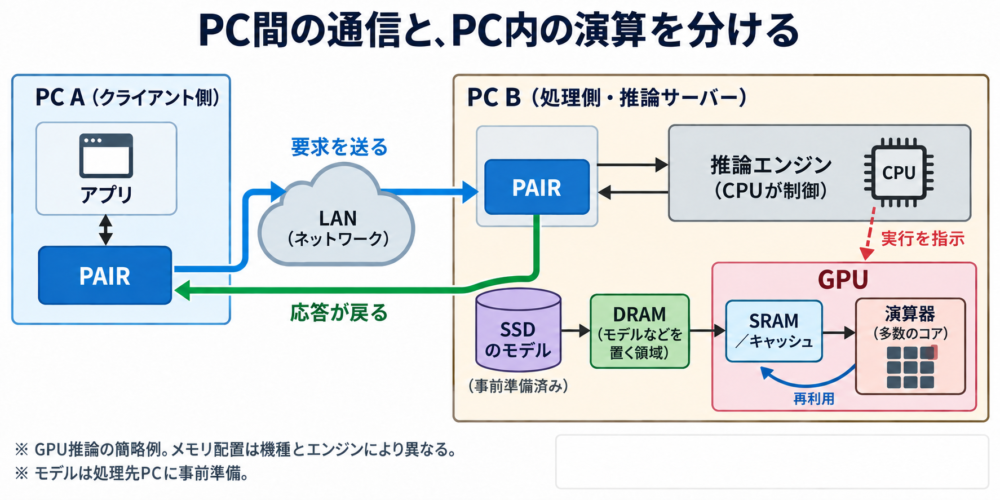
図:PC AのアプリからPC Bへ要求が届きPC B内部でCPUとGPUが推論する概念図。配線やメモリ配置を省略したGPU推論の概念図です。
図で区別したいのは、「PC間で要求を届ける通信」と「選ばれたPCの中で演算器へ値を届ける読み出し」です。PAIRのLAN(家庭や職場などの範囲のネットワーク)を、GPU内のメモリ配線の延長と考えると、何が共有されるのかを誤解しやすくなります。メモリ階層の詳細は、AIのデータはどこを通る?SSD・DRAM・SRAMからGPU演算までを参照してください。
モデルとメモリは、それぞれのPCに用意する
同じモデルを複数台に置くと、振り分け先を増やせる
PAIRの参加PCすべてに、同じモデルを置く必要はありません。ただし、あるモデルの要求を複数台へ振り分けたいなら、そのモデルを処理できる推論エンジンとモデルを各候補に用意します。
説明用に、PC AはモデルX、PC BはモデルXとY、PC CはモデルYを持つとします。モデルXを指定した要求の候補はAとBです。Cが空いていても、モデルXを持たなければ代わりにはなりません。
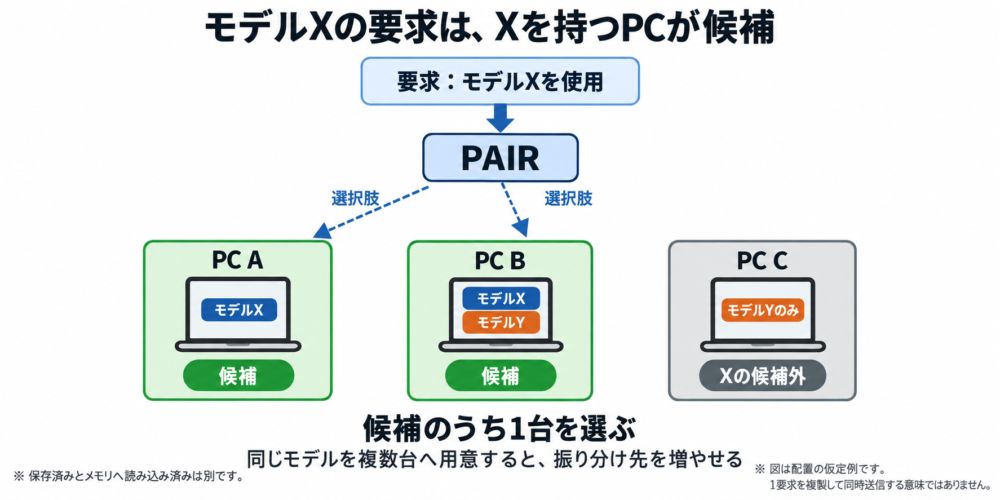
図:モデルXを持つPC AとPC BだけがXの要求の候補になる図。
ここでは「そのモデルを持つか」という適合条件と、「候補のどこへ送るか」という負荷に応じた順位を分けて考えます。同じモデルの保存コピーが複数あることで、初めて同じ要求を引き受ける選択肢が増えます。NVIDIA:PAIR Architecture
| モデル配置 | できること | 引き換えに必要なもの |
|---|---|---|
| モデルXを1台だけに置く | Xの要求をそのPCへ集める | Xの処理先が1台に限られる |
| モデルXを複数台に置く | Xの独立した要求を複数台へ振り分ける | 各PCの保存領域と実行できるメモリ |
| PCごとに別モデルを置く | 要求されたモデルに応じて担当を分ける | アプリ側が適切なモデル名を指定する |
同じ名前だけで期待する出力品質まで揃うとは限りません。比較するときはモデルの版、量子化(数値の精度を下げて容量を抑える方法)、生成設定も確認します。これは運用上の確認点です。
10GB使えるPCが2台あっても、1要求のための20GBにはならない
例えば、あるモデルの実行に合計18GB必要で、各PCでその処理に使えるメモリは10GBずつ、と仮定します。PAIRは1件を1台へ割り当てるため、2台をつないでも「18GBを2台へ分けて載せる」処理には変わりません。この例は、各PC内での別領域への退避などを使わない条件です。
一方、各PCの10GB以内に収まるモデルをそれぞれ動かし、別々の要求を処理する使い方は考えられます。増えるのは独立した要求を処理する場所であり、1件が利用できるメモリ容量は各PC側の条件に依存します。NVIDIA:PAIR Getting Started
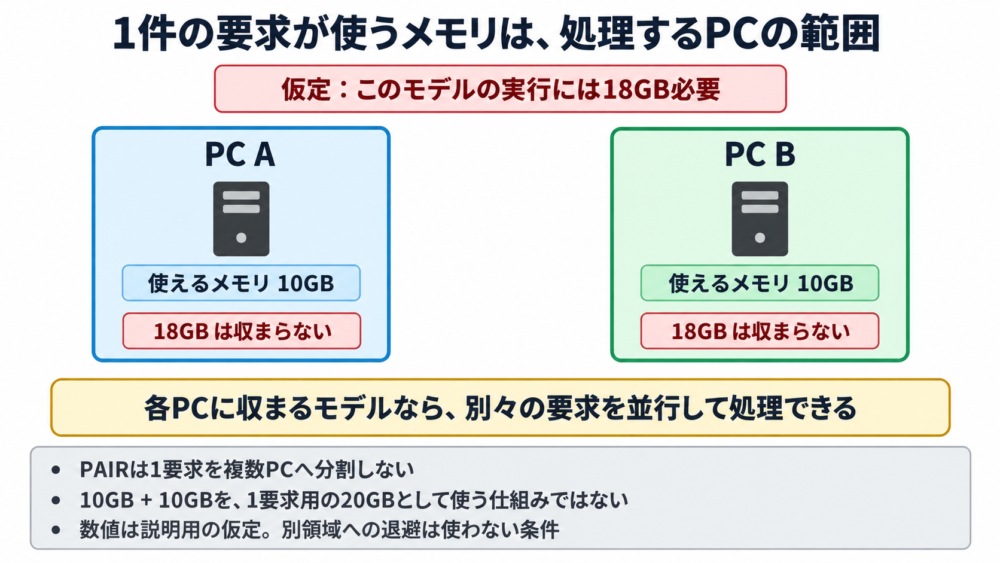
図:1要求18GBの必要量を各10GBの2台へPAIRでは分割できない仮定図。
| 比較する仕組み | 共有・分担する範囲 | 狙う効果 |
|---|---|---|
| PAIRの要求分散 | 独立した要求をPCごとに割り当てる | 同時に処理できる仕事を増やす |
| モデル並列化の一般的な考え方 | 一つのモデルの計算や層などを複数装置へ分担する | 大きなモデルの収容や計算分担 |
| 1台のユニファイドメモリ | CPUとGPUが同じ物理メモリを利用する構成 | コピー削減や柔軟な容量利用 |
モデルの重みを複数GPUへ分割する例は、PyTorch:Distributed Inferenceでも解説されています。この表の後ろ二つは比較のための一般概念です。PAIRに接続したことだけで、それらの機能が追加されるわけではありません。共有の範囲は、ユニファイドメモリとは?CPU・GPUの共有とデータ転送を図解でも説明しています。
複数台が役立つのは、同時に進められる仕事があるとき
資料ごとの要約は並べられるが、統合には待ちが残る
次はPAIRの実測ではなく、処理の依存関係を考える例です。
資料A・B・Cが互いの結果を必要としないなら、各要約は並行して始められます。その後で「三つの要約を比較して結論を出す」処理を行うなら、統合は必要な要約が揃うまで待ちます。
逆に、資料Aの分析結果を使って資料Bへの質問を決める手順では、Bの要求を先に確定できません。PCが3台あっても、依存する手順が自動的に同時実行へ変わることはありません。
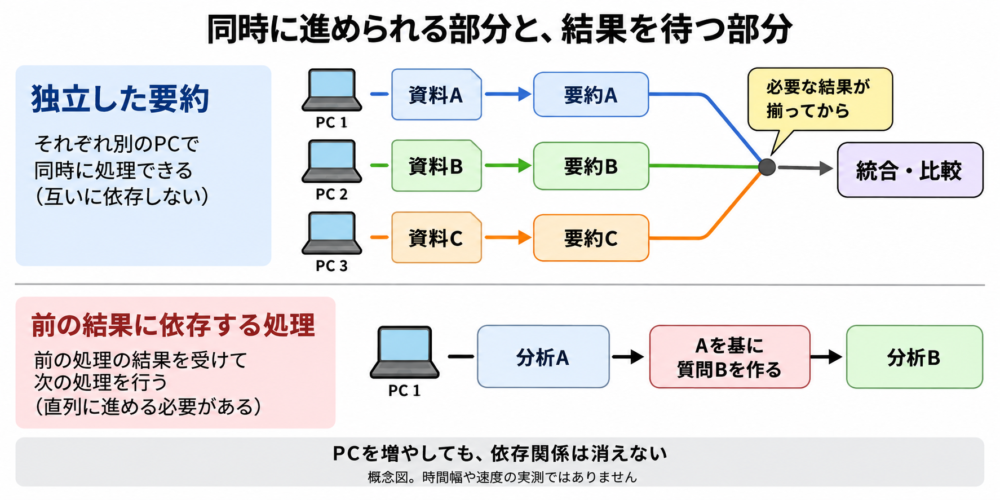
図:独立した資料要約は並行し結果を使う統合は待つという依存関係図。PCの割り当ては説明用で、実測結果ではありません。
作業を増やす前に、「次の要求に前の結果が必要か」と考えると、分散の効果を判断しやすくなります。
| 用途の例 | PAIRで期待すること | 残る制約 |
|---|---|---|
| 独立した文書の要約・分類 | 複数の要求を別PCで進める | 最終集約、各PCの処理速度 |
| 複数エージェントの独立調査 | 同時発生するモデル呼び出しの集中を緩和する | 調査の依存関係、結果の整合確認 |
| 複数人のローカルAI利用 | 適合する複数ノードへ要求を分ける | モデル配置、要求数、通信 |
| 一人の単発チャット | 他PCへ処理を移せる場合がある | 1要求を複数GPUに分割する高速化は行わない |
| 1台に載らない大きなモデル | 各ノードで実行可能かを先に検討する | PAIR自体はメモリ不足を合算で解消しない |
総処理量と、一人の待ち時間は別に測る
要求を増やせば、システム全体が1秒間に処理する量であるスループットは伸びる可能性があります。一方、個々の待ち時間には、送信、待ち行列、モデル読み込み、推論、応答の受信が影響します。
例えば、手元のPCにはモデルが読み込み済みでも、選ばれた別PCではSSDからの読み込みが必要なら、最初の応答が遅れる可能性があります。「別PCが空いている」と「今の要求を最短で返せる」は同じ条件ではありません。
比較時は、TTFT(最初のトークンが届くまでの時間)、ITL(続けて届くトークン間の時間)、全要求が終わるまでの時間を分けます。トークンはモデルが文章を扱う単位です。測定条件の揃え方は、「1 PFLOPS」「128GB」でAI性能は分かる?RTX Sparkから学ぶ性能指標にまとめています。
ベータ版では、対応環境と振り分けの限界を確認する
公式技術ブログでは、Windows・macOS・Linux向けベータ版と、対応するGeForce RTX 20シリーズ以降、Turing以降のRTX PRO、DGX Spark、Apple M4以降などを案内しています。OS名だけで動作可否を決めず、導入時点の対応表を確認します。NVIDIA:PAIR技術ブログ
特に、公式Known IssuesではWindows on ARMを実験的としています。RTX Spark関連の発表として紹介されたことから、RTX Sparkの全機種・構成での動作保証へ広げることはできません。
同資料では、現行の振り分けが待機・実行中の仕事量とGPU使用率を基にし、GPUの機種、空きメモリ、実測の応答時間、モデルが既にメモリ上にあるかまでは判断へ使わないと説明されています。異なる性能のPCを混ぜる場合には、結果として遅いPCが選ばれる可能性もあります。
また、共有メモリを使う一部環境では、PAIR上のGPUメモリ表示が実際の状況を正しく示さない問題が記載されています。大きなモデルを置く判断には、OSや推論エンジン側の表示も確認します。NVIDIA:PAIR Known Issues
「ローカルで動く」の通信範囲を理解する
別PCへ振り分けると、そのPCは要求の入力を受け取ります。「自分のPCだけで処理」と「家庭内の別PCで処理」は、データが届く範囲という点で異なります。
PAIRの公式セキュリティ文書は、アプリから同じPCの入口へ入るHTTP通信と、ペアリング済みノード間の相互TLS通信を区別しています。相互TLSは、通信を暗号化し、双方が証明書で相手を確認する方式です。
ただし、機器の発見や一部の状態情報には平文HTTPが使われます。PAIRにつながるすべての通信が同じ保護を受けると考えず、信頼できる端末とネットワークで使い、PAIRのポートをインターネットへ公開しないことが前提です。
モデルのダウンロード、更新、エージェントのWeb検索や外部サービス呼び出しは、それぞれ別の通信です。PAIRが推論をLAN内へ振り分けても、アプリ全体が外部通信をしないという保証にはなりません。NVIDIA:PAIR Security
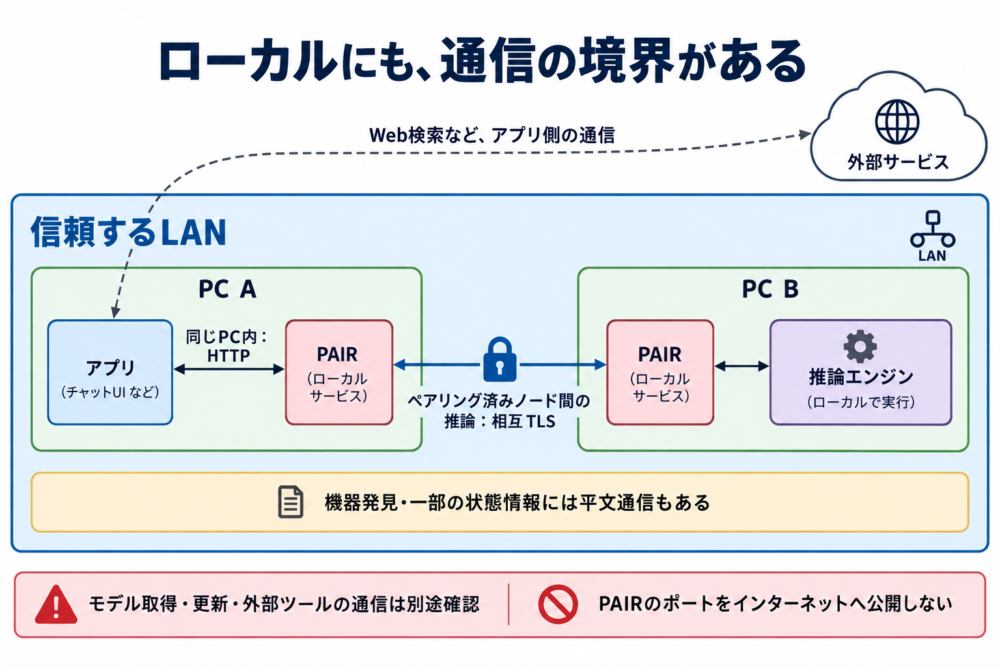
図:同じPC内のHTTPとペアリング済みPC間の相互TLSおよび外部通信を区別する図。
試すときは、配置・経路・待ち時間の順で確認する
仕組みを理解したうえで試すなら、公式Getting Startedの手順に沿い、小さい構成から確認します。
- 参加PCの対応環境を調べ、それぞれにPAIRを用意する。
- 信頼するPC同士をペアリングする。
- 推論エンジンを有効にし、使うモデルを必要なノードへ用意する。
- アプリを、そのアプリと同じPCのPAIRエンドポイントへ接続する。
- 小さな要求を送り、デスクトップ版のJobs表示で処理したノードを確認する。
- 独立した要求を複数送り、単独PCのときと同じ条件で待ち時間を比較する。
別PCのIPアドレスをアプリへ直接指定する方法と、同じPCのPAIRを入口にする方法は混同しないでください。実際に使うポートや表示は導入環境に従います。NVIDIA:PAIR Getting Started
モデルの準備ができても、使うモデルの利用条件は別途確認します。PAIR本体のリポジトリはApache-2.0ですが、接続先の推論エンジンやモデルまで同じライセンスになるわけではありません。NVIDIA:PAIR LICENSE
PAIRを検討する出発点は、手元のPCの台数よりも、同時に進められる要求がいくつあるかです。その要求を処理できるモデル配置を用意し、実際にどこで処理されたかと、利用者の待ち時間を確かめると、複数PCを使う価値を判断できます。
コメント