AI・テクノロジー

AI研究・論文解説

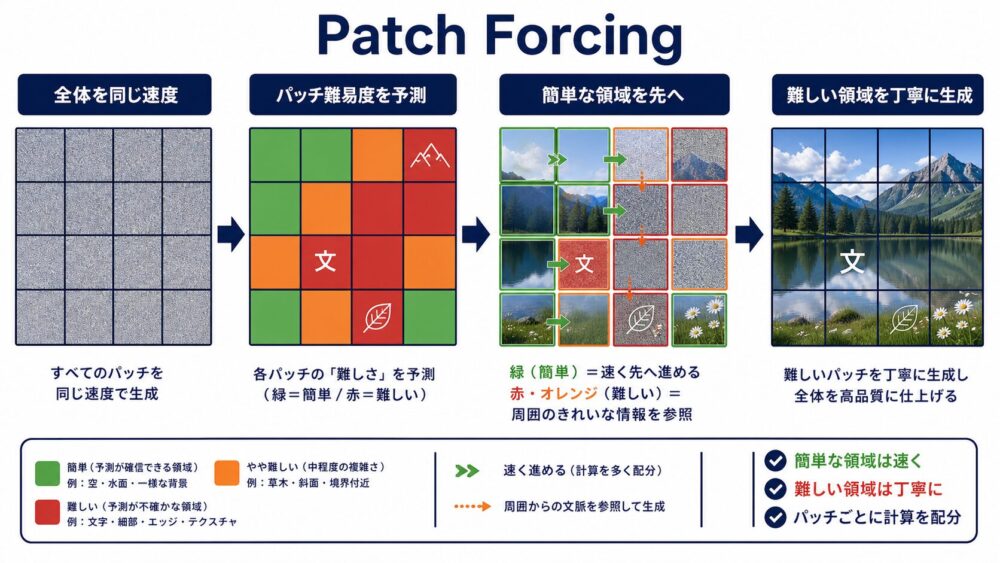
Patch Forcingとは?画像生成をパッチごとの難しさで適応的に進める仕組み

Patch Forcingとは、画像をパッチごとの難しさに応じて異なる速度で生成する適応サンプリング手法です。LTG sampler、difficulty head、dual-loop、look-aheadの仕組みを、Flow Matchingの数式とImageNet・Text-to-Imageの実験結果から解説します。
AI研究・論文解説
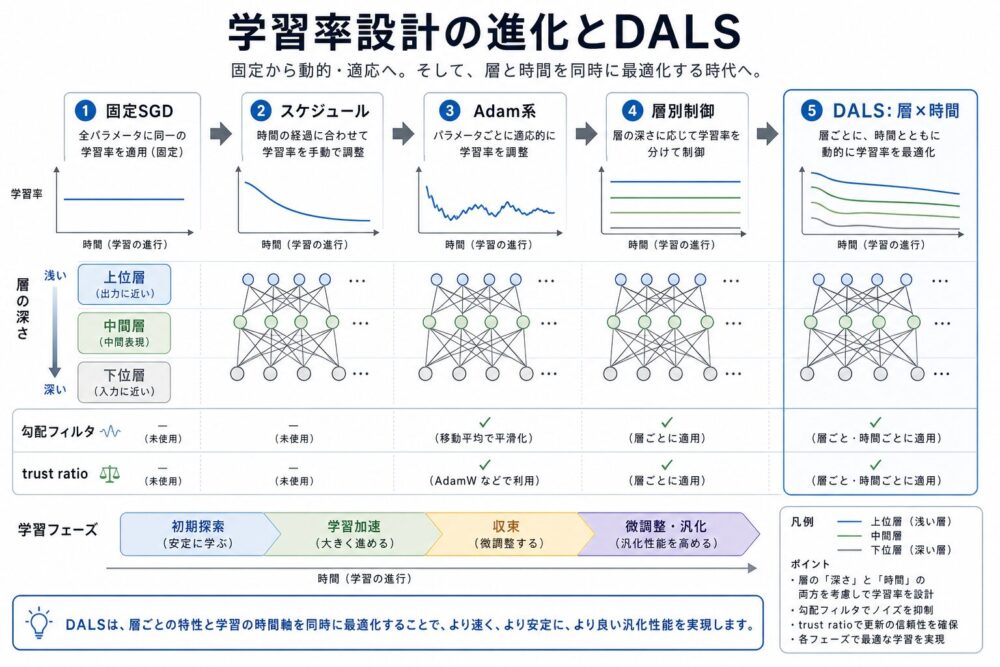
学習率とは?DALS論文で見る最適化手法の進化と使い分け

学習率とは何か、SGD、cosine decay、AdamW、RAdam、LARS、Grokfast、DALSの違いを論文ベースで解説します。DALSが提案する層と学習フェーズに応じた最適化、scratch学習とfine-tuningでの使い分け、実験結果の読み方を整理します。
AI技術・仕組み

Decoder-only Transformerとは?GPT系LLMの学習と生成を図解

Decoder-only Transformerの構造をGPT-2論文から解説。元のTransformer decoderとの違い、causal mask、次token損失、学習・prefill・decode、KV Cacheまで図と具体例で理解できます。
AI技術・仕組み

RoPEとは?LLMが位置情報を回転で扱う仕組みを図解

RoPEとは、LLMのQueryとKeyを位置に応じて回転する位置表現です。2次元の具体計算、相対位置差が内積へ残る理由、PyTorch実装、標準RoPEと長文向けスケーリングの違いを図解します。
AI技術・仕組み

Self-Attentionとは?QKVの計算と並列化の仕組みを図解

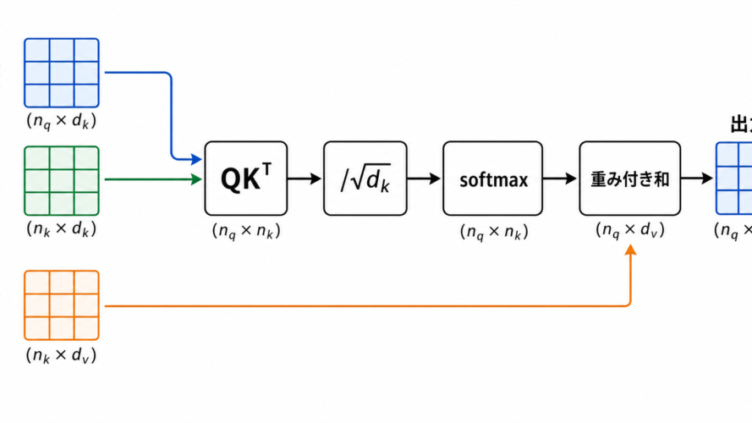
Self-AttentionのQ・K・VとScaled Dot-Product Attentionを数値例で解説。RNNとの依存関係の違い、並列計算できる理由、学習と生成の違いを図解し、PyTorchで計算の一致を確かめます。
AI研究・論文解説

【論文解説】LLMはなぜ日本文化に寄りがちなのか?CROQで見る文化・地域バイアス

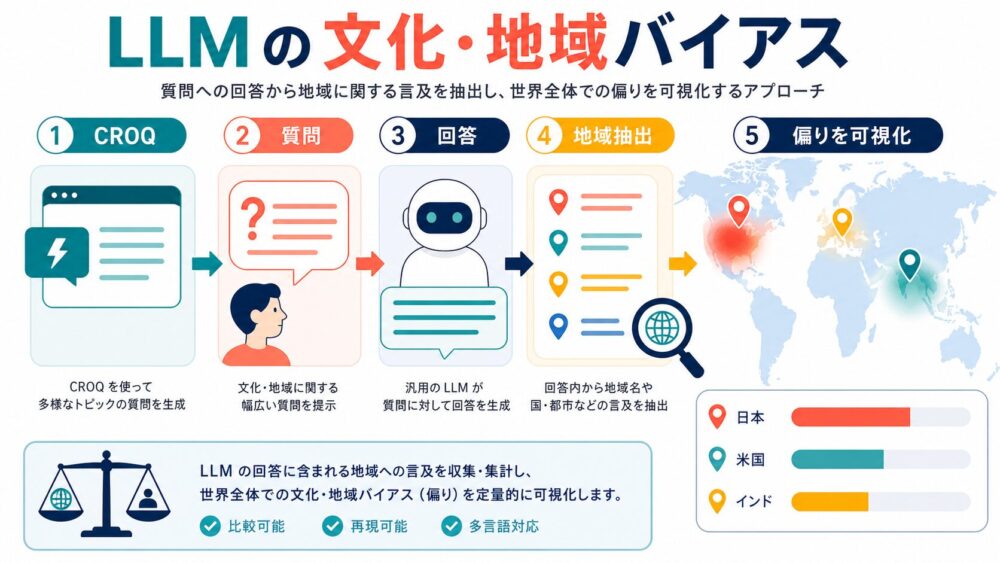
LLMが文化に関する曖昧な質問へ答えるとき、どの国や地域を暗黙に選びやすいのかを調べた論文を解説します。CROQデータセット、LLM-as-a-judgeによる地域抽出、入力言語の影響、SFT後に強まる文化・地域バイアスを初心者にも分かりやすく整理します。
AI技術・仕組み

【LLM解説シリーズ】Transformerとは?Attention Is All You Need論文からLLMの基本構造を理解する

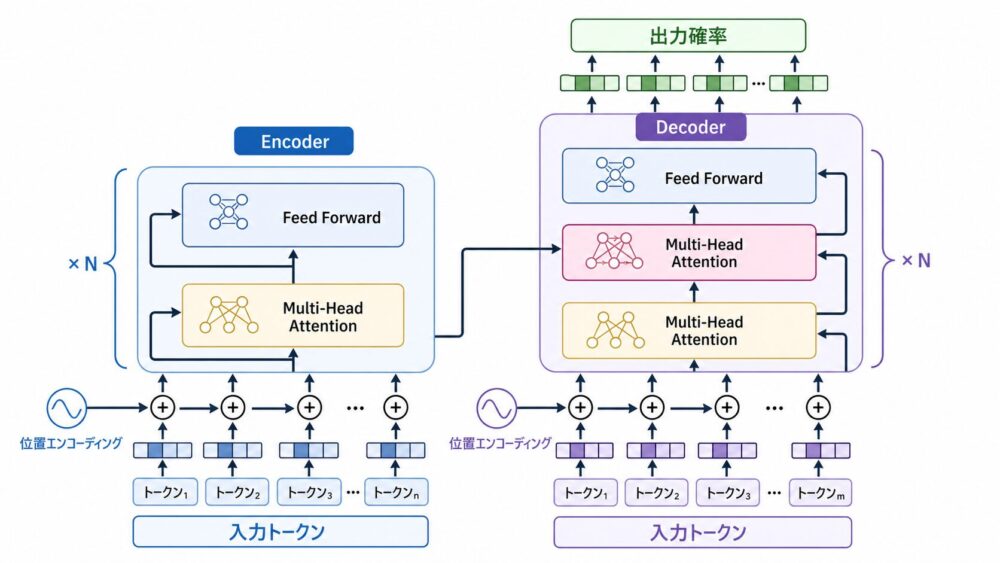
Transformerは、Attentionを中心に系列を処理するLLMの基礎アーキテクチャです。Attention Is All You Need論文をもとに、Self-Attention、Multi-Head Attention、Positional Encoding、EncoderとDecoderの違いを初心者にも分かりやすく解説します。
AI技術・仕組み

Bahdanau Attentionとは?加法型Attentionの計算とSelf-Attentionとの違い

Bahdanau Attentionとは、RNN翻訳のDecoderがEncoder出力を動的に参照する加法型Attentionです。score、softmax、context vectorの具体計算とSelf-Attentionとの違いを図解します。
AI技術・仕組み

Embeddingとは?LLMが単語や文章をベクトルで表す仕組みをBERT論文から解説

Embedding(埋め込み)とは、token IDをベクトルへ変換するLLMの入口です。BERT論文をもとに、token embedding、segment embedding、position embedding、Masked Language Modeling、文脈化表現を初心者にも分かりやすく解説します。
AI技術・仕組み

Tokenizationとは?SentencePiece論文からLLMのトークン化を解説

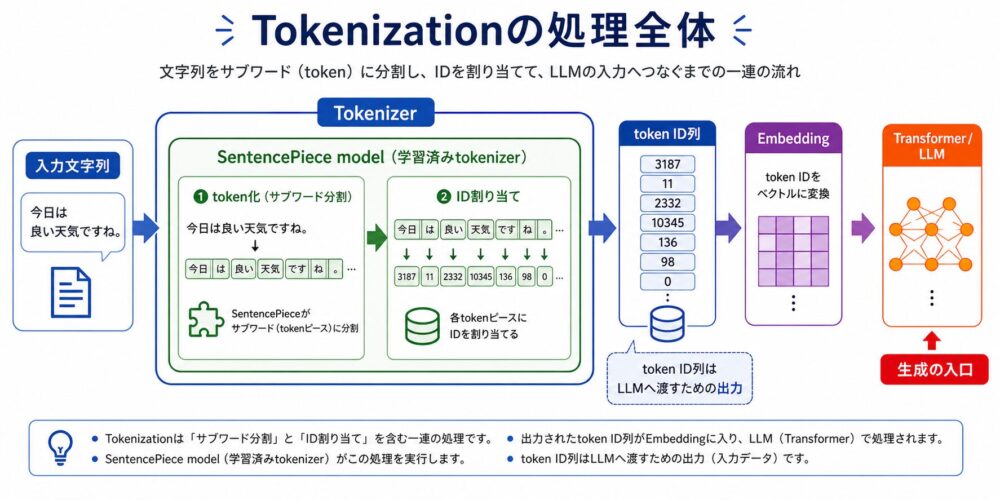
Tokenization(トークン化)とは、文章をLLMが扱えるtoken IDの列に変換する処理です。SentencePiece論文をもとに、サブワード、BPE、Unigram、可逆なdetokenization、日本語LLMでの注意点を解説します。
スポンサーリンク