AI技術・仕組み

AI技術・仕組み

RoPEとは?LLMが位置情報を回転で扱う仕組みを図解

RoPEとは、LLMのQueryとKeyを位置に応じて回転する位置表現です。2次元の具体計算、相対位置差が内積へ残る理由、PyTorch実装、標準RoPEと長文向けスケーリングの違いを図解します。
AI技術・仕組み
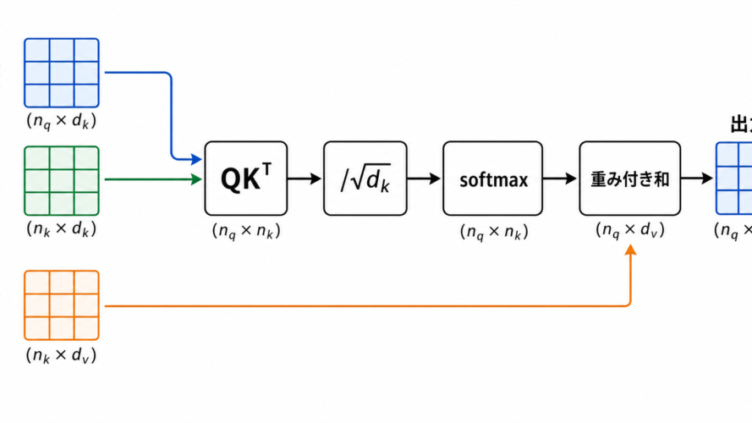
Self-Attentionとは?QKVの計算と並列化の仕組みを図解

Self-AttentionのQ・K・VとScaled Dot-Product Attentionを数値例で解説。RNNとの依存関係の違い、並列計算できる理由、学習と生成の違いを図解し、PyTorchで計算の一致を確かめます。
AI技術・仕組み

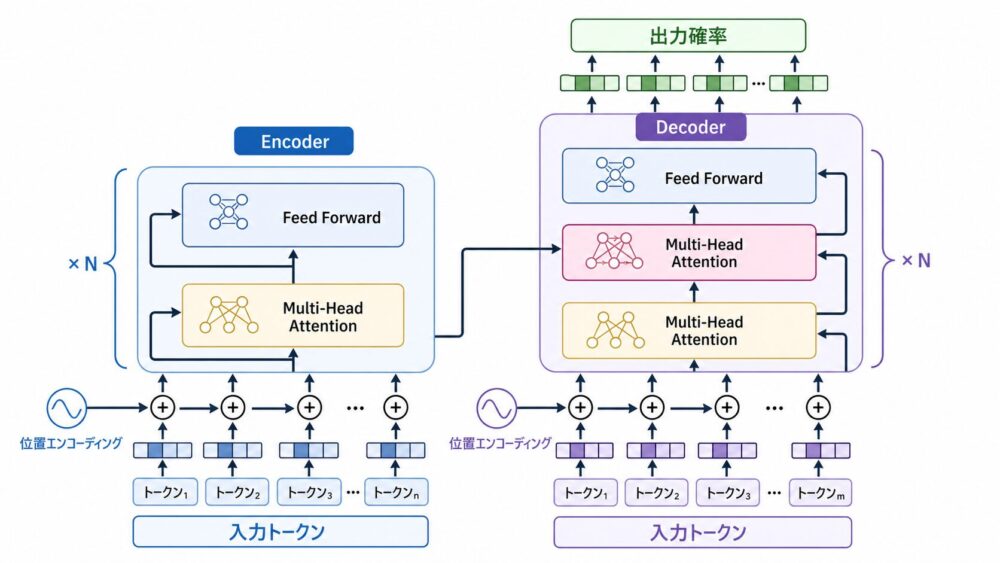
【LLM解説シリーズ】Transformerとは?Attention Is All You Need論文からLLMの基本構造を理解する

Transformerは、Attentionを中心に系列を処理するLLMの基礎アーキテクチャです。Attention Is All You Need論文をもとに、Self-Attention、Multi-Head Attention、Positional Encoding、EncoderとDecoderの違いを初心者にも分かりやすく解説します。
AI技術・仕組み

Bahdanau Attentionとは?加法型Attentionの計算とSelf-Attentionとの違い

Bahdanau Attentionとは、RNN翻訳のDecoderがEncoder出力を動的に参照する加法型Attentionです。score、softmax、context vectorの具体計算とSelf-Attentionとの違いを図解します。
AI技術・仕組み

Embeddingとは?LLMが単語や文章をベクトルで表す仕組みをBERT論文から解説

Embedding(埋め込み)とは、token IDをベクトルへ変換するLLMの入口です。BERT論文をもとに、token embedding、segment embedding、position embedding、Masked Language Modeling、文脈化表現を初心者にも分かりやすく解説します。
AI技術・仕組み

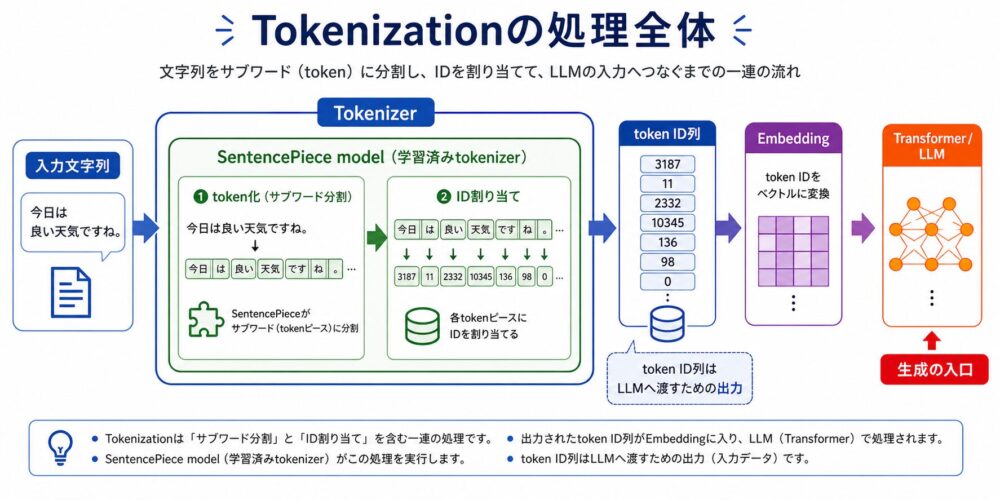
Tokenizationとは?SentencePiece論文からLLMのトークン化を解説

Tokenization(トークン化)とは、文章をLLMが扱えるtoken IDの列に変換する処理です。SentencePiece論文をもとに、サブワード、BPE、Unigram、可逆なdetokenization、日本語LLMでの注意点を解説します。
AI技術・仕組み

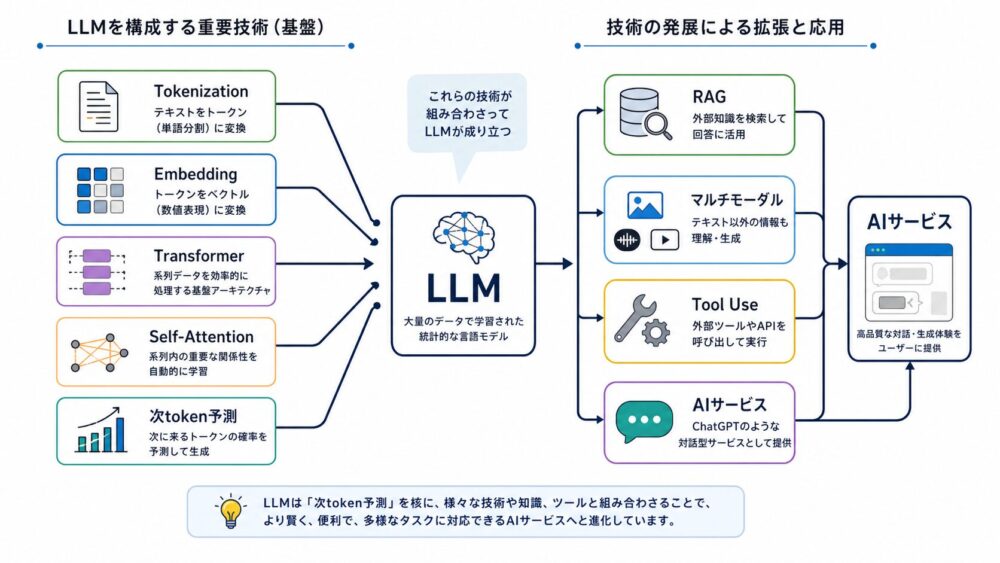
LLMとは?ChatGPTの原点をGPT-3論文から読み解く

LLM(大規模言語モデル)とは何かを、GPT-3論文をベースに解説します。Transformer、次トークン予測、Few-shot学習、ChatGPTにつながる技術的背景を整理します。
スポンサーリンク