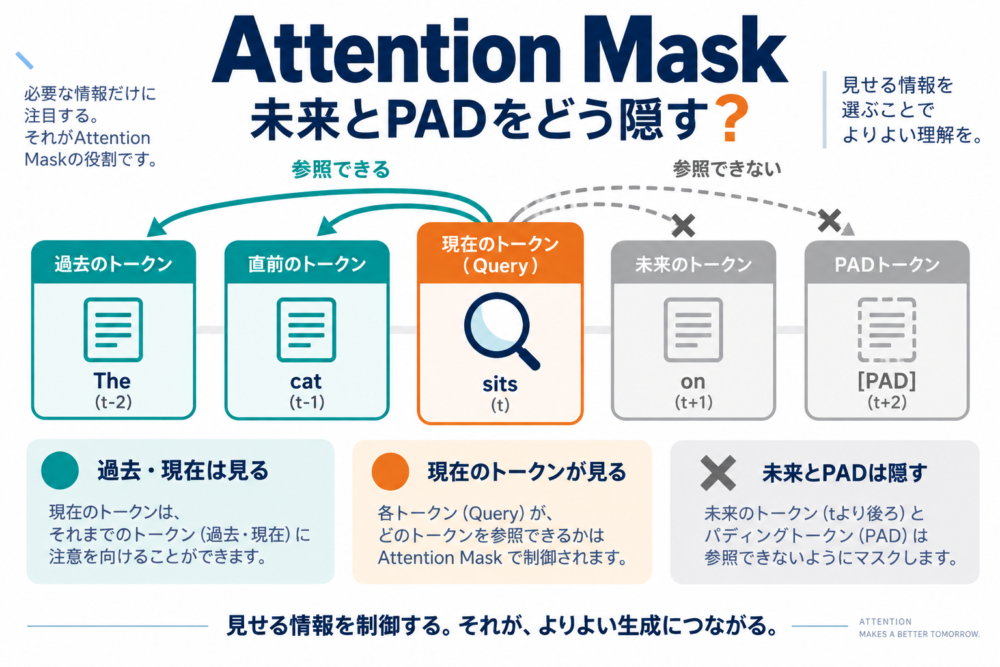
Attention Mask(注意機構で参照できる位置を指定する仕組み)は、各トークンが「どこから情報を受け取ってよいか」を決めます。文章生成では未来のトークンを隠し、長さの異なる文章をまとめて扱うときは埋め草のPADを参照先から外します。
この記事では、行列の読み方からCausal MaskとPadding Maskを整理し、PyTorchで両方を組み合わせます。図の行をQuery、列をKeyとして読み、最後に小さな数値例で確かめると、Trueの意味や次元の間違いを見つけやすくなります。
Q・K・Vの計算自体を先に確認したい方は、Self-AttentionとScaled Dot-Product Attentionの解説を参照してください。本記事の図は独自の概念図、数値例は仕組みを確かめるための人工的な入力です。
Attention Maskは何を制限するのか
Attention(入力のどの部分から情報を集めるかを重み付けする処理)は、Query(情報を探す側)とKey(参照先の手掛かり)から重みを計算し、その重みでValue(実際に集める情報)を混ぜます。
マスクはこの重み付けに制約を与えます。禁止した参照先の重みを0にすることで、その位置のValueが出力に混ざることを防ぎます。
| マスク | 制限する理由 | 主な場面 | 設計上の注意 |
|---|---|---|---|
| Causal Mask(因果マスク) | 未来の情報を使わずに予測する | 自己回帰型の文章生成モデル | 過去だけでは不十分なタスクに一律適用しない |
| Padding Mask(埋め草の除外) | PADを内容として参照させない | 長さの違う系列を同じ長さにそろえる | PAD位置の出力や損失は別に扱う |
| 両方を組み合わせる | 未来とPADの両方を除く | 右側にPADを追加した文章生成の学習 | 真偽値の意味をそろえて合成する |
たとえば文章全体が与えられる分類用の双方向エンコーダでは、通常、未来側を一律に隠す必要はありません。一方、次のトークンを予測する自己回帰モデルでは、答えにつながる未来の入力を使えないようにします。原論文のDecoderもこの制約を設けています。出典:Attention Is All You Need、§3.1–3.2
行は「情報を集める位置」、列は「参照先」
4トークンのSelf-Attention(同じ系列内で情報を集める処理)なら、マスクは基本的に4行4列で表せます。
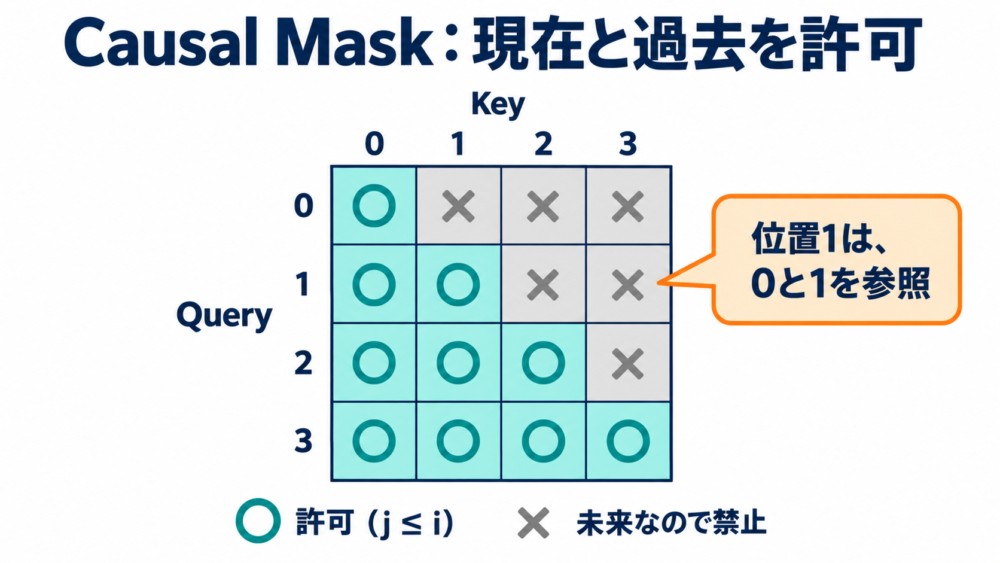
行番号をi、列番号をjとすると、マス(i, j)は「位置iのQueryから、位置jのKey・Valueを参照できるか」です。本記事の図では、許可を青緑、禁止を灰色で示します。色は重みの大きさではなく、参照の可否です。
以降の行列は、行と列をどちらも左から/上から0、1、2、3の順に並べます。行列の向きを変えれば三角形の向きも変わるため、「上三角か下三角か」だけを暗記せず、参照の意味から読みましょう。
なぜsoftmaxの前にマスクを入れるのか
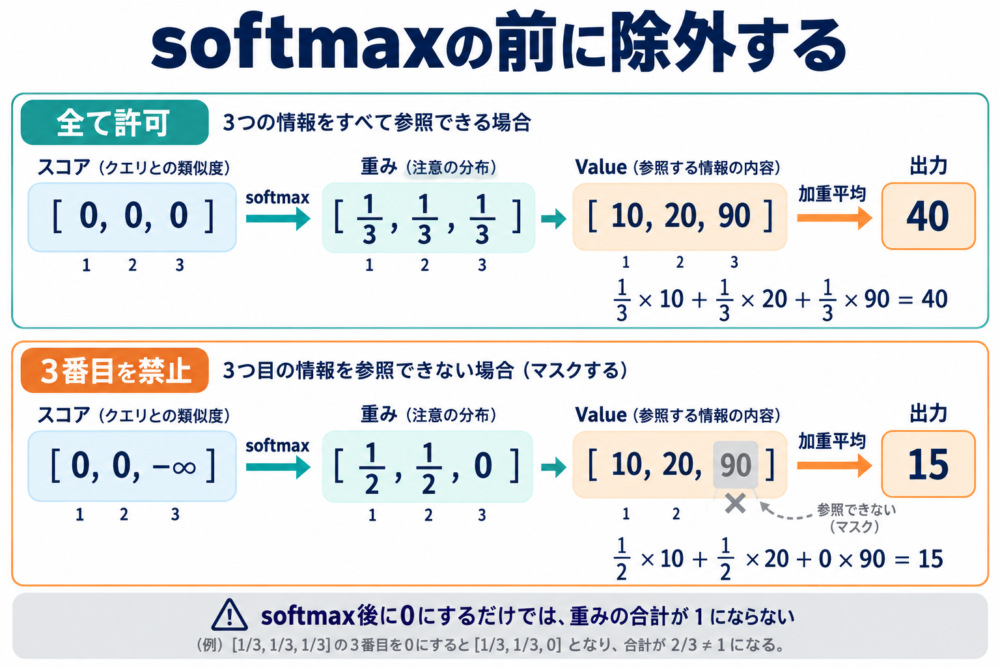
softmax(複数の値を、合計1の重みに変換する関数)の入力となるスコアに、許可なら0、禁止なら負の無限大を加えると考えます。
各Queryと各Keyの内積から求めたスコアを、Keyの次元数の平方根で調整し、マスクMを加えてからsoftmaxに渡します。Oは出力、Mはこの式では加算用のマスクです。bool型のTrue/Falseをそのまま足すという意味ではありません。
3つの参照先のスコアがすべて0で、Valueが10、20、90だとします。
| 条件 | softmaxに入る値 | 重み | Valueの加重平均 |
|---|---|---|---|
| すべて許可 | [0, 0, 0] | [1/3, 1/3, 1/3] | 40 |
| 3番目を禁止 | [0, 0, −∞] | [1/2, 1/2, 0] | 15 |
禁止位置には重みを割り当てず、残った位置の間で配分し直すため、10と20の平均になります。
softmaxの後で3番目の重みだけを0にすると、重みは[1/3, 1/3, 0]、合計は2/3です。出力は10となり、上の15とは一致しません。後から除外するなら再正規化も必要なので、通常はsoftmax前のスコアにマスクを適用します。
また、Valueだけを0にしても、その位置へ重みを割り当てること自体は止まりません。PAD用の埋め込みを0にする設定と、AttentionでPADを参照しない設定も区別しましょう。
Causal Mask:未来を見せず、現在と過去を許可する
同じ開始位置の系列をQueryとKeyに使う場合、許可条件はj ≤ iです。位置0は0だけ、位置1は0と1、位置2は0・1・2を参照できます。
| Query\Key | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | 許可 | 禁止 | 禁止 | 禁止 |
| 1 | 許可 | 許可 | 禁止 | 禁止 |
| 2 | 許可 | 許可 | 許可 | 禁止 |
| 3 | 許可 | 許可 | 許可 | 許可 |
現在位置を参照してよい理由
次トークン予測では、位置iの入力までを使って、その次のトークンを予測します。たとえば入力が「私は/猫が/好き」なら、「私は」の位置から「猫が」を、「猫が」の位置から「好き」を予測するように、入力と正解を1位置ずらします。
そのため、入力の現在位置を参照することと、予測すべき答えを見ることは別です。対角線を含めて許可する図は、この入力と正解のずれを前提にしています。実装では、データ側でずらすのか、モデルが内部でずらすのかを確認してください。
生成が1トークンずつでも、学習には必要
学習時は正解の文章全体を用意できるため、複数位置の計算をまとめて行えます。制約がなければ、早い位置から後ろの正解トークンを参照できてしまいます。Causal Maskを適用すると、行列演算で処理をまとめつつ、各位置が使える情報を現在までに制限できます。
これは概念上の依存関係です。図に禁止セルが多いことだけから、演算時間やメモリ使用量がその割合で減るとは判断できません。具体的な計算方法は実行カーネルに依存します。
Padding Mask:PADの列を参照先から外す
バッチ(複数の入力をまとめて処理する単位)に長さの異なる文章を入れるとき、短い文章にPAD(長さを合わせるための埋め草トークン)を足すことがあります。
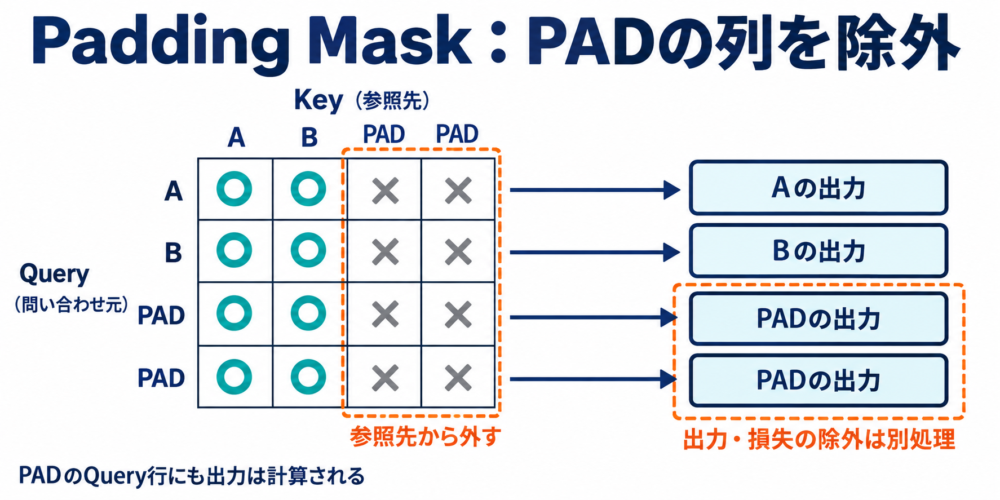
系列が「A、B、PAD、PAD」なら、有効なKeyは0と1です。Padding Maskだけを適用する場合、どのQuery行も列0と1を参照でき、列2と3を参照できません。
| Query\Key | A | B | PAD | PAD |
|---|---|---|---|---|
| A | 許可 | 許可 | 禁止 | 禁止 |
| B | 許可 | 許可 | 禁止 | 禁止 |
| PAD | 許可 | 許可 | 禁止 | 禁止 |
| PAD | 許可 | 許可 | 禁止 | 禁止 |
PADの出力行が0になるとは限らない
このマスクが除外するのは参照先の列です。PAD位置のQueryでも、有効なKey・Valueを使えば出力が計算されます。
学習の損失(予測の誤差)からPADを除く場合は、クラス番号を正解に使うCrossEntropyLossで、PADの教師ラベルをignore_indexの値にするなど、損失側での設定が必要です。Attention Maskを渡すだけで、PADの損失が自動的に無視されるとは限りません。系列全体を平均して分類する場合も、有効な出力だけを平均する処理が必要です。
PADのQuery行を全部禁止にすれば済むと考えると、次の問題が生じます。ある行の参照先をすべて禁止すると、素朴なsoftmax計算では全要素が−∞になり、正規化できずNaN(有効な数値にならない状態)になります。最適化された関数の挙動は実装にもよるため、全禁止行の扱いに依存しない設計を先に考えます。
PyTorchではTrueの意味と形状をセットで確認する
PyTorchのSDPA(Scaled Dot-Product Attentionを計算する関数)とnn.MultiheadAttentionでは、bool型マスクの意味が異なります。以下はPyTorch 2.14の公式仕様を基にした比較です。
| 関数・引数 | boolのTrue | 代表的な形状 | 選ぶ場面と注意 |
|---|---|---|---|
F.scaled_dot_product_attentionのattn_mask |
参照を許可 | 重みの形状へbroadcast可能 | Q・K・Vを自分で用意する。許可条件を合成しやすい |
nn.MultiheadAttentionのattn_mask |
参照を禁止 | (L, S) または (B×H, L, S) | 射影も含めて層を使う。SDPAのboolをそのまま渡さない |
nn.MultiheadAttentionのkey_padding_mask |
そのKeyを除外 | (B, S) | バッチごとのPAD指定に向く。Queryの損失除外とは別 |
Bはバッチ数、Hはヘッド数(別々の重み付けを計算する本数)、LはQueryの長さ、SはKeyの長さです。ここではバッチを持つ入力を扱います。出典:SDPA、MultiheadAttention
SDPAの形状を一つずつたどる
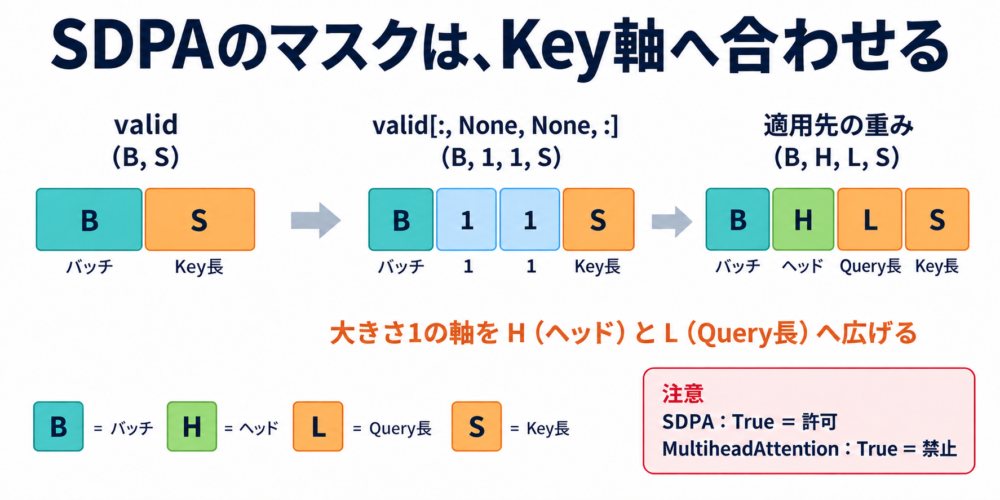
通常のMulti-head構成で、Qを(B, H, L, D)、Kを(B, H, S, D)とすると、Attentionの重みは(B, H, L, S)です。DはQuery・Keyの1ヘッドあたりの特徴次元です。
有効Keyを示すvalidの形状が(B, S)なら、valid[:, None, None, :]で(B, 1, 1, S)にします。ヘッド軸とQuery軸に大きさ1の次元を足し、broadcast(大きさ1の軸を必要な範囲へ広げる規則)によって全ヘッド・全Queryに適用します。
(B, S)をそのまま渡すと、右端から次元を対応させる規則によりBがLと対応してしまいます。エラーになる場合に加え、偶然サイズが等しいと意図しない軸へ適用される可能性もあります。動いたことだけでは形状が正しい証拠になりません。
float型なら0と負の無限大で表す
SDPAのfloat型マスクはスコアに加算されます。許可を0、禁止を−∞にした加算マスクは、ここまでの式に直接対応します。dtype(数値型)はQ・K・Vとそろえ、device(CPUやGPU上の配置先)もそろえます。
boolを単にfloatへ変換して0と1にしても、禁止を表す加算マスクにはなりません。1を足した位置のスコアを上げるだけです。nn.MultiheadAttentionで2種類のマスクを同時指定するときも、両者の型をそろえます。
Causal MaskとPadding Maskを合成して実行する
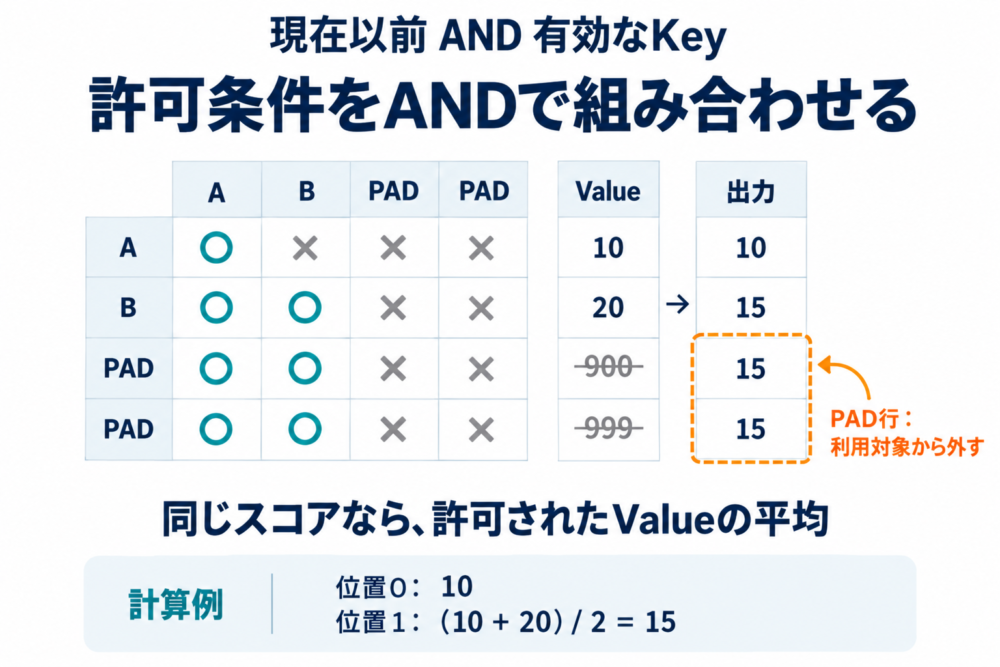
SDPA向けに「許可=True」と統一すれば、因果条件を満たし、かつ有効なKeyである位置をANDで選べます。
「A、B、PAD、PAD」の右パディングでは、許可行列は次のようになります。
| Query\Key | A | B | PAD | PAD |
|---|---|---|---|---|
| A | 許可 | 禁止 | 禁止 | 禁止 |
| B | 許可 | 許可 | 禁止 | 禁止 |
| PAD | 許可 | 許可 | 禁止 | 禁止 |
| PAD | 許可 | 許可 | 禁止 | 禁止 |
逆に「禁止=True」の表現なら、未来であるか、またはPADである位置をORで選びます。ANDかORかは、マスクの名前ではなくTrueが何を意味するかで決まります。
手計算できる最小コード
以下はCPUで動かせる独自の例です。入力は空でなく、PADを右側へ追加し、L=S=4とします。関連度をすべて同じにするためQとKを0にし、出力が許可されたValueの平均になるようにしました。学習済みモデルの出力例ではありません。
import torch
import torch.nn.functional as F

# 平均を手計算できるよう、すべての関連度を同じ0にする。
q: torch.Tensor = torch.zeros(1, 1, 4, 1)
k: torch.Tensor = torch.zeros_like(q)
v: torch.Tensor = torch.tensor([10.0, 20.0, 900.0, 999.0]).view(1, 1, 4, 1)
valid: torch.Tensor = torch.tensor([[True, True, False, False]])
causal: torch.Tensor = torch.ones(4, 4, dtype=torch.bool).tril()
allowed: torch.Tensor = causal[None, None, :, :] & valid[:, None, None, :]
out: torch.Tensor = F.scaled_dot_product_attention(
    q, k, v, attn_mask=allowed, dropout_p=0.0, is_causal=False
)
print(out.flatten().tolist())
[10.0, 15.0, 15.0, 15.0]位置0はValueの10だけ、位置1は10と20を参照します。末尾2つの15はPAD Query行の出力なので、実際の学習や集約では利用対象から外します。PAD側の900や999はどの行にも混ざりません。
この例では因果条件を明示マスクへ含めたため、is_causal=Falseとしています。公式仕様に合わせ、attn_maskとis_causal=Trueの併用に依存しない書き方です。PADなし・同じ位置から始まる正方形の因果Attentionなら、明示マスクの代わりにis_causal=Trueを使う方法もあります。
dropout_p=0.0は、結果を比較するときに重みがランダムに間引かれないようにするためです。SDPAは渡された確率でdropoutを適用するので、推論時にも明示的に0を渡します。出典:SDPA公式リファレンス
「見えないはずの値」を変えて確かめる
出力の形が合っているだけでは、情報の漏れは分かりません。先ほどのコードに続けて、PADのValueを大きく変えても、有効位置の出力が変わらないかを検査できます。
# PADの値が有効位置へ漏れていないかを確認する。
changed: torch.Tensor = v.clone()
changed[:, :, 2:, :] = -12345.0
checked: torch.Tensor = F.scaled_dot_product_attention(
    q, k, changed, attn_mask=allowed, dropout_p=0.0
)
torch.testing.assert_close(out[:, :, :2], checked[:, :, :2])
さらに位置1のValueを変えたとき、位置0の出力が不変なら、位置0から未来の位置1が見えていないことを確認できます。モデル全体の検証では、変更したトークンがQ・K・Vや他の層へ及ぼす影響も含めて検査してください。
本記事の例はPyTorch 2.14.0+cpu/Python 3.12のCPU環境で実行し、期待する平均、PAD変更への不変性、未来変更への不変性、boolと加算マスクの一致を確認しました。別途nn.MultiheadAttentionの禁止位置の重みが0になることも検査しています。GPUでの速度や、すべてのカーネルでの数値一致を測定したものではありません。
KVキャッシュではQueryとKeyの位置を確認する
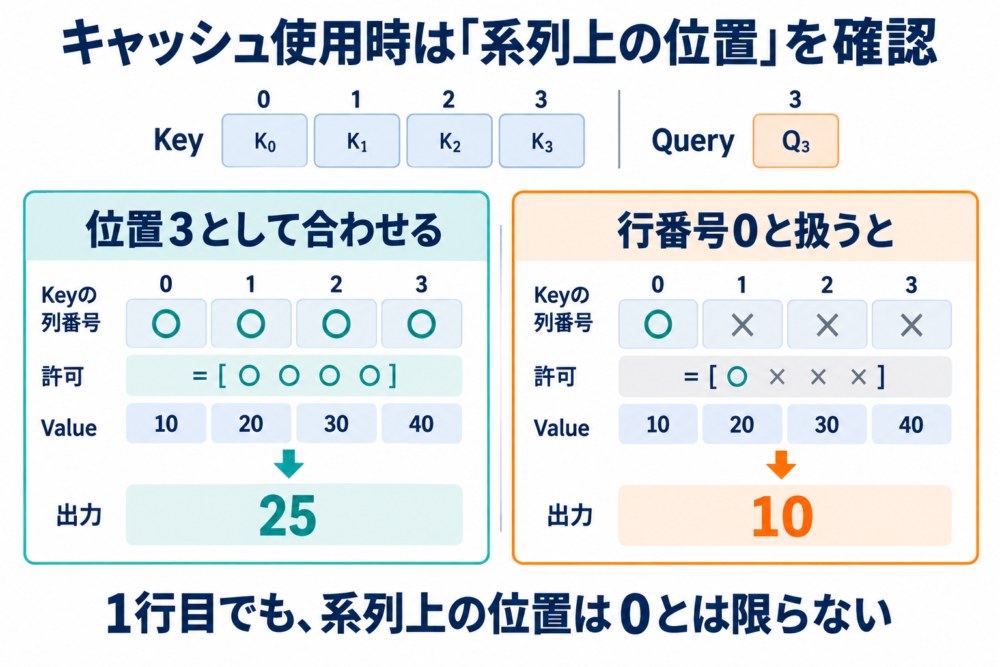
KVキャッシュ(過去のKeyとValueを保存して再利用する仕組み)を使うと、LとSが異なることがあります。たとえば新しいQueryが1つ、キャッシュを含むKeyが4つなら、マスクは1行4列です。
Queryが系列全体の位置3に対応し、Keyが位置0〜3なら、4つとも過去または現在なので許可できます。しかし、この1行を単純に行番号0と扱って左上基準の三角マスクを作ると、列0しか許可されません。
PyTorch 2.14のSDPAでis_causal=Trueを使う場合、非正方形では左上基準の因果配置です。したがって、Queryの行番号と系列上の位置が一致するかを確認する必要があります。出典:SDPAのis_causal仕様
この例では、Keyの位置がQueryの位置以下か、つまりkey_position <= query_positionを基に明示マスクを作れば、許可は[True, True, True, True]です。単純な連続系列ならQuery側へキャッシュ長を足せますが、バッチごとの長さ、PAD、複数トークンの追加を含む場合はそれぞれの位置情報を使います。
独自コードでQとKを0、Valueを[10, 20, 30, 40]にすると、位置を合わせた出力は25、左上基準では10でした。これはマスクの位置を取り違えたときの説明用比較です。利用するライブラリがキャッシュ処理を実装している場合は、その仕様に沿ってください。保存されるデータ自体はKVキャッシュの仕組みで解説しています。
うまく動かないときの確認順
| 症状 | 確認する点 | 修正・検証の方針 |
|---|---|---|
| 未来やPADの変更で出力が変わる | Trueの意味、行と列、合成条件 | allowedとblockedを区別し、見えない位置だけを変更する |
| shapeエラー、またはバッチ間で結果が不自然 | (B, S)をそのままSDPAへ渡していないか | (B, 1, 1, S)としてKey軸を合わせる |
| PADの出力や損失が残る | Key列だけを除外しているか | 出力の集約と教師ラベル側にも有効位置を反映する |
| NaNが出る | 全禁止行、入力値、数値型 | 左paddingや空系列も調べ、少なくとも有効行の参照先を確保する |
| 推論結果が毎回変わる | SDPAのdropout_p | 推論・比較時は0.0にする |
| キャッシュ使用時だけ結果が違う | Queryの絶対位置とKeyの位置 | 長方形の三角形を描き、期待する許可範囲と照合する |
最初は小さな系列で、各行がどのValueを受け取るべきかを手計算しましょう。その後、バッチ数、ヘッド数、系列長を増やすと、意味の間違いと形状の間違いを切り分けられます。
マスクを正しく指定できたら、必要に応じてPyTorchでFlashAttentionの利用と性能を調べる方法へ進めます。マスクを作ることと、高速な実行経路が選ばれることは別に確認する必要があります。
参考資料
- Attention Is All You Need:TransformerのAttentionとDecoderの因果制約。
- PyTorch 2.14:scaled_dot_product_attention:マスクの型、形状、dropout、非正方形の因果配置。
- PyTorch 2.14:MultiheadAttention:attn_maskとkey_padding_maskの意味と形状。
コメント