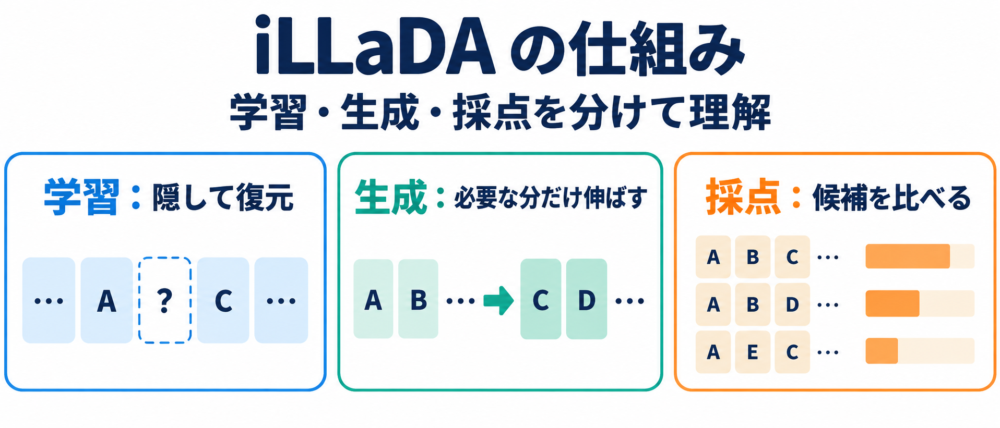
iLLaDAは、文章の空欄を繰り返し埋める拡散言語モデル「LLaDA」の改良モデルです。 変更点を理解するには、学習の仕方、回答を伸ばしていく方法、選択肢を採点する方法を分けて考えると整理できます。
この記事では、マスク(内容を隠す記号)を並べた小さな例で動作を追います。図中の文章と確率は説明用に作ったもので、モデルを実行した結果ではありません。
iLLaDAはどんなモデルか
iLLaDAは2026年6月24日に公開された、8B規模のマスク型拡散言語モデルです。8Bは約80億個のパラメータ(学習で調整する数値)を持つ規模を表します。事前学習済みのBaseと、指示応答向けのInstructがあります。公式リポジトリの公開情報
通常の自己回帰モデルは、既にある文章の続きとして次のトークン(文章を処理する単位)を予測します。マスク型拡散では、見えている部分を手掛かりに複数の空欄を予測し、段階的に文章を完成させます。この基本を詳しく知りたい場合は、拡散言語モデルとは?LLaDA論文で理解する文章生成の仕組みを参照してください。
本記事で見る変更点は次の3つです。
| 観点 | 注目する変更 | 読むときの問い |
|---|---|---|
| 学習 | 指示と回答を含む列にマスクをかける | どこを隠し、何を予測するか |
| 文章生成 | ブロックを必要に応じて追加する | いつ次の枠を用意し、いつ終えるか |
| 選択肢評価 | 候補中の確信度が高い位置から採点する | 何の確率を比べているか |
これらはそれぞれ異なる段階の処理です。たとえば、選択肢の採点方法を変えることと、自由な文章を生成する方法を変えることでは、改善できる対象が違います。原論文:Improved Large Language Diffusion Models
空欄を埋めるとは:予測と確定を分ける
説明のため「猫/が/窓辺/で/眠る」を5枚のカードとして扱います。実際のトークン境界はこの区切りと一致するとは限りません。
全部がマスクの状態から、モデルは各位置に入る候補を計算できます。しかし、候補を一度出しただけでは完成としません。採用する位置を選び、残りを再び予測する材料にします。
たとえば最初に「猫」と「眠る」を残せたら、次の計算は「猫/?/?/?/眠る」を見て行います。間の助詞や場所を考えるときに、左右の情報を参照できます。このように両側を参照できる性質が、双方向Attention(入力同士の関係を左右両方向に計算する仕組み)です。
この説明でいう「確定」は、選んだ生成手順の中でトークンを残すことです。文章の内容が現実に正しいと検証された、という意味ではありません。公式リポジトリの推論とFAQ
学習では何を隠すのか:指示と回答の境界を見る
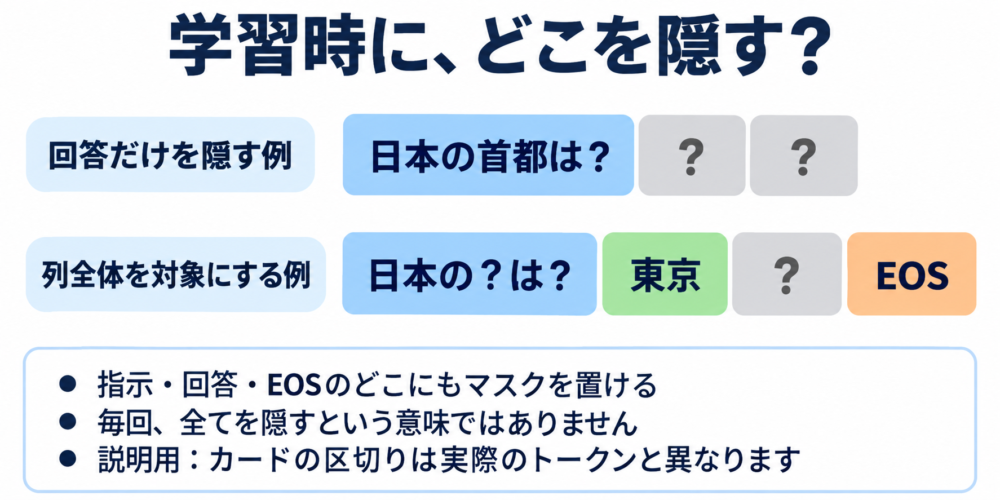
SFT(教師ありファインチューニング)は、指示に応じた回答の例を用いてモデルを調整する工程です。ここでは「日本の首都は?」「東京です」という組を想像してください。
指示を常に見せ、回答だけを隠す学習では、「質問を読んで回答を復元する」例を作れます。一方、指示を含む列全体を隠す対象にすれば、「日本の?は?/東京です」のように、質問側の欠けた語も予測する例ができます。
iLLaDAのSFTでは、指示・回答・末尾のEOS(文章の終了を表す特殊トークン)を含む列にランダムなマスクを適用します。マスクがかかる対象を回答の領域だけに限定しない点が、論文で説明される変更です。原論文 §2.2
ここで「学習時は回答も用意されているのに、実際に質問されたときはどうするのか」と疑問が生じます。学習時は正解の文章を持っているので、隠した位置を復元できたか比較できます。利用時は回答がまだないため、回答用のマスクを用意し、学習済みのモデルで予測します。学習用の正解データと、利用者が入力する質問を分けると、この違いを追いやすくなります。
マスクは学習のたびに違う位置へ置けます。同じ文章でも見える部分が変わるので、復元の問題も変わります。ただし、これだけで繰り返し学習が常に有効だと保証できるわけではなく、効果は評価データで確かめる必要があります。
可変長生成:必要になったら次のブロックを足す
文章を作り始める前に、最終的な回答の長さは分かりません。説明が一言で済むこともあれば、理由を何段階も書くこともあります。
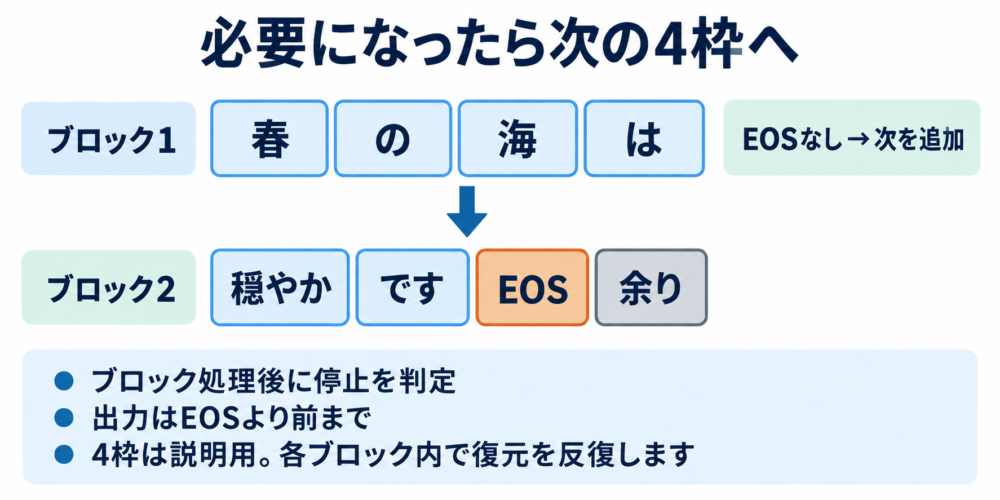
iLLaDAでは、マスクのブロック(一定数の生成枠)を追加して、その中を復元します。ブロックの処理後、EOSなどの停止トークンがあれば終了し、なければ次のブロックへ進みます。最大生成量に達した場合も停止します。原論文 §2.3
4枠ずつ増やす例
説明用に1ブロックを4枠とします。1つ目が「春/の/海/は」、2つ目が「穏やか/です/EOS/余り」になれば、文章として読むのはEOSより前までです。図の「余り」は説明上の表示で、モデルの特殊トークン名ではありません。
最初から長大な空欄列を扱う方法と比べると、短い回答では後続ブロックを作らずに済みます。一方、長い回答ではブロックの追加と復元を何回も繰り返します。
| 設計上の観点 | 小さなブロック | 大きなブロック |
|---|---|---|
| 一緒に予測する範囲 | 狭い範囲を扱う | 広い範囲を扱える |
| 長い回答 | ブロックの追加が多くなる | 追加回数を抑えられる |
| 停止位置の近く | 枠の余りを小さくしやすい | EOS以降に余る枠が増えやすい |
| 選び方 | 応答長と処理回数を見る | 品質と1回の計算量を見る |
この表は処理構造から考えた一般的なトレードオフです。大小どちらが高速・高品質かは、モデル、問題、反復数、実装によって変わります。ブロック内で複数位置を予測できても、ブロック全体を1回の計算だけで完成させるとは限りません。
信頼度スコア:文章を作るときと、選択肢を比べるときの違い
選択式問題では、候補の文章が最初から与えられています。必要なのは未知の回答を自由に作ることではなく、候補同士を比較することです。
iLLaDAのconfidence-based scoring(モデルの確信度を使った採点)では、候補をいったん全てマスクにし、その候補に実際に含まれるトークンの確率を各位置で調べます。最も高い位置を1つ見える状態にして、残りの位置を再び採点します。原論文 §2.3
「候補に含まれる語」の確率を見る
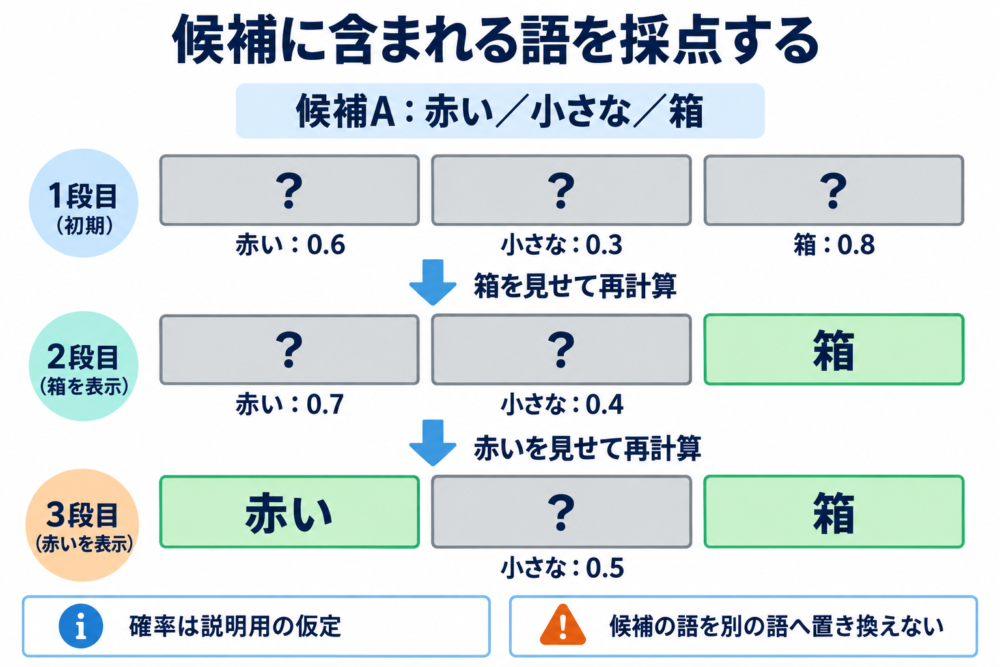
候補Aを「赤い/小さな/箱」としましょう。最初に、それぞれの位置で「赤い」「小さな」「箱」の確率が0.6、0.3、0.8だったと仮定します。
最も高い「箱」を見せると、次は「?/?/箱」を条件に再計算します。ここで「赤い」の確率が0.7になったら、それを見せます。最後に「小さな」の確率が0.5だったとします。
たとえ別の語「青い」の確率が高くても、候補Aを採点中に「赤い」を「青い」へ置き換えません。置き換えると別の候補を評価したことになるためです。
小さな数値でスコアを計算する
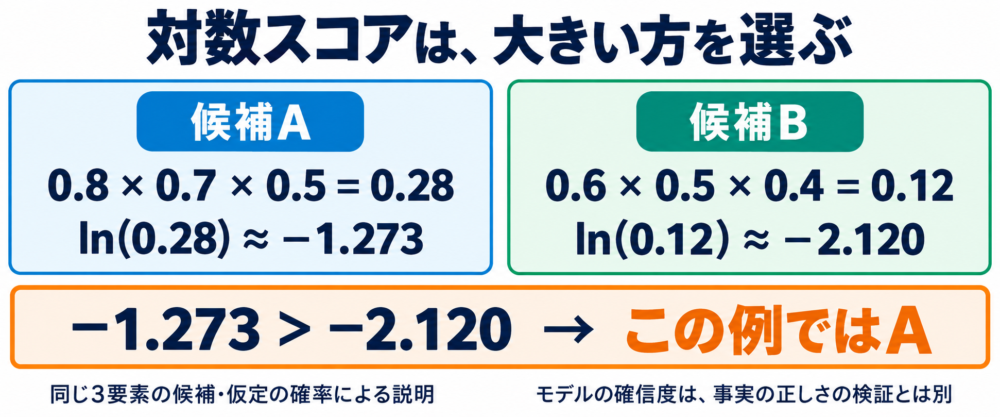
各段階で選んだ確率の自然対数を足します。この例では候補を同じ3要素にそろえ、長さの違いが比較へ入らないようにしています。自然対数は積を足し算へ変えられ、非常に小さな確率の積を扱うときに便利です。
| 説明用の候補 | 順に採用した確率 | 積 | 自然対数の和 |
|---|---|---|---|
| A:赤い/小さな/箱 | 0.8、0.7、0.5 | 0.28 | 約−1.273 |
| B:青い/大きな/箱 | 0.6、0.5、0.4 | 0.12 | 約−2.120 |
この例では、−1.273の方が大きいため候補Aが選ばれます。確率が1未満なら対数は負なので、「絶対値が大きい方」ではなく、数直線上で右にある値を選ぶことに注意してください。
このスコアは候補比較のための指標で、文章全体の尤度(モデルがその文章を生む確率)の推定値とは区別されます。また、モデルが付けた高い確率だけで、現実の箱が赤いと確かめたことにはなりません。確信度と事実確認では、測っているものが異なります。
GQAは何を共有するのか:計算と保存の単位を分ける
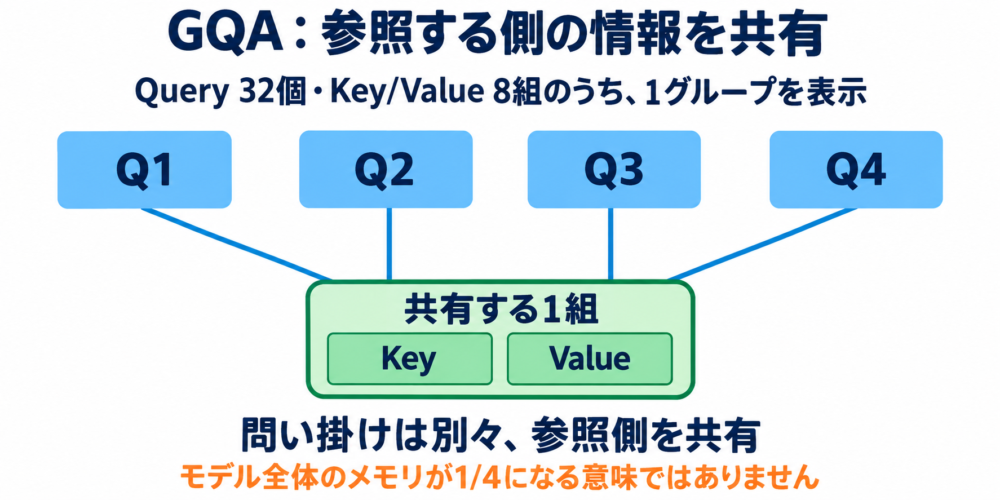
公式Baseモデルカードによると、iLLaDAは事前学習量が12Tトークン、最大系列長が8192です。また、AttentionではQueryが32ヘッド、Key/Valueが8ヘッドというGQA(複数の問い合わせが参照情報を共有する方式)を使います。
Queryは「何を探すか」、Keyは「照合する特徴」、Valueは「参照して取り込む情報」と考えると役割を区別しやすくなります。ヘッドは、それらの関係を並行して計算する系統です。
32個のQueryヘッドに対してKey/Valueが8組なら、4個のQueryが1組のKey/Valueを共有する関係になります。各Queryの問い掛けが同一になるわけではありません。共有するのは参照側の表現です。
同じ長さ・同じヘッド次元でKVを保存する比較なら、KVヘッド数に比例する部分は32組から8組へ減ります。しかし、モデルの重みや途中の計算結果などもメモリを使うので、総使用量まで4分の1になるとは言えません。
さらに、双方向の処理では、空欄が埋まると参照関係も変わります。過去の計算をどこまで再利用できるかは、保存対象と更新タイミングを決める推論実装の問題です。GQAを採用したという情報だけで、自己回帰モデルと同じキャッシュ手順や実行速度を仮定しないようにしましょう。
評価結果は、問題の種類と条件をそろえて読む
以下は公式Instructモデルカードから、性質の異なる3指標に絞って整理したものです。値は報告されたスコアで、高い方が良い指標です。
| 指標と測る課題 | LLaDA 8B | iLLaDA 8B | Qwen2.5 7B |
|---|---|---|---|
| MMLU-Redux:知識理解を問う問題 | 68.9 | 76.4 | 75.7 |
| MATH:数学の問題 | 42.2 | 56.7 | 75.5 |
| HumanEval:コード生成 | 49.4 | 65.9 | 84.8 |
iLLaDAはこの3指標ではLLaDAを上回っていますが、Qwen2.5との関係は指標によって異なります。たとえばMATHの差は56.7−42.2=14.5ポイントです。「14.5%向上」とは意味が異なるため、差を伝えるときは単位も確認します。
この比較から「双方向Attentionだけが改善の原因」とは結論できません。学習量、データの処理、モデル設計、評価手順といった複数の条件が変わっています。原論文も、自己回帰モデルと完全に条件を合わせた比較ではないことを限界として挙げています。原論文 §4
高得点と高速な応答は別に確かめる
品質を見るベンチマークと、待ち時間の計測は別の評価です。たとえば仮に20回の反復で文章を作れたとしても、1反復が長い文章全体を扱うなら、20回という回数だけで高速だとは判断できません。
速度を比べる場合には、同じ機材と精度設定で、入力の長さ、生成した長さ、ブロックサイズ、反復数、同時に処理する件数を記録する必要があります。この記事では推論速度を実測していないため、特定の高速化倍率は示しません。
iLLaDAを読むときの3つの確認点
論文や実装を読むときは、「何を隠して学ぶか」「どの単位で文章を伸ばすか」「何の確率で答えを比べるか」の3点を追うと、処理を混同しにくくなります。
筆者がこの研究で注目するのは、拡散言語モデルを改善する余地が、ネットワーク構造だけでなく、学習例の作り方や生成の止め方、評価方法にもある点です。新しい結果を見る際にも、得点と一緒に、その結果を得た手順を読むことが理解につながります。
参考資料
- Improved Large Language Diffusion Models — 原論文
- iLLaDA-8B-Base — 公式モデルカード
- iLLaDA-8B-Instruct — 公式モデルカード
- ML-GSAI/LLaDA — 公式リポジトリ
資料確認日:2026年9月20日。本文図は説明用に独自作成した概念図です。原論文の図やモデルの実行結果を転載したものではありません。
コメント