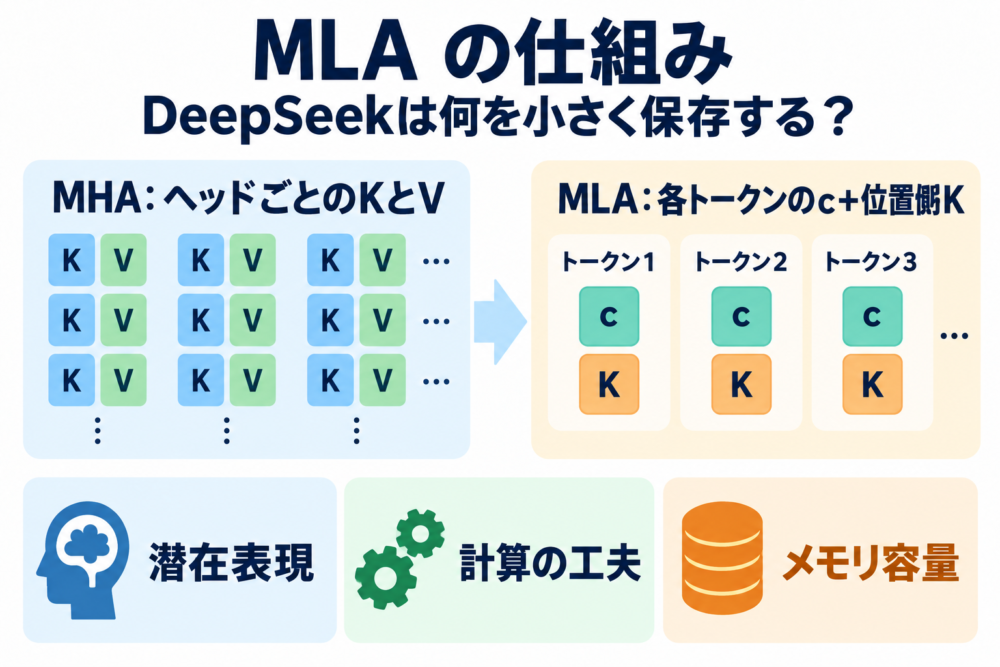
LLM(大規模言語モデル)に長い文章を読ませると、会話の履歴に応じてメモリ使用量が増えます。その一因が、過去の計算結果を保存するKV Cache(キーとバリューのキャッシュ)です。
MLA(Multi-head Latent Attention)は、KとVのもとになる小さな数値列を保存し、キャッシュを抑えるAttention(入力のどこを参照するかを決める処理)の設計です。保存量を減らすだけでなく、その小さな表現から効率よく計算する工夫も含みます。
この記事では、2024年発表のDeepSeek-V2論文を起点に、保存するデータ、計算の順序、位置情報の扱いを図解します。後継モデルの公式実装も補助資料に使いますが、容量の具体例はDeepSeek-V2の設定にそろえます。
KV Cacheには何を保存しているのか
Qは今回の問い合わせ、Kは照合先、Vは取り出す情報
トークン(文章を処理する単位)を1つずつ生成するとき、Attentionは過去のトークンを参照します。そこで使うのが、入力の数値表現から作るQ・K・Vです。
| 記号 | 名前と役割 | 生成時の扱い |
|---|---|---|
| Q | Query。今回どの情報を探すかを表す | 現在処理するトークンについて作る |
| K | Key。Qと照合して参照の重みを決める | 過去の分を再利用する |
| V | Value。重みに応じて取り出す情報 | 過去の分を再利用する |
Qと各Kの内積(対応する数値の積を足す計算)からスコアを求め、Softmax(スコアを合計1の重みに変換する処理)を通します。その重みでVを足し合わせることで、現在の処理に必要な情報を集めます。
一般的な自己回帰生成では、過去のKとVを保存しておけば、次のトークンを生成するときに作り直さずに済みます。一方、保存する履歴は文章の長さに応じて増えます。詳しい生成の流れはKV Cacheとは?LLMの生成を高速化する仕組みで説明しています。
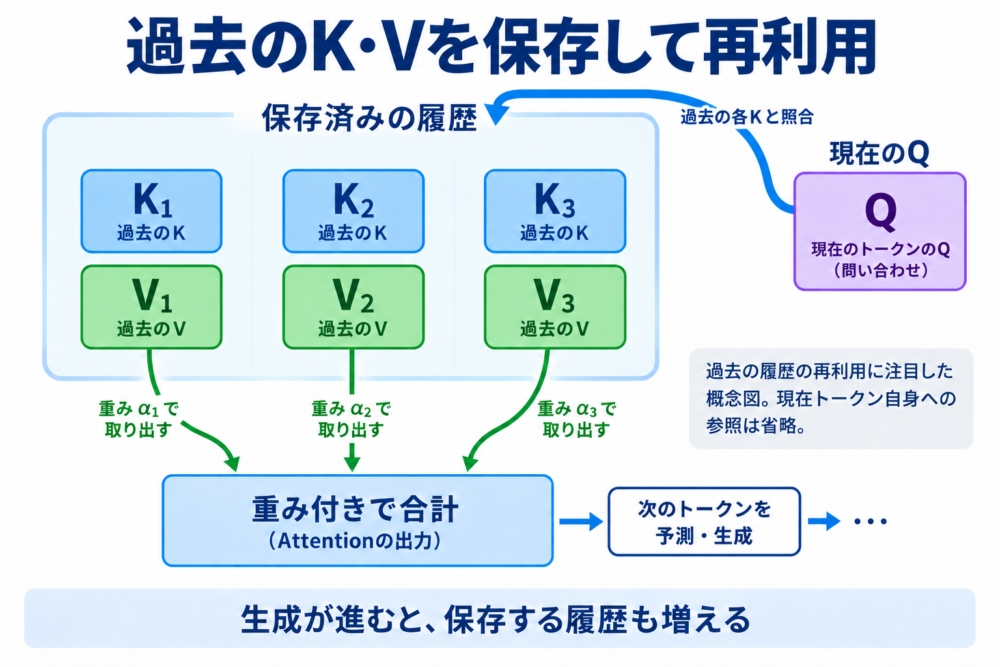
図:仕組みを説明する独自の概念図。
ヘッドごとに保存すると、履歴が大きくなる
MHA(Multi-Head Attention)は、複数のヘッド(異なる観点で情報を参照する計算の組)を使います。各ヘッドが別々のKとVを持つため、ヘッド数、トークン数、層数が増えると保存量も増えます。
MLAが変えるのは、この「過去の各トークンを、どんな数値列として残すか」です。過去のトークンを単純に捨てる方式ではなく、KとVに使う表現を小さくします。
MLAはKとVを共通の潜在表現から作る
潜在表現とは、処理に使う特徴をまとめた内部の数値表現です。MLAでは、ある層に入力されたトークンの表現から、小さなベクトル(数値の列)を作ります。ここではそのベクトルを c と呼びます。
仕組みだけを抜き出すと、次の関係になります。実装上の正規化などは省略しています。
hは入力、Dは次元を減らす変換、UはKやVに必要な表現へ変換する行列です。上付きのCは、後で説明する位置情報の経路と区別するための記号です。
ポイントは、K用とV用に別々の大きな履歴を持つ代わりに、両方のもとになるcを共有することです。各ヘッドは異なる変換を使えるため、cを共有しても、全ヘッドのKやVが同じになるわけではありません。
このように小さな中間表現を挟む設計を、低ランク圧縮と呼びます。「ランク」は、線形変換で表現できる独立な方向の数に関係する用語です。小さな通り道を設け、モデルはその制約の中で必要な表現を学習します。
したがって、既存の任意のモデルに後からZIP圧縮をかけるような機能とは異なります。MLAの構造を前提に学習したモデルと、それを処理する実装が必要です。また、この説明だけで「元のMHAと同じ精度を必ず保つ」とは言えません。モデルの品質は学習や評価条件と合わせて確認します。
出典:DeepSeek-V2 §2.1、DeepSeek公式リポジトリ。
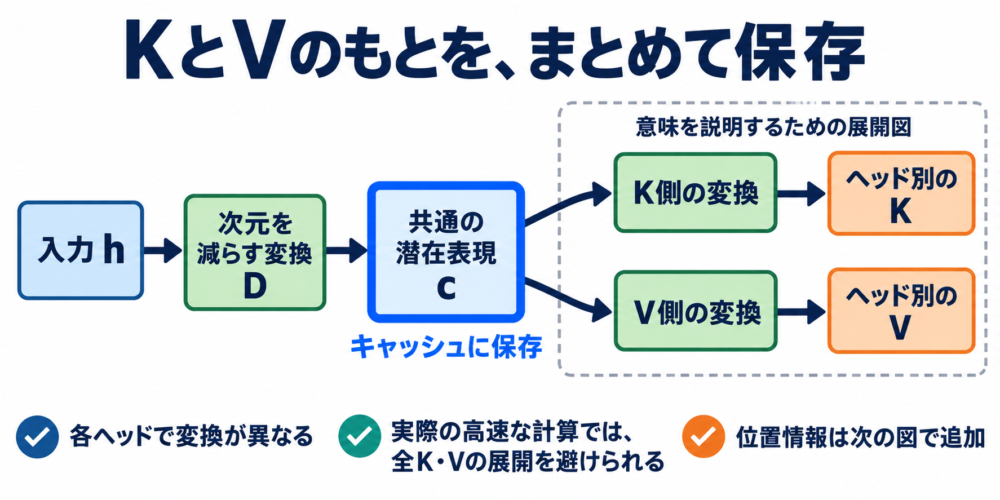
図:仕組みを説明する独自の概念図。
小さく保存しても、毎回すべて展開するなら遅くならないか
K側は、過去の全データを広げる代わりにQを変換する
ここで「過去のcを毎回KとVへ戻すのなら、計算が増えるのでは」と疑問が生まれます。MLAでは、行列計算の順序を変えられることが重要です。
位置情報をいったん省き、1ヘッドのKをk=Ucとします。スコアの内積は次のように書き換えられます。
Tは転置(行と列を入れ替える操作)です。左辺は「cをKに広げてからQと照合」、右辺は「Qを変換してからcと照合」を表します。
右辺なら、現在のQを変換して、保存済みの小さなcを参照できます。過去のすべてのKを大きな形で保持する必要がなくなります。このように変換を別の計算に組み込む考え方を、行列の吸収と呼びます。
説明用に、c=(2,1)、そこから作るk=(2,1,3)、q=(1,2,1)を考えます。変換Uは、cの1番目、2番目、両者の和を出すものとします。
- Kを作る順序:1×2+2×1+1×3=7。
- Qを変換する順序:Uᵀq=(2,3)なので、2×2+3×1=7。
これは計算順序の等価性を確認する小さな例です。実モデルの値や、圧縮による精度を測った結果ではありません。
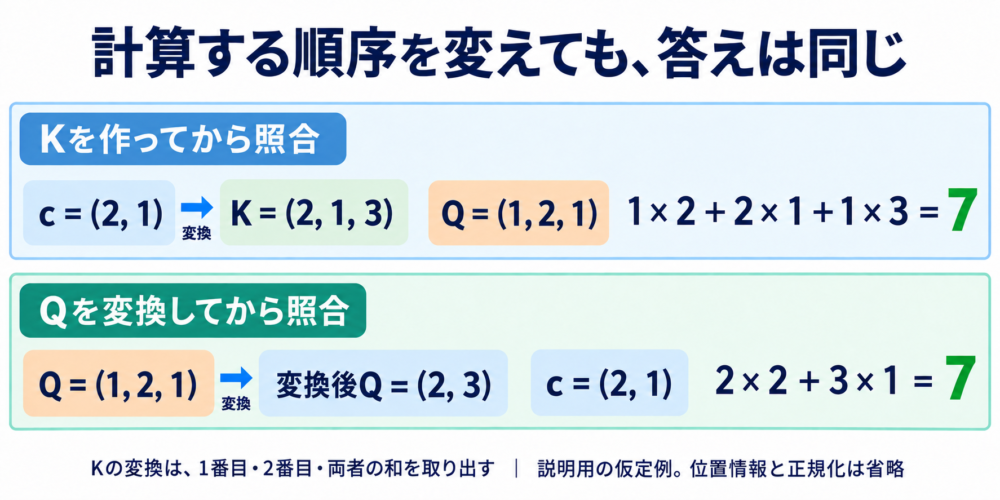
図:説明用の数値例。計算順序を変えても内積は7になる。
V側は、小さな表現の加重和を先に求める
Vにも同じ線形性を利用できます。過去の各トークンを参照する重みをaとすると、次の関係が成り立ちます。
左辺は、各cをVへ変換してから重み付きで足します。右辺は、cのまま足し合わせ、最後に変換します。各トークンの大きなVを先にそろえる処理を避けられるわけです。重みaはヘッドごとに異なるため、加重和もヘッドごとに計算します。
DeepSeek-V3の公式推論実装では、MLAクラスのabsorb経路で、Qの変換、潜在表現とのスコア計算、潜在表現の加重和、V側の変換を確認できます。これは後継モデルの実装による補足です。実際の浮動小数点演算では計算順序による丸め誤差もあるため、数式の等価性とビット単位の一致は区別します。
位置情報は別の経路で持つ:分離したRoPE
単語の並び順を扱うため、Attentionには位置の情報も必要です。RoPE(Rotary Position Embedding)は、QとKの数値の組を位置に応じて回転させ、内積に相対的な位置を反映する方法です。画像を回転させる処理ではありません。
ところが、K全体にそのままRoPEを適用すると、先ほどの行列吸収が難しくなります。位置ごとに変わる回転が計算の間に入り、固定した変換だけにまとめられないためです。行列の掛け算では、掛ける順序を自由に交換できません。
DeepSeek-V2は、内容を照合する経路と、RoPEを適用する追加の経路を分けます。スコアは概念的に次の2つを足して求めます。
この後に次元に応じたスケーリングとSoftmaxが続きます。RはRoPEを適用した部分です。保存するのは、K/V共通の潜在表現cに加えて、位置側のキーkᴿです。位置側のキーはヘッド間で共有します。
「内容側」と呼んでも、cが文章の意味だけを完全に分離した表現になるという意味ではありません。ここでは、明示的にRoPEをかける経路との区別として使っています。
出典:DeepSeek-V2 §2.1.3。位置側のキーを含む保存と2つの内積の加算は、公式V3実装でも確認できます。
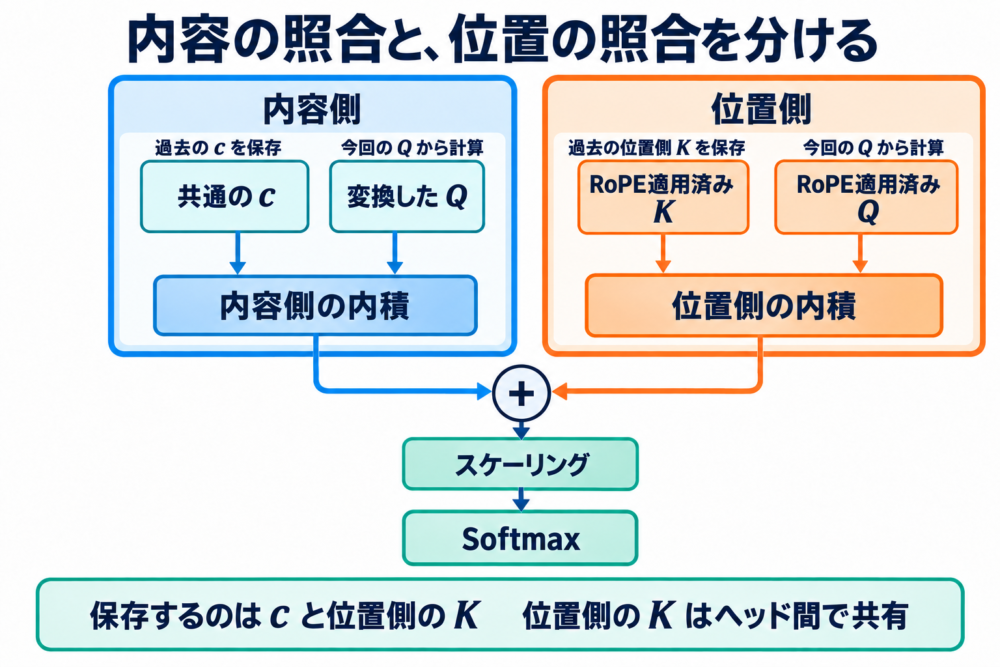
図:仕組みを説明する独自の概念図。
容量を計算する:DeepSeek-V2の設定例
1トークン・1層では「512+64」個の数値
DeepSeek-V2の公式設定ファイルには、潜在表現の次元kv_lora_rankが512、RoPE側の次元qk_rope_head_dimが64、層数num_hidden_layersが60と記載されています。
この設定で圧縮表現を保存する場合、1トークン・1層あたりの要素数は512+64=576です。K用とV用に512を2回数える必要はありません。
キャッシュ本体の概算は、次の式で求められます。
| 記号 | 意味 | 今回の仮定 |
|---|---|---|
| B | 同時に保存する系列数 | 1 |
| T | 各系列に保存するトークン数 | 4,096 |
| L | キャッシュを持つ層数 | 60 |
| d_c | K/V共通の潜在表現の次元 | 512 |
| d_r | 位置側のキーの次元 | 64 |
| s | 1要素のバイト数 | 2(16ビット保存) |
計算すると、1×4,096×60×576×2=283,115,520バイトです。1MiB=1,048,576バイトなので、270MiBになります。
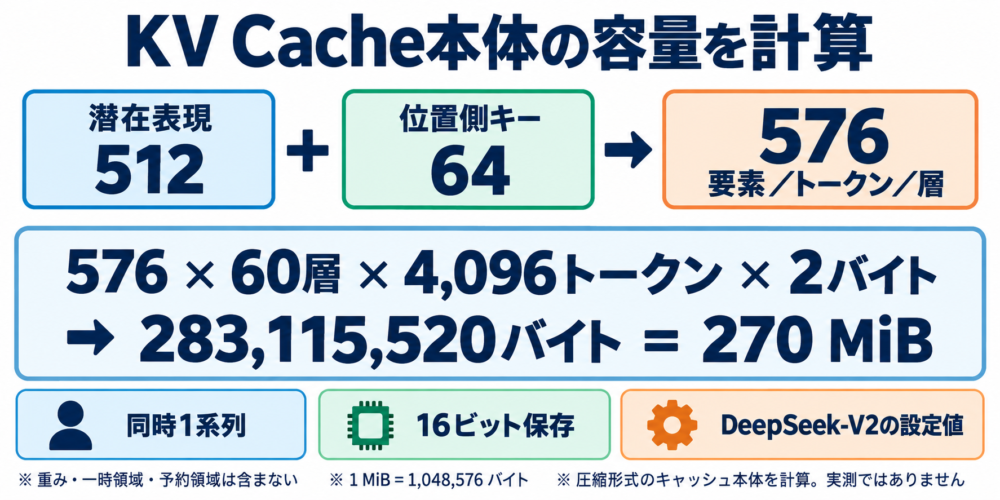
図:DeepSeek-V2の設定を使う計算例。モデル全体の必要メモリや実測値ではない。
長い履歴や複数の会話では増え続ける
| 条件 | キャッシュ本体の計算値 | 変わった点 |
|---|---|---|
| 1系列・4,096トークン | 270MiB | 基準 |
| 1系列・8,192トークン | 540MiB | 履歴を2倍 |
| 4系列・各4,096トークン | 1,080MiB | 同時に保存する系列を4倍 |
これらは設定値からの計算例で、実測値ではありません。重み、一時的な計算領域、メモリの予約、配置の都合による余白、複数GPUでの複製などを含みません。圧縮表現を保持する実装を前提としています。
MLAでも、履歴が伸びるほどキャッシュは増えます。また、270MiBでDeepSeek-V2全体を動かせるという意味でもありません。モデルの重みを保存する領域は別に必要です。
GQA・量子化・FlashAttentionとは何が違うのか
同じ省メモリの話でも、変更する対象が異なります。
| 方式 | 主に変える対象 | 利点 | 確認する条件・トレードオフ |
|---|---|---|---|
| MHA | ヘッドごとにK/Vを持つ基本形 | ヘッドごとに別の表現を使える | KVの保存量が大きくなる |
| GQA / MQA | K/Vを共有するヘッドの範囲 | KVヘッド数を減らせる | 共有の程度と品質は学習・評価条件に依存 |
| MLA | 保存するK/V共通の表現 | 小さな潜在表現を保存できる | 学習済み構造と圧縮形式に対応する実装が必要 |
| KV Cacheの量子化 | 数値1個を保存するビット数 | 要素あたりの容量を減らせる | 表現誤差、変換処理、対応形式を確認する |
| FlashAttention | Attentionの演算順序とメモリ間の読み書き | 中間結果の大きな書き出しを抑える | ハードウェアや対応カーネルによって効果が変わる |
GQA(Grouped-Query Attention)は複数のQヘッドでK/Vを共有し、MQA(Multi-Query Attention)はその共有を1組まで広げます。MLAは、共通の小さな表現からヘッドごとの計算につなぐ点が異なります。
GQAでKとVの次元をどちらもd、KVヘッド数をGとすると、1トークン・1層の要素数は2Gdです。MLAではd_c+d_rです。ただし、これらの式だけで同じ品質になるとは判断できません。GQAの詳しい構成はGQA/MQAとは?KV Cacheを減らすAttention改良で説明しています。
また、MLAと量子化、演算カーネルの最適化は、異なる対象への工夫です。組み合わせられるかどうかは推論エンジンと対応形式を確認します。量子化したモデルの重みを使っていても、KV Cacheまで同じビット数で保存されるとは限りません。
GPU上ではどこに効くのか
GPUで推論する場合、大きなキャッシュは通常、HBMなどのGPUメモリに置かれ、計算に必要な部分を読み出します。HBMは大容量・高帯域のメモリ、SRAMはGPU内部で使う小さく高速なメモリです。
MLAに対応する処理が小さなキャッシュを利用できれば、保存量に加えて、読み出すデータ量を抑えられる可能性があります。特に、生成中に過去の履歴を繰り返し参照する場面で意味があります。ただし、実際の転送量はデータの再利用やカーネル(GPU上で実行する計算処理)の設計にも依存します。
CPUは実行やデータの準備を制御し、GPU側ではメモリから読み出した数値を演算に使います。MLAにしたからキャッシュ全体がSRAMへ移る、という理解は適切ではありません。メモリの配置と転送の基礎はAIのデータ経路を解説した記事も参考になります。
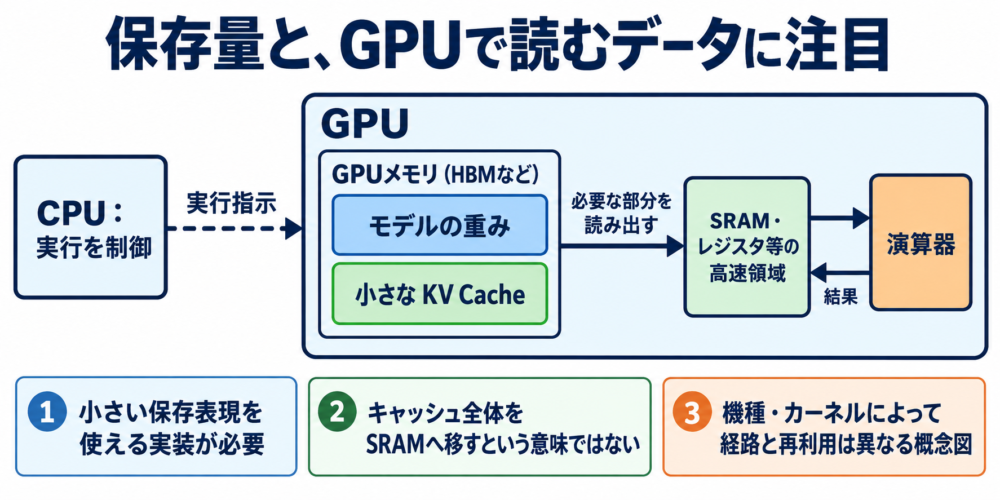
図:仕組みを説明する独自の概念図。
「キャッシュを減らせた」と「その割合だけ速い」は別の評価
DeepSeek-V2論文は、DeepSeek 67Bとの比較でKV Cacheの93.3%削減を報告しています。この数字は特定モデル間の比較結果です。手元のGPUの総使用メモリが93.3%減る、あるいは生成速度が同じ比率で改善することを保証するものではありません。
実際の効果を判断するときは、次の条件をそろえます。
- 保存形式:推論エンジンが圧縮した潜在表現を保持しているか。
- 処理する長さ:入力・出力のトークン数と同時処理する系列数。
- 数値形式:重みとKV Cacheそれぞれの保存精度。
- 測定対象:入力処理、最初の応答までの時間、生成中の速度のどれを見るか。
- GPUと実装:対応する演算処理が使われ、別の部分が律速になっていないか。
公式V3実装にも、展開したK/Vを保存するnaiveと、圧縮表現を保存するabsorbの分岐があります。「MLAというモデル構造を持つこと」と「その省メモリ性を実行時に活かしていること」は、分けて確かめる必要があります。
MLAを理解するときに押さえたいこと
MLAの中心は、KとVに共通する小さな表現を保存し、計算順序の工夫によってそれを利用する点です。さらに、位置情報を別のキーとして持つことで、RoPEと効率のよい計算を両立させます。
仕組みを読むときは「何を保存するか」、容量を比べるときは「層数・履歴・精度」、性能を評価するときは「どの実装で何を測ったか」を確認すると、論文の数字と実際の利用条件を結び付けやすくなります。
参考資料
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- DeepSeek-V2公式リポジトリ
- DeepSeek-V2公式設定ファイル
- DeepSeek-V3公式推論実装
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
本文の数値例は説明用の計算であり、実測結果ではありません。図は仕組みを説明するための独自の概念図です。資料確認日:2026年9月20日。
コメント