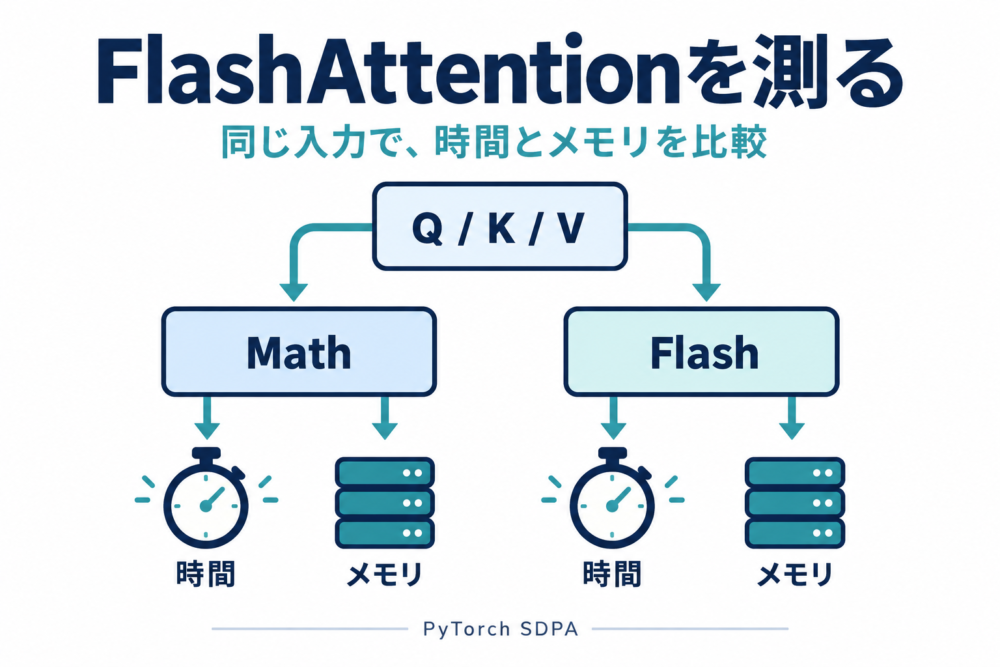
FlashAttentionの効果を調べるには、同じ入力を使って計算方式だけを切り替え、処理時間と追加のピークメモリを別々に測ります。 PyTorchではSDPA(スケーリング付き内積Attentionを計算する機能)の実行方式を固定できるため、標準のMathとFlashを比較できます。 結果を読むときは、系列長・数値形式・GPU・推論か学習かをそろえ、非対応やメモリ不足を速度の数値に混ぜないことが大切です。
この記事は測定手順とコードの解説です。掲載コードは構文と設計を確認していますが、FlashAttention対応GPUでの実行検証は未実施で、実測の速度表は掲載していません。 手元の環境はGTX 1060 3GBで、今回の比較を実施できませんでした。対応環境で実行する際も、小さい入力から動作と出力を確認してください。
仕組みを先に知りたい方は、FlashAttentionの原理解説を参照してください。ここでは、測定結果を残せる形にすることへ進みます。
最初は、Attention一回のforwardに範囲を絞る
forward(入力から出力を計算する処理)だけを、torch.inference_mode()で測ります。モデルの重み、文章の前処理、学習の勾配計算は含めません。入力はQ・K・V(問い合わせ・照合対象・集約する値を表す配列)です。
| 項目 | この記事の条件 | そろえる理由 |
|---|---|---|
| 比較する実行方式 | MATHとFLASH_ATTENTION |
自動選択の結果と混同しない |
| 入力形状 | B=1、H=8、N=512/1024/2048、D=64 | 系列長Nだけを変える |
| 数値形式 | FP16(16ビット浮動小数点) | 数値形式による差を混ぜない |
| マスク | QとKが同じ長さのcausal | 未来の位置を参照しない条件を一致させる |
| dropout | 0.0 | ランダムな除外処理を入れない |
| 実行範囲 | 推論時のforwardのみ | 学習時の追加計算・保存量と区別する |
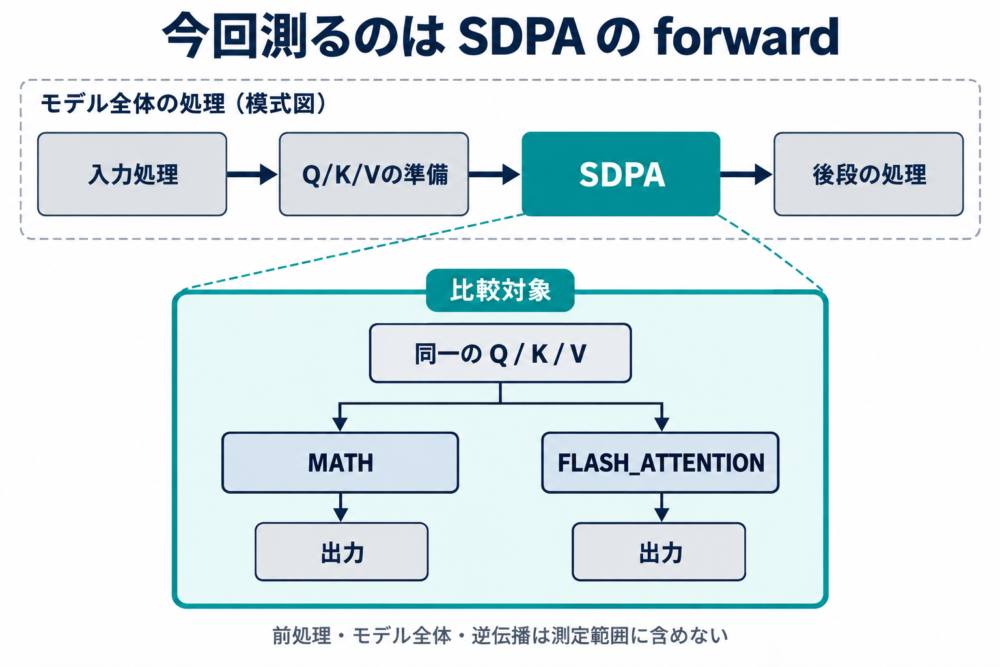
*AI生成の概念図。今回の測定対象はSDPAのforwardです。*
Bはバッチ数、HはAttentionのヘッド数、Nは系列長、Dはヘッド内の次元数です。同じNの比較では、生成済みの同一Q/K/Vを両方式へ渡します。
PyTorchのsdpa_kernelでFlashだけを許可すれば、非対応時に別方式へ黙って切り替わった結果をFlashの速度として記録することを避けられます。対応条件はGPU・PyTorchのビルド・入力に依存するので、警告やエラーも残します。
この記事はPyTorch内蔵SDPAを使い、外部のflash-attnパッケージは導入しません。外部パッケージの対応情報はDao-AILabのREADMEにありますが、それをそのままPyTorch内蔵方式の動作保証にはできません。
時間とメモリは別の区間で測る
GPUの処理完了を待ってから時間を読む
CUDA(NVIDIA GPUで計算する仕組み)の処理は、CPUからの呼び出しに対して非同期に進みます。Python関数を呼ぶ前後の時計だけを見ると、GPUへ仕事を渡す時間を測ってしまう場合があります。
ここでは、準備運転のwarm-upを10回行い、CUDA Event(GPUの処理列に記録する時刻の目印)で20回分の実行区間を測ります。終了Eventの完了を待ってから20で割り、これを5区間繰り返した中央値を記録します。PyTorchのCUDA解説でも、正しい計時には同期やEventが必要だと説明されています。
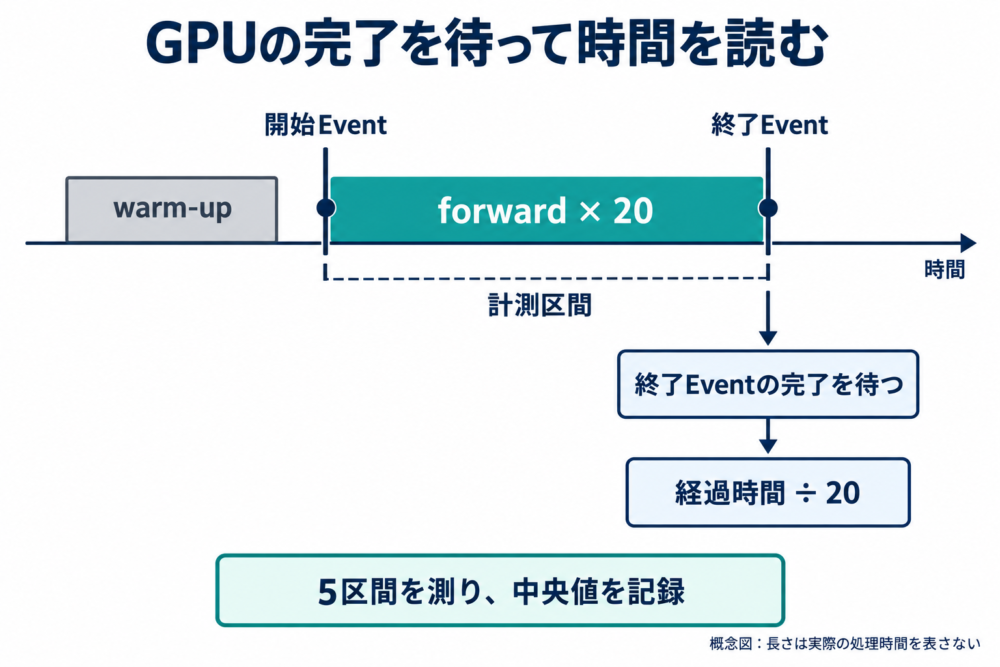
*AI生成の概念図。warm-upを除き、終了Eventを待って時間を読み取ります。*
得られる値は、繰り返したforwardの一回当たり時間です。短い演算ではCPUからの投入の間隔も区間に影響するため、純粋なGPUカーネル一個の実行時間とは区別します。詳しい内訳が必要なら、次の段階でプロファイラー(処理別の時間を調べる道具)を使います。
メモリは、Q/K/Vを置いた後を基準にする
メモリ測定では、入力を用意してwarm-upを終えた時点のmemory_allocated()を基準値にします。ピーク記録をリセットして一回だけforwardを実行し、max_memory_allocated()から基準値を引きます。
追加ピーク = forward中の最大割当量 − forward直前の割当量
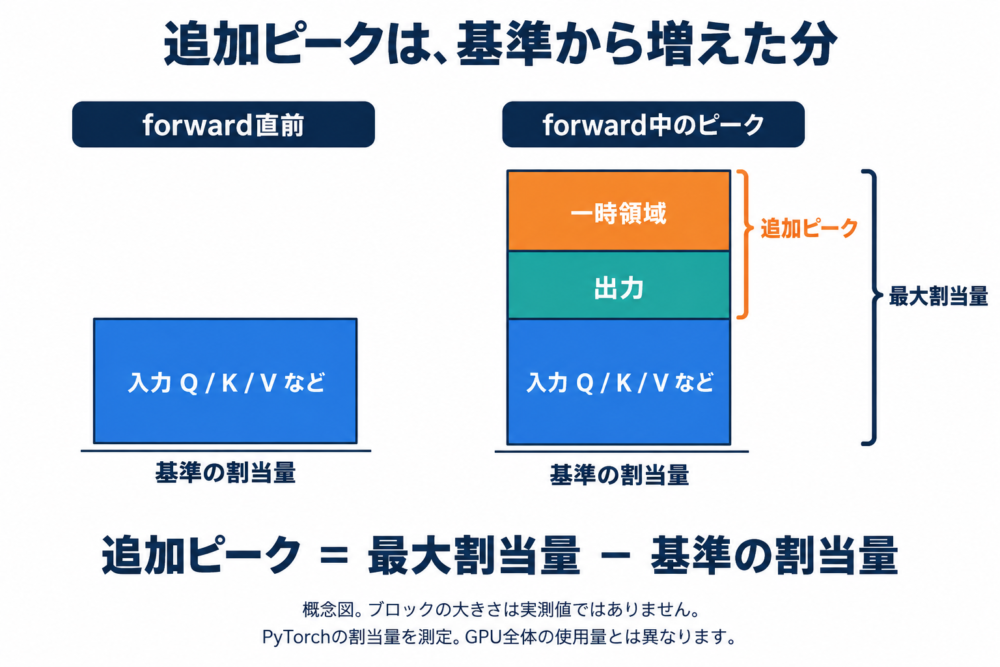
*AI生成の概念図。各領域の面積は実測のメモリ量を表しません。*
この差には出力テンソルと一時的な計算領域が含まれ、既に確保してある入力は差分から除かれます。MathではFP16入力でも中間値をfloatで保持するため、両方式の差にはその実装上の条件も含まれます。PyTorchの割当管理で把握する範囲なので、GPU全体の使用量でも、Attentionの中間行列だけの大きさでもありません。
memory_reserved()はキャッシュを含む管理領域で、nvidia-smiも別の観点の値です。まずは同じ指標で比較します。定義は最大割当量のAPIとCUDAのメモリ管理を確認してください。
前の出力を変数に残したまま次のforwardを実行すると、出力が二つ同時に存在する区間を作ってしまいます。コードでは各回の出力を解放し、正しさ確認用の参照出力も、両方式の計測が終わってから作ります。
測定コードを保存して実行する
CUDAを使えるPyTorch環境を前提にします。インストール方法はOSとGPU環境に合わせてPyTorch公式の導入案内で選び、使用した版を記録してください。以下をbenchmark.pyとして保存します。入力を大きく変更する前に、既定のN=512でエラーが出ないか確認します。
"""Compare two SDPA forward backends on the same CUDA tensors.

Run: python benchmark.py > results.jsonl
This example has not been executed on a Flash-capable GPU by the author.
"""
from __future__ import annotations

import json
import logging
import statistics
import sys

try:
    import torch
    import torch.nn.functional as F
    from torch.nn.attention import SDPBackend, sdpa_kernel
except ImportError:
    print('ERROR: Install a CUDA-enabled PyTorch with torch.nn.attention.sdpa_kernel.', file=sys.stderr)
    raise SystemExit(2)

logging.basicConfig(level=logging.INFO, format='%(levelname)s %(message)s')
LOGGER = logging.getLogger(__name__)
BACKENDS = {'math': SDPBackend.MATH, 'flash': SDPBackend.FLASH_ATTENTION}


def emit(row: dict[str, object]) -> None:
    """Write one record. Args: row, JSON-compatible fields. Returns: None.

    Raises: TypeError for non-JSON values. Example: emit({'status': 'ok'}).
    """
    print(json.dumps(row, ensure_ascii=False), flush=True)


def forward(q: torch.Tensor, k: torch.Tensor, v: torch.Tensor) -> torch.Tensor:
    """Evaluate square causal attention. Args: q/k/v, CUDA B,H,N,D tensors.

    Returns: output tensor. Raises: RuntimeError for unsupported inputs.
    Example: output = forward(q, k, v).
    """
    # Explicit dropout avoids changing the operation between comparisons.
    return F.scaled_dot_product_attention(q, k, v, dropout_p=0.0, is_causal=True)


def measure(name: str, q: torch.Tensor, k: torch.Tensor, v: torch.Tensor) -> dict[str, object]:
    """Measure a warmed forward. Args: backend name and identical input tensors.

    Returns: latency and allocator statistics. Raises: RuntimeError/OOM.
    Example: row = measure('math', q, k, v).
    """
    with sdpa_kernel([BACKENDS[name]]):
        for _ in range(10):
            out = forward(q, k, v)
            del out  # Do not keep an earlier result alive during the next call.
        torch.cuda.synchronize()
        samples: list[float] = []
        start = torch.cuda.Event(enable_timing=True)
        end = torch.cuda.Event(enable_timing=True)
        for _ in range(5):
            start.record()
            for _ in range(20):
                out = forward(q, k, v)
                del out
            end.record()
            end.synchronize()
            samples.append(start.elapsed_time(end) / 20)

        # Measure memory separately so reference outputs cannot inflate the baseline.
        torch.cuda.synchronize()
        baseline = torch.cuda.memory_allocated()
        torch.cuda.reset_peak_memory_stats()
        out = forward(q, k, v)
        torch.cuda.synchronize()
        peak = torch.cuda.max_memory_allocated()
        del out

    return {
        'backend': name, 'status': 'ok',
        'median_ms': statistics.median(samples),
        'min_ms': min(samples), 'max_ms': max(samples),
        'baseline_MiB': baseline / 2**20,
        'peak_allocated_MiB': peak / 2**20,
        'extra_peak_MiB': (peak - baseline) / 2**20,
    }


@torch.inference_mode()
def run_case(n: int) -> None:
    """Compare one sequence length. Args: n, positive sequence length.

    Returns: None; writes JSON lines. Raises: RuntimeError on input allocation.
    Example: run_case(512).
    """
    shape = (1, 8, n, 64)
    q, k, v = [torch.randn(shape, device='cuda', dtype=torch.float16) for _ in range(3)]
    ok: set[str] = set()
    for name in BACKENDS:
        LOGGER.info('N=%d backend=%s', n, name)
        try:
            row = measure(name, q, k, v)
            ok.add(name)
        except torch.cuda.OutOfMemoryError as error:
            row = {'backend': name, 'status': 'oom', 'reason': str(error)}
        except RuntimeError as error:
            # Report the real error: not every RuntimeError means unsupported hardware.
            row = {'backend': name, 'status': 'error', 'reason': str(error)}
        emit({'kind': 'measurement', 'N': n, **row})
        torch.cuda.empty_cache()  # Only between backends, never inside the timed section.

    if ok == set(BACKENDS):
        try:
            # Accuracy checks follow both measurements to avoid retaining a reference tensor.
            with sdpa_kernel([SDPBackend.MATH]):
                reference = forward(q, k, v)
            with sdpa_kernel([SDPBackend.FLASH_ATTENTION]):
                actual = forward(q, k, v)
            diff = (actual.float() - reference.float()).abs()
            finite = bool(torch.isfinite(reference).all() & torch.isfinite(actual).all())
            emit({'kind': 'output_check', 'N': n,
                  'finite': finite,
                  'max_abs_diff': diff.max().item() if finite else None,
                  'mean_abs_diff': diff.mean().item() if finite else None})
        except RuntimeError as error:
            emit({'kind': 'output_check', 'N': n, 'status': 'error', 'reason': str(error)})


def main() -> int:
    """Run the example. Args: none. Returns: 0, or 2 without CUDA.

    Raises: unexpected non-RuntimeError failures. Example: raise SystemExit(main()).
    """
    if not torch.cuda.is_available():
        LOGGER.error('CUDA is unavailable; no performance measurements were made.')
        return 2
    torch.manual_seed(1234)
    emit({'kind': 'environment', 'torch': torch.__version__,
          'cuda_runtime': torch.version.cuda, 'gpu': torch.cuda.get_device_name(0),
          'capability': torch.cuda.get_device_capability(0),
          'B': 1, 'H': 8, 'D': 64, 'dtype': 'float16', 'causal': True,
          'dropout': 0.0, 'mode': 'inference_forward', 'warmup': 10,
          'repeats_per_interval': 20, 'intervals': 5})
    for n in (512, 1024, 2048):
        try:
            run_case(n)
        except RuntimeError as error:
            emit({'kind': 'case', 'N': n, 'status': 'error', 'reason': str(error)})
        torch.cuda.empty_cache()
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
実行すると、環境情報と各条件の記録をJSONL(1行ごとに独立したJSONを保存する形式)で出力します。進捗ログとPyTorchの警告は標準エラー出力へ残します。
python benchmark.py > results.jsonl 2> benchmark.logNVIDIAのドライバー版は、同じ環境のnvidia-smiでも記録します。その表示のCUDA Versionはドライバー側の対応情報で、コードが出すtorch.version.cudaのビルド情報とは分けて扱ってください。
出力のどこを比較するか
| 出力項目 | 読み方 | 注意点 |
|---|---|---|
median_ms |
5区間の一回当たり平均時間の中央値 | 全forward個別の中央値ではない |
min_ms / max_ms |
同じ5区間の平均時間の最小・最大 | ばらつきが大きければ負荷や温度も確認 |
extra_peak_MiB |
基準から増えた最大割当量 | MiBは1024×1024バイト。出力も含む |
peak_allocated_MiB |
測定区間の割当量ピーク | 入力などの基準値を含む |
max_abs_diff / mean_abs_diff |
Math出力とFlash出力の絶対差 | Mathを数学的な真値とはみなさない |
finite |
両出力にNaNや無限大がないか | trueだけでは正しさや品質を保証しない |
速度比は、同じNのMathの時間÷Flashの時間で計算します。両方がstatus: okの行だけを使い、エラーの行へ0ミリ秒を入れないようにします。status: oomはGPUメモリ不足、status: errorは理由を確認すべき実行エラーです。後者はGPU非対応に限らず、入力や環境の不一致も含みます。
コードの終了コードが0でも、全条件の成功を意味しません。非有限値があると差の欄はnullになるため、速度比の採用前に確認します。個々のstatusとoutput_checkを読み、出力差の確認に失敗した条件を採用しないでください。CUDAが使えない場合や必要なPyTorch機能を読み込めない場合は、測定せず終了コード2で止まります。
融合された演算では計算の順序が変わり、出力がビット単位で一致するとは限りません。SDPAの公式仕様を踏まえ、絶対差を記録したうえで、実際のモデルで許容できる誤差や品質を別途確認します。この例のランダム入力で差が小さくても、文章生成の品質検査の代わりにはなりません。
条件を広げるときの順番
まず系列長Nだけを変え、時間と追加ピークがどう動くかを見ます。その後にバッチ数、ヘッド数、ヘッド次元、数値形式を一つずつ変えます。条件を変えた記録は、環境情報のB/H/D/dtypeも合わせて更新してください。
| 変更するもの | 確認したいこと | 混同しやすい点 |
|---|---|---|
| 系列長 | 長い入力で時間・メモリ差が広がるか | 長くすれば必ず一定倍率になるとは限らない |
| バッチ数・ヘッド数 | 並列に処理する量による変化 | 総入力サイズも増える |
| 数値形式 | 対応可否、時間、誤差の変化 | 形式変更と方式変更を同時に比較しない |
| 実行順 | Math先行・Flash先行で傾向が変わらないか | 温度やクロック、他処理の影響 |
学習を調べるなら、逆伝播も含む別の測定を用意します。入力の勾配や保存される中間値が増えるため、この記事のforwardだけのメモリ値を学習時の必要量として使うことはできません。実モデルの生成速度を知りたい場合も、モデル全体の処理を別に計測します。
一文字ずつの生成へ、そのまま流用しない
decode(過去の情報を参照して次のトークンを生成する段階)では、Qの長さが1、K/Vが過去を含む長さになることがあります。この記事の正方形入力を単にQ=1へ変え、is_causal=Trueのまま測ると、意図と違うマスクになるおそれがあります。
PyTorch SDPAの非正方形causalは左上揃えです。Qの長さ1、Kの長さ4なら、左上の三角形として許されるのは先頭の位置になります。K/Vの4位置がすべて「現在までの有効な履歴」なら、最後のQが参照してほしい範囲とは一致しません。paddingや未来の位置を含むかによって必要なマスクが変わるため、decodeの意味を決めてから実装してください。SDPAのis_causal仕様
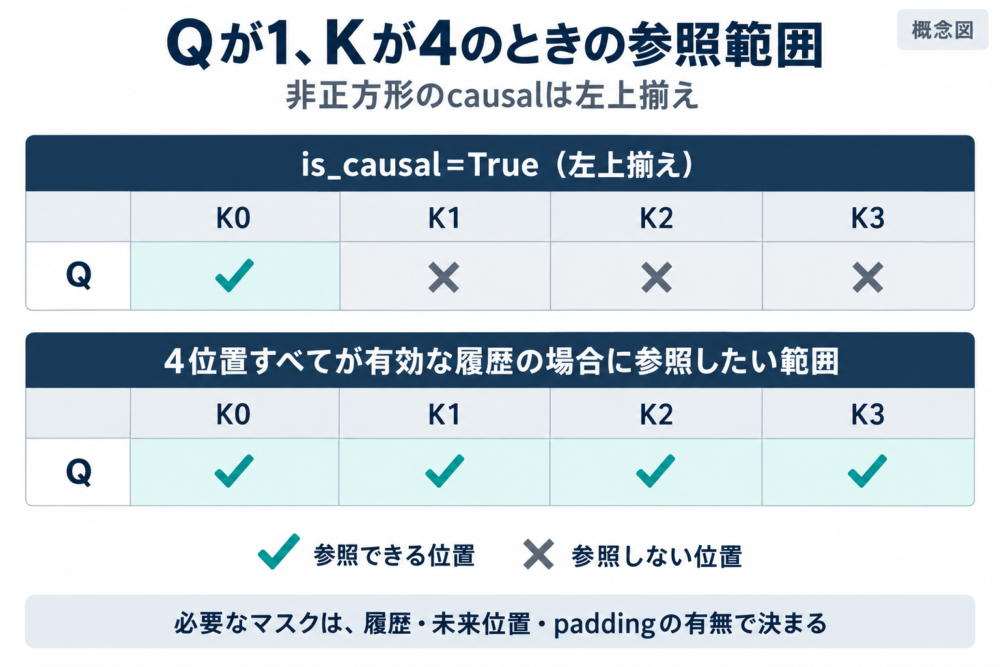
*AI生成の概念図。下段は4位置すべてが有効な履歴である場合の例です。*
自分の用途に近い条件で両方式が動き、時間・追加ピーク・出力差を確認できたら、実モデルで比較する段階へ進めます。測定対象と条件を残しておくと、PyTorchやGPUを変えたときも同じ基準で見直せます。
コメント