CodexでGPT-6 Astraを使うには、モデル一覧からAstraを選ぶか、CLI(コマンドラインで操作するツール)でcodex --model gpt-6-astraを指定します。ただし、モデル名を入力するだけで利用権が付くわけではなく、アカウントや利用環境で提供されている必要があります。
Astraを選ぶ目安は、複数のファイルやアプリをまたぎ、途中の判断が多い仕事かどうかです。日常的な開発ではGPT-6.1 Solも有力な選択肢になり、仕事内容に合わせて選び分けられます。
この記事では、2026年10月13日時点の公式情報を基に、モデルの使い分け、設定方法、利用できない場合の確認先を整理します。旧版で比較対象にしていたGPT-5.6 Solから、現在のGPT-6.1 Solを中心とした説明へ更新しました。
AstraとSolはどう使い分ける?
OpenAIは、Astraを難しい推論、コーディング、アプリを使う作業、調査などに向くモデルとして説明しています。一方、Codexのモデルガイドでは、GPT-6.1 Solを複雑な開発・エージェント作業の推奨モデルに挙げ、Astraに近い性能をより低いコストで提供すると説明しています。これは公式の位置付けであり、以下の表は筆者の速度・正答率の実測ではありません。Codex Models
| モデル | 選ぶ目安 | 比較時に見る点 |
|---|---|---|
| GPT-6 Astra | 難しい原因調査、複数の領域をまたぐ修正、途中で方針を判断する長い仕事 | 結果の質が、待ち時間や利用量に見合うか |
| GPT-6.1 Sol | 実装、レビュー、調査を含む普段の開発 | 必要な品質を満たしながら、作業を回しやすいか |
| GPT-6 Luna | 範囲の狭い修正、繰り返す定型作業 | 指示した範囲を正しく処理できるか。難しい判断が残らないか |
たとえば、「原因が分かっている1か所の修正」と「再現条件を調べ、複数ファイルを修正し、回帰を確認する仕事」では必要な判断が違います。前者はSolやLunaから試し、後者で調査や整合性の確認が不足するならAstraを比較する、という選び方ができます。
旧GPT-5.6 Solを使ってきた場合も、モデル名の新旧だけで一律に置き換えるより、同じ入力と完了条件で結果を比べる方が判断しやすくなります。利用できるモデルは、使っているクライアントの一覧で確認してください。
CodexでAstraを選択する方法
アプリ・Web・IDE拡張ではモデル一覧から選ぶ
Codexの入力欄付近にあるモデル選択で、GPT-6 Astraを選びます。IDE(統合開発環境)の拡張機能などでは、表示位置や選択肢がクライアントによって異なる場合があります。選択後は、モデル名と推論設定を確認してから依頼を送ります。Codex Models
一覧にAstraが出ない場合は、後述の「Astraが選べないとき」を確認してください。API(アプリケーション間の通信規約)向けのモデルページに名前が載っていても、同じモデルがすべてのCodexアカウントに表示されるとは限りません。
CLIでは起動時にモデル名を指定する
新しいセッションをAstraで始める例です。
# 起動時にモデルを明示し、既定モデルとの取り違えを避ける
codex --model gpt-6-astra起動済みの対話セッションでは、/modelからモデルと推論設定を選べます。変更したら、画面に表示された選択結果を確認します。Codex Models
既定モデルはconfig.tomlに指定する
毎回Astraで始めたい場合は、ユーザー設定の~/.codex/config.tomlに記述できます。~はユーザーのホームディレクトリを表します。
# Astraの公式推奨に合わせ、まず軽い推論設定から評価する
model = "gpt-6-astra"
model_reasoning_effort = "low"
これは必要な設定部分だけの例です。既存ファイルがある場合は、ほかの設定を消さずに該当項目を編集してください。同じキーを重複して追加しないようにします。
Codexにはユーザー設定以外にも、プロジェクト設定や起動時の指定があります。CLIの明示指定など、より優先される設定があれば、ユーザー設定と異なるモデルで動く場合があります。設定を書いた後も、実際に選ばれたモデルを確認することが大切です。Basic configuration
推論強度はLightから試し、足りないときに上げる
推論強度は、回答や作業にどれだけ推論を使うかを調整する設定です。公式ガイドは、AstraではLightから始めることを勧めています。設定ファイルで対応する値はlowです。Codex Models
複雑そうな仕事でも、最初から最大設定を選ぶ必要はありません。判断の抜けや制約の取り違えが残るかを見て、必要なら強度を上げます。逆に、入力資料が不足している場合は、推論強度を上げる前に資料や完了条件を補う方が問題の解消につながります。
| 設定・モード | 主な役割 | 選ぶときの注意 |
|---|---|---|
| Light / Low | Astraを試す開始点 | 求めた品質を満たせるか確認する |
| Medium、High、Extra High | 1つの仕事に使う推論を増やす | 待ち時間や利用量との釣り合いを見る |
| Max | 1つの仕事をさらに深く検討する | 単純な修正でも常に必要とは限らない |
| Ultra | サブエージェントに仕事を分け、並行して進める | 分割できる仕事か、クライアントで利用可能かを確認する |
Ultraは、単にMaxより上のAPI設定値という関係ではありません。Codex側の作業モードとAPIのパラメーターを混同しないようにしてください。APIのAstraモデルページで示される推論値はlow、medium、high、xhigh、maxです。GPT-6 Astra model
表示される強度やモードは、モデル、クライアント、利用条件によって異なります。一覧にない値を設定ファイルへ書けば使える、というものではありません。
利用量と料金は、ログイン方法を分けて確認する
CodexのChatGPTログインによる利用と、APIキーによる利用では、確認する利用枠と課金先が異なります。APIのトークン単価から「自分のプランで何回実行できるか」を計算することはできません。Codex Pricing
| 利用方法 | 確認するもの | 見積もる際の注意 |
|---|---|---|
| ChatGPTアカウントでログイン | アカウントのプラン、利用量表示、モデルの提供状況 | 1回の依頼で使う量は、モデルや仕事の大きさによって変わる |
| APIキーで利用 | APIプロジェクトのモデル権限、料金、使用量 | サブスクリプションに含まれる利用と別に確認する |
利用量を比べるなら、モデルだけでなく入力資料、依頼内容、推論設定も記録します。「短い修正を1件」と「リポジトリ全体の調査を1件」を同じ1回として比べると、モデルによる違いを判断できません。
契約変更や実行前の判断には、公式料金ページと自分のアカウントに表示される条件を使ってください。
Astraが選べないときの確認手順
利用できない場合は、モデル名を繰り返し指定する前に、どの認証経路とクライアントで使おうとしているかを整理します。ChatGPTログイン、APIキー、ワークスペースの管理者設定は、それぞれ確認する境界が異なります。Workspace model availability
| 症状 | 確認する順番 |
|---|---|
| モデル一覧にAstraがない | 現在のログイン先 → そのクライアントのモデル一覧 → プランや管理者設定 |
| モデル名を指定すると利用不可になる | ChatGPTログインかAPIキーか → 対応するアカウント・プロジェクトの利用権限 |
| config.tomlを編集しても別モデルになる | 起動時の--model → プロジェクトやプロファイルの設定 → 実際のモデル表示 |
| Astraは選べるが特定の強度がない | 選択中モデル → クライアントで提供される強度・モード |
組織で使っている場合は、管理者によるモデルの有効化が必要な場合があります。ChatGPTの画面で選べることと、CodexやAPIプロジェクトで使えることを同一視せず、問題が起きている環境の条件を確認してください。
長い仕事では「どこまで終わらせるか」を指示する
Astraに長い作業を任せるときは、手順を細かく固定するよりも、完了条件と変更してよい範囲を具体的にします。公式の指示設計ガイドも、必要な情報を段階的に読ませることや、完了まで進める境界を明確にすることを説明しています。Rethinking skills and prompts for GPT-6 Astra
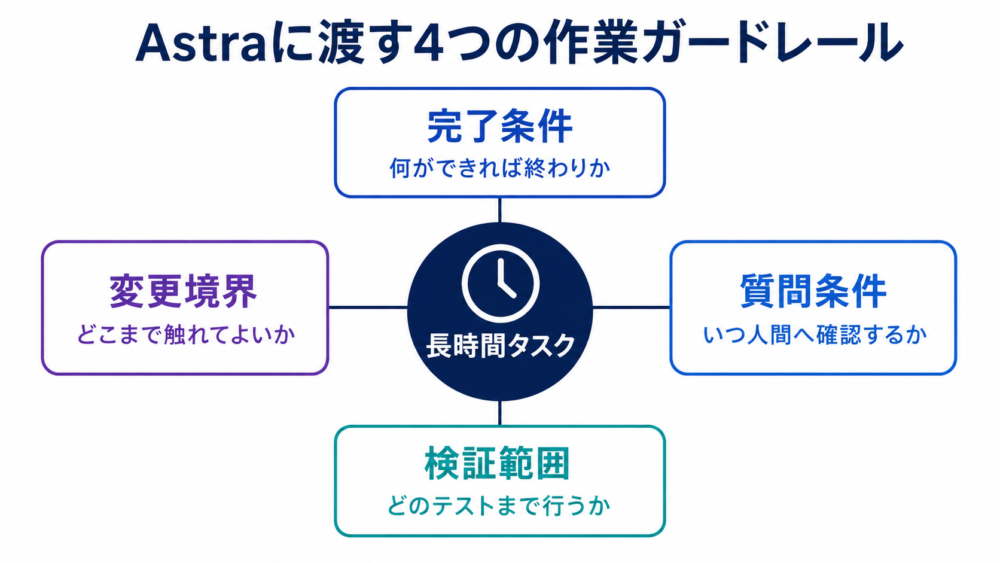
上の図は、依頼に含めたい4つの観点を整理した概念図です。モデル内部の動作や実測結果を表すものではありません。
不具合修正なら、次のように依頼できます。
ログイン後に一覧画面が空になる不具合を調べ、修正してください。

完了条件:再現条件を説明し、修正後に関連テストが通ること。
変更範囲:認証と一覧取得に関係するコード。公開APIの仕様は維持すること。
質問条件:仕様変更やデータ移行が必要なら、実行前に確認すること。
検証範囲:再現テストと関連テスト。失敗した場合は原因を調べ、
同じ変更範囲で修正できるところまで進めること。
最後に、変更内容、検証結果、残った問題を報告してください。
これは筆者が整理した依頼例です。「全部任せる」だけでは曖昧になる承認の境界を残しつつ、最初の実装案を出した時点で止まらないように、検証までを完了条件に含めています。
AGENTS.mdやスキルにも同じ考え方を適用できます。毎回すべての資料を読ませるより、最初の案内を短くし、対象の仕事に必要な資料へ進める構成にします。一方で、公開・削除・外部への送信などに必要な承認まで省く理由にはなりません。
自分のタスクでAstraとSolを比べる
モデルを決めるには、実際に繰り返す仕事を1つ選び、同じ条件で比べるのが分かりやすい方法です。OpenAIのモデル選択ガイドも、品質、費用、待ち時間を評価して選ぶ考え方を示しています。Model selection
- 同じコードの状態、入力資料、依頼文、完了条件を用意する。
- 選んだモデルと推論設定を記録し、別々の作業環境で実行する。
- テストの成否だけでなく、仕様の取り違え、修正の手戻り、説明不足を確認する。
- 求める品質を満たした結果同士で、所要時間と表示された利用量を比較する。
1回の成功だけで常に優れているとは判断できないため、普段扱う複数の仕事で傾向を見ます。Solで十分に完了する仕事はSolを使い、難しい調査や判断で差が出る仕事をAstraに任せると、自分の用途に合う使い分けを作れます。
なお、本記事ではモデルを実行した性能比較は行っていません。公式資料の説明と、読者自身が比較するための手順を分けて示しています。
コメント