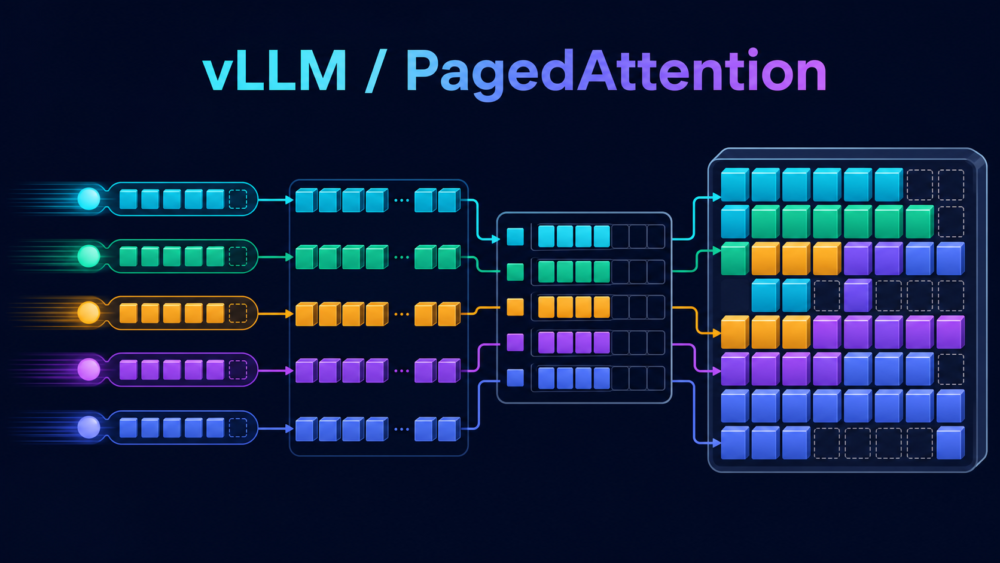
vLLMは、LLM(大規模言語モデル)を効率よく実行し、アプリから利用できる形で配信するソフトウェアです。複数の生成要求をさばくとき、途中の計算結果を保存するメモリと、要求の処理順を工夫して、GPUを活用します。本記事では、用途の判断からPagedAttentionの原理、容量計算、最初の起動方法までを順に説明します。
vLLMとは:どんな場面で使うか
たとえば、社内チャットへ同時に質問が届く場合、回答の長さも入力文の長さも人によって異なります。vLLMはモデルを読み込み、これらの要求をまとめて実行する推論エンジンと、API(アプリケーション間の通信規約)経由で受け付けるサーバー機能を提供します。Pythonからまとめて文章を生成する使い方もできます。vLLM公式Quickstart
| 構成要素 | 担当すること | 例 |
|---|---|---|
| 言語モデル | 学習済みの重みに基づいて出力を計算する | Qwenなどの対応モデル |
| 推論エンジン | モデルの実行、メモリ、要求の処理を管理する | vLLM |
| アプリ | 会話画面、検索、利用者管理などを提供する | 社内チャット、文書要約サービス |
vLLMを導入しても、モデル自体の知識や推論能力が自動的に増えるわけではありません。導入を検討する軸は、必要なモデルを動かせるか、同時利用時の待ち時間を満たせるか、運用できるかです。
Ollamaと迷ったときの考え方
以下は機能の優劣ではなく、最初に試す環境を選ぶための目安です。OllamaもAPIを提供し、vLLMも少数の要求を処理できるため、用途は重なります。Ollama公式Quickstart
| 重視すること | 最初に検討する入口 | 引き受ける作業・注意点 |
|---|---|---|
| 手元でモデルを呼び出し、会話やアプリ連携を試す | OllamaのアプリやCLI(コマンド操作) | モデル形式と実行環境が目的に合うかを確認する |
| 複数の要求を受けるLLMサーバーを調整する | vLLM | GPU、モデル、同時処理数を管理し、負荷をかけて測定する |
| インフラ管理を小さくしてモデルを利用する | 運用を外部に任せるAPIサービス | 利用料金、データ送信先、利用可能なモデルを確認する |
自分だけが使う短い会話と、多人数が長文を送るサービスでは、必要な設計が変わります。vLLMの特徴がどこに効くかを理解すると、導入の理由も具体的になります。
vLLMの速さを支える仕組み
vLLMの性能には複数の機能が関わります。PagedAttentionだけで、すべての高速化を説明することはできません。
| 仕組み | 主に改善する対象 | 効果を考える場面 |
|---|---|---|
| PagedAttention | 生成途中のKV Cacheの配置・管理 | 長さの異なる要求がメモリを使う |
| 連続バッチ処理 | 同じ計算に参加する要求の組合せ | 先に終わった要求の枠を活用する |
| Automatic Prefix Caching(APC) | 入力の共通する先頭部分の再計算 | 同じ長い文書や会話履歴を繰り返し渡す |
| 計算カーネルの最適化 | GPU上の計算とデータの読み書き | ハードウェアに合う実装を使う |
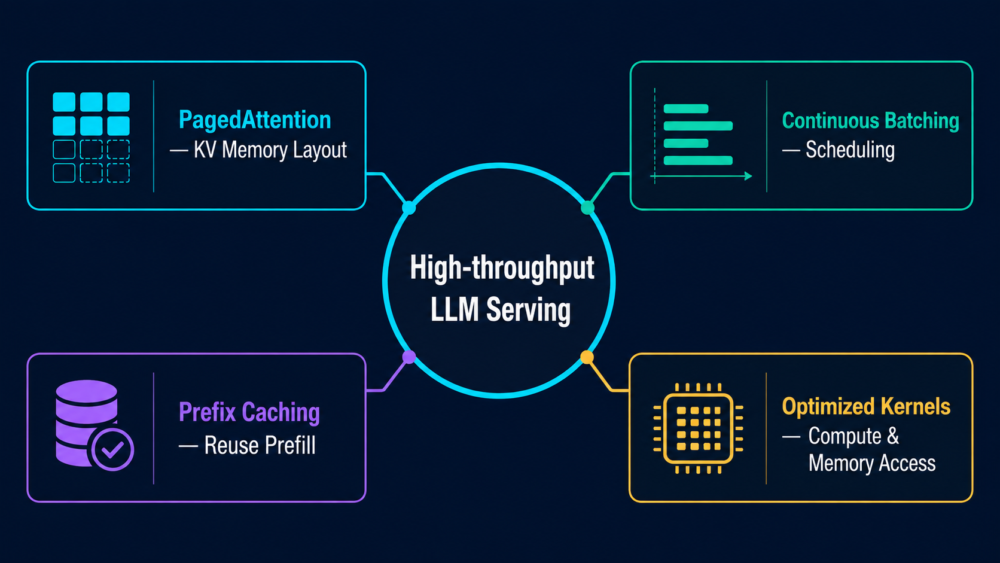
図は機能の役割を示す模式図です。機能の一覧はHugging FaceのvLLM解説でも確認できます。
ここでいう「速さ」は、1人の回答が届く速さと、サーバー全体が単位時間に処理できる量に分かれます。同時処理を増やして総処理量が伸びても、1人の待ち時間まで短くなるとは限りません。導入後は両方を測って判断します。
PagedAttentionはKV Cacheをどう管理するか
生成が進むと増えるKV Cache
LLMは、入力文を読み取るprefill(入力処理)の後、decode(新しいトークンを順に生成する処理)へ進みます。トークンはモデルが扱う文字列の単位で、常に1文字や1単語と一致するわけではありません。
過去のトークンに対するKeyとValueという計算結果を保存し、次の計算で使い回す仕組みがKV Cacheです。保存によって重複する計算を省けますが、扱う文脈が長くなるほど容量が増えます。前提を詳しく知りたい場合はKV Cacheの解説も参照してください。
要求ごとに最大長まで連続した領域を予約すると、短く終わった要求にも大きな空きが残ります。また、使用中の領域の間へ空きが分散すると、空きの合計が足りていても、大きな連続領域を確保しにくくなります。
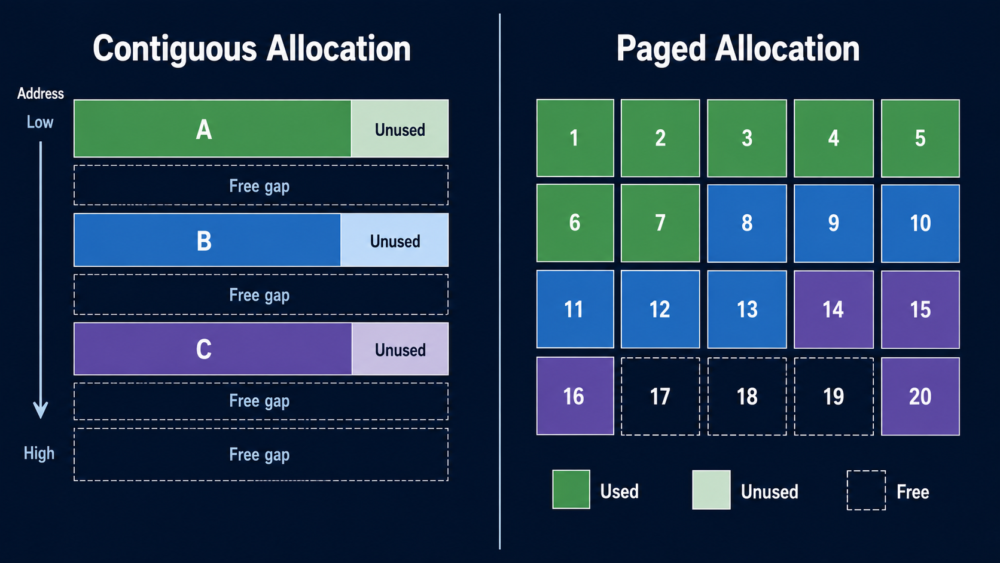
左のUnusedは予約内の未使用部分、Free gapは領域間の空きです。右はブロック単位の配置例で、面積や削減率を実測した図ではありません。ブロック方式でも末尾の空きは残り得ます。
トークンの順序とメモリ上の位置を分ける
PagedAttentionは、KV Cacheを一定数のトークンごとのブロックへ分け、GPUメモリ上では離れた場所にも配置できるようにします。要求から見た順序を表す「論理ブロック」と、実際の保存位置である「物理ブロック」を対応表で結びます。PagedAttentionの原論文
たとえば、要求Aの3ブロックが次の場所にあっても、計算時には対応表を使って順に参照できます。
| 要求 | 論理ブロックの順番 | 物理ブロック番号の例 |
|---|---|---|
| A | 0 | 7 |
| A | 1 | 1 |
| A | 2 | 9 |
| B | 0 | 3 |
| B | 1 | 8 |
物理番号が7、1、9と飛んでも、Aのトークン順が入れ替わるわけではありません。順番は対応表で保ち、保存先に連続性を要求しないことが、この設計の要点です。
要求の成長に合わせて割り当てる
入力や生成結果が増えて現在のブロックに収まらなくなると、要求へ次のブロックを追加します。処理が終わり、共有などによる参照が不要になったブロックは、別の要求に割り当てられます。
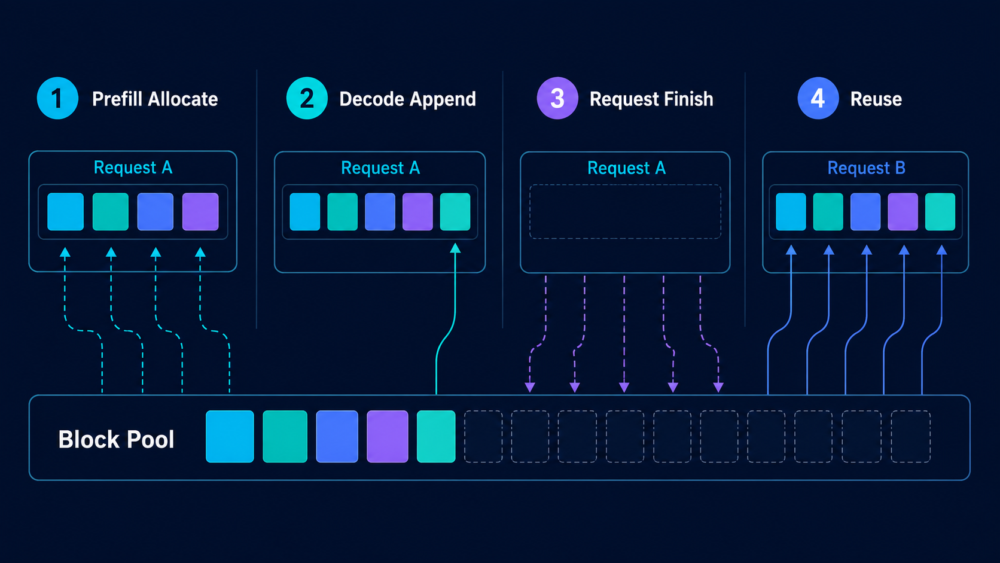
図は、共有やキャッシュ保持を省略した基本の流れです。ここでいう「追加」は管理対象のブロックを要求へ割り当てることであり、生成のたびにGPUメモリそのものをOSへ新規要求するという意味ではありません。
原論文は2023年の設計を説明しています。現在のvLLMは内部構成が更新されているため、運用時の動作は現行V1ガイドと利用するバージョンで確認します。
KV Cacheの容量を具体値で計算する
通常のTransformerで、各層・各トークンにKeyとValueを保存する場合、1トークン分のKV容量は次のように概算できます。
先頭の2はKeyとValue、Lは層数、H_KVはKVヘッド数、d_hは1ヘッドの次元、bは要素当たりのバイト数です。Queryのヘッド数とKVヘッド数が異なるモデルでは、KV側を使います。GQA・MQAの解説
以下は、L=32、H_KV=8、d_h=128、BF16(1要素2バイト)、1ブロック16トークンという説明用の条件です。特定の実機の測定結果ではありません。
| 計算対象 | 計算 | 容量 |
|---|---|---|
| 1トークン | 2 × 32 × 8 × 128 × 2 | 131,072 bytes = 128 KiB |
| 1ブロック | 128 KiB × 16 | 2 MiB |
| 100トークンのKV本体 | 128 KiB × 100 | 12.5 MiB |
| 必要ブロック数 | 100 ÷ 16を切り上げ | 7ブロック |
| 割当容量 | 2 MiB × 7 | 14 MiB |
| 末尾の空き | 128 KiB × (112 − 100) | 1.5 MiB |
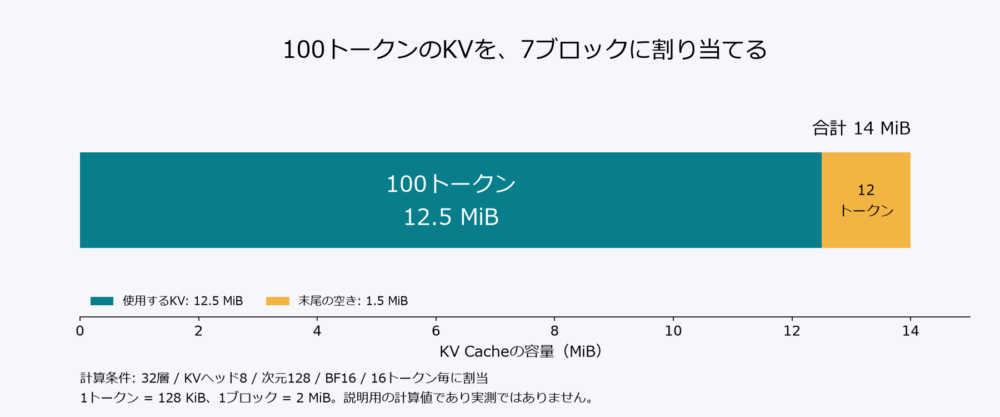
図の単位はMiBです。1 KiBは1,024 bytes、1 MiBは1,024 KiBなので、128 KiB × 100は12.5 MiBになります。7ブロックで112トークン分を確保するため、最後の12トークン分が空きます。
この14 MiBは、例に置いた1要求のKV用割当です。モデルの重みや計算途中の作業領域を含む、必要VRAM(GPUメモリ)の総量ではありません。 同時要求数、文脈長、KVのデータ型、モデル構造によっても変わります。層ごとに保存方式が異なるモデルや圧縮されたキャッシュへ、この式をそのまま当てはめないでください。
連続バッチ処理とAPCは何が違うか
連続バッチ処理は、空いた枠へ次の要求を入れる
固定した一組の要求がすべて終わるまで待つ方式では、短い要求が先に終わると、その枠を使わずに待つ時間が生まれます。連続バッチ処理では、反復計算の区切りで処理対象を入れ替えます。
2枠でAを3ステップ、Bを5ステップ処理し、待機中のCに2ステップ必要な例を考えます。下表は生成ステップだけの説明用で、入力処理やGPU上の実時間は省略しています。
| ステップ | 固定した組で処理する場合 | 連続的に入れ替える場合 |
|---|---|---|
| 1〜3 | AとB | AとB |
| 4〜5 | Bだけ。Aの枠は空き | BとC |
| 6〜7 | C | この例の3要求は終了済み |
両側でA・B・Cの必要ステップ数は同じです。この表から読めるのは空いた枠の使い方であり、「何倍速い」という測定値ではありません。PagedAttentionのメモリ管理と組み合わせることで、長さの違う要求を扱いやすくなります。原論文の要求処理
APCは、同じ先頭部分の入力計算を使い回す
APCは、前の要求と共通する先頭部分のKVを再利用します。同じ長文資料を付けて質問を変える場合など、入力処理を繰り返さずに済む可能性があります。新しい出力トークンを生成する計算そのものを省く機能ではありません。APC公式解説
「意味が似た文章」なら再利用できる、という仕組みでもありません。先頭からのトークン列などでキャッシュを識別するため、文面やチャット用の書式が変わると共有できる範囲も変わります。キャッシュはブロック単位なので、共通部分のすべてが必ず再利用されるわけではありません。Prefix Cachingの設計
vLLMの使い方:小さいモデルでAPIを試す
以下はLinuxと対応NVIDIA GPUを使う例です。uv(Python環境管理ツール)を導入し、GPUドライバーと空きメモリを確認したうえで進めます。AMDやApple Siliconなどは導入経路が異なるため、公式Quickstartで環境を選んでください。
コマンドは2026年10月12日に公式資料と照合しました。本記事ではGPU上で実行していないため、動作や速度の実測例としては扱いません。
1. 専用環境へインストールする
既存プロジェクトと依存関係を混ぜないように、新しい作業ディレクトリで実行します。
# 既存アプリの依存関係を変えないため、専用環境を使う。
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto

# 後で同じ条件を調べられるよう、導入された版を記録する。
vllm --version
uv pip freeze > requirements-vllm.txt
2. ローカルからだけ接続できる形で起動する
公式例にも使われるQwen2.5-1.5B-Instructを指定します。初回はモデルの取得が発生するため、通信環境、保存容量、モデルの利用条件も確認してください。
# 初回確認では外部公開を避け、扱う文脈長も限定する。
vllm serve Qwen/Qwen2.5-1.5B-Instruct \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 4096
起動完了後、別のターミナルからモデル一覧を確認します。
curl --fail-with-body http://127.0.0.1:8000/v1/models成功の目安は、HTTPの成功応答と、モデル情報を含むJSONが返ることです。ダウンロード中や初期化中はまだ接続できないので、先にサーバー側のログを見ます。
3. 短い文章を生成する
curl --fail-with-body http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "Qwen/Qwen2.5-1.5B-Instruct",
    "messages": [
      {"role": "user", "content": "KV Cacheの役割を日本語で一文にまとめてください。"}
    ],
    "temperature": 0,
    "max_tokens": 96
}'応答のchoicesに生成内容が入れば、APIからモデルまでの基本的な疎通を確認できます。例のmax_tokensは出力の上限で、サーバー起動時のmax-model-lenは入力と出力を合わせて扱える長さの上限です。
この形式はOpenAI互換APIとして提供されますが、モデルごとのチャット用書式や対応機能まで同一になるわけではありません。Chat Completionsには適切なchat template(会話をモデル入力へ変換する書式)が必要で、生成設定の初期値はモデル側の設定にも影響されます。公式QuickstartのAPI配信
停止するときは、サーバーを起動したターミナルでCtrl+Cを押します。本番で外部から接続させる場合は、このローカル確認とは別に、認証、通信経路、利用量の制限を設計します。
導入後は待ち時間と総処理量を分けて測る
採否を決める際は、同じGPUとモデルだけでなく、入力・出力の長さ、同時要求数、データ型、キャッシュが温まっているかまで揃えます。自分だけで1回生成した結果を、そのまま多人数のサービスへ当てはめないことが大切です。
| 指標 | 分かること | 比較時の注意 |
|---|---|---|
| TTFT(最初のトークンまでの時間) | 回答が始まるまでの待ち | 入力長とキューの待ち時間を揃える |
| ITL(出力トークン間の時間) | 回答が表示され続ける滑らかさ | 平均だけでなく遅い側の分布も見る |
| 応答完了までの時間 | 1要求全体の待ち | 出力長が長ければ自然に伸びる |
| 出力トークン数/秒、要求数/秒 | サーバー全体の処理量 | 入出力を混ぜたtokens/sと区別する |
| GPUメモリ、KV使用状況 | 容量の余裕 | 起動時の予約と実際の要求への割当を区別する |
| 中断・再計算、エラー | 高負荷時の安定性 | 処理量が伸びても再計算や失敗が増えていないかを見る |
たとえば社内チャットなら、「同時10要求で最初の表示まで何秒以内」のように、自分の用途の合格条件を先に置きます。この数字は説明用であり、vLLMの保証値ではありません。
設定を変えるときは、何を制限するかを確認する
| 設定 | 調整するもの | トレードオフ |
|---|---|---|
max-model-len |
1要求の最大文脈長 | 短くすると長文を受けられなくなる |
max-num-seqs |
1回の反復で扱う最大系列数 | 減らすとメモリ負荷を抑えやすいが、同時処理の上限も下がる |
max-num-batched-tokens |
1回の反復で扱うトークン数の上限 | 入力処理と生成処理の時間配分に影響する |
gpu-memory-utilization |
実行に使うGPUメモリの割合 | 増やす場合は他の処理と空き容量の余裕を確認する |
設定の定義はEngine Argumentsで確認できます。KVが不足すると、要求をいったん中断して後で再計算することがあり、待ち時間に影響します。同時処理数やメモリ割当を変える場合は、Optimization and Tuningの説明を参照し、一つずつ変更して測定します。
よくある疑問
vLLMとPagedAttentionは同じもの?
vLLMは推論・配信のソフトウェア全体、PagedAttentionはKV Cacheを効率よく扱うための仕組みです。vLLMには、これ以外にも要求の処理や計算を改善する機能が含まれます。
vLLMなら1人で使う場合も必ず速くなる?
必ず速くなるとはいえません。モデル、GPU、生成の長さ、比較対象の実装によって変わります。メモリの使い方と複数要求の処理に着目した仕組みなので、必要な同時利用条件で測って判断します。
vLLMは無料で使える?
vLLM本体はApache License 2.0で提供されています。GPUやクラウドの実行費用は別にかかり、利用するモデルの条件もそれぞれ確認が必要です。
FlashAttentionや量子化とは何が違う?
FlashAttentionはAttention計算時のデータの読み書き、量子化は数値を表すビット幅に着目します。KVの配置や要求処理とは改善する対象が異なるため、対応条件を満たせば複数の工夫を組み合わせて使います。
コメント